ComfyUIでのWan2.1動画生成:T2V・I2V・V2Vガイド
Wan2.1のComfyUIワークフローをダウンロード:wan2.1_i2v_480p_14B_fp16.safetensors、wan2.1_t2v_14B_fp16.safetensors、wan_2.1_vae.safetensors、GGUF版と5B版。T2V、I2V、V2Vガイド。
アリババが2025年2月にオープンソース化したWan2.1は、動画生成分野におけるベンチマークモデルです。Apache 2.0ライセンスの下で提供されており、14B(140億パラメータ)と1.3B(13億パラメータ)の2つのバージョンがあり、テキストから動画へ(T2V)、画像から動画へ(I2V)などのさまざまなタスクをカバーしています。
また、コミュニティの作者によってGGUF版および量子化バージョンが作成されています。
- GGUF: https://huggingface.co/city96/Wan2.1-T2V-14B-gguf/tree/main
- 量子化バージョン: https://huggingface.co/Kijai/WanVideo_comfy/tree/main
この記事では、Wan2.1に関連する以下のワークフローを案内します。
- ComfyUIがネイティブにサポートするWan2.1ワークフロー
- Kijaiによるバージョン
- City96によるGGUFバージョン
ComfyUI/output ディレクトリに保存されます。
Wan2.1は480Pと720Pのモデルを分けていますが、対応するワークフローはモデルとキャンバスのサイズを除いて他に違いはありません。対応する720Pまたは480Pのワークフローに基づいて、もう一方のバージョンのワークフローを調整できます。
Wan2.1 ComfyUIネイティブワークフローの例
以下のワークフローはComfyUI公式ブログからのものです。現在、ComfyUIはWan2.1をネイティブサポートしています。公式サポート版を使用するには、ComfyUIを最新バージョンにアップグレードしてください。手順についてはComfyUIのアップグレード方法のセクションを参照してください。 ComfyUI Wikiがオリジナルのワークフローを整理しています。
ComfyUIを最新バージョンに更新すると、メニューバーのWorkflows -> Workflow TemplatesからWan2.1ワークフローテンプレートを見つけることができます。
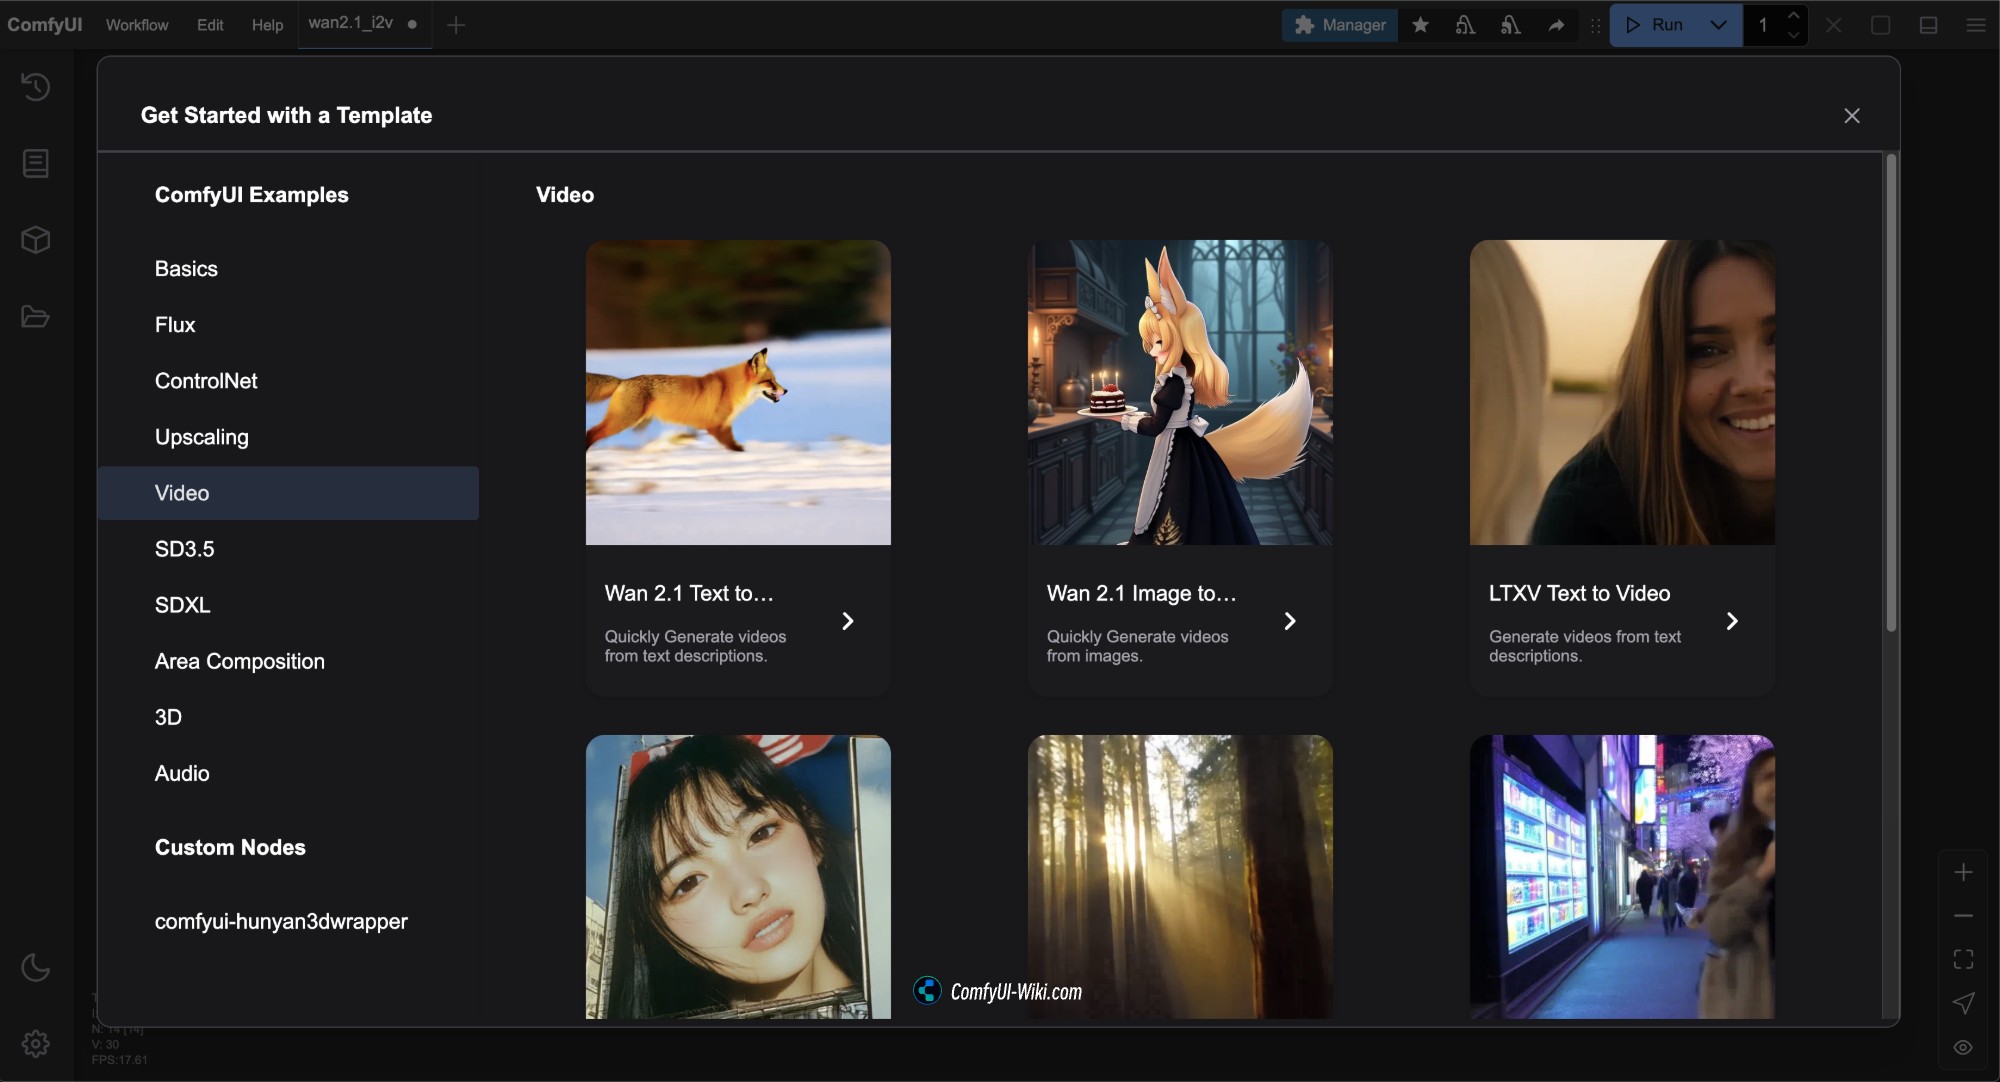
このバージョンの対応するすべてのワークフローファイルはComfy-Org/Wan_2.1_ComfyUI_repackagedから提供されています。
その中でも、Diffusion modelsでは複数のバージョンが提供されています。この記事の公式ネイティブ版で使用されているモデルバージョンのハードウェア要件が高すぎる場合は、ニーズに合ったバージョンを選択してください。
- i2vは画像から動画へのモデルを意味し、t2vはテキストから動画へのモデルを意味します。
- 14Bと1.3Bは対応するパラメータ数を表し、値が大きいほど高いハードウェア性能が必要です。
- bf16、fp16、fp8は異なる精度を表し、精度が高いほど高いハードウェア性能が必要です。
- bf16はAmpereアーキテクチャ以上のGPUのサポートが必要な場合があります。
- fp16はより広くサポートされています。
- fp8は最も低い精度とハードウェア要件ですが、効果も比較的劣る可能性があります。
- 一般的に、ファイルサイズが大きいほど高いハードウェア仕様が必要です。
1. Wan2.1テキストから動画へのワークフロー
1.1 Wan2.1テキストから動画へのワークフローファイルのダウンロード
以下の画像をダウンロードしてComfyUIにドラッグするか、メニューバーのWorkflows -> Open(Ctrl+O)を使用してワークフローを読み込んでください。
JSON形式のファイルをダウンロードしてください。
1.2 手動でのモデルインストール
上記のワークフローファイルでモデルのダウンロードが完了できない場合は、以下のモデルファイルをダウンロードし、対応する場所に保存してください。
Diffusion modelsファイルを1つ選択してダウンロードしてください:
- wan2.1_t2v_14B_bf16.safetensors
- wan2.1_t2v_14B_fp16.safetensors
- wan2.1_t2v_14B_fp8_e4m3fn.safetensors
- wan2.1_t2v_14B_fp8_scaled.safetensors
- wan2.1_t2v_1.3B_bf16.safetensors
- wan2.1_t2v_1.3B_fp16.safetensors
Text encodersから1つのバージョンを選択してダウンロードしてください:
VAE
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── wan2.1_t2v_14B_fp16.safetensors              # Or the version you choose
│   ├── text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors      # Or the version you choose
│   └── vae/
│       └──  wan_2.1_vae.safetensors
1.3 ワークフローを実行する手順
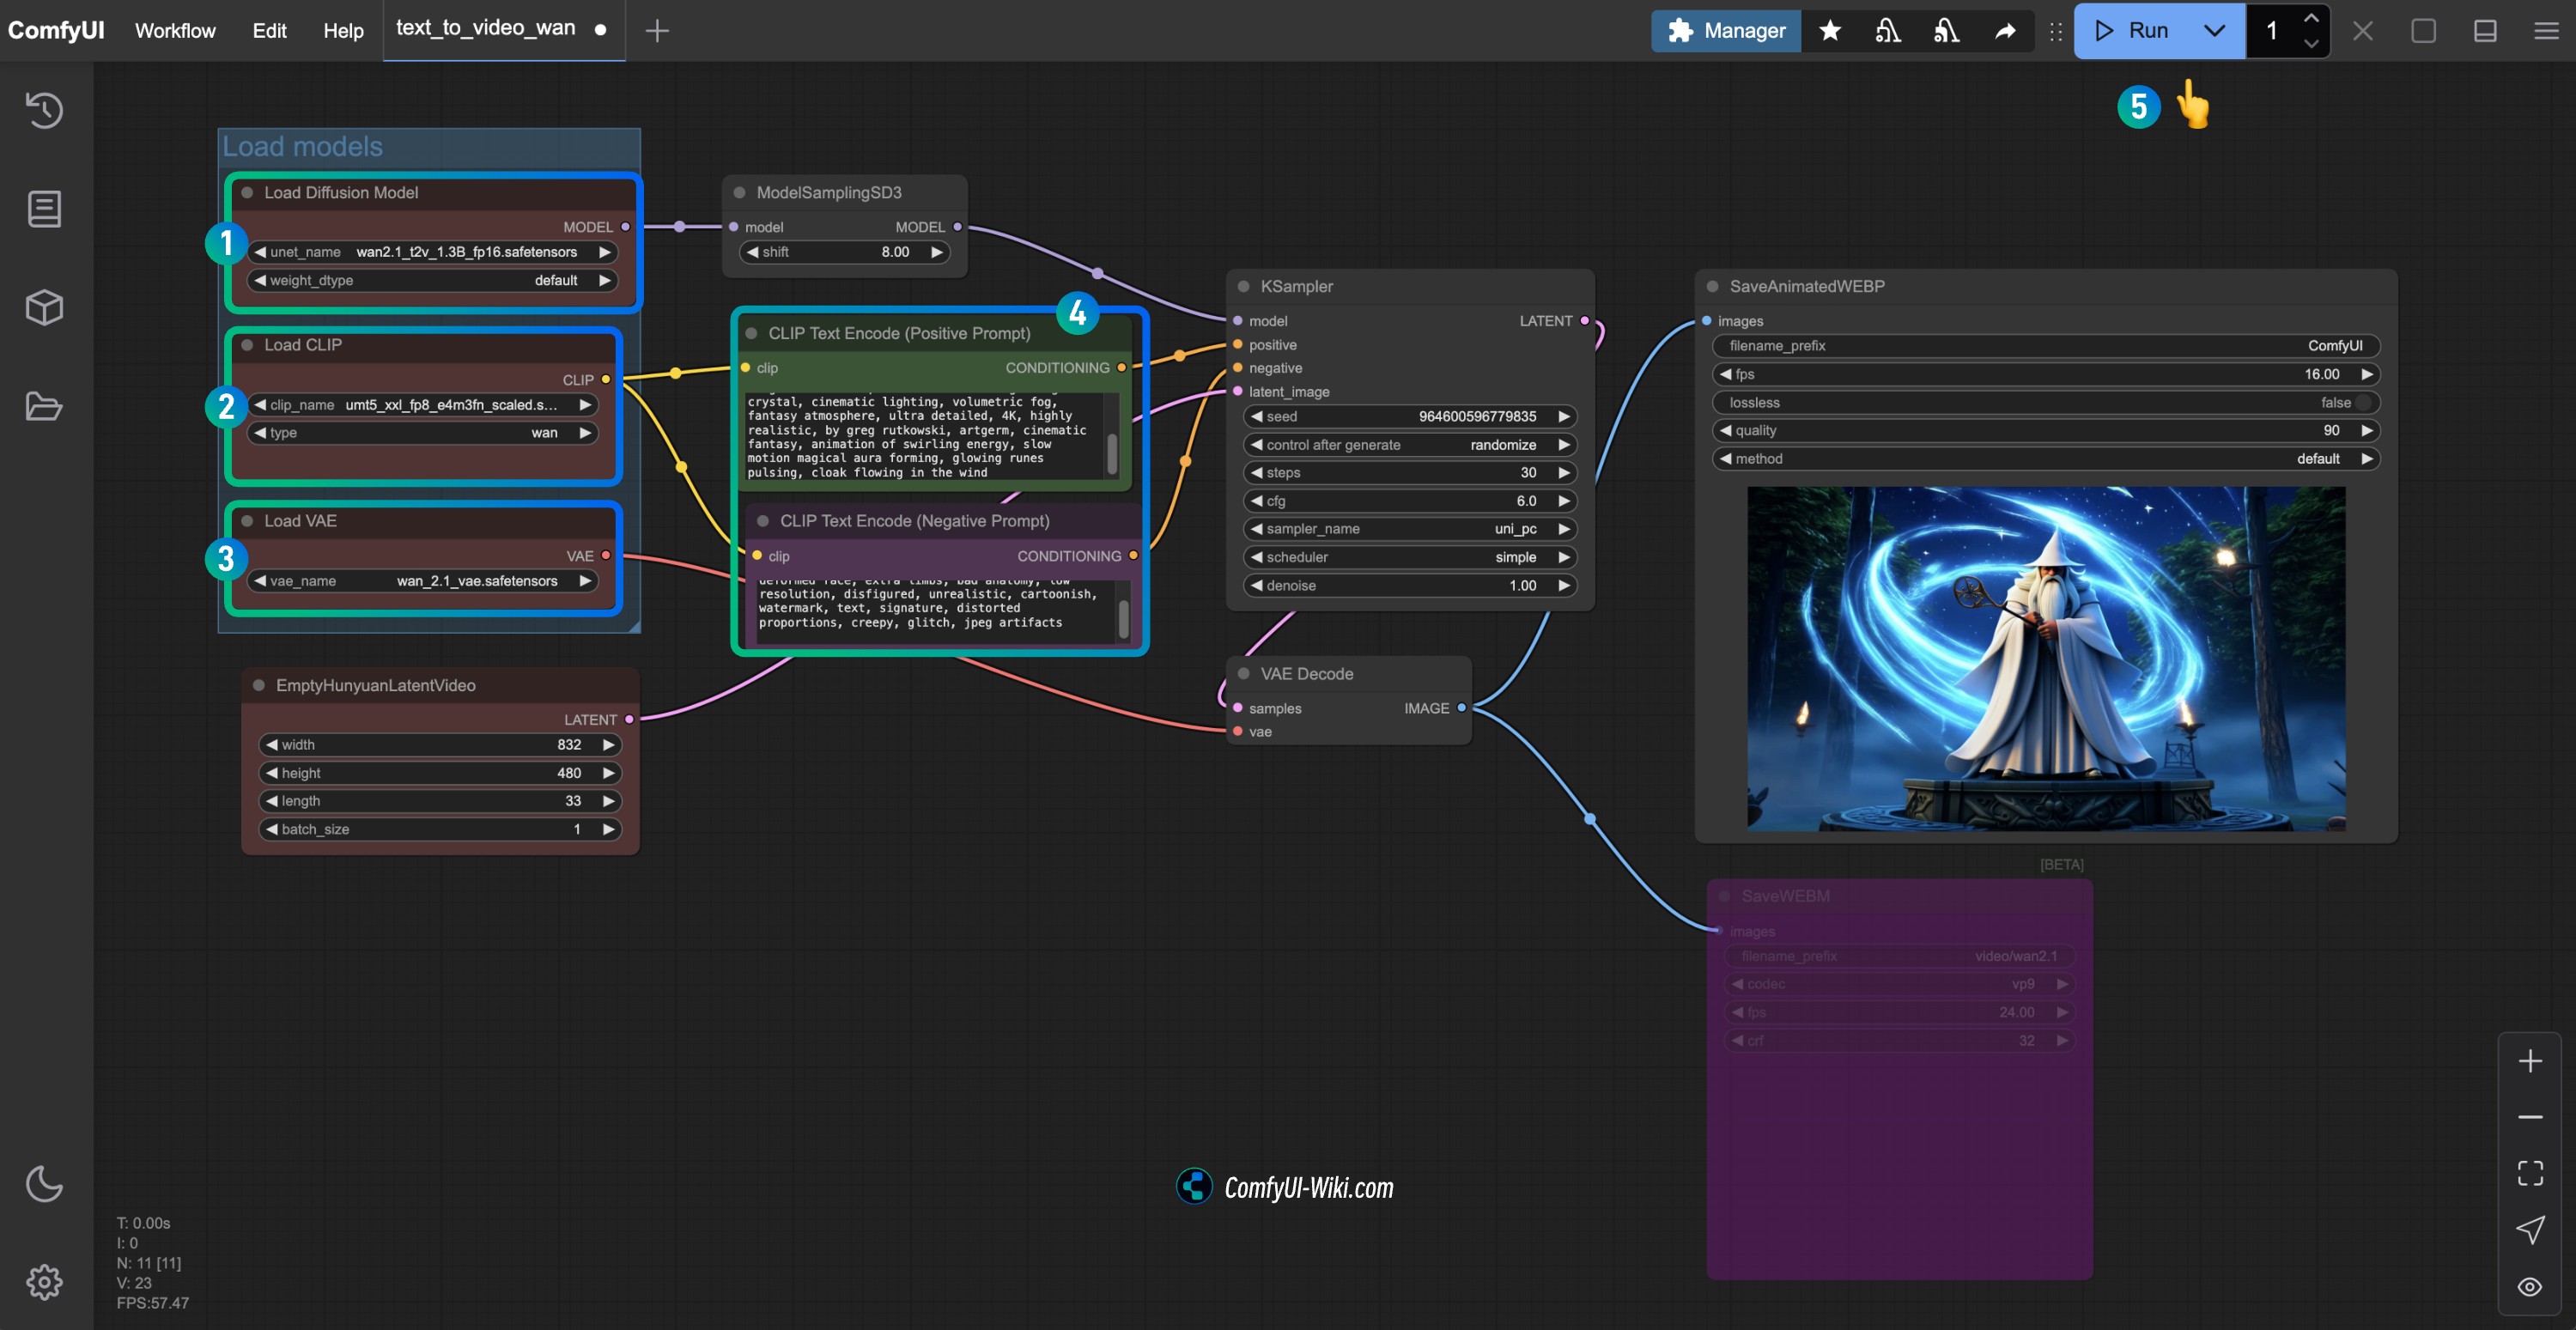
Load Diffusion Modelノードがwan2.1_t2v_1.3B_fp16.safetensorsモデルを読み込んでいることを確認します。Load CLIPノードがumt5_xxl_fp8_e4m3fn_scaled.safetensorsモデルを読み込んでいることを確認します。Load VAEノードがwan_2.1_vae.safetensorsモデルを読み込んでいることを確認します。CLIP Text Encoderノードに生成したい動画の説明コンテンツを入力できます。Runボタンをクリックするか、ショートカットCtrl(cmd) + Enterを使用して動画生成を実行します。
2. Wan2.1画像から動画へのワークフロー
2.1 Wan2.1画像から動画へのワークフロー14Bワークフロー
ワークフローファイルのダウンロード
以下のボタンをクリックして対応するワークフローをダウンロードし、ComfyUIインターフェースにドラッグするか、メニューバーのWorkflows -> Open(Ctrl+O)を使用して読み込んでください。
JSON形式のファイルをダウンロードしてください。
このバージョンのワークフローは、異なる拡散モデルを使用し、WanImageToVideoノードのサイズが異なることを除いて、基本的に480Pバージョンと同じです。
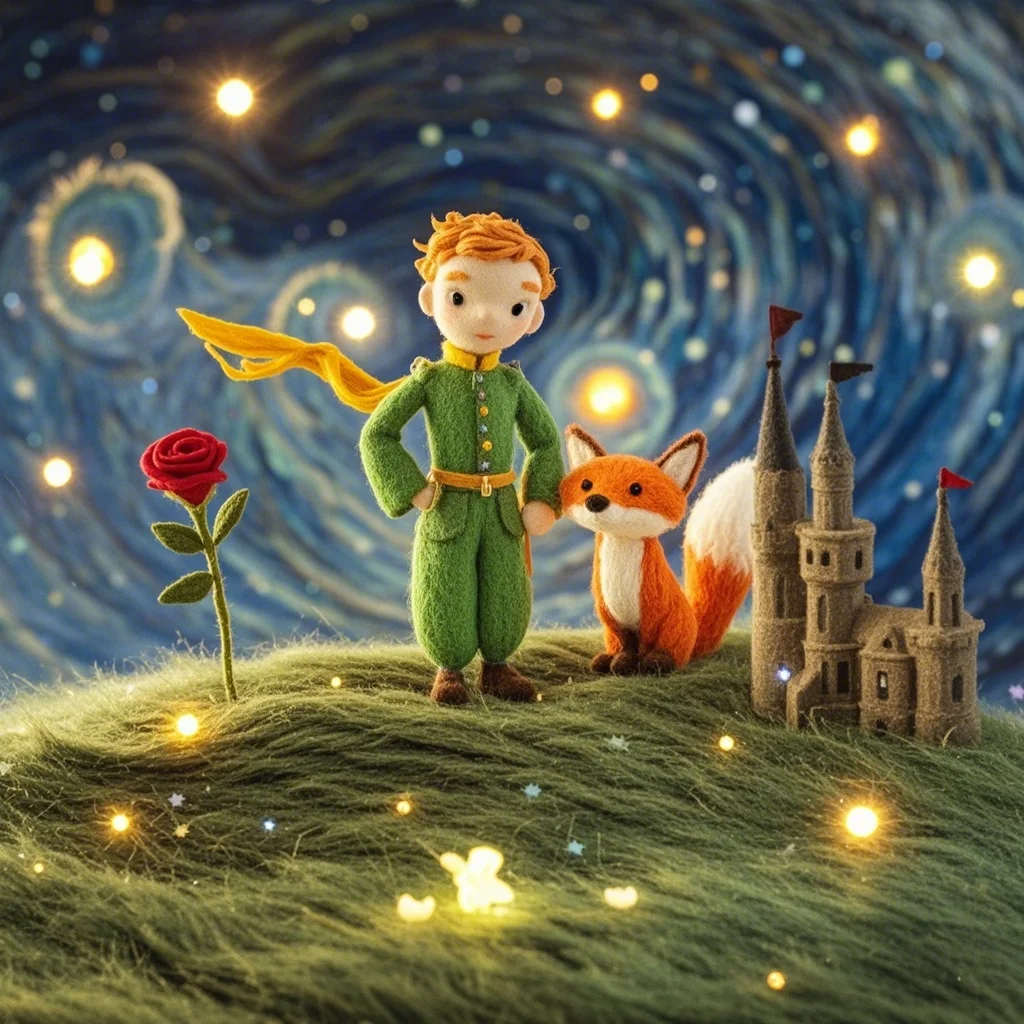
以下の画像を入力画像としてダウンロードしてください。
2.2 手動でのモデルダウンロード
上記のワークフローファイルでモデルのダウンロードが完了できない場合は、以下のモデルファイルをダウンロードし、対応する場所に保存してください。
Diffusion models
720Pバージョン
- wan2.1_i2v_720p_14B_bf16.safetensors
- wan2.1_i2v_720p_14B_fp16.safetensors
- wan2.1_i2v_720p_14B_fp8_e4m3fn.safetensors
- wan2.1_i2v_720p_14B_fp8_scaled.safetensors
480Pバージョン
- wan2.1_i2v_480p_14B_bf16.safetensors
- wan2.1_i2v_480p_14B_fp16.safetensors
- wan2.1_i2v_480p_14B_fp8_e4m3fn.safetensors
- wan2.1_i2v_480p_14B_fp8_scaled.safetensors
Text encoders
VAE
CLIP Vision
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── wan2.1_i2v_480p_14B_fp16.safetensors         # Or the version you choose
│   ├── text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors      # Or the version you choose
│   └── vae/
│   │   └──  wan_2.1_vae.safetensors
│   └── clip_vision/
│       └──  clip_vision_h.safetensors
2.3 ワークフローを実行する手順
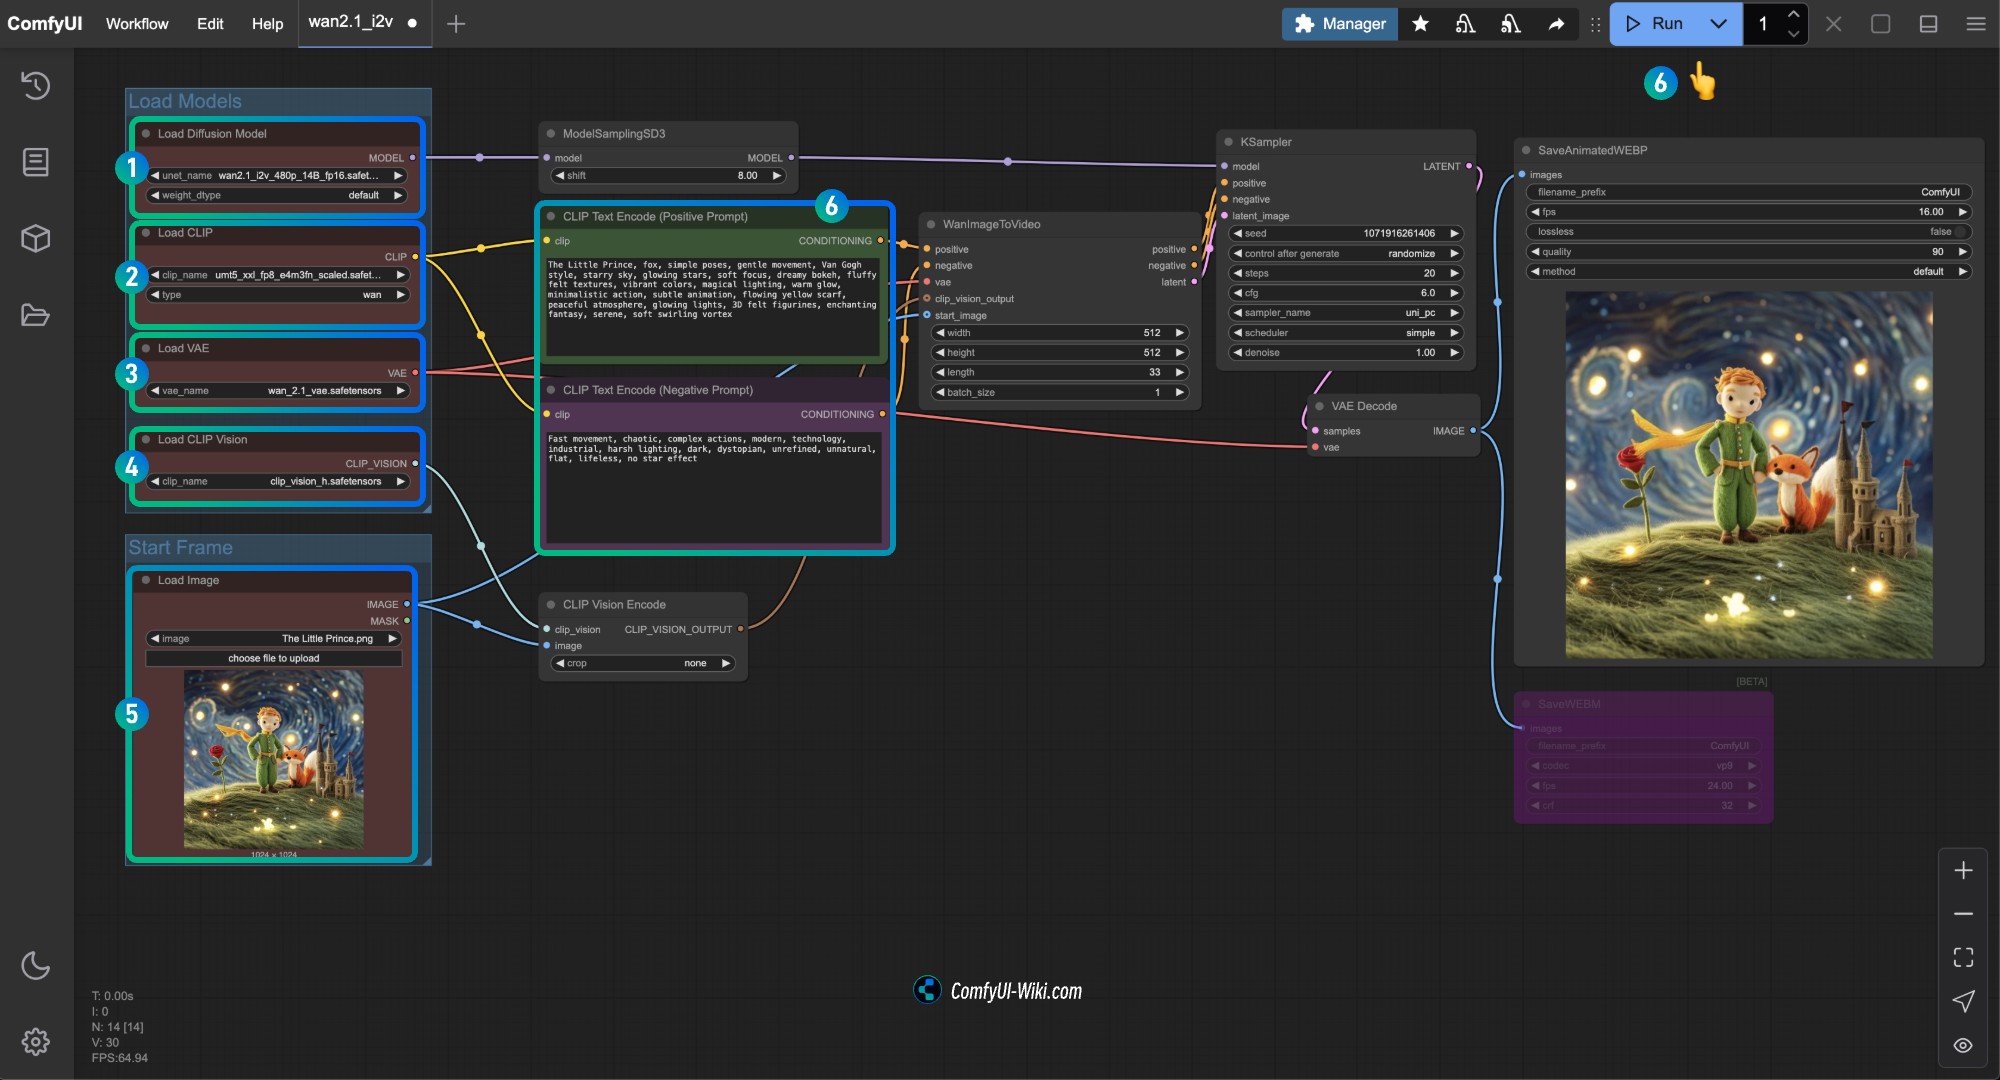
Load Diffusion Modelノードがwan2.1_i2v_480p_14B_fp16.safetensorsモデルを読み込んでいることを確認しますLoad CLIPノードがumt5_xxl_fp8_e4m3fn_scaled.safetensorsモデルを読み込んでいることを確認しますLoad VAEノードがwan_2.1_vae.safetensorsモデルを読み込んでいることを確認しますLoad CLIP Visionノードがclip_vision_h.safetensorsモデルを読み込んでいることを確認しますLoad Imageノードで入力画像を読み込みますCLIP Text Encoderノードに生成したいコンテンツを入力するか、ワークフロー内の例を使用しますRunボタンをクリックするか、ショートカットCtrl(cmd) + Enter(Enter)を使用して動画生成を実行します
Kijai Wan2.1 量子化版ワークフロー
このバージョンは Kijai によって提供されており、次のカスタムノードが必要です:
次の3つのノードをインストールする必要があります:
開始する前に、対応する3つのカスタムノードをインストールしてください。手順については ComfyUI カスタムノードのインストールチュートリアル を参照してください。
モデルリポジトリ: Kijai/WanVideo_comfy
リポジトリでは複数バージョンのモデルが提供されています。デバイスの性能に応じて適切なモデルを選択してください。一般的に、ファイルサイズが大きいほど効果は高くなりますが、より高いハードウェア性能も必要になります。
1. Kijai テキストから動画へのワークフロー
1.1 Kijai Wan2.1 テキストから動画へのワークフローのダウンロード
以下のボタンをクリックして対応するワークフローをダウンロードし、ComfyUI のインターフェースにドラッグするか、メニューバーの Workflows -> Open(Ctrl+O) を使用して読み込んでください。
2つのワークフローファイルは基本的に同じですが、2つ目のファイルには補足の注記が含まれています。
1.2 モデルの手動インストール
Diffusion モデル
- Wan2_1-T2V-14B_fp8_e4m3fn.safetensors
- Wan2_1-T2V-14B_fp8_e5m2.safetensors
- Wan2_1-T2V-1_3B_fp32.safetensors
- Wan2_1-T2V-1_3B_bf16.safetensors
- Wan2_1-T2V-1_3B_fp8_e4m3fn.safetensors
テキストエンコーダー
VAE
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── Wan2_1-T2V-14B_fp8_e4m3fn.safetensors             # Or the version you choose
│   ├── text_encoders/
│   │   └─── umt5-xxl-enc-bf16.safetensors                    # Or the version you choose
│   └─── vae/
│       └──  Wan2_1_VAE_bf16.safetensors                      # Or the version you choose
1.3 ワークフローを実行する手順
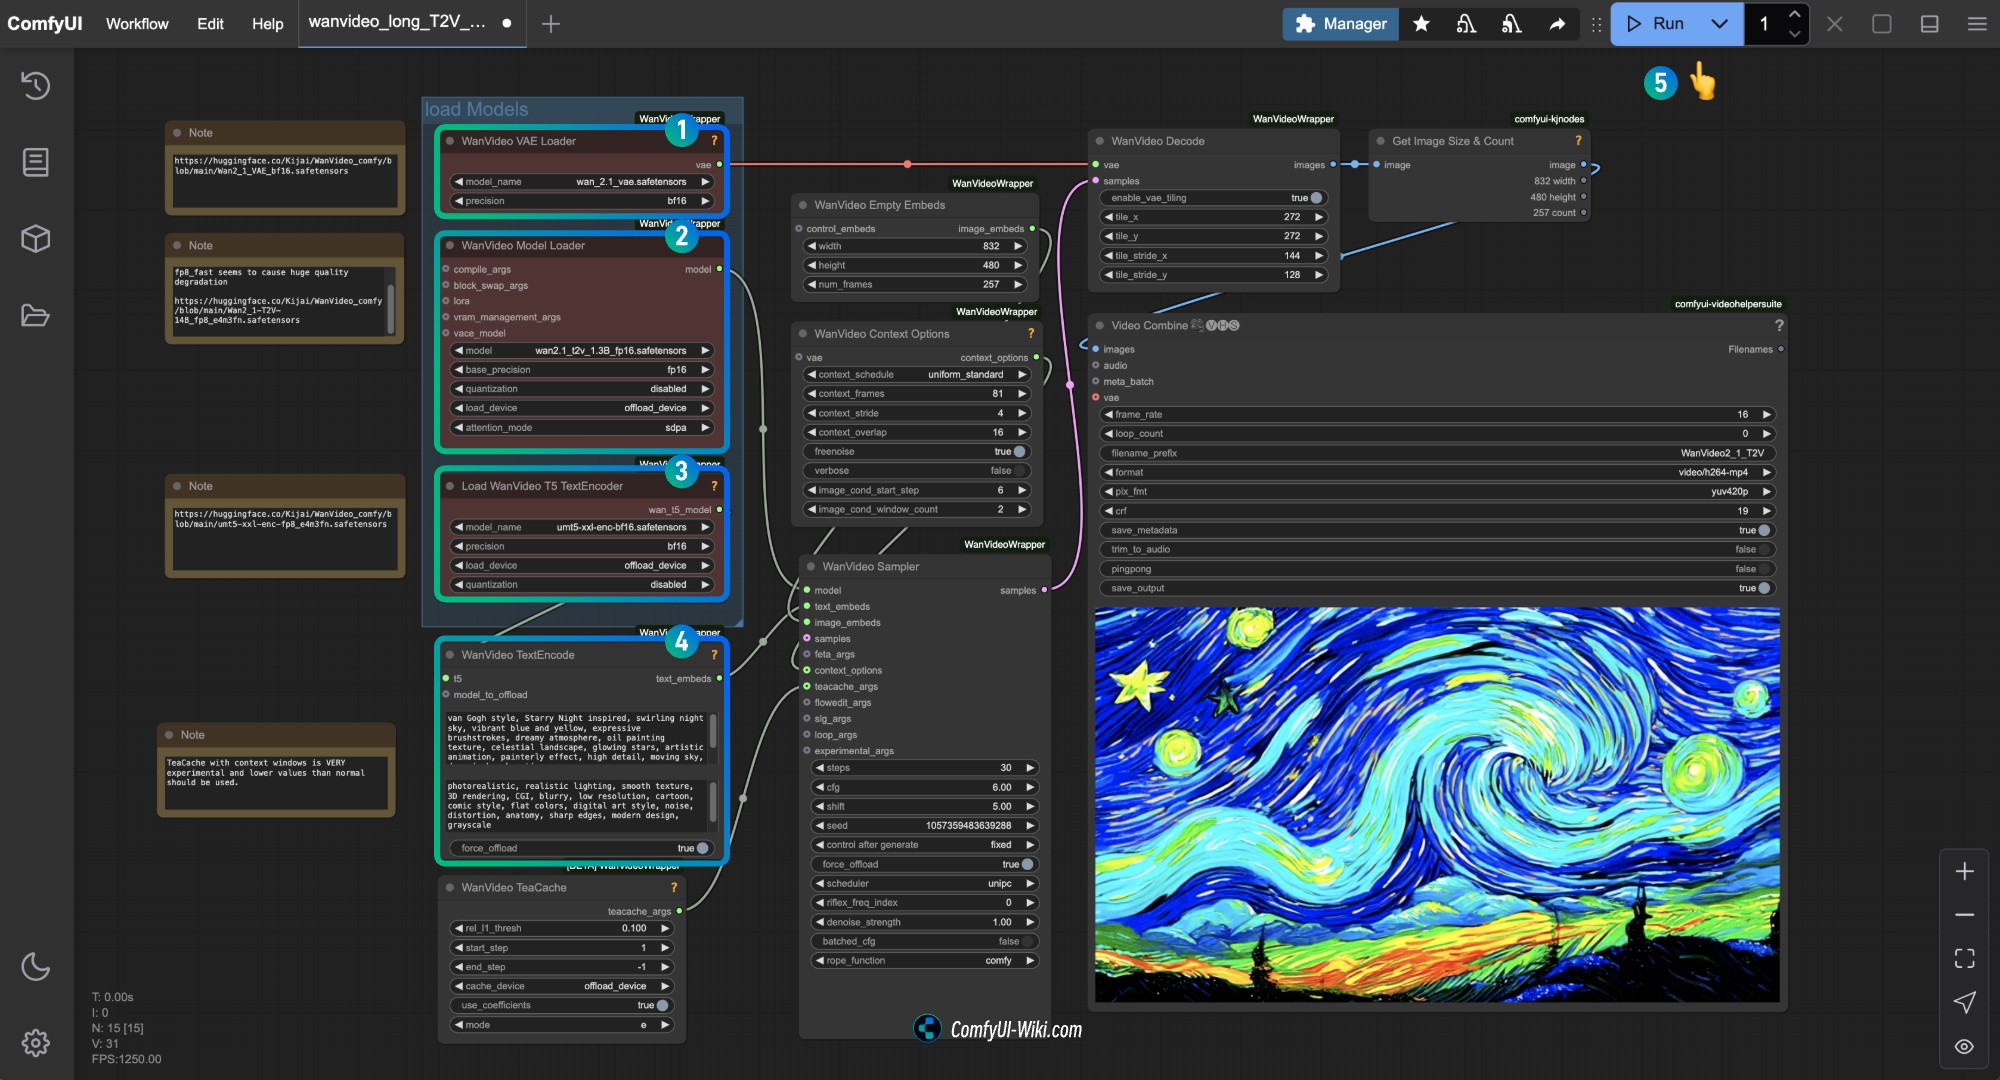
対応するノードが対応するモデルを読み込んでいることを確認し、ダウンロードしたバージョンを使用してください。
WanVideo Vae LoaderノードがWan2_1_VAE_bf16.safetensorsモデルを読み込んでいることを確認しますWanVideo Model LoaderノードがWan2_1-T2V-14B_fp8_e4m3fn.safetensorsモデルを読み込んでいることを確認しますLoad WanVideo T5 TextEncoderノードがumt5-xxl-enc-bf16.safetensorsモデルを読み込んでいることを確認しますWanVideo TextEncodeノードに生成したいコンテンツを入力しますRunボタンをクリックするか、ショートカットCtrl(cmd) + Enter(Enter)を使用して動画生成を実行します
WanVideo Empty Embeds ノードのサイズを変更することで、動画のサイズを変更できます。
2. Kiai Wan2.1 画像から動画へのワークフロー
2.1 ワークフローファイルのダウンロード
以下の画像を入力画像としてダウンロードしてください
2.2 モデルの手動ダウンロード
Diffusion モデル 720P バージョン
480P バージョン
テキストエンコーダー
VAE
CLIP Vision
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── Wan2_1-I2V-14B-720P_fp8_e4m3fn.safetensors           # Or the version you choose
│   ├── text_encoders/
│   │   └─── umt5-xxl-enc-bf16.safetensors                       # Or the version you choose
│   ├── vae/
│   │   └──  Wan2_1_VAE_fp32.safetensors                         # Or the version you choose
│   └── clip_vision/
│       └──  clip_vision_h.safetensors
2.3 ワークフローを実行する手順
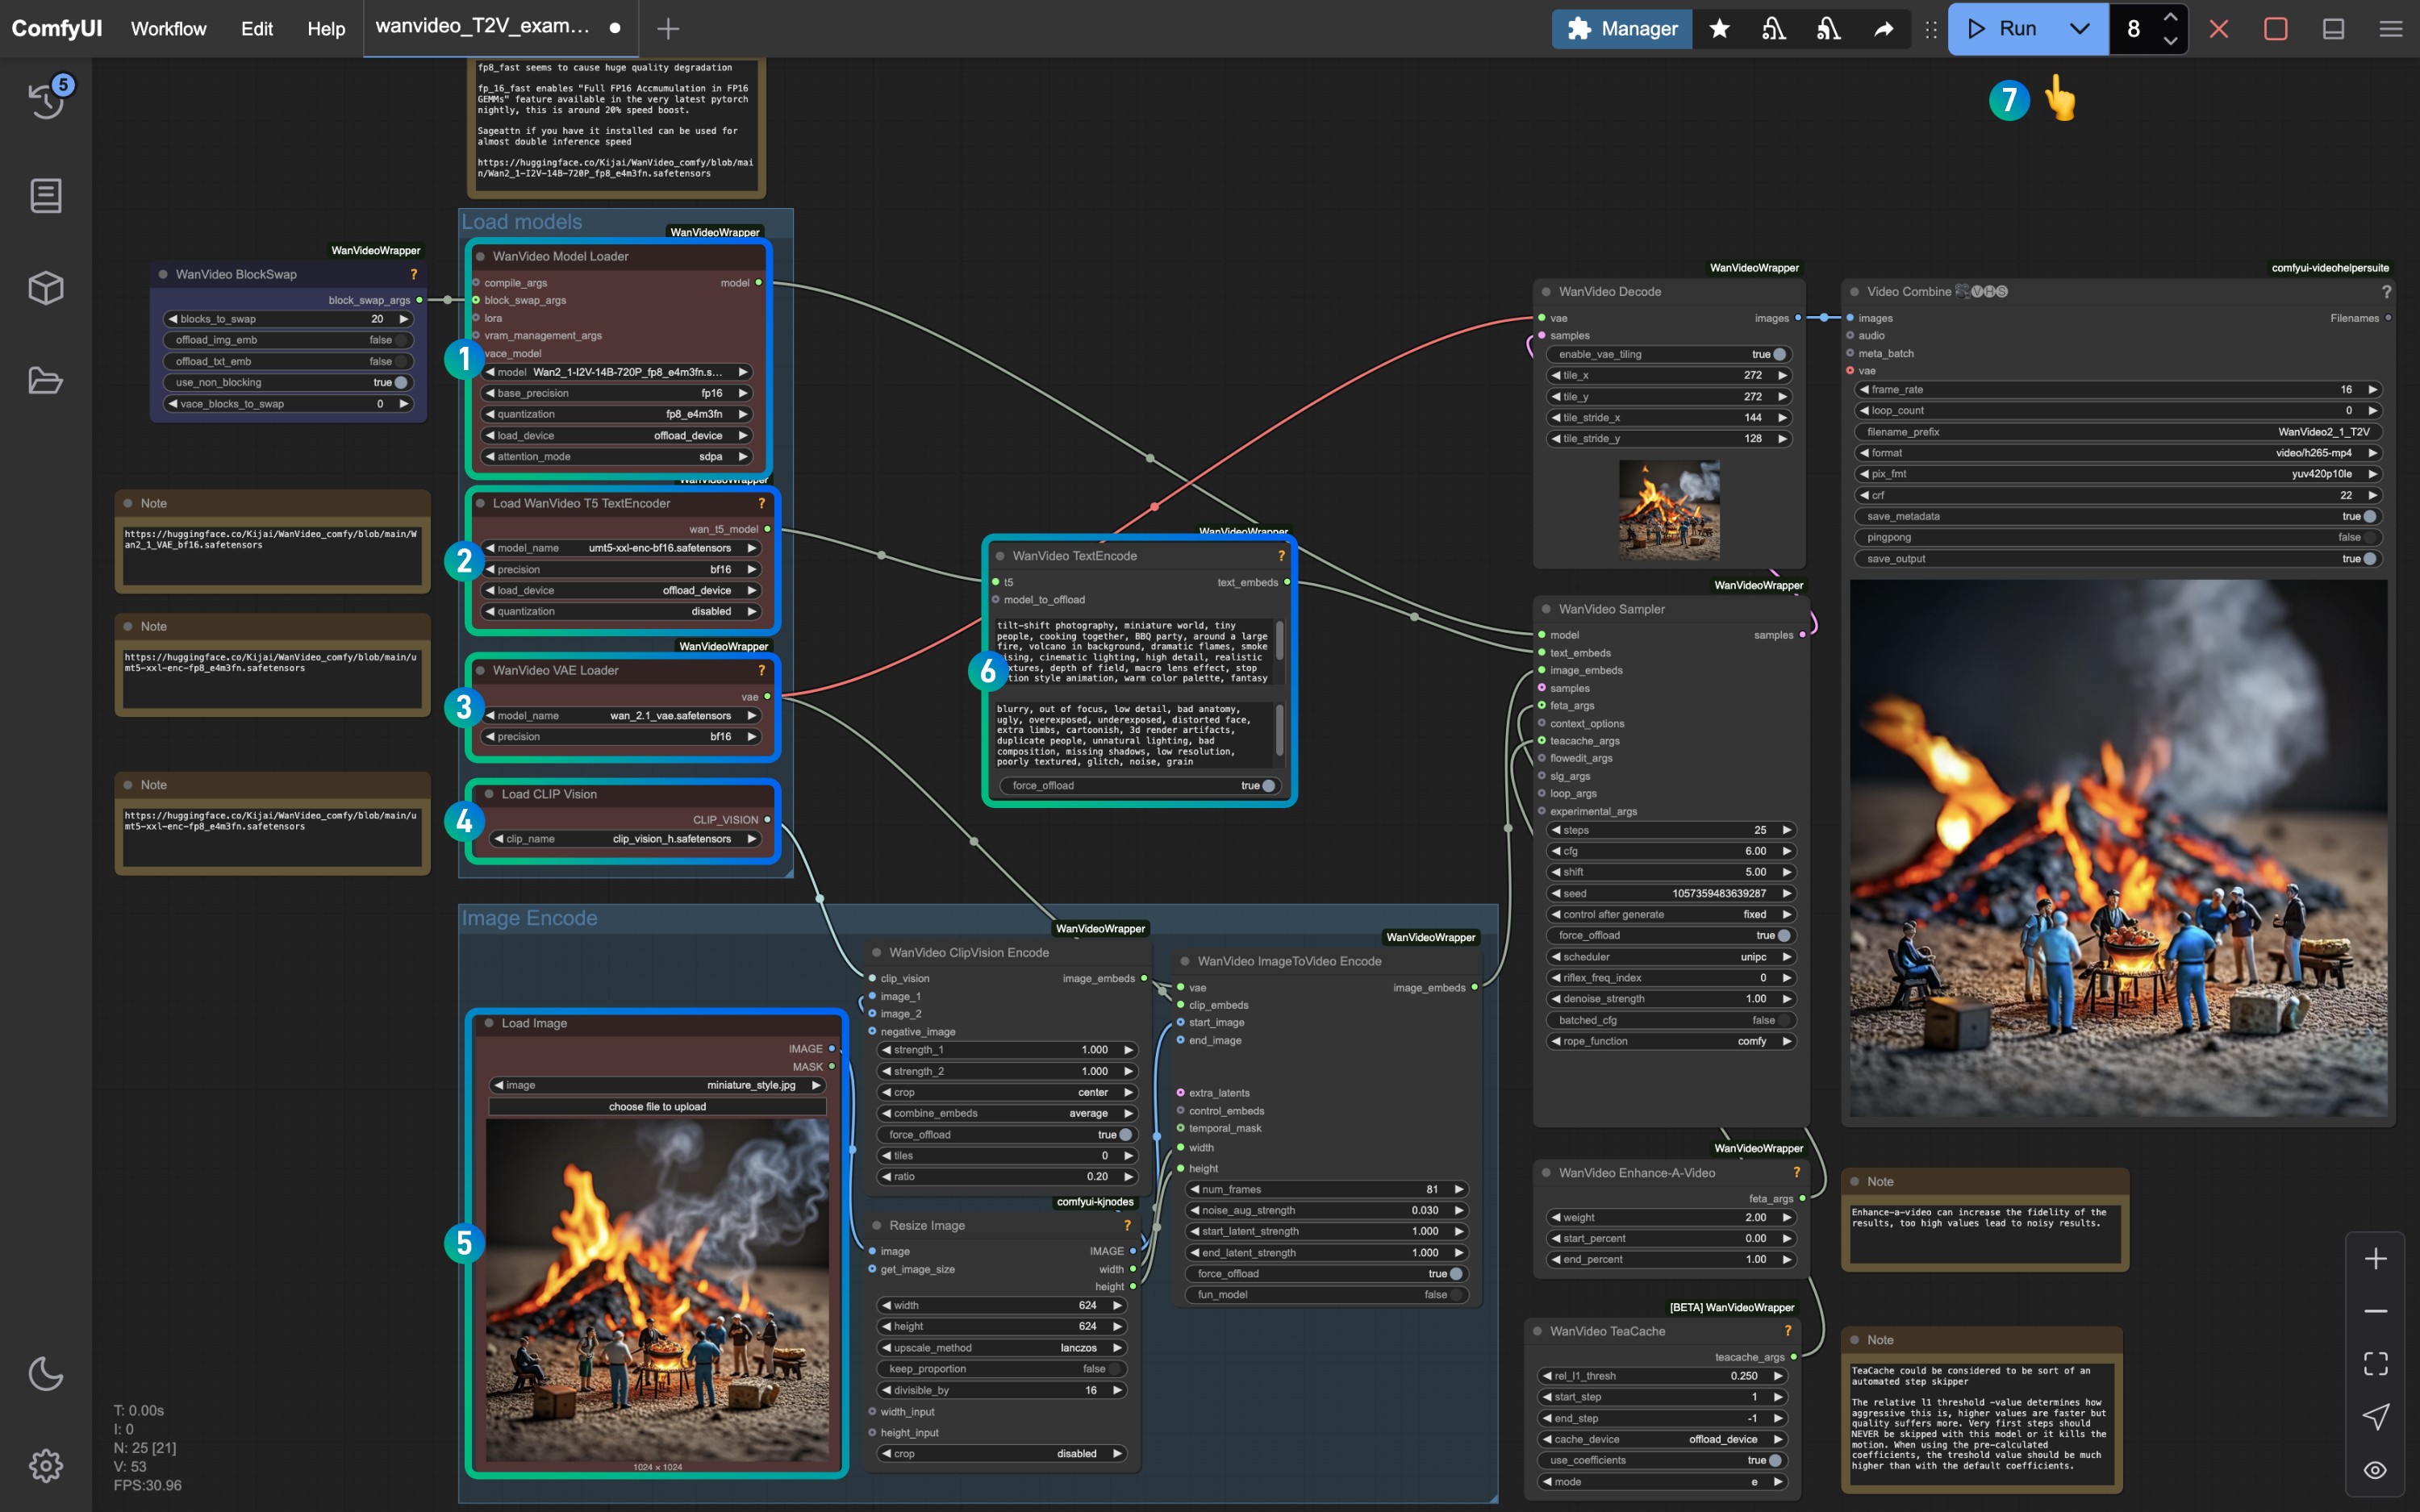
図の番号を参照し、対応するノードとモデルが読み込まれていることを確認して、モデルが正常に動作するようにしてください
WanVideo Model LoaderノードがWan2_1-I2V-14B-720P_fp8_e4m3fn.safetensorsモデルを読み込んでいることを確認しますLoad WanVideo T5 TextEncoderノードがumt5-xxl-enc-bf16.safetensorsモデルを読み込んでいることを確認しますWanVideo Vae LoaderノードがWan2_1_VAE_fp32.safetensorsモデルを読み込んでいることを確認しますLoad CLIP Visionノードがclip_vision_h.safetensorsモデルを読み込んでいることを確認しますLoad Imageノードで入力画像を読み込みます- デフォルトのままにするか、
WanVideo TextEncodeプロンプトを変更して動画の効果を調整します Runボタンをクリックするか、ショートカットCtrl(cmd) + Enter(Enter)を使用して動画生成を実行します
Wan2.1 GGUF版ワークフロー
このパートでは、GGUF版モデルを使用して動画生成を完了します。 モデルリポジトリ: https://huggingface.co/city96/Wan2.1-T2V-14B-gguf/tree/main
該当するモデルを読み込むには ComfyUI-GGUF が必要です。開始する前に該当するカスタムノードをインストールしてください。手順については ComfyUI カスタムノードインストールチュートリアル を参照してください。
1. Wan2.1 GGUF版 テキストから動画へのワークフロー
1.1 ワークフローファイルのダウンロード
1.2 モデルの手動ダウンロード
以下のリストからダウンロードする Diffusion models のモデルファイルを選択してください。 city96は複数の異なるバージョンのモデルを提供しています。https://huggingface.co/city96/Wan2.1-T2V-14B-gguf/tree/main にアクセスして、ご自身に適したバージョンをダウンロードしてください。一般的にファイルが大きいほど効果は良くなりますが、デバイス性能への要求も高くなります。
Text encoders からバージョンを1つ選択してダウンロードしてください。
VAE
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── wan2.1-t2v-14b-Q4_K_M.gguf                   # または選択したバージョン
│   ├── text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors      # または選択したバージョン
│   └── vae/
│       └──  wan_2.1_vae.safetensors
1.3 ワークフローの実行手順
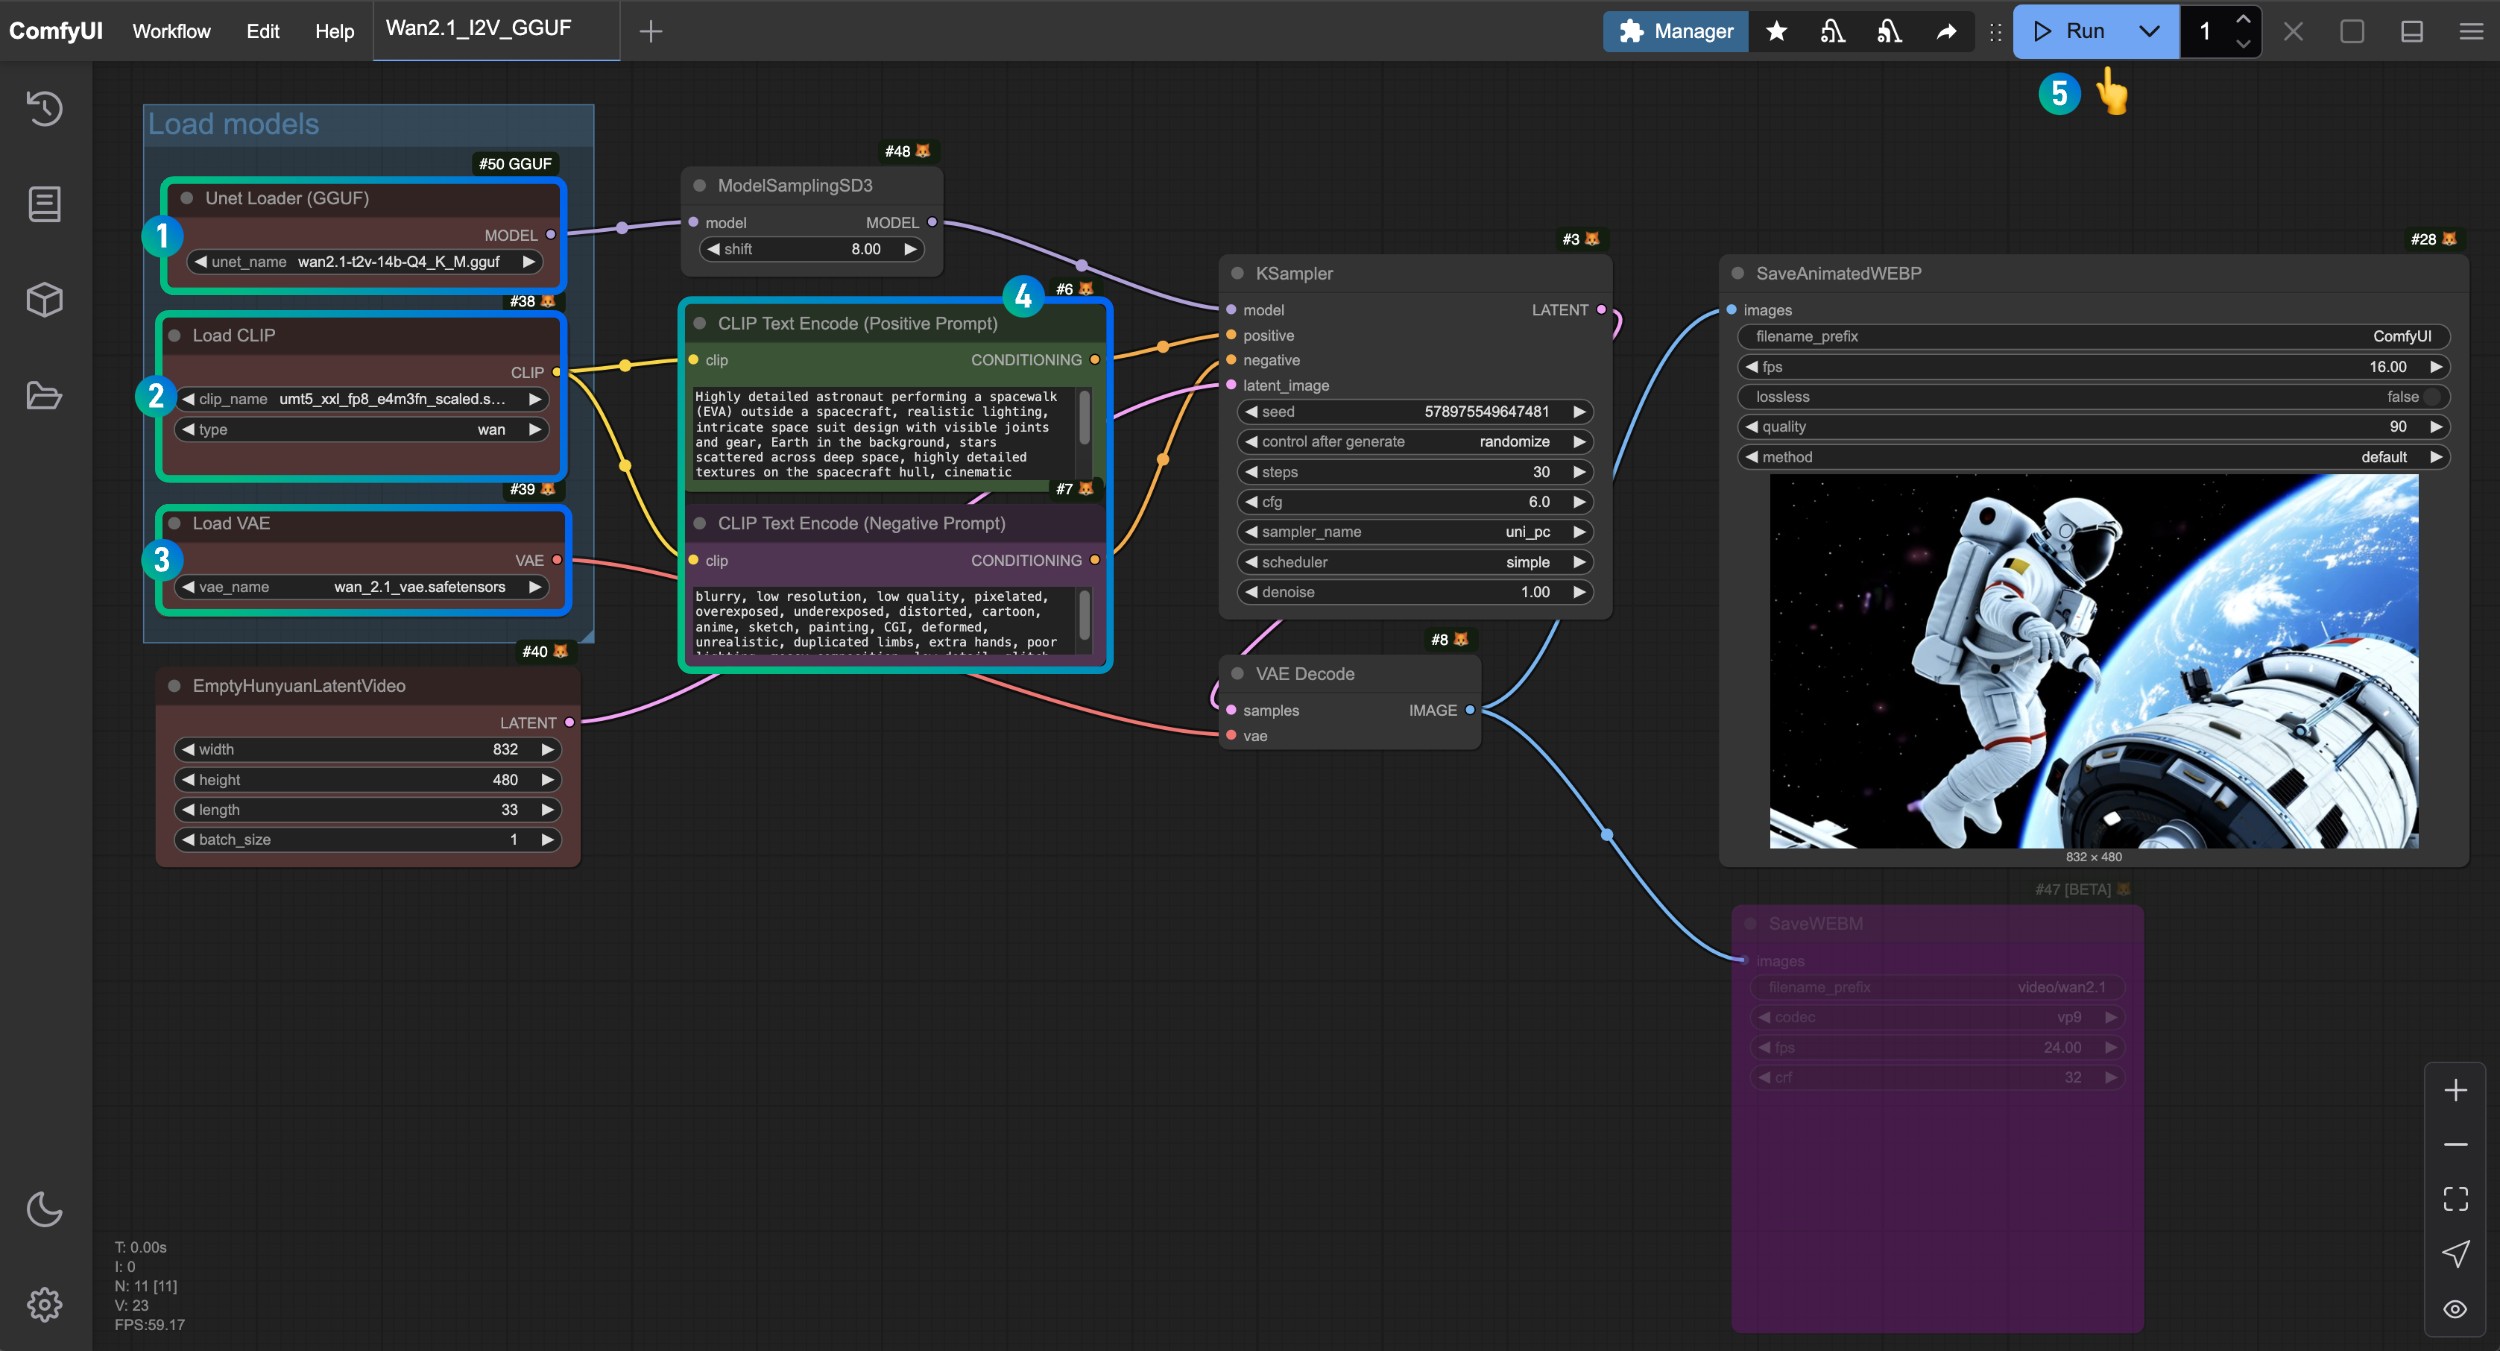
Unet Loader(GGUF)ノードがwan2.1-t2v-14b-Q4_K_M.ggufモデルを読み込んでいることを確認しますLoad CLIPノードがumt5_xxl_fp8_e4m3fn_scaled.safetensorsモデルを読み込んでいることを確認しますLoad VAEノードがwan_2.1_vae.safetensorsモデルを読み込んでいることを確認しますCLIP Text Encoderノードに生成したい動画の説明内容を入力できますRunボタンをクリックするか、ショートカットCtrl(cmd) + Enter(回车)を使用して動画生成を実行します
2. Wan2.1 GGUF版 画像から動画へのワークフロー
2.1 ワークフローファイルのダウンロード
2.2 モデルの手動ダウンロード
以下のリストからダウンロードする Diffusion models のモデルファイルを選択してください。 city96は複数の異なるバージョンのモデルを提供しています。該当するリポジトリにアクセスして、ご自身に適したバージョンをダウンロードしてください。一般的にファイルが大きいほど効果は良くなりますが、デバイス性能への要求も高くなります。
ここでは wan2.1-i2v-14b-Q4_K_M.gguf モデルを使用して例を完成させます。
Text encoders からバージョンを1つ選択してダウンロードしてください。
VAE
ファイルの保存場所
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── wan2.1-i2v-14b-Q4_K_M.gguf                   # または選択したバージョン
│   ├── text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors      # または選択したバージョン
│   └── vae/
│       └──  wan_2.1_vae.safetensors
2.3 ワークフローの実行手順
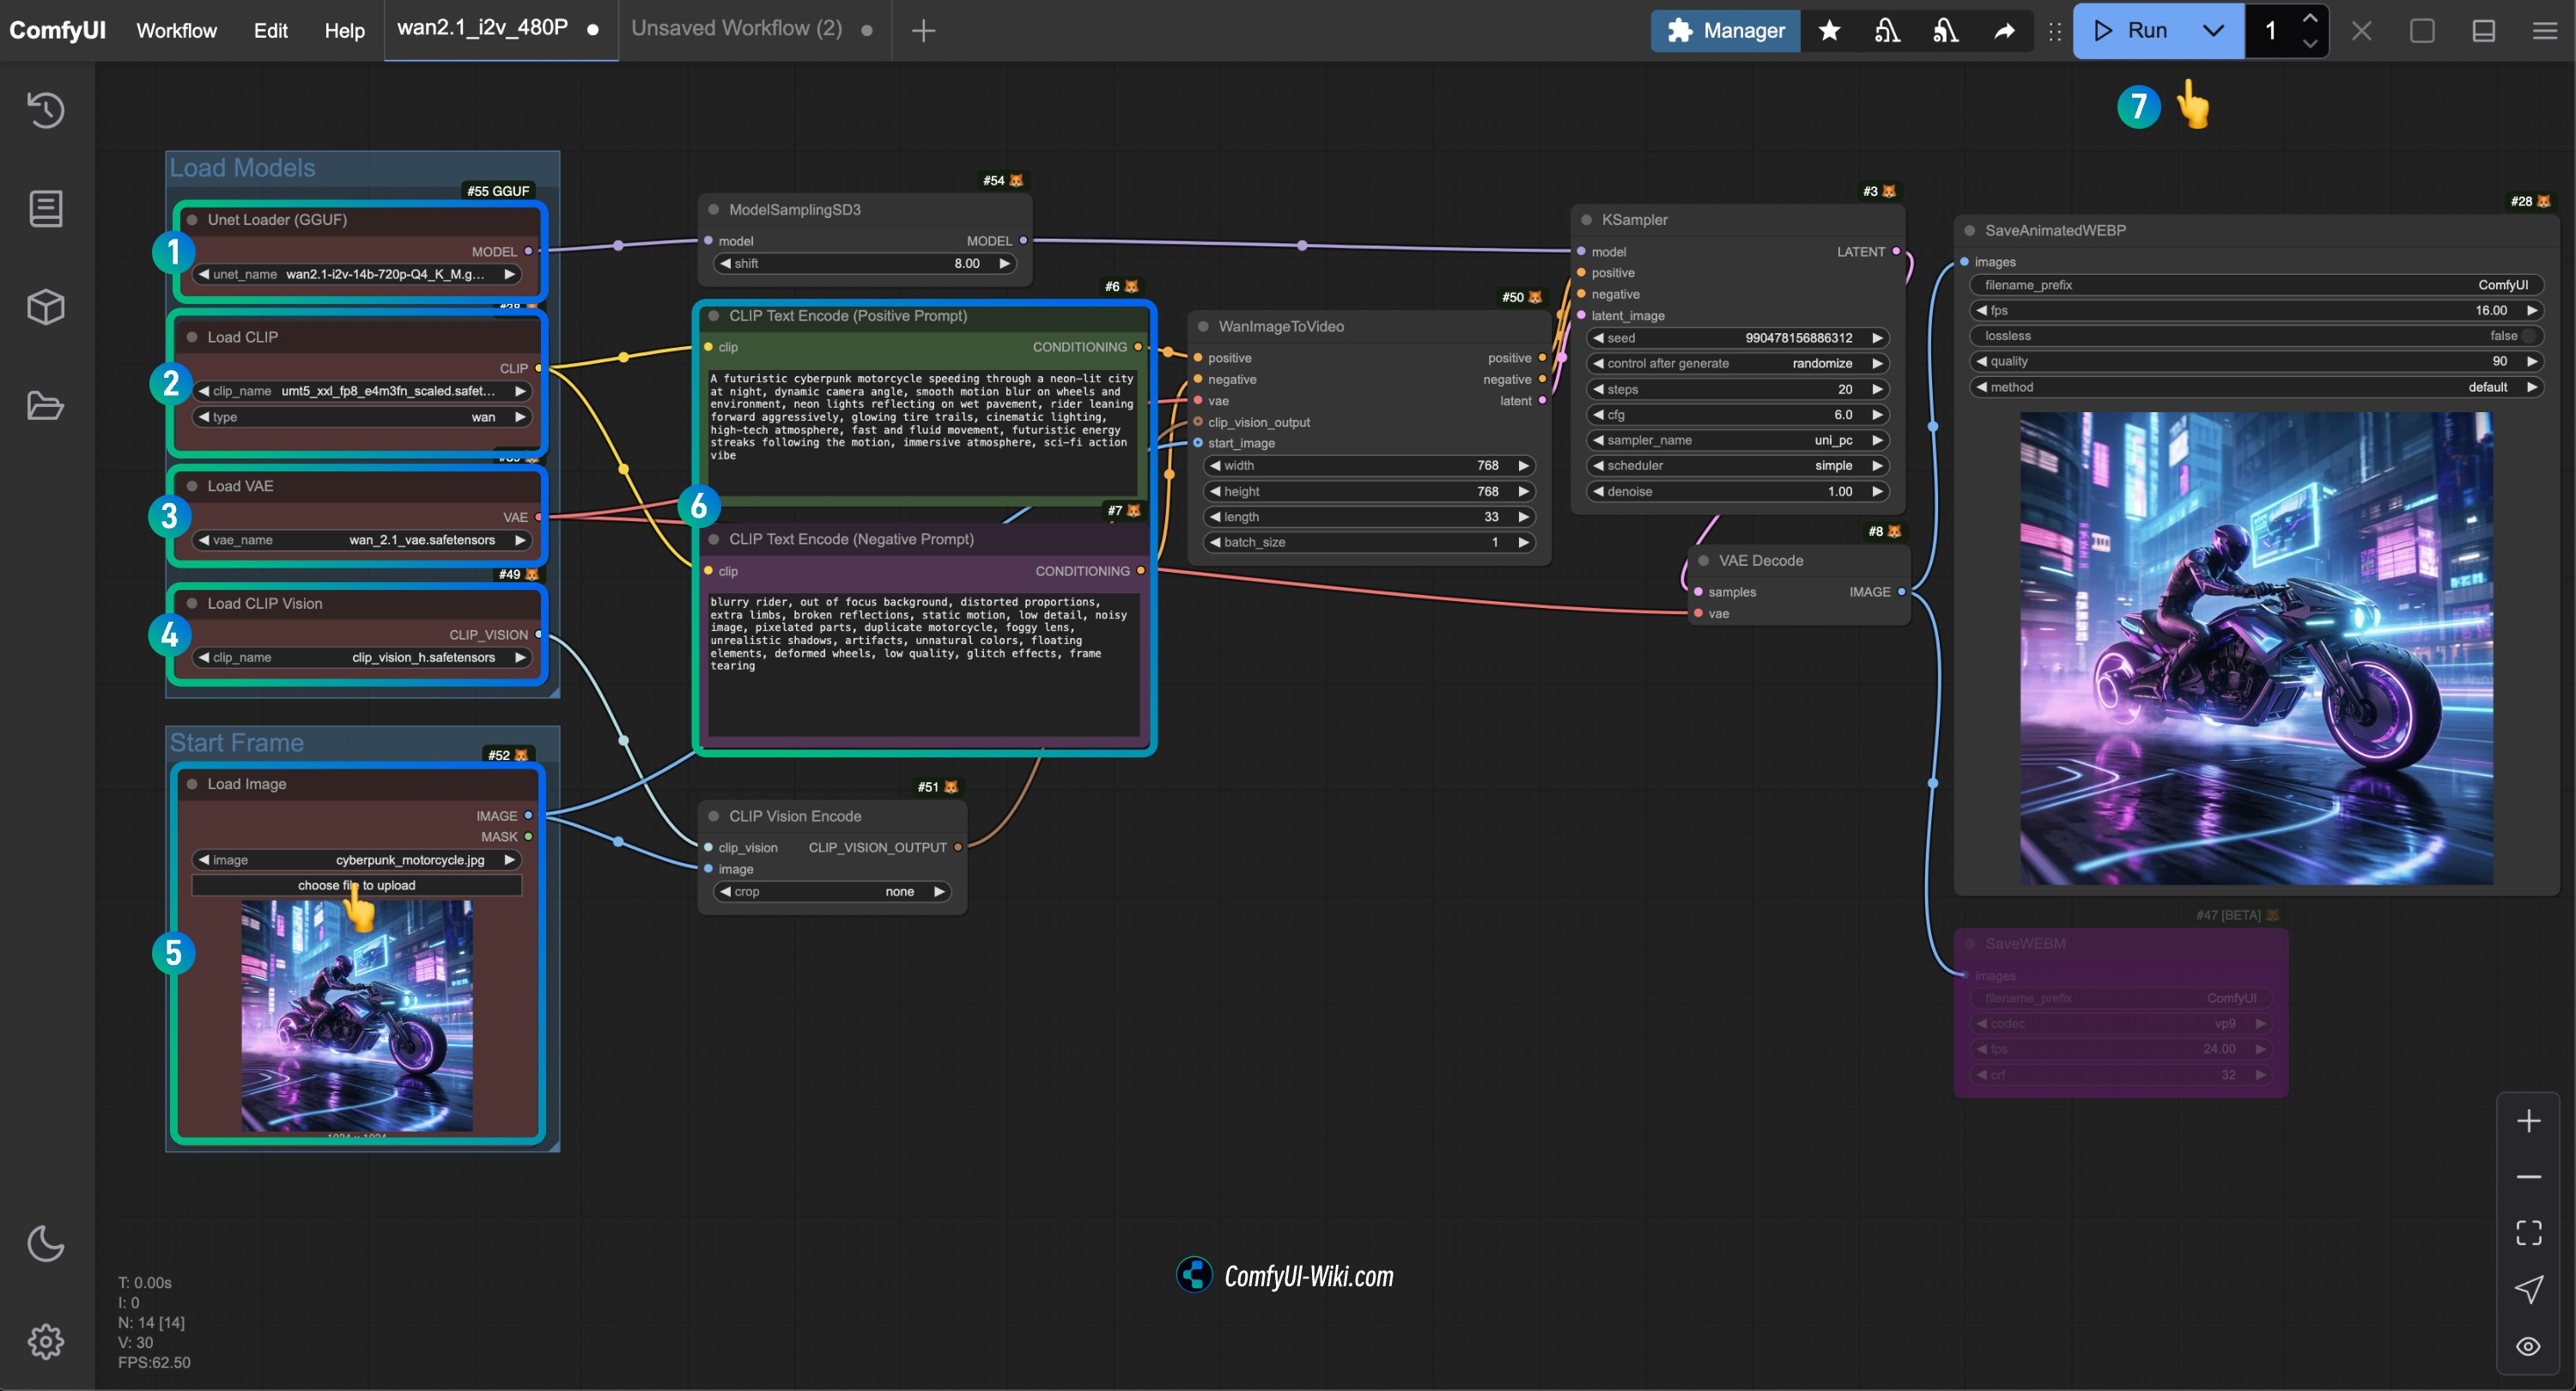
Unet Loader(GGUF)ノードがwan2.1-i2v-14b-Q4_K_M.ggufモデルを読み込んでいることを確認しますLoad CLIPノードがumt5_xxl_fp8_e4m3fn_scaled.safetensorsモデルを読み込んでいることを確認しますLoad VAEノードがwan_2.1_vae.safetensorsモデルを読み込んでいることを確認しますLoad CLIP Visionノードがclip_vision_h.safetensorsモデルを読み込んでいることを確認しますLoad Imageノードで入力画像を読み込みますCLIP Text Encoderノードに生成したい内容を入力するか、ワークフロー内の例を使用しますRunボタンをクリックするか、ショートカットCtrl(cmd) + Enter(Enter)を使用して動画生成を実行します
よくあるご質問
mp4 形式の動画として保存する方法
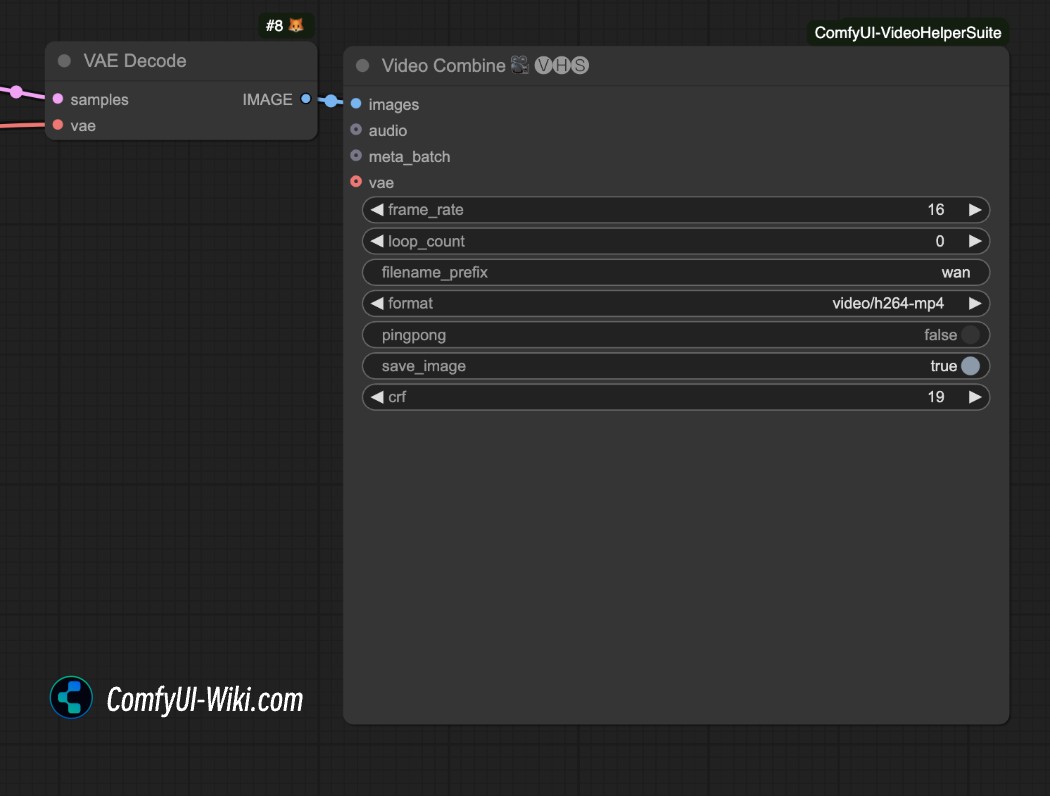
上記の動画生成ワークフローは、デフォルトでは .webp 形式で動画を生成します。他の動画形式で保存したい場合は、ComfyUI-VideoHelperSuite プラグインの video Combine ノードを使って mp4 形式の動画として保存してみてください。
関連リソース
すべてのモデルは Hugging Face と ModelScope でダウンロードできるようになりました:
コメント
GitHubでサインインしてディスカッションに参加しましょう。