ComfyUI Frame Packワークフロー完全チュートリアル:低VRAMで長尺動画を生成
ComfyUIでFramePackを使い低VRAMで長尺動画を生成:Kijai FramePackWrapperのセットアップ、FLF2Vワークフローのダウンロード、最初と最後のフレーム制御、Hunyuan連携を解説。
FramePackは、ControlNetの作者であるスタンフォード大学のLvmin Zhang博士のチームによって開発されたAI動画生成技術です。その主な特徴は以下の通りです:
- 動的コンテキスト圧縮:動画フレームを重要性に基づいて分類し、キーフレームは1536の特徴マーカーを保持する一方、遷移フレームは192に簡略化されます。
- ドリフト耐性サンプリング:双方向メモリ法と逆生成技術を利用して、画像のドリフトを回避し、動作の連続性を確保します。
- VRAM要件の削減:動画生成のためのVRAMしきい値をプロフェッショナルグレードのハードウェア(12GB+)からコンシューマーレベル(わずか6GB VRAM)に下げ、一般ユーザーがRTX 3060ラップトップで最大60秒の高品質動画を生成できるようにします。
- オープンソースと統合:FramePackは現在オープンソース化され、テンセントのHunyuan動画モデルに統合されており、マルチモーダル入力(テキスト+画像+音声)とリアルタイムインタラクティブ生成をサポートしています。
Frame Packに関連するオリジナルリンク
- オリジナルリポジトリ:https://github.com/lllyasviel/FramePack/
- ComfyUIなしでWindowsにワンクリックで実行する統合パッケージ:https://github.com/lllyasviel/FramePack/releases/tag/windows
対応するプロンプト
lllyasvielは対応するリポジトリで動画生成用のGPTプロンプトを提供しています。Frame Packワークフローを使用する際にプロンプトの書き方が分からない場合は、以下を試してみてください:
- 以下のプロンプトをコピーしてGPTに送信します。
- GPTが要件を理解したら、対応する画像を提供すると、適切なプロンプトが得られます。
You are an assistant that writes short, motion-focused prompts for animating images.

When the user sends an image, respond with a single, concise prompt describing visual motion (such as human activity, moving objects, or camera movements). Focus only on how the scene could come alive and become dynamic using brief phrases.

Larger and more dynamic motions (like dancing, jumping, running, etc.) are preferred over smaller or more subtle ones (like standing still, sitting, etc.).

Describe subject, then motion, then other things. For example: "The girl dances gracefully, with clear movements, full of charm."

If there is something that can dance (like a man, girl, robot, etc.), then prefer to describe it as dancing.

Stay in a loop: one image in, one motion prompt out. Do not explain, ask questions, or generate multiple options.
ComfyUI における Frame Pack の現在の実装
現在、ComfyUI で Frame Pack 機能を実装しているカスタムノードの作者は 3 名います:
- Kijai: ComfyUI-FramePackWrapper
- HM-RunningHub: ComfyUI_RH_FramePack
- TTPlanetPig: TTP_Comfyui_FramePack_SE
これらのカスタムノードの違い
以下では、これらのカスタムノードが実装しているワークフローの違いについて説明します。
Kijai のカスタムプラグイン
Kijai は対応するモデルを再パッケージ化しています。Kijai の関連カスタムノードを使ったことがある方も多いと思いますが、これほど迅速なアップデートを提供してくれている彼に感謝します!
Kijai のバージョンは ComfyUI Manager に登録されていないようです。そのため、現在はマネージャーのカスタムノードマネージャーからインストールすることはできません。マネージャーの Git 経由または手動でインストールする必要があります。
特徴:
- 最初と最後のフレームを使った動画生成をサポート
- Git または手動でのインストールが必要
- モデルは再利用可能
HM-RunningHub と TTPlanetPig のカスタムプラグイン
これら 2 つのカスタムノードは、同じコードをベースに改変されたバージョンで、オリジナルは HM-RunningHub によって作成され、その後 TTPlanetPig が対応するプラグインのソースコードをベースに最初と最後のフレームを使った動画生成を実装しました。この PR を確認してください。
これら 2 つのカスタムノードが使用するモデルのフォルダー構造は一致しており、どちらも再パッケージ化されていない元のリポジトリのモデルファイルを使用しています。そのため、これらのモデルファイルはこのフォルダー構造をサポートしていない他のカスタムノードでは使用できず、ディスク容量の使用量が大きくなります。
特徴:
- 最初と最後のフレームを使った動画生成をサポート
- ダウンロード済みのモデルファイルは他のノードやワークフローで再利用できない可能性がある
- モデルファイルが再パッケージ化されていないため、より多くのディスク容量を消費する
- 依存関係に関するいくつかの互換性の問題
Kijai ComfyUI-FramePackWrapper FLF2V ComfyUI ワークフロー
1. プラグインのインストール
ComfyUI-FramePackWrapper は、マネージャーのGitを使用してインストールする必要がある場合があります:
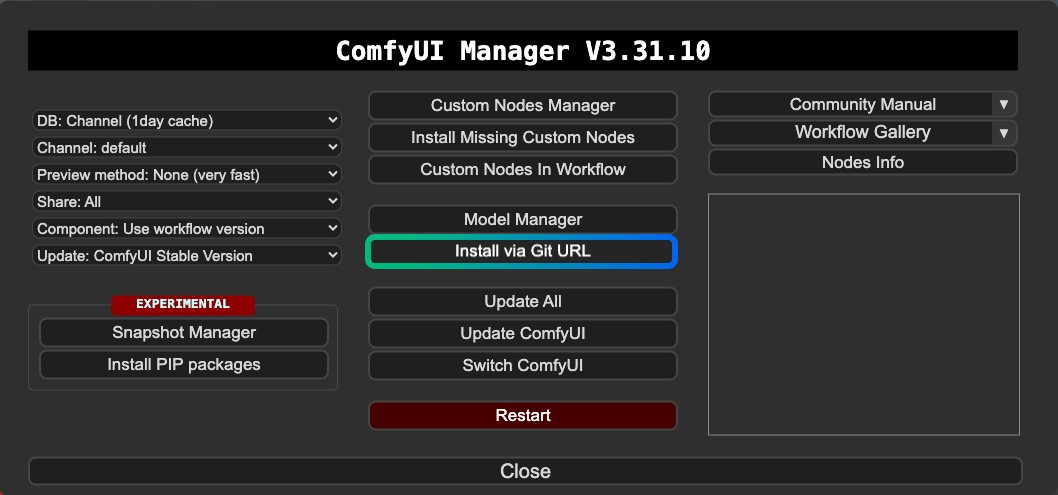
以下の記事が役立つかもしれません:
2. ワークフローファイルのダウンロード
以下の動画ファイルをダウンロードし、ComfyUI にドラッグして対応するワークフローを読み込んでください。ファイルにはモデル情報を追加しているため、モデルのダウンロードを促すメッセージが表示されます。
動画プレビュー
以下の画像をダウンロードしてください。これらを画像入力として使用します。
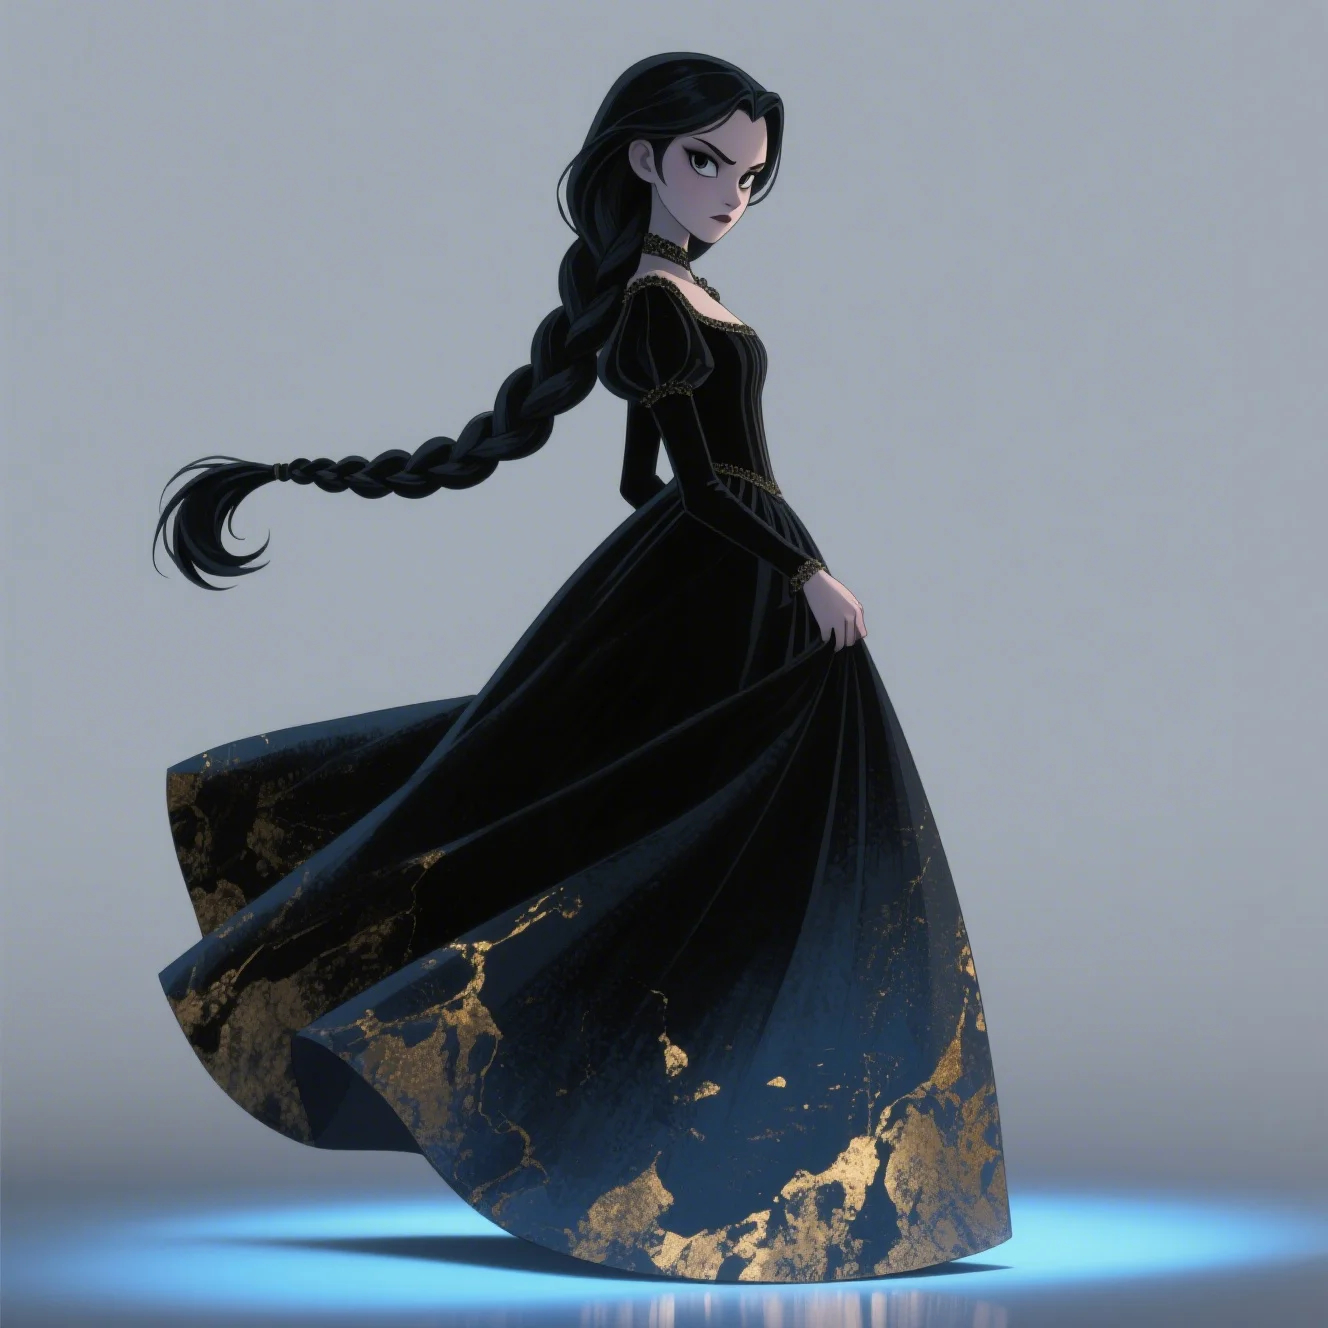
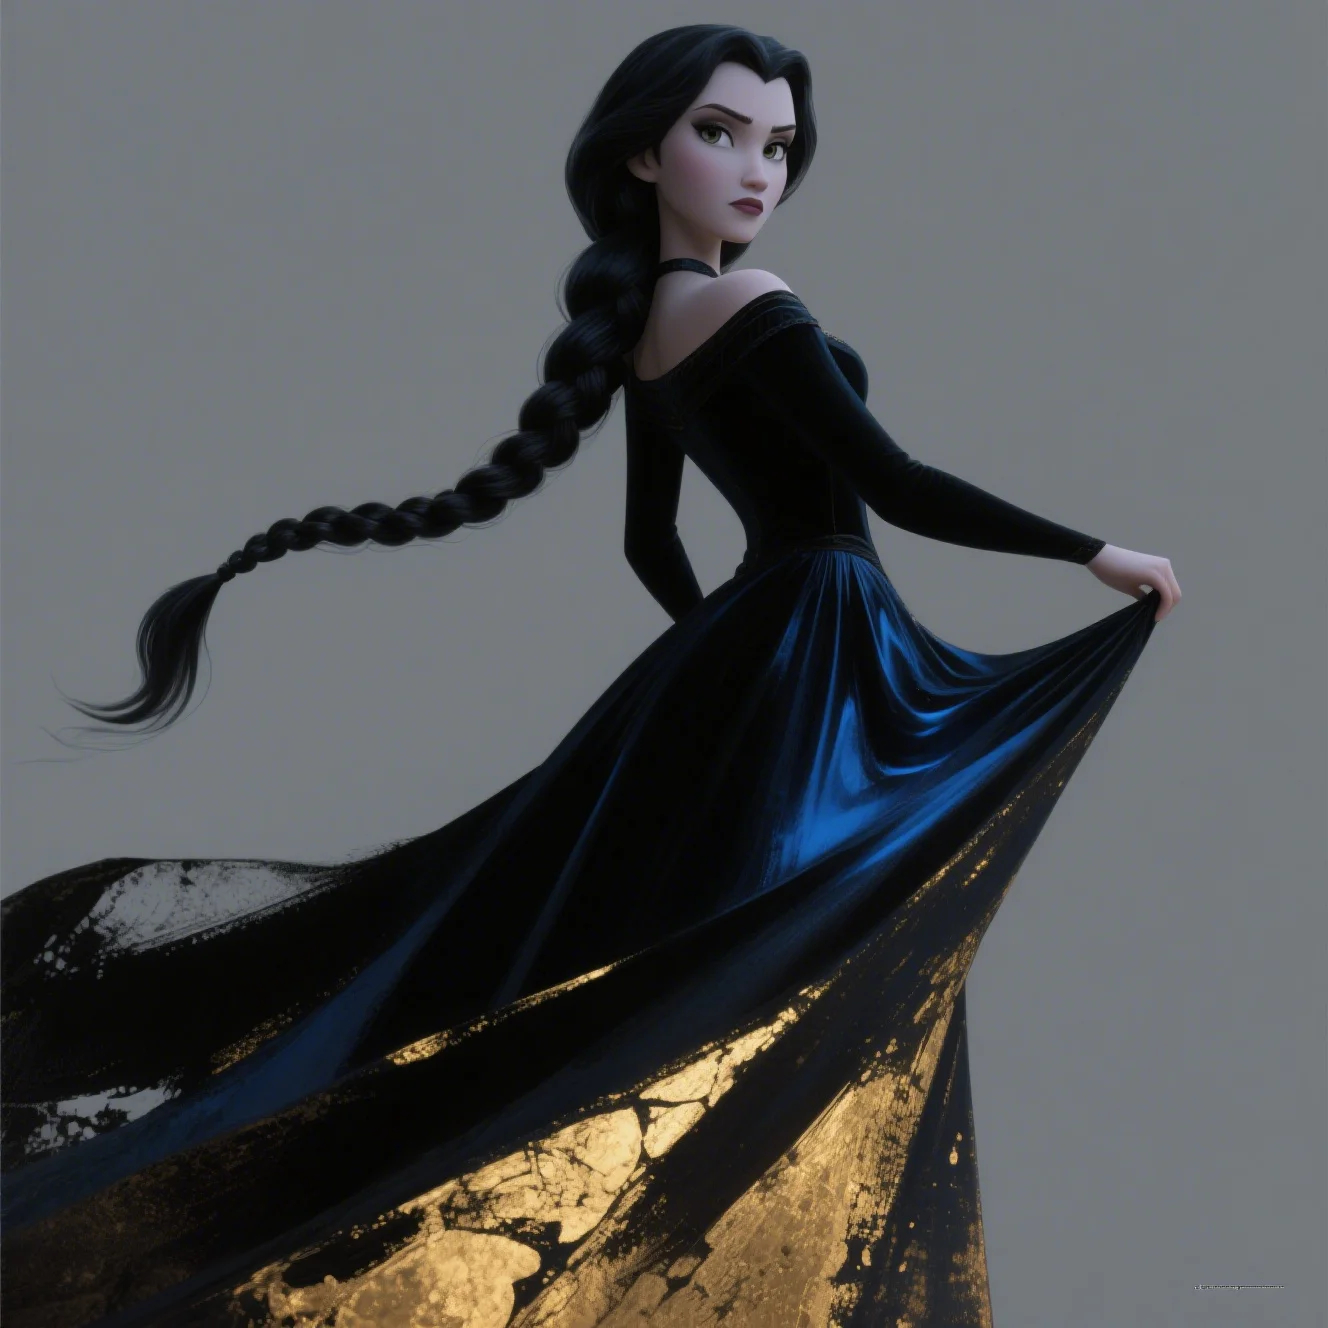
3. 手動でのモデルインストール
ワークフロー内でモデルを正常にダウンロードできない場合は、以下のモデルをダウンロードし、対応する場所に保存してください。
CLIP Vision
VAE
Text Encoder
Diffusion Model Kijai は精度の異なる2つのバージョンを提供しています。グラフィックカードの性能に応じて、いずれかを選択してダウンロードしてください。
| ファイル名 | 精度 | サイズ | ダウンロードリンク | グラフィックカード要件 |
|---|---|---|---|---|
| FramePackI2V_HY_bf16.safetensors | bf16 | 25.7GB | ダウンロードリンク | 高 |
| FramePackI2V_HY_fp8_e4m3fn.safetensors | fp8 | 16.3GB | ダウンロードリンク | 低 |
ファイルの保存場所
📂 ComfyUI/
├──📂  models/
│   ├──📂  diffusion_models/
│   │   └── FramePackI2V_HY_fp8_e4m3fn.safetensors  # or bf16 precision
│   ├──📂  text_encoders/
│   │   ├─── clip_l.safetensors
│   │   └─── llava_llama3_fp16.safetensors
│   ├──📂  clip_vision/
│   │   └── sigclip_vision_patch14_384.safetensors
│   └──📂  vae/
│       └──  hunyuan_video_vae_bf16.safetensors
4. 対応するワークフローを順を追って完成させる
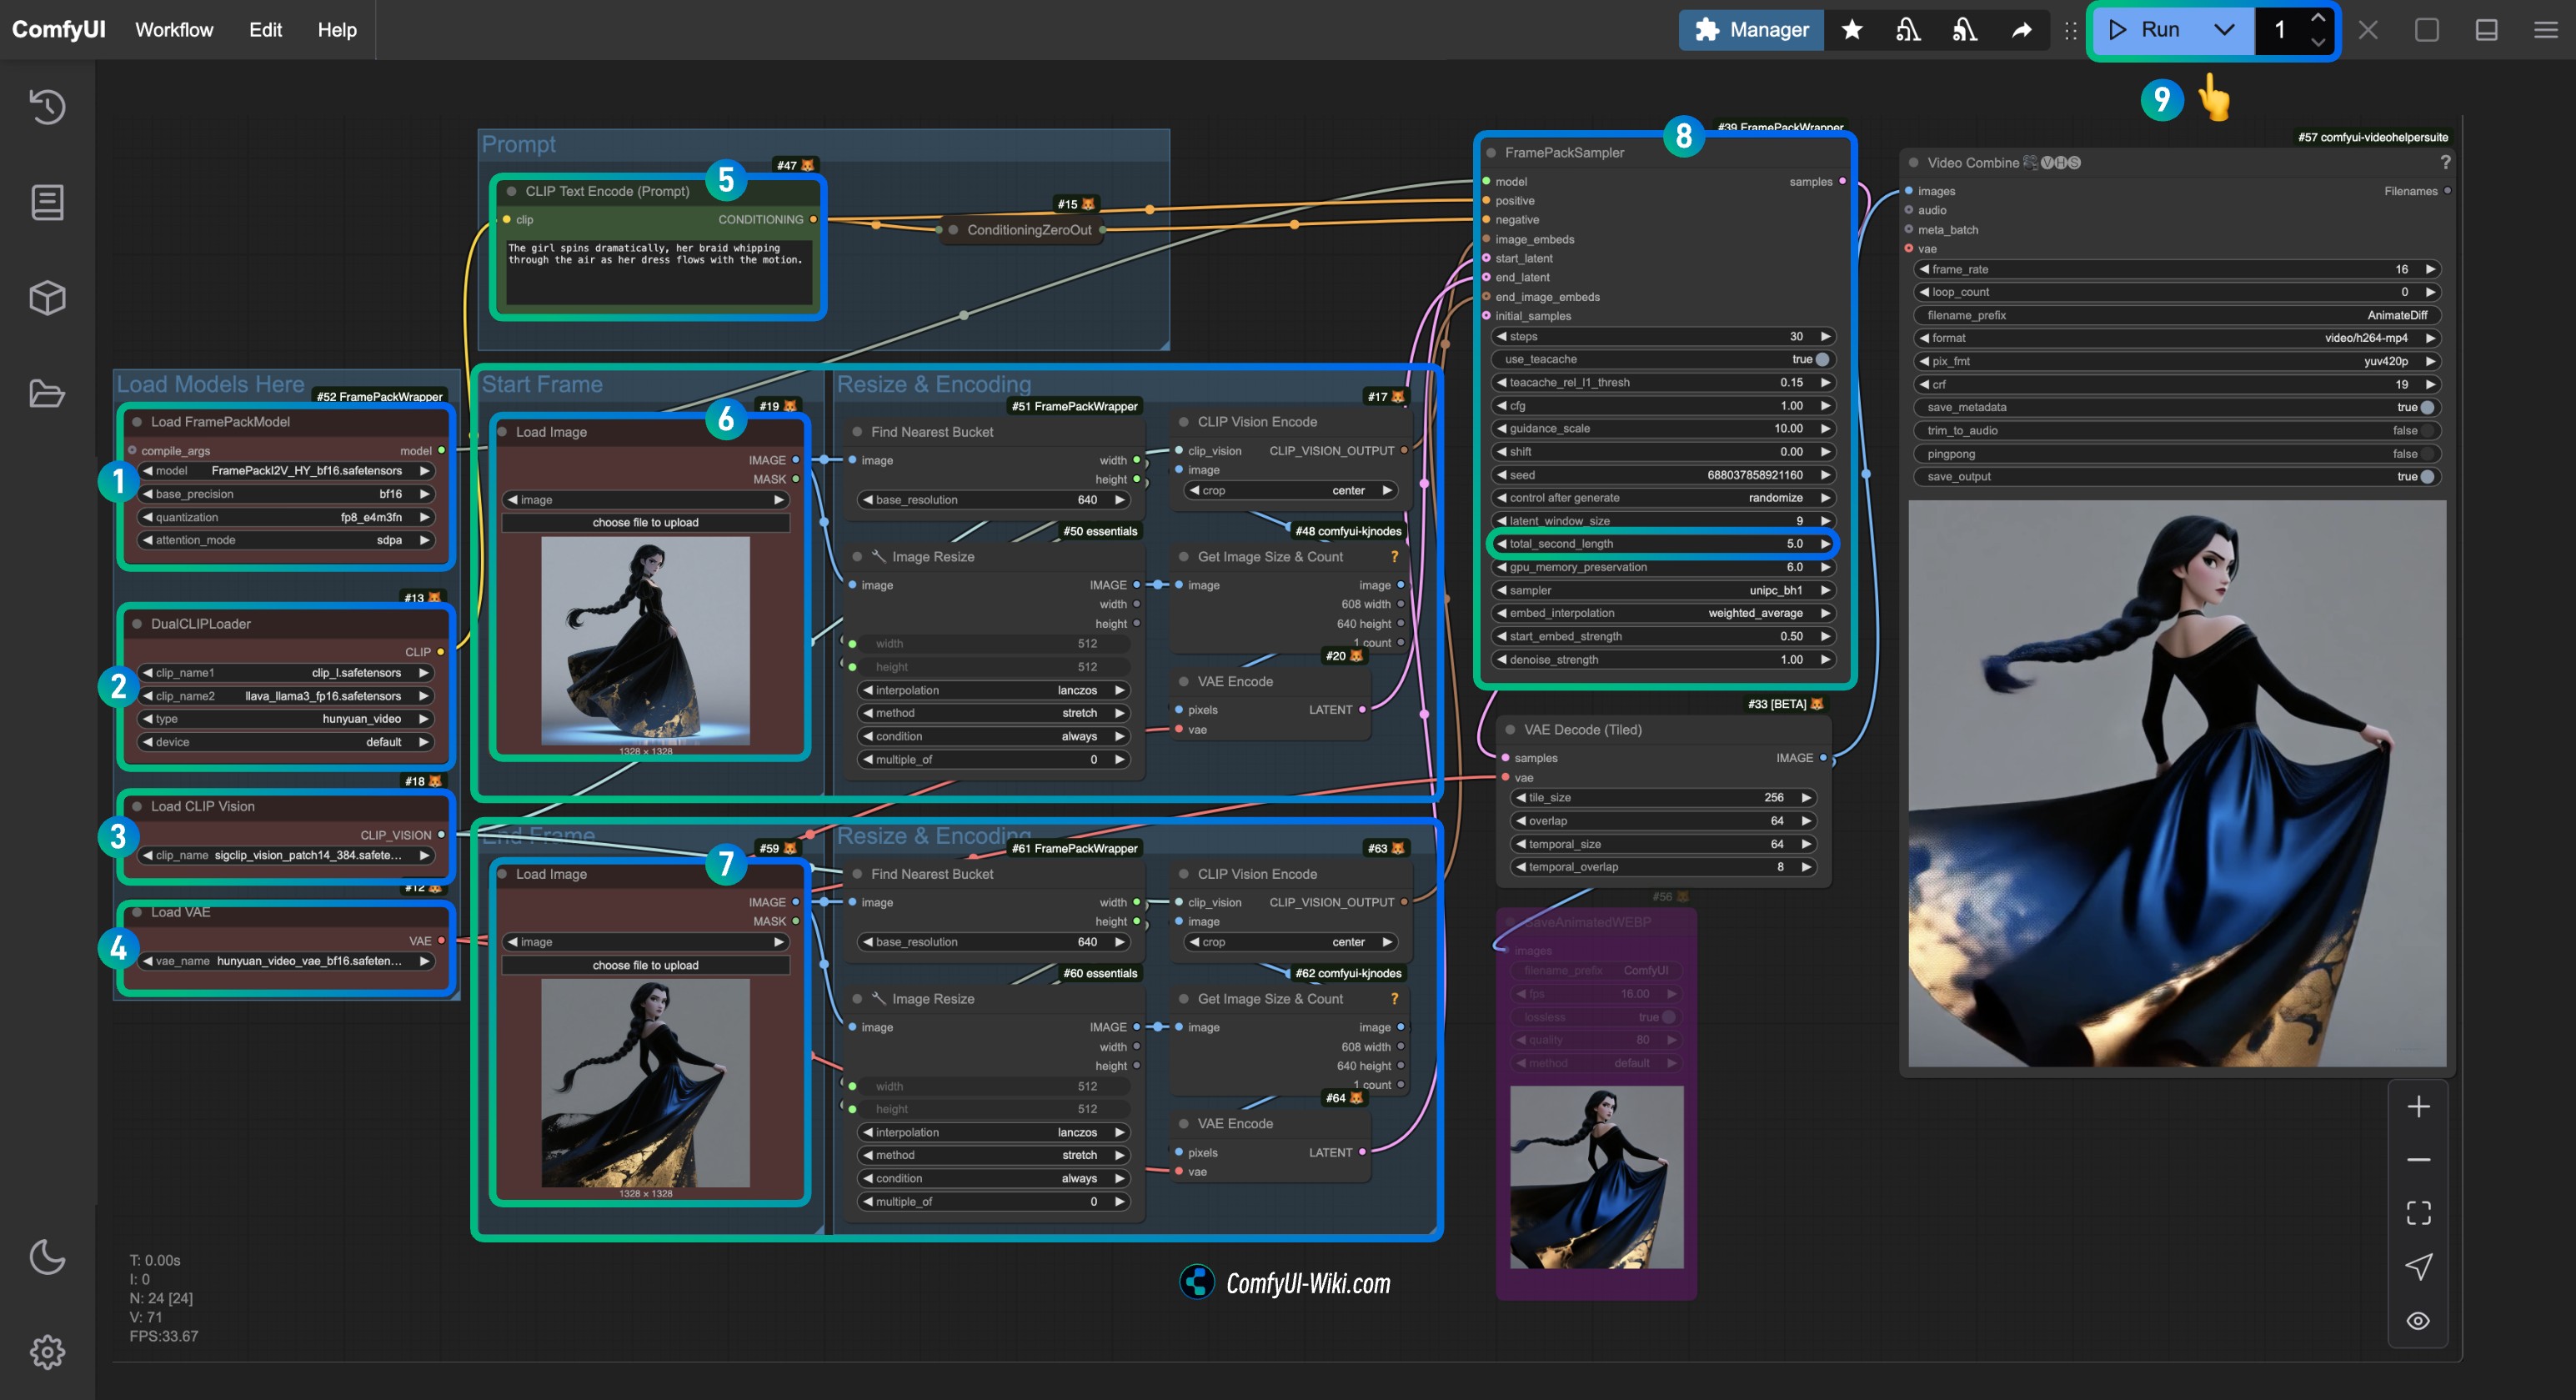
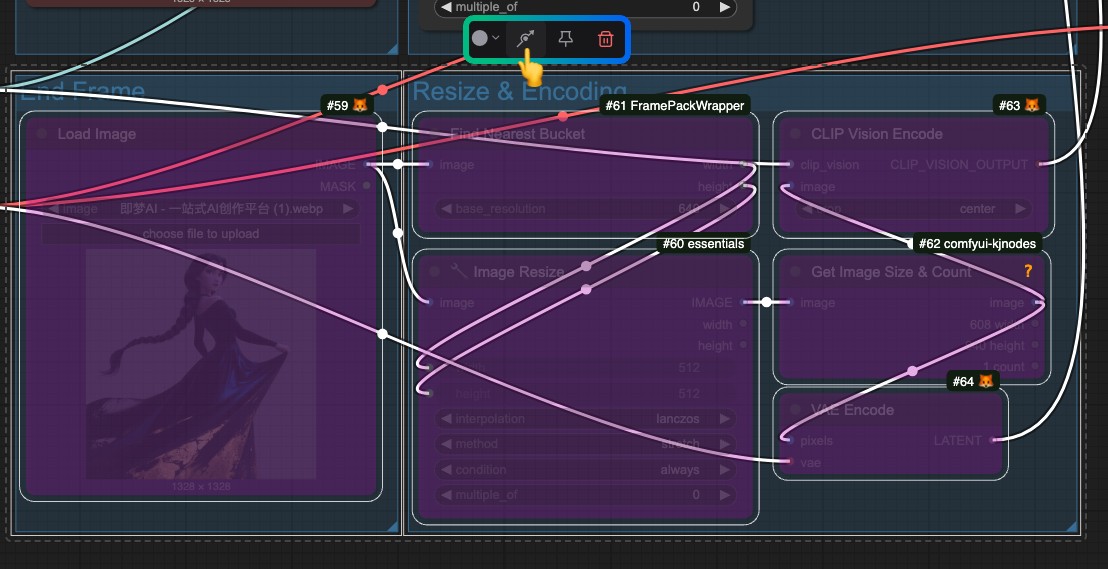
Load FramePackModelノードにFramePackI2V_HY_fp8_e4m3fn.safetensorsモデルが読み込まれていることを確認します。DualCLIPLoaderノードに以下が読み込まれていることを確認します。clip_l.safetensorsモデルllava_llama3_fp16.safetensorsモデル
Load CLIP Visionノードにsigclip_vision_patch14_384.safetensorsモデルが読み込まれていることを確認します。Load VAEノードでhunyuan_video_vae_bf16.safetensorsモデルを読み込むことができます。- (オプション、私の入力画像を使用する場合)
CLIP Text EncoderノードのPromptパラメータを変更し、生成したい動画の説明を入力します。 Load Imageノードでfirst_frame.jpgを読み込みます。これはfirst_frameの入力処理に関連しています。Load Imageノードでlast_frame.jpgを読み込みます。これはlast_frameの入力処理に関連しています(最後のフレームが不要な場合は、削除するか Bypass を使用して無効にできます)。FramePackSamplerノードでtotal_second_lengthパラメータを変更して動画の再生時間を変更できます。私のワークフローでは5秒に設定されていますが、必要に応じて調整してください。Runボタンをクリックするか、ショートカットCtrl(cmd) + Enterを使用して動画生成を実行します。
最後のフレームが不要な場合は、last_frame に関連する入力処理全体をバイパスしてください。
HM-RunningHub と TTPlanetPig プラグインの詳細
これら2つのプラグインは同じモデル保存場所を使用しますが、以前述べたように、オリジナルのリポジトリ全体をダウンロードするため、指定された場所に保存する必要があります。これにより、他のプラグインがこれらのモデルを再利用できなくなり、ディスク容量が多少無駄になります。ただし、最初と最後のフレームの生成は実装されているので、試してみたい場合は試してみてください。
list index out of range の問題が発生しました。このissueを確認できます。現在、考えられる状況として次のように議論されています:
「使用しているtorchvisionのバージョンが、インストール済みのPyAVのバージョンと互換性がない可能性があります。」
しかし、issueで言及されている方法を試しても、問題を解決できませんでした。したがって、ここでは関連するチュートリアル情報のみを提供できます。問題を解決できた場合は、ぜひフィードバックをお寄せください。誰かが同様の解決策を提案しているかどうか、このissueを確認することをお勧めします。
プラグインのインストール
- 以下のいずれか、または両方をインストールできます。ノードは異なりますが、どちらも1つのノードだけで簡単に使用できます:
- HM-RunningHub: ComfyUI_RH_FramePack
- TTPlanetPig: TTP_Comfyui_FramePack_SE
- ComfyUIでの動画編集体験を強化:
動画関連のワークフローでVideoHelperSuiteを使用したことがあるなら、ComfyUIの動画機能を拡張するために依然として重要です。
1. モデルのダウンロード
HM-RunningHubは、すべてのモデルをダウンロードするためのPythonスクリプトを提供しています。このスクリプトを実行し、プロンプトに従うだけです。私の方法は、以下のコードを download_models.py として保存し、ComfyUI/models のルートディレクトリに配置して、対応するディレクトリからターミナルで python download_models.py を実行するというものです。
cd <your installation path>/ComfyUI/models/次にスクリプトを実行します:
python download_models.pyこれには、Pythonの独立環境 / システム環境に huggingface_hub パッケージがインストール済みである必要があります。
from huggingface_hub import snapshot_download

# Download HunyuanVideo model
snapshot_download(
    repo_id="hunyuanvideo-community/HunyuanVideo",
    local_dir="HunyuanVideo",
    ignore_patterns=["transformer/*", "*.git*", "*.log*", "*.md"],
    local_dir_use_symlinks=False
)

# Download flux_redux_bfl model
snapshot_download(
    repo_id="lllyasviel/flux_redux_bfl",
    local_dir="flux_redux_bfl",
    ignore_patterns=["*.git*", "*.log*", "*.md"],
    local_dir_use_symlinks=False
)

# Download FramePackI2V_HY model
snapshot_download(
    repo_id="lllyasviel/FramePackI2V_HY",
    local_dir="FramePackI2V_HY",
    ignore_patterns=["*.git*", "*.log*", "*.md"],
    local_dir_use_symlinks=False
)
以下のモデルを手動でダウンロードし、対応する場所に保存することもできます。これは、対応するリポジトリからすべてのファイルをダウンロードすることを意味します。
- HunyuanVideo: HuggingFace リンク
- Flux Redux BFL: HuggingFace リンク
- FramePackI2V: HuggingFace リンク
ファイルの保存場所
comfyui/models/
  flux_redux_bfl
  ├── feature_extractor
  │   └── preprocessor_config.json
  ├── image_embedder
  │   ├── config.json
  │   └── diffusion_pytorch_model.safetensors
  ├── image_encoder
  │   ├── config.json
  │   └── model.safetensors
  ├── model_index.json
  └── README.md
  FramePackI2V_HY
  ├── config.json
  ├── diffusion_pytorch_model-00001-of-00003.safetensors
  ├── diffusion_pytorch_model-00002-of-00003.safetensors
  ├── diffusion_pytorch_model-00003-of-00003.safetensors
  ├── diffusion_pytorch_model.safetensors.index.json
  └── README.md
  HunyuanVideo
  ├── config.json
  ├── model_index.json
  ├── README.md
  ├── scheduler
  │   └── scheduler_config.json
  ├── text_encoder
  │   ├── config.json
  │   ├── model-00001-of-00004.safetensors
  │   ├── model-00002-of-00004.safetensors
  │   ├── model-00003-of-00004.safetensors
  │   ├── model-00004-of-00004.safetensors
  │   └── model.safetensors.index.json
  ├── text_encoder_2
  │   ├── config.json
  │   └── model.safetensors
  ├── tokenizer
  │   ├── special_tokens_map.json
  │   ├── tokenizer_config.json
  │   └── tokenizer.json
  ├── tokenizer_2
  │   ├── merges.txt
  │   ├── special_tokens_map.json
  │   ├── tokenizer_config.json
  │   └── vocab.json
  └── vae
      ├── config.json
      └── diffusion_pytorch_model.safetensors
2. ワークフローのダウンロード
HM-RunningHub
TTPlanetPig

コメント
GitHubでサインインしてディスカッションに参加しましょう。