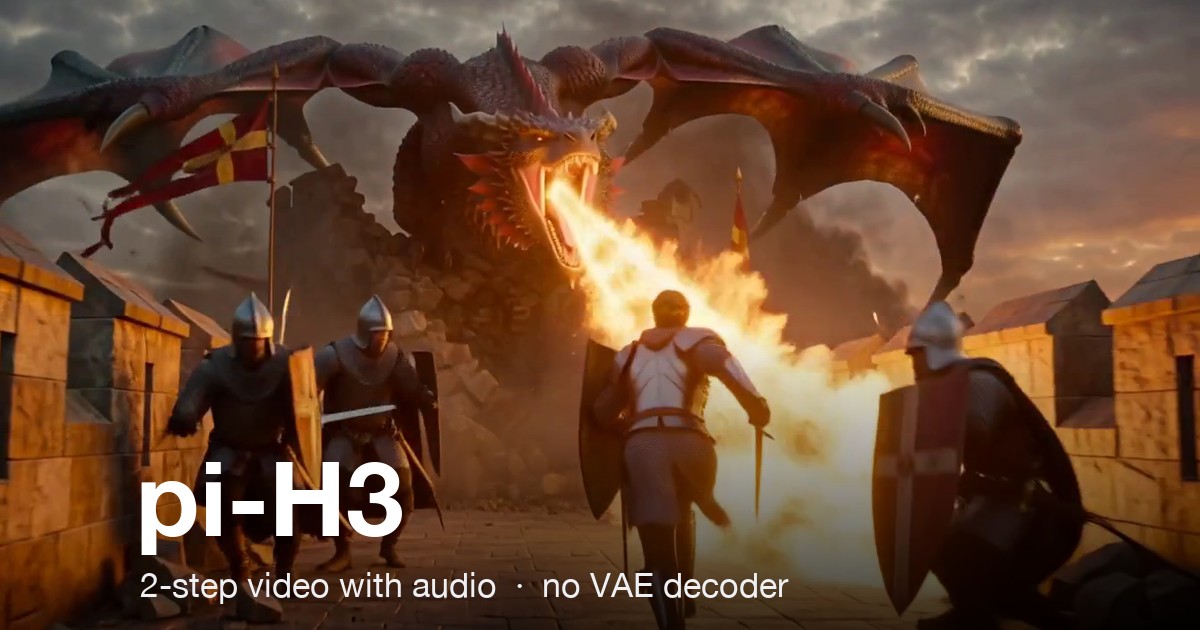
 テキスト→動画
LoRA
pi-H3がMiniMax H3動画をComfyUIで2〜4ステップに短縮pi-H3アダプターは、音声付きのMiniMax H3動画をComfyUIで2ステップまたは4ステップに短縮します。さらにVAEデコーダーを省略する実験的な経路も用意されています。重みも公開済みです。
minimax-h3-community-license-agreement
ComfyUI エコシステムの最新情報:オープンソースモデルのリリース、カスタムノード、ワークフロー、ツールのアップデート。
テキスト→動画pi-H3アダプターは、音声付きのMiniMax H3動画をComfyUIで2ステップまたは4ステップに短縮します。さらにVAEデコーダーを省略する実験的な経路も用意されています。重みも公開済みです。
minimax-h3-community-license-agreement
 テキスト→画像
Seedream 5.5 のコントラスト、ライティング、グレインを加える rank-16 の MiniMax-H3-Image スタイル LoRA。ComfyUI 用の 4 分割比較ボード 20 枚付き。
minimax-h3-image-community-license-agreement
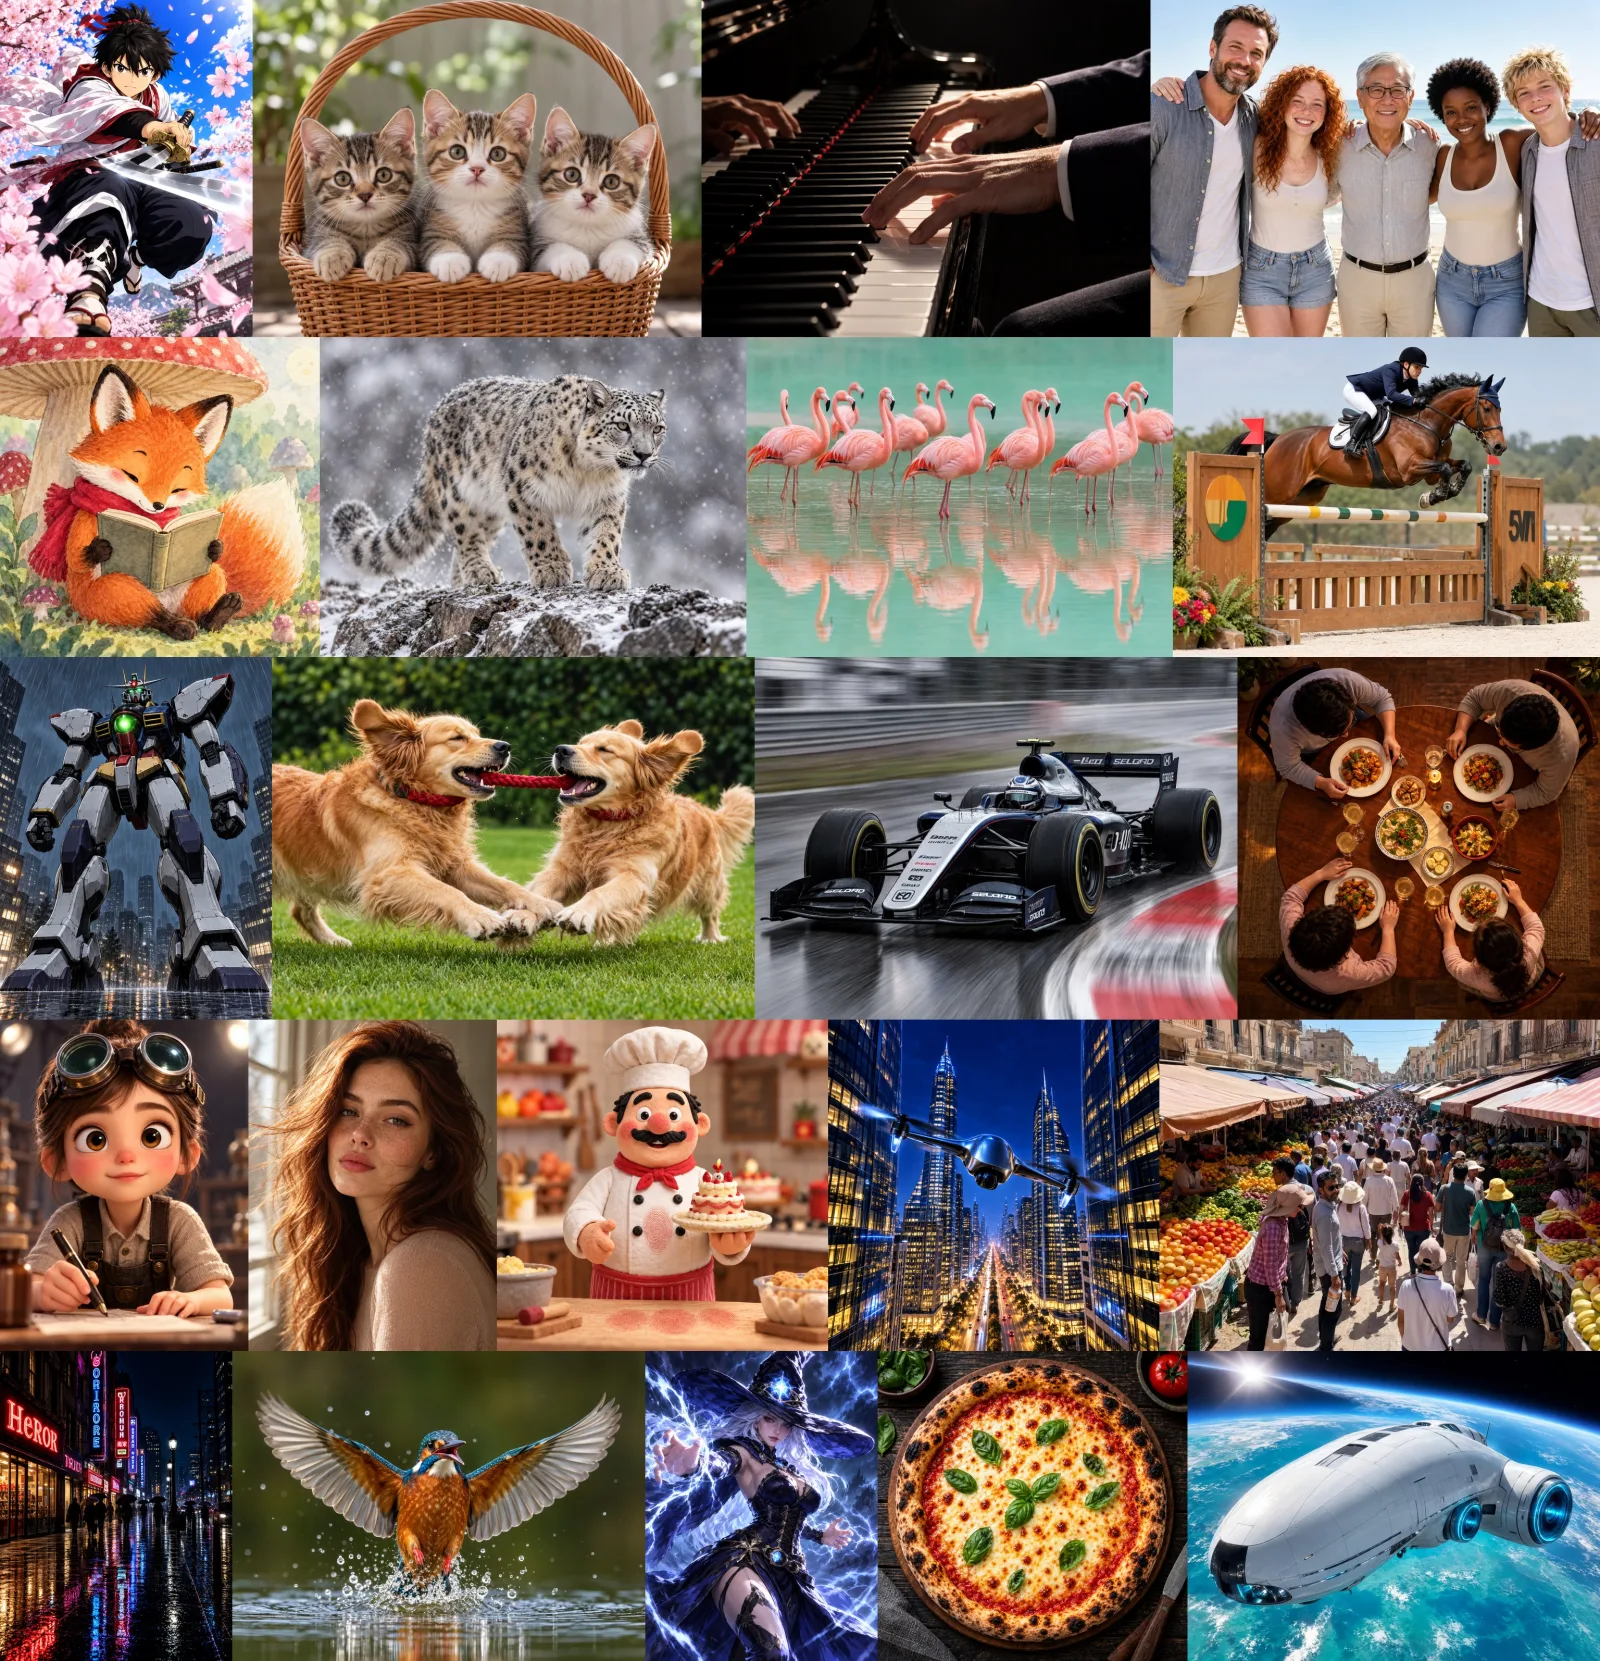 テキスト→画像
rank-64のComfyUI LoRAを使えば、MOSS-Image-SFTをCFG 3の50ステップではなくCFG 1の4ステップで実行でき、細かいテクスチャは50ステップの教師モデルを上回ると測定されています。
Apache-2.0
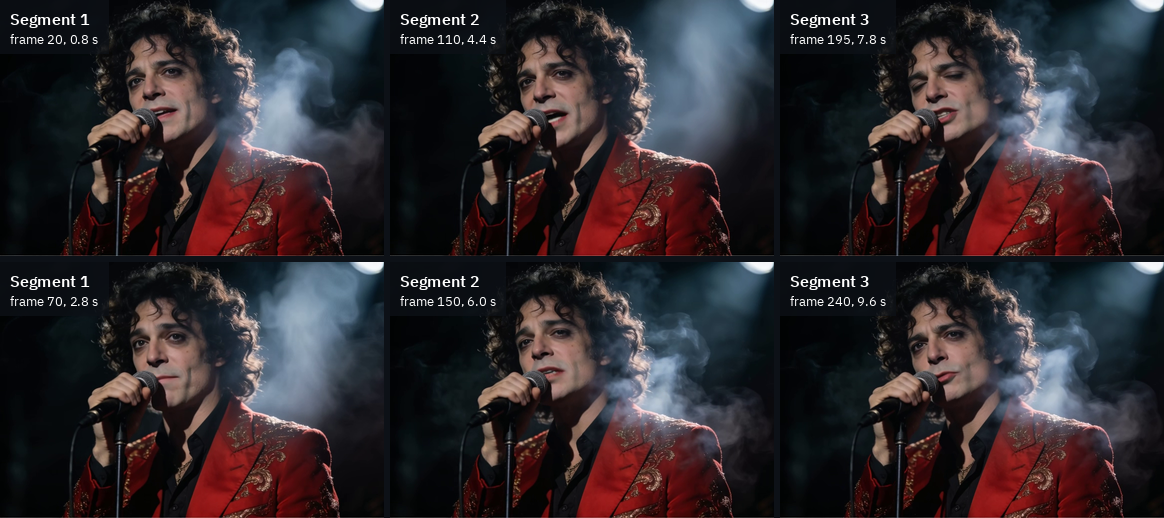 キャラクターアニメ
Meituanの音声駆動アバターモデルがComfyUIで動作します: Comfy-Orgによる重みの再パッケージ化、コミュニティ製ネイティブノードパック、レビュー中のコアサポートを解説します。
MIT
 エコシステム
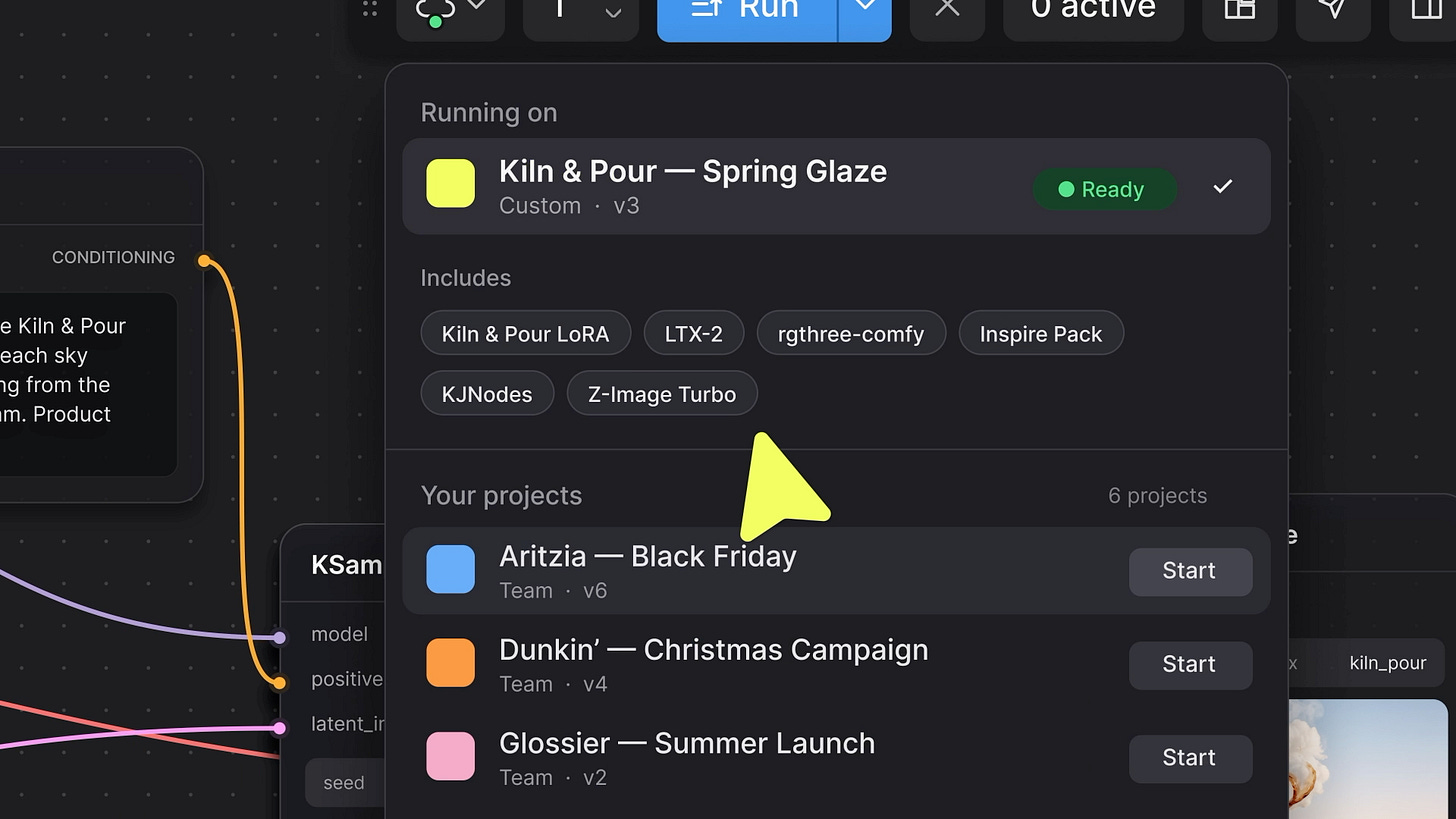
カスタムビルドはカスタムノード、モデル、LoRA、依存関係を1つのセットアップにまとめ、Comfy Cloud で標準のノードリストでは実行できないワークフローを開けるようにします。
 テキスト→動画
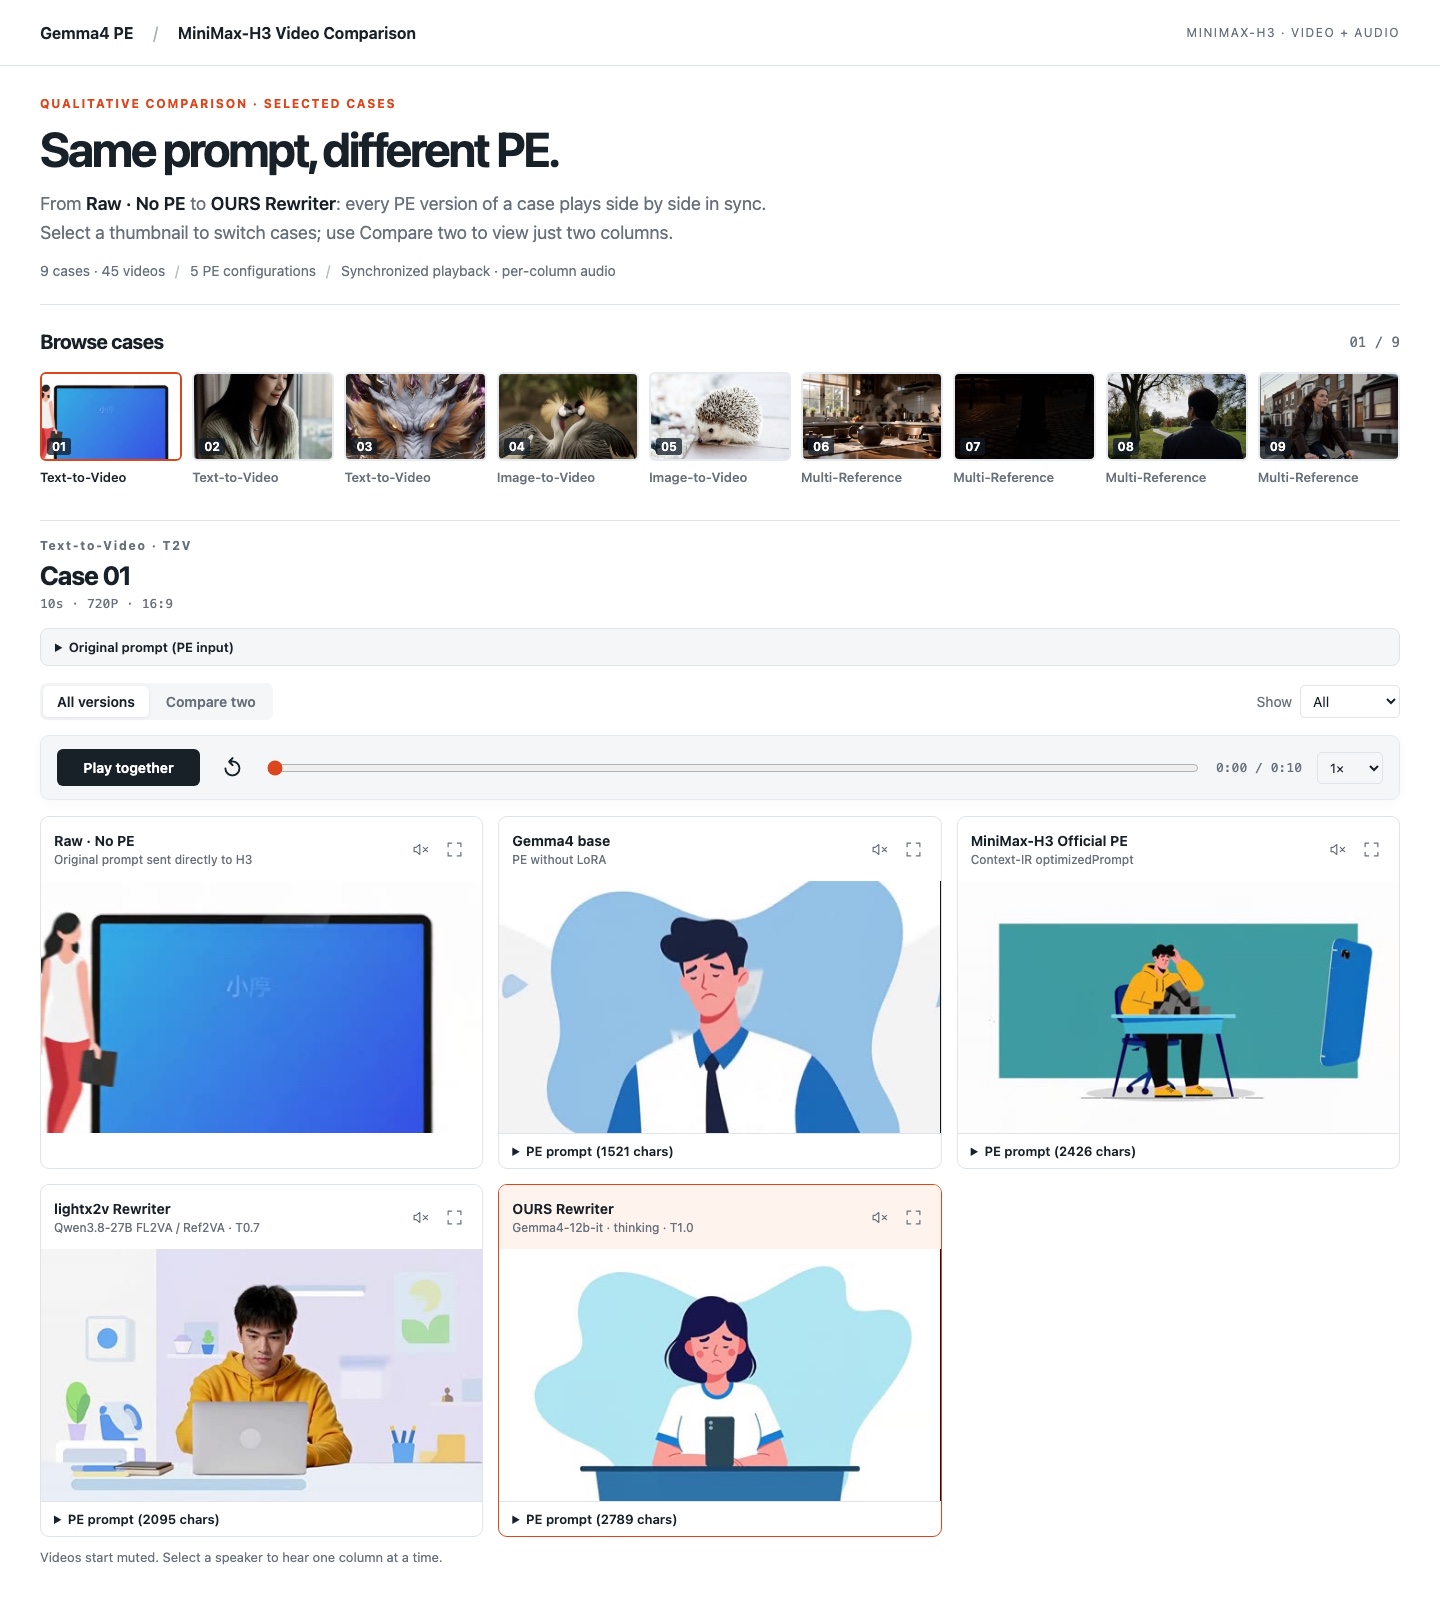
Wuli-Art は Gemma-4-12B を MiniMax H3 向けプロンプト拡張モデルにファインチューニングしました。FL2VA と Ref2VA で共通の重みセット、fp8 で 13 GB、ComfyUI ワークフローは 2 種類です。
Apache-2.0
 テキスト→動画
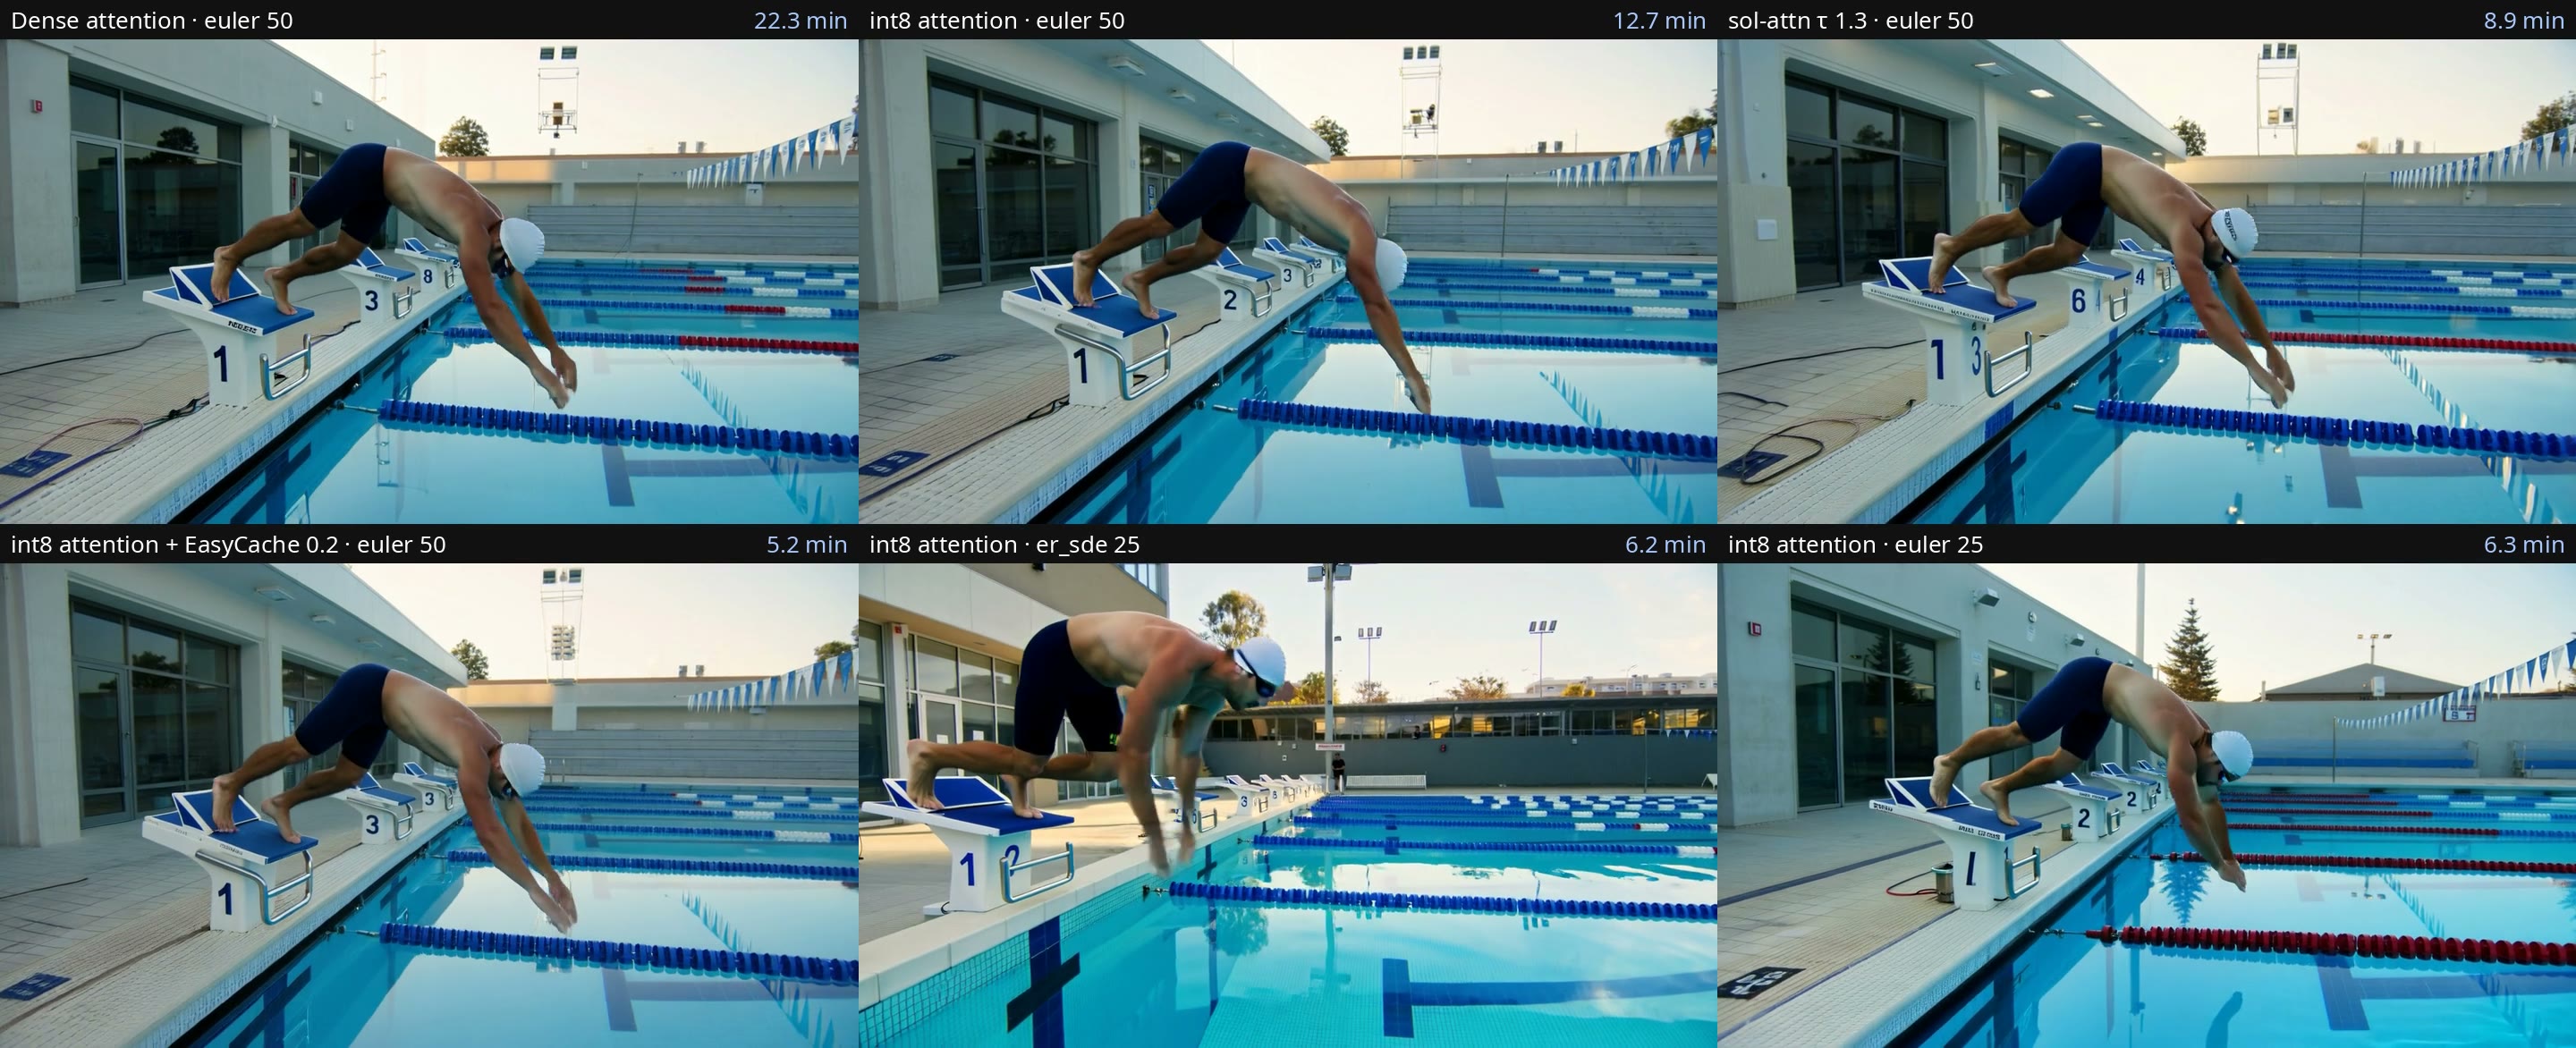
MBZUAIの29BワールドモデルPAN 2が、Kijai氏のコアPRによりComfyUIで読み込めるようになりました。int8ウェイトで26.7 GB、RTX 5090で241フレームを15.2秒/ステップで生成します。
 エコシステム
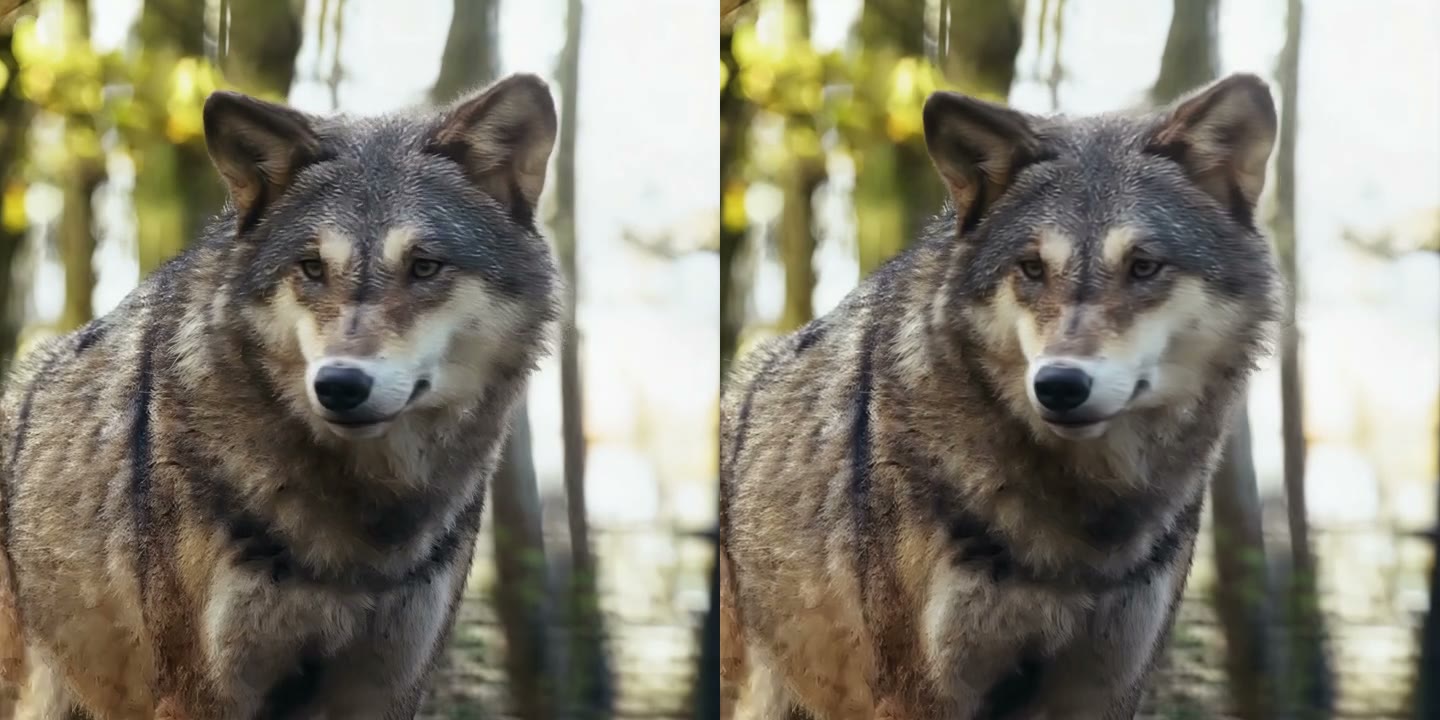
ComfyUI コアに Kijai の Video Deflicker ノードが入りました。フレームごとに処理した映像のちらつきを除去し、ネイティブ RAFT のフローは torchvision より約 2.3 倍高速です。
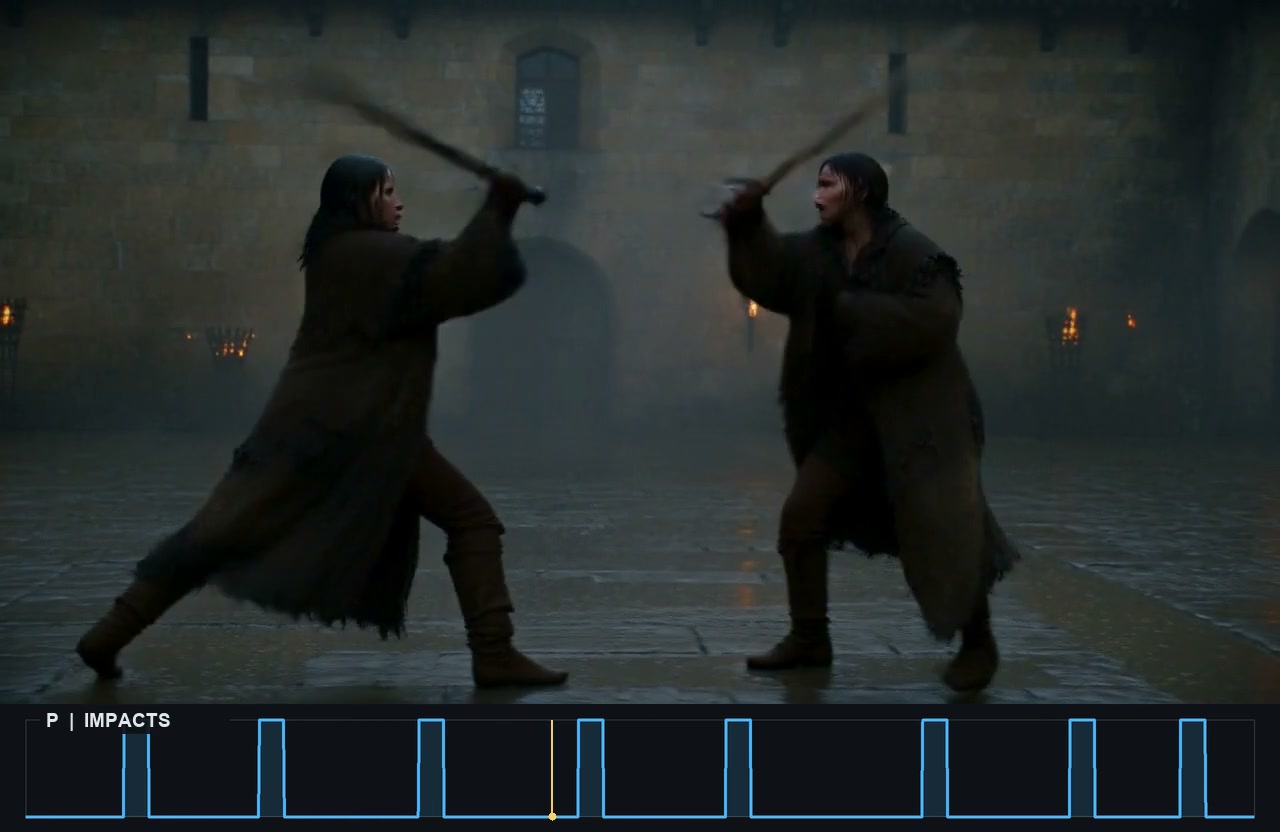 テキスト→動画
NKD Event CurveはMiniMax H3向けのComfyUIノードです。カーブを描けばアクションがピークの位置で発生し、6種類のガイドと、曲や別のクリップからコピーしたタイミングを利用できます。
GPL-3.0
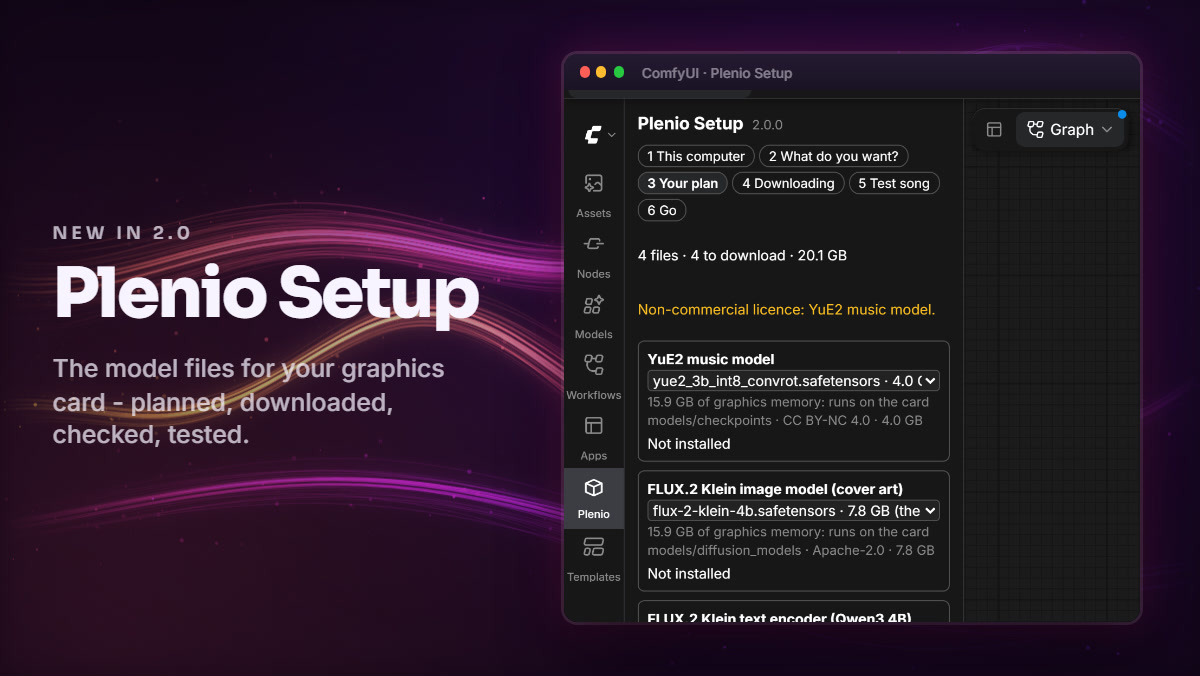 マルチモーダル
ComfyUI向けPlenio 2.0は、モデルファイルをプラン・検証するSetupタブ、モデルフィールドの自動設定、Song API v2、MCPサーバー、そして部屋での利用を想定したプレイヤーを追加します。
 キャラクターアニメ
MeituanのLongCat Video Avatar 1.6は、1枚の写真と音声トラックから10分を超えるリップシンク済みアバター動画を生成します。より高速な8ステップ経路とINT8重みを備えています。
MIT
 画像編集
rank-32 アダプターが MOSS-Image-Base に任意マスクのインペイント、1 パスでのアウトペイント、混合編集を追加。ComfyUI ノードとすぐ使えるワークフロー、12 組の元画像/マスク/結果を提供します。
 テキスト→動画
Geiru Context Suiteは、すべてのMiniMax H3ショットをクリップ1にピン留めし、ハイブリッドウィンドウ経由で2分間を1パスでレンダリングするComfyUIノードを追加します。
GPL-3.0
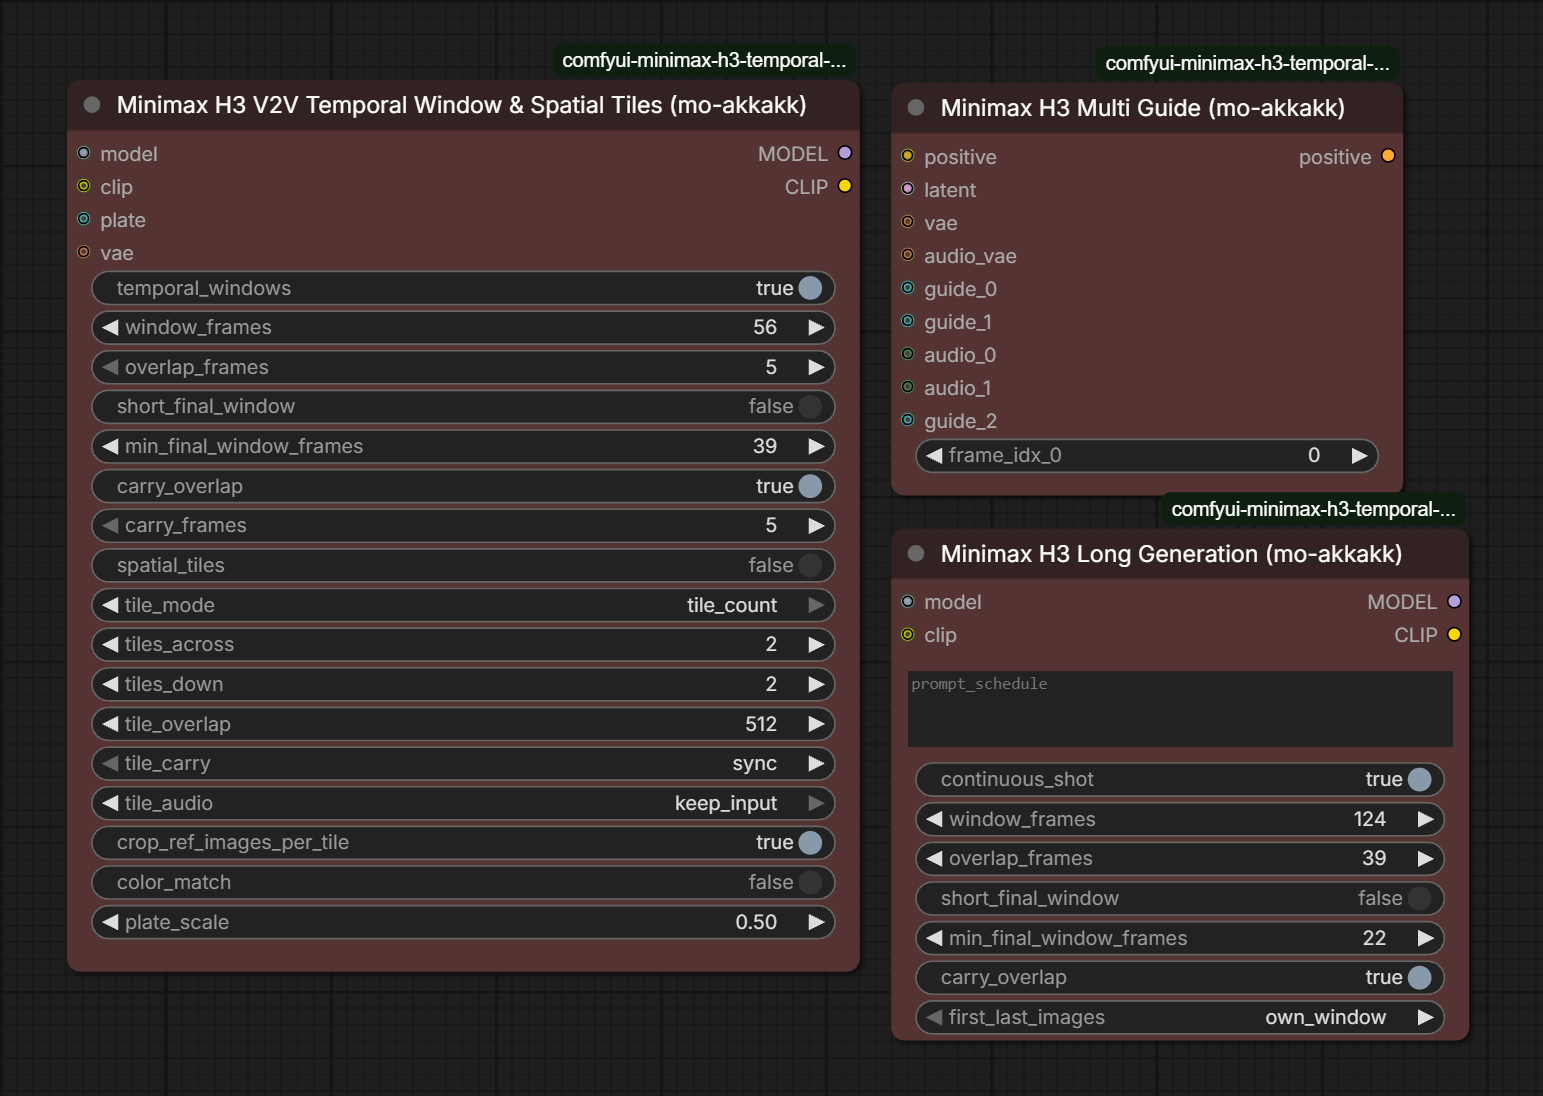 動画編集
長尺・高解像度のMiniMax H3動画から動画への変換を、オーバーラップするウィンドウと空間タイルに分割してレンダリングするComfyUIノードパック。2つのサンプルワークフロー付き。
MIT
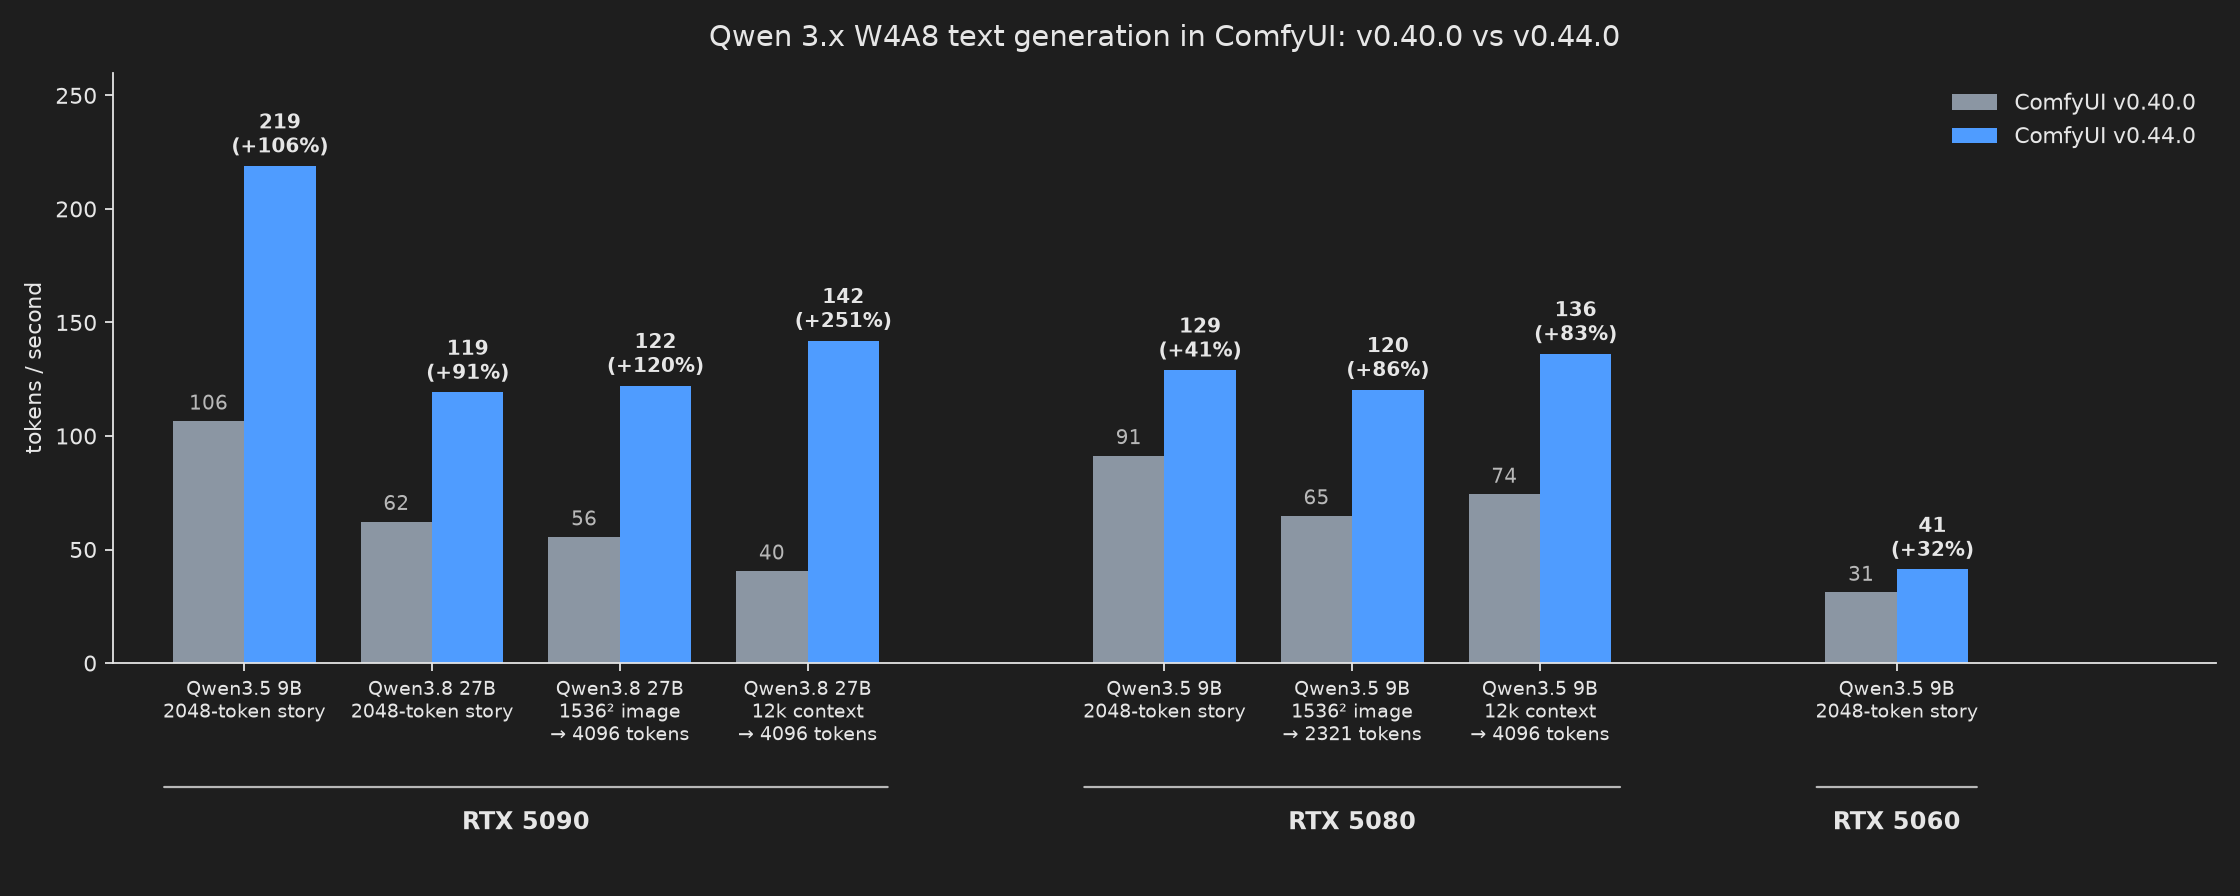 エコシステム
ComfyUI v0.45.0はQwen3.xのテキスト生成を書き換えました。RTX 5090上のQwen3.5 9Bは毎秒106トークンから219トークンへ高速化。適応ツリーMTPとINT8アテンションを採用しています。
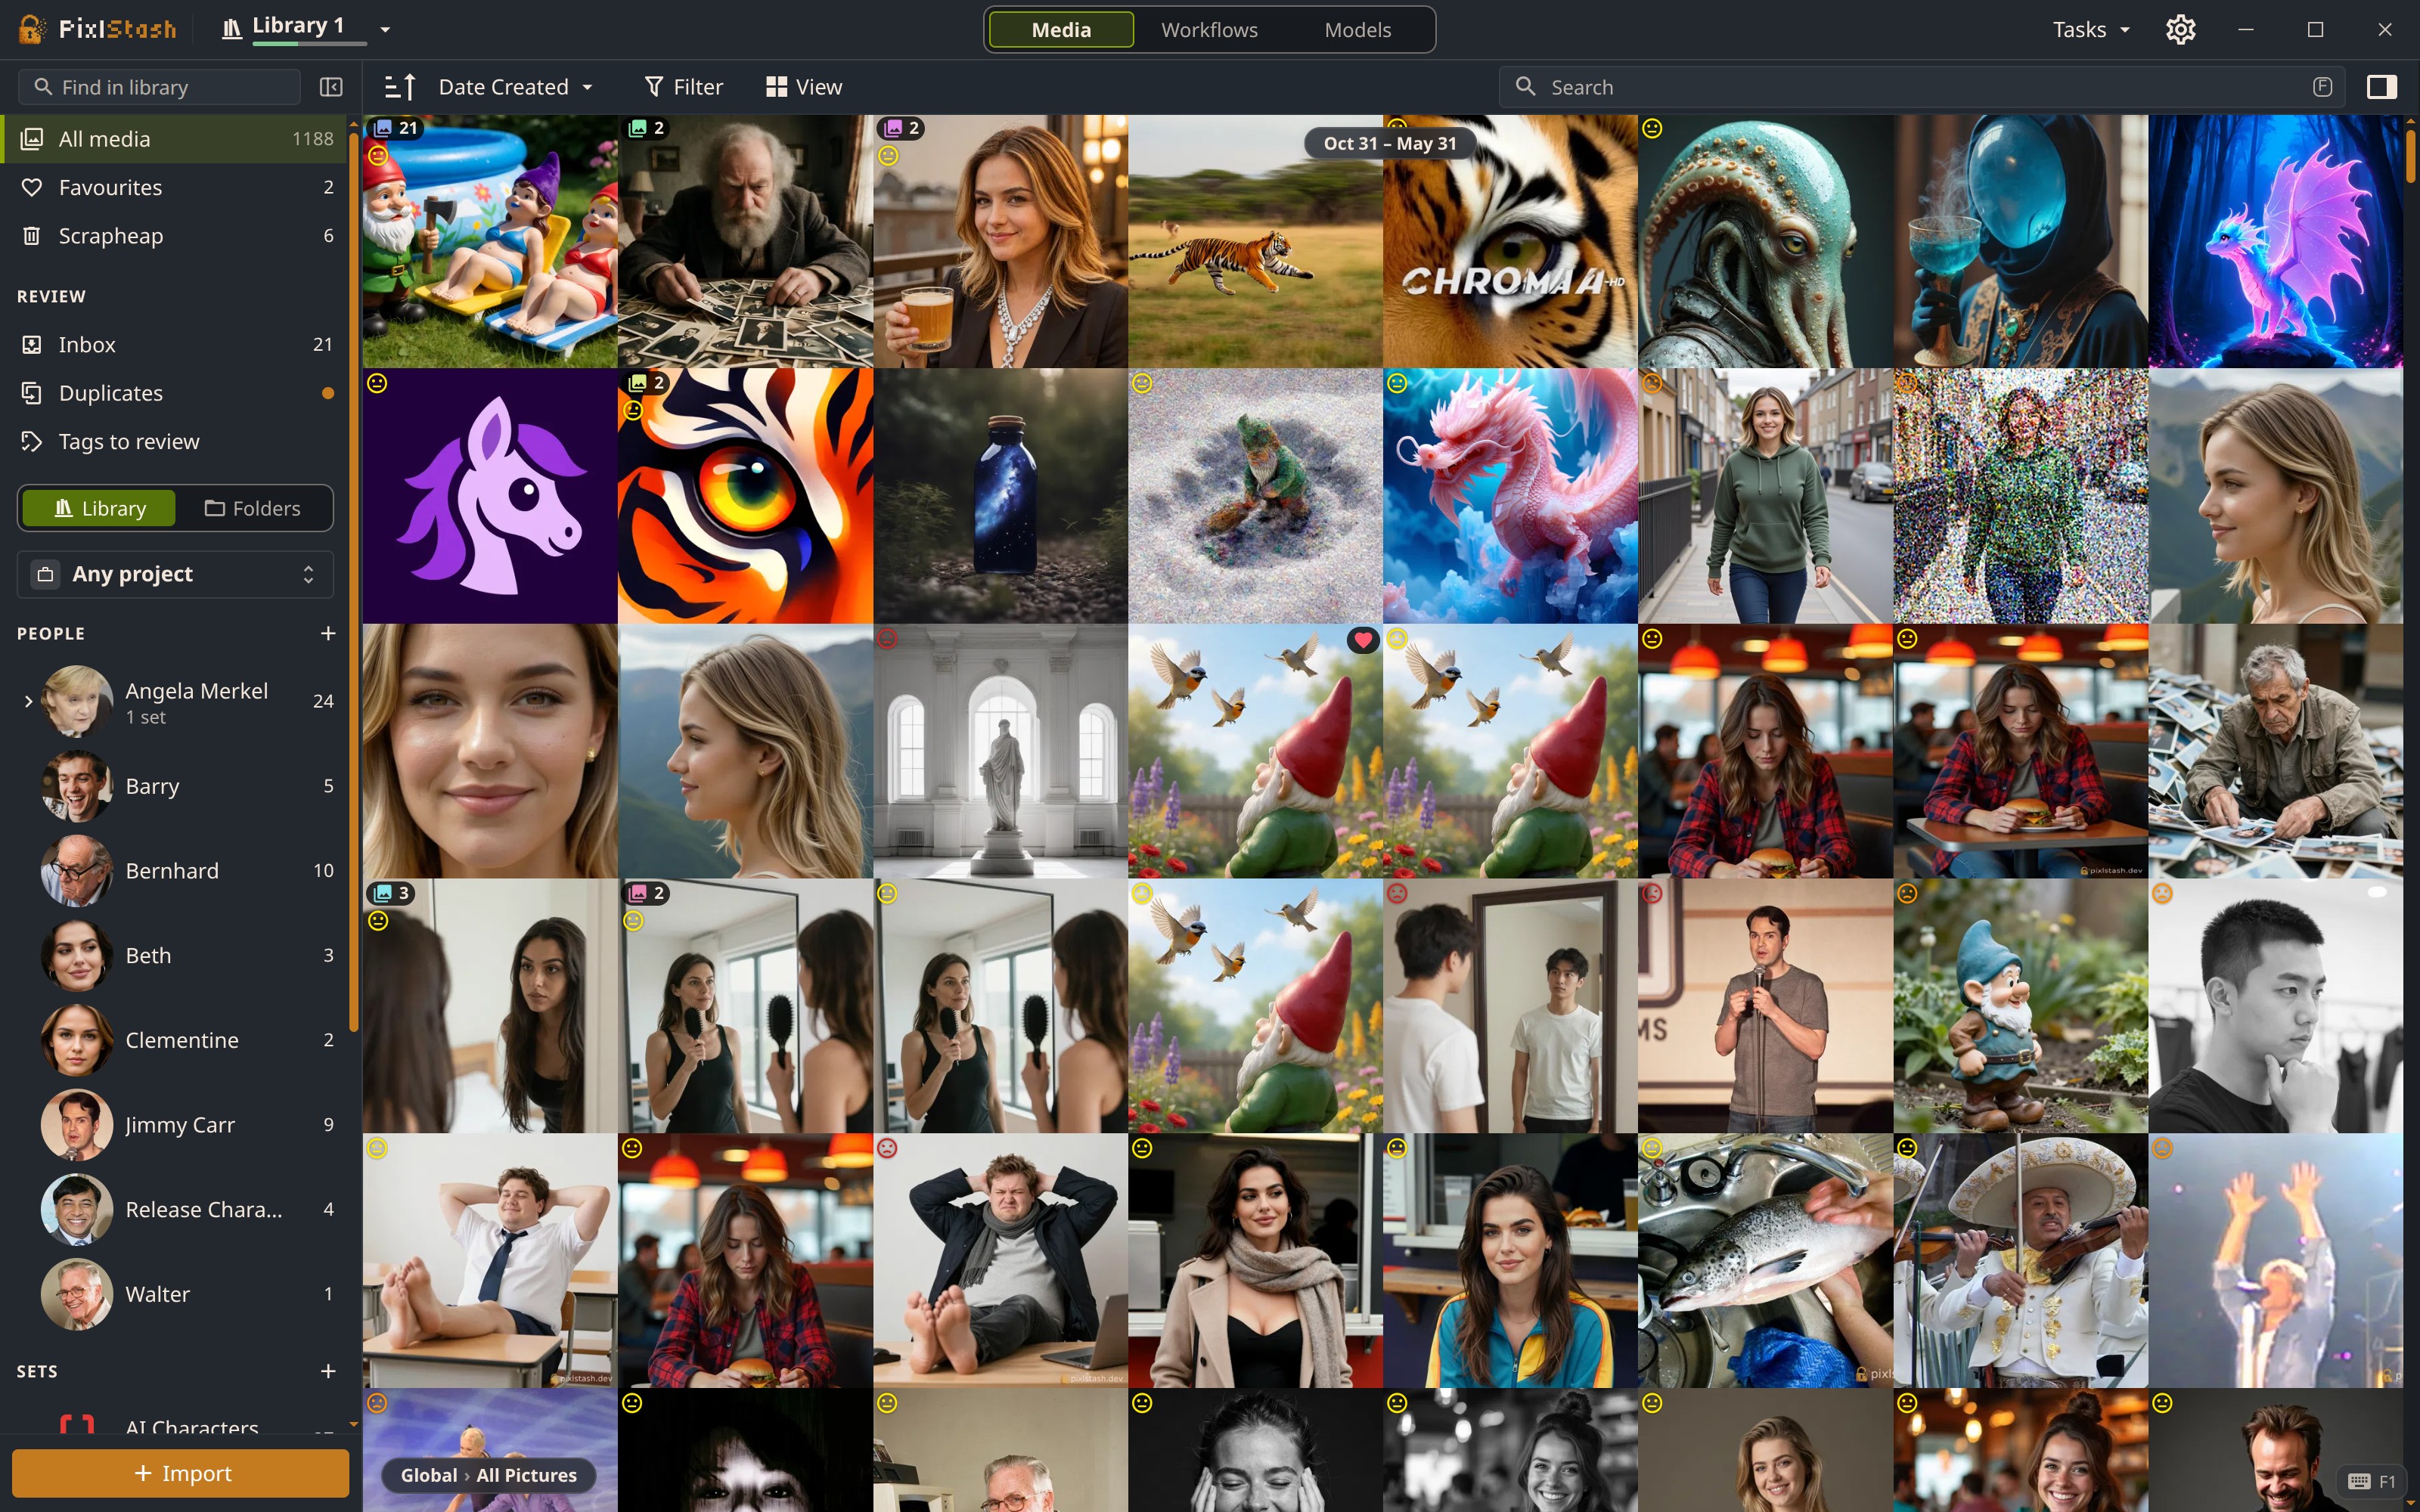 エコシステム
PixlStash 2.0は、AI-toolkitによるLoRA学習、顔の類似クラスタ、キャラクターシートを、ComfyUIと連携する画像ライブラリに追加します。
 動画編集
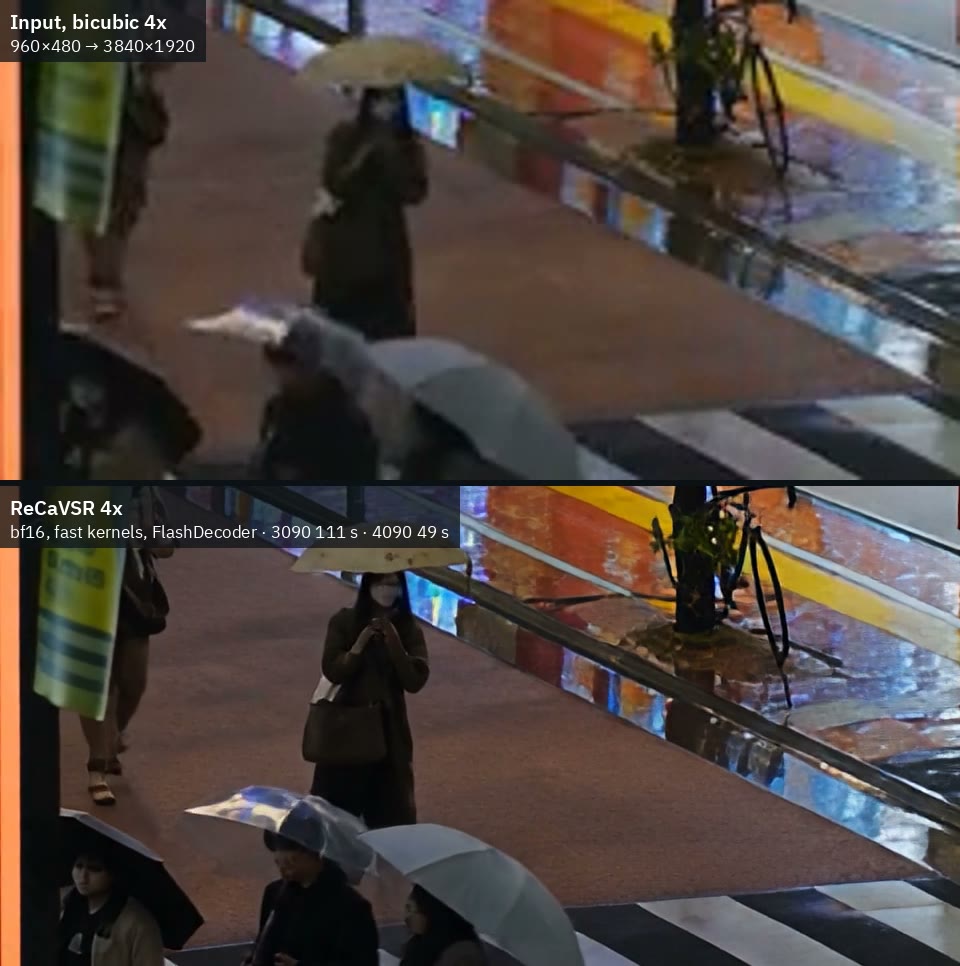
ReCaVSRはWan2.2上でクリップをブロックごとに1回のデノイズステップで4倍にアップスケールします。ComfyUIノード、6.3 GBのint8ファイル、ComfyUI Managerからのインストールが利用可能になりました。
 画像編集
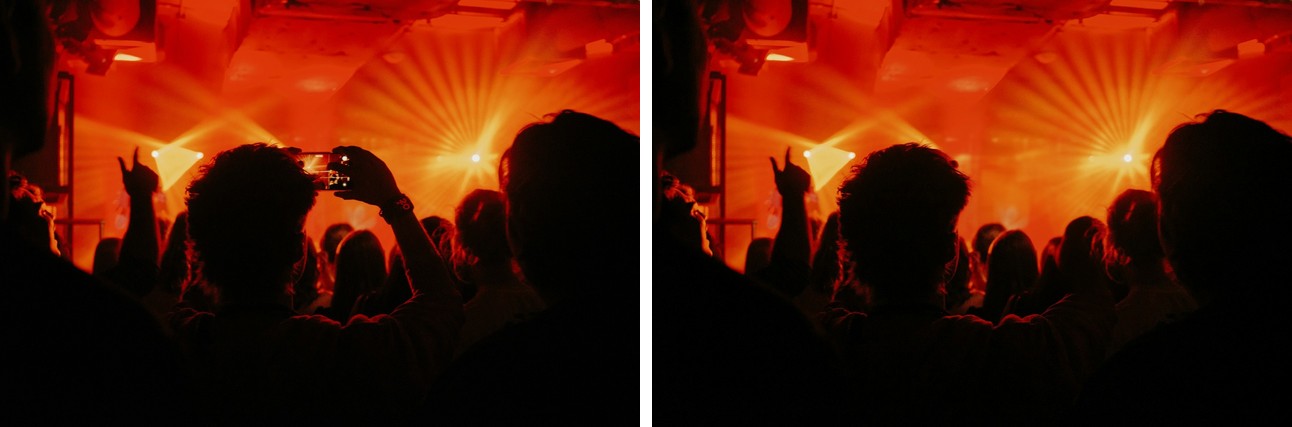
PrunaAIのオブジェクト削除LoRAを使えば、Qwen-Image 2.1の写真からマスクしたオブジェクトをCFGなしの6ステップで消去し、フレームの残りの部分はそのまま保持できます。ComfyUIワークフローも配布されています。
 画像編集
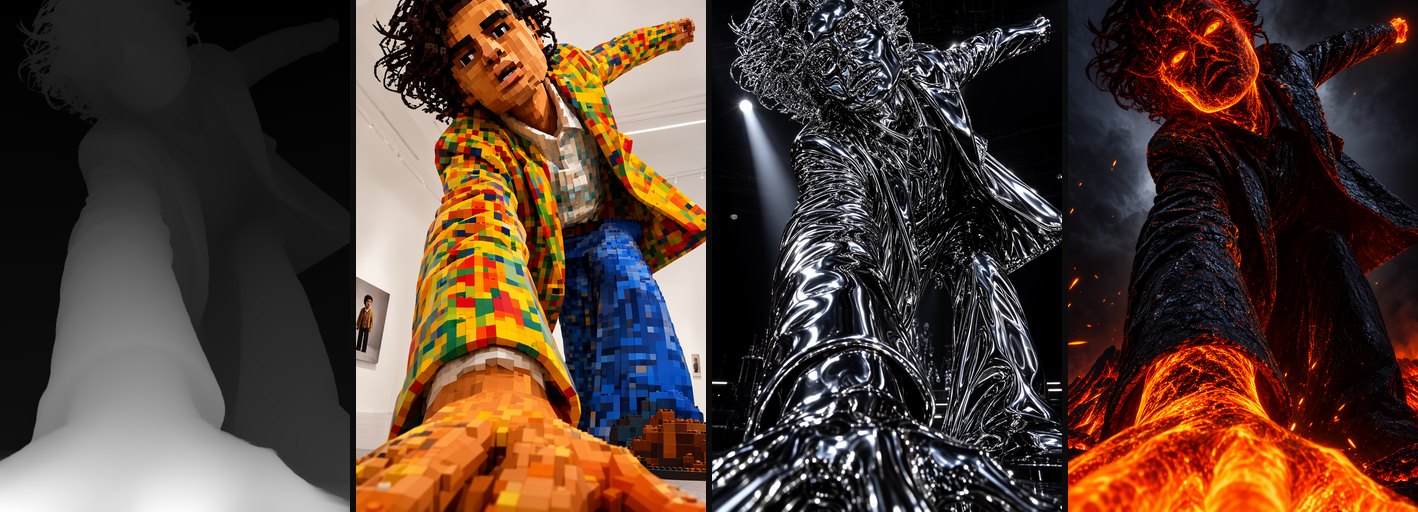
MOSS-Image-SFT 用の ControlNet 形式の編集 LoRA 7 種。コントロールマップごとに 1 つずつ用意され、すぐ使える ComfyUI ワークフロー、サンプルグリッド、単一の 290 MB 重みファイルをそれぞれ備えています。
 テキスト→動画
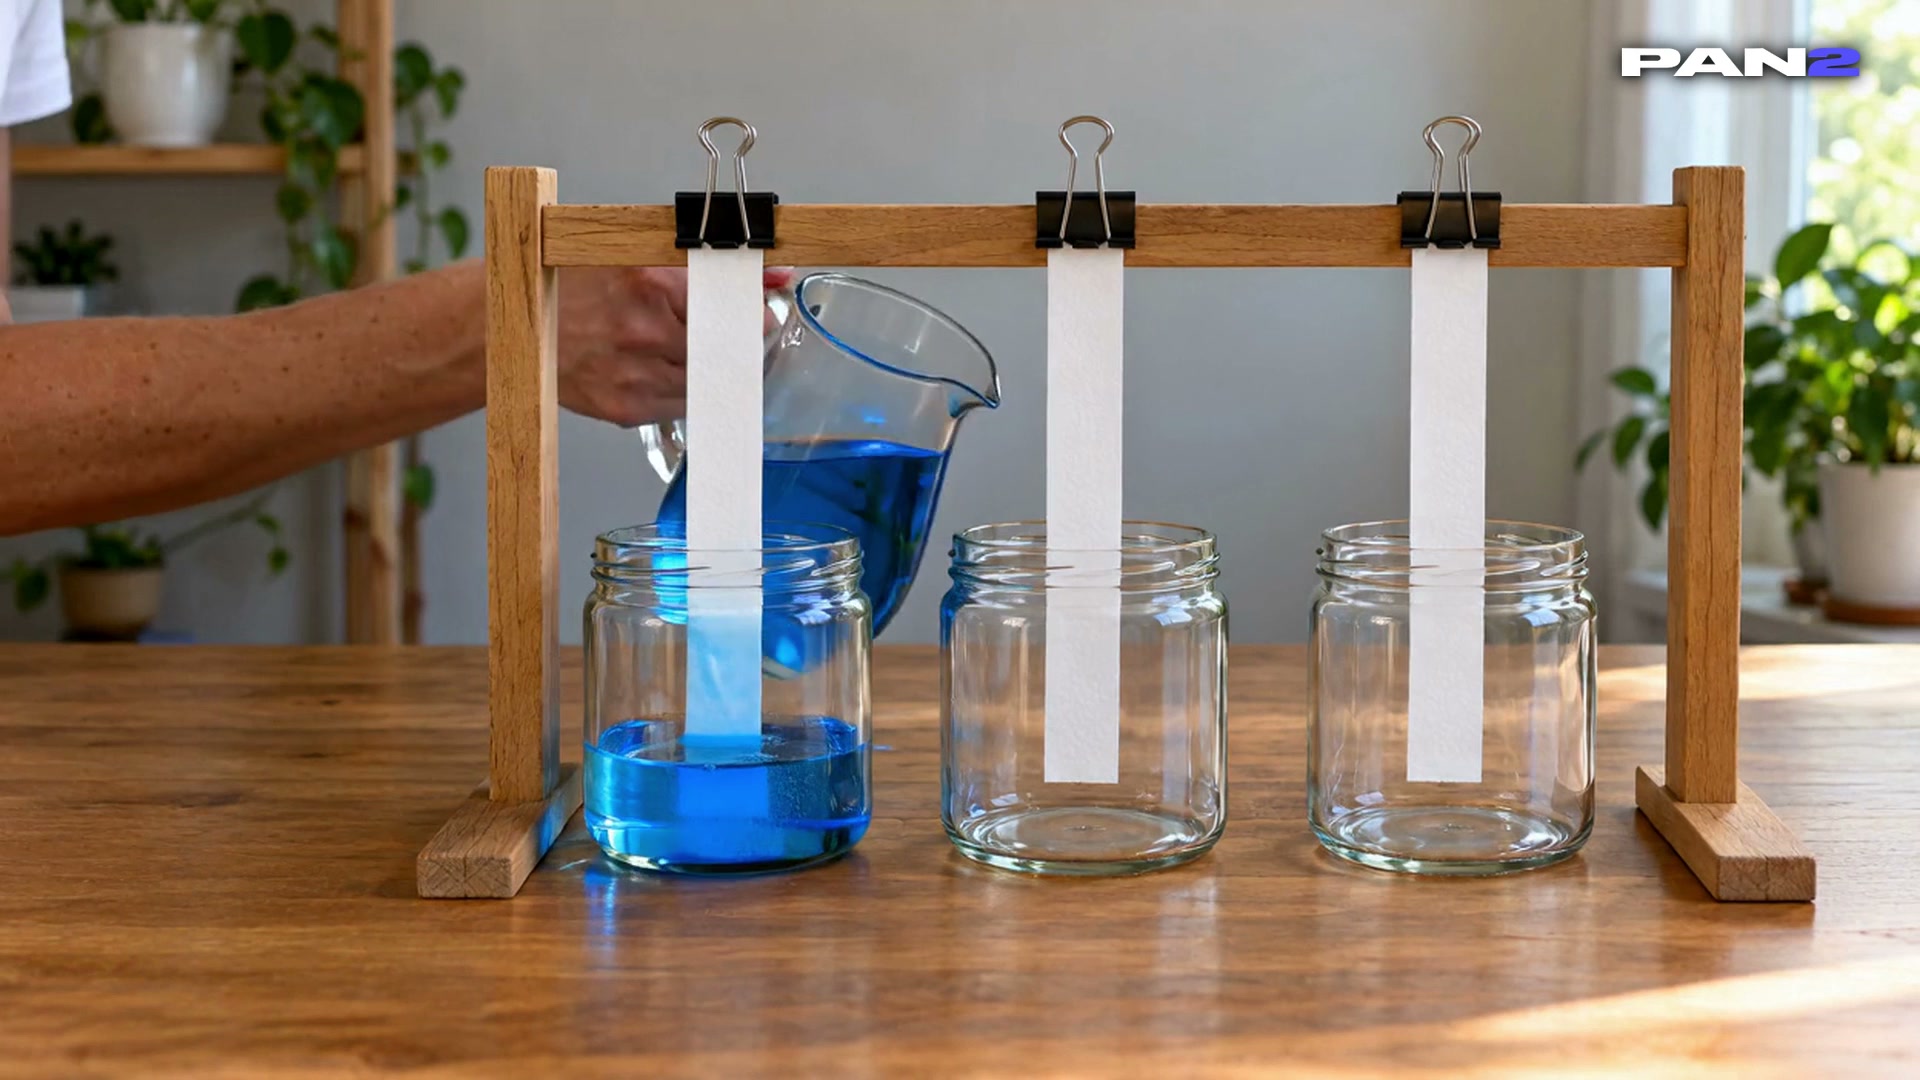
MBZUAI IFMがPAN 2を公開。テキストまたは開始フレームから20秒・704x1248の動画をシミュレーションする29Bの世界モデルで、fp8重みを読み込むコミュニティ製ComfyUIノードも登場しました。