 视频编辑
LoRA
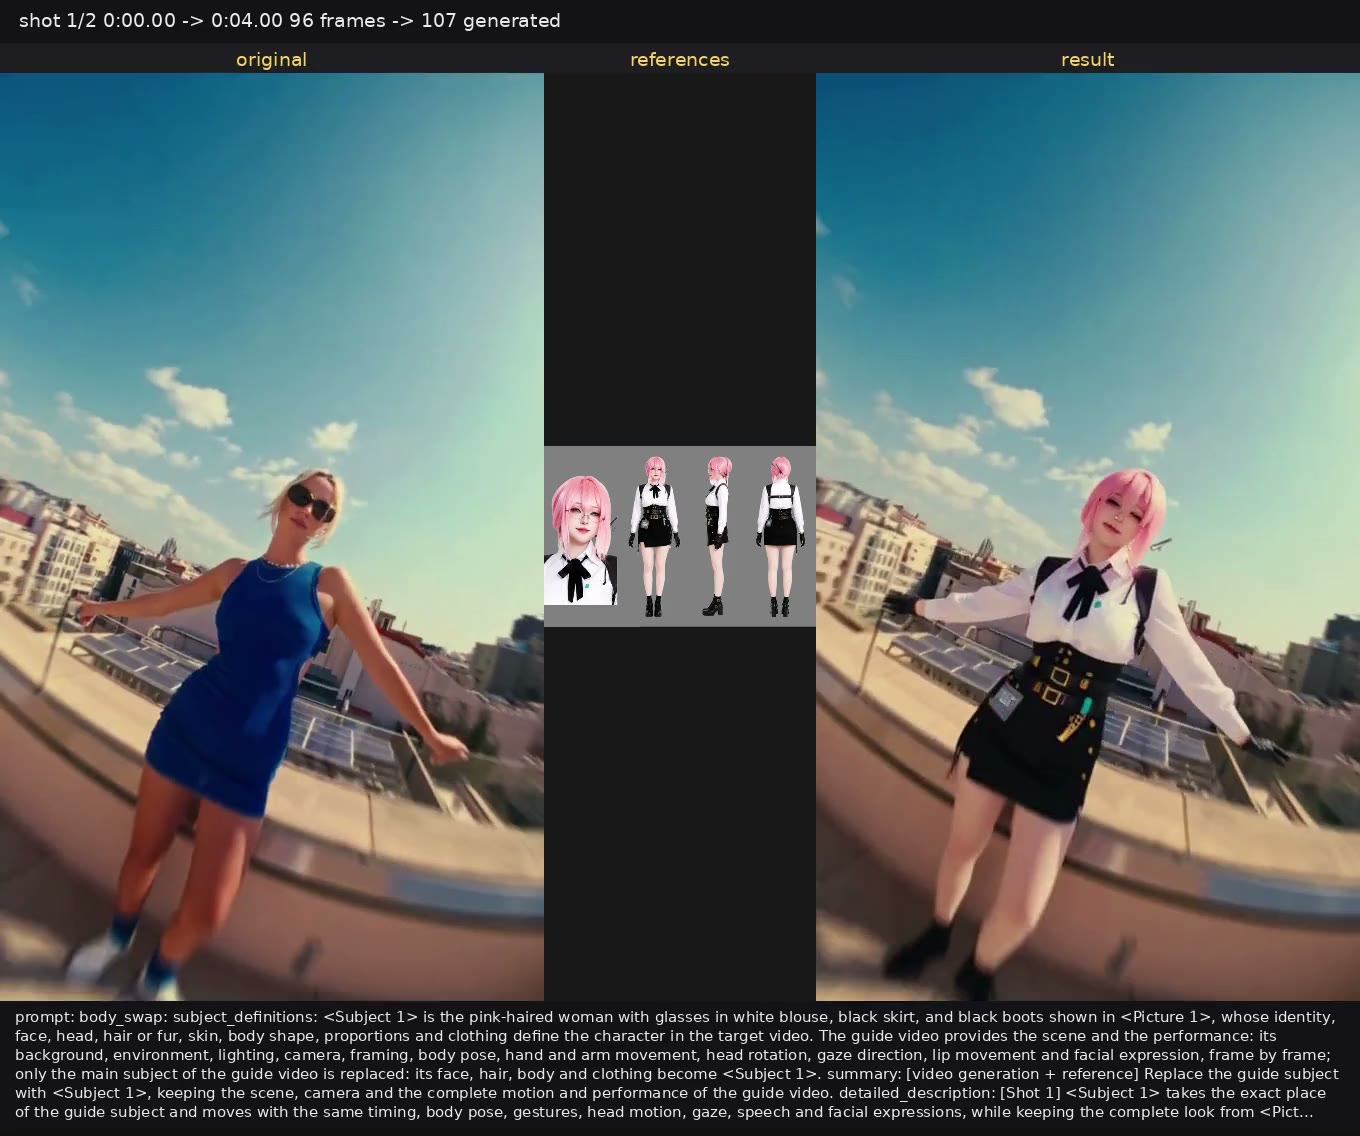
MiniMax H3 角色替换与 Live Wallpaper LoRA:ComfyUI 工作流与示例Alissonerdx 的 MiniMax H3 LoRA 包新增 v1.0 角色替换能力,可将引导片段中的主体替换为参考角色,并附带 Live Wallpaper 适配器,提供 ComfyUI 工作流与示例。
BFS-Character-Swap-Community-1.1
ComfyUI 生态最新动态:开源模型发布、自定义节点、工作流与工具更新。
视频编辑Alissonerdx 的 MiniMax H3 LoRA 包新增 v1.0 角色替换能力,可将引导片段中的主体替换为参考角色,并附带 Live Wallpaper 适配器,提供 ComfyUI 工作流与示例。
BFS-Character-Swap-Community-1.1
 生态工具
Comfy-Org 的 Nvidia VFX Nodes 升级到 0.2.1,带来 RTX Video Super Resolution、RTX Video HDR 和 RTX Video Frame Generation,并提供官方模板与 Manager 安装支持。
 文生图
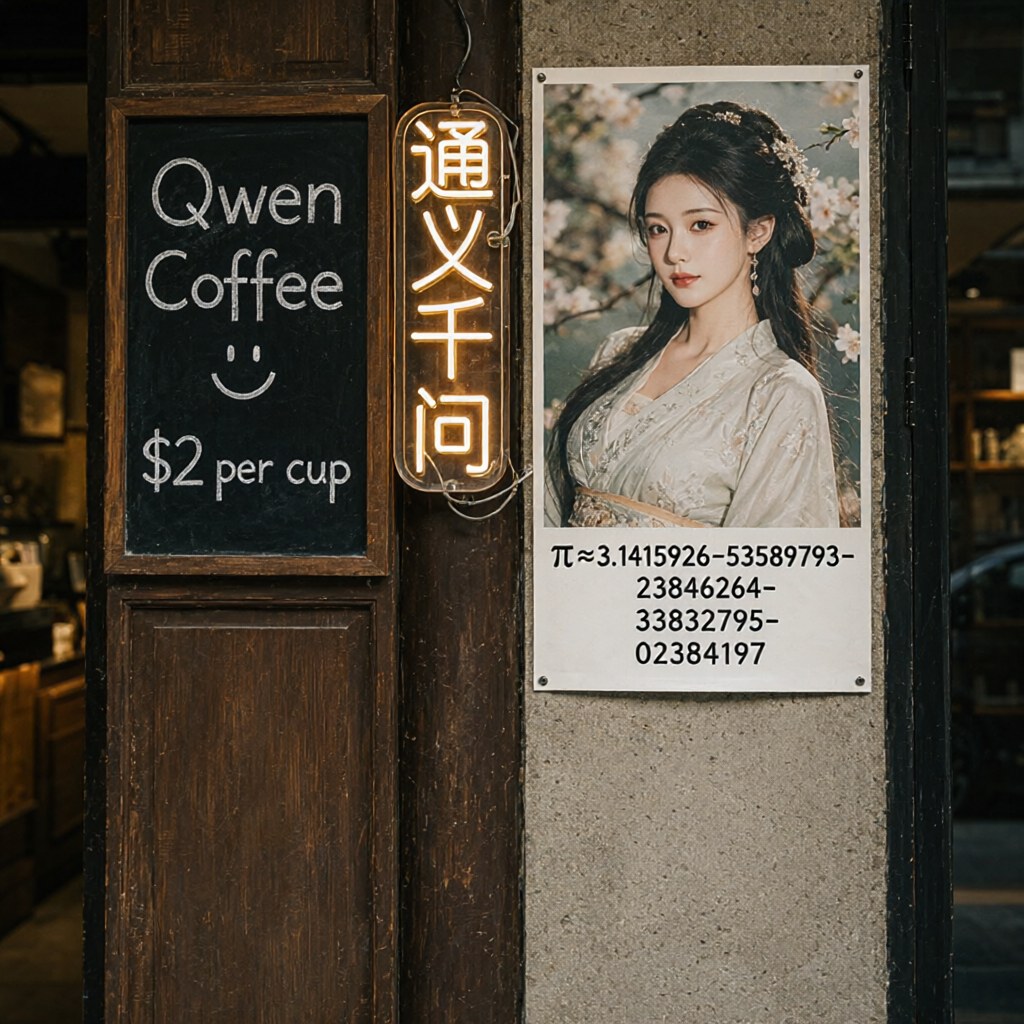
LightX2V 发布面向 Qwen-Image 2.1 的 4 步 DMD 蒸馏 Lightning LoRA,覆盖文生图与多引用编辑,并附对比样张。
Apache-2.0
 语音合成
Fish Audio 发布 Drama 3,这是一款 35B MoE 文本转语音模型,能够遵循方括号中的表演指令,开放权重并提供 ComfyUI 合作节点。
Fish Audio Community License 1.0
 图生图
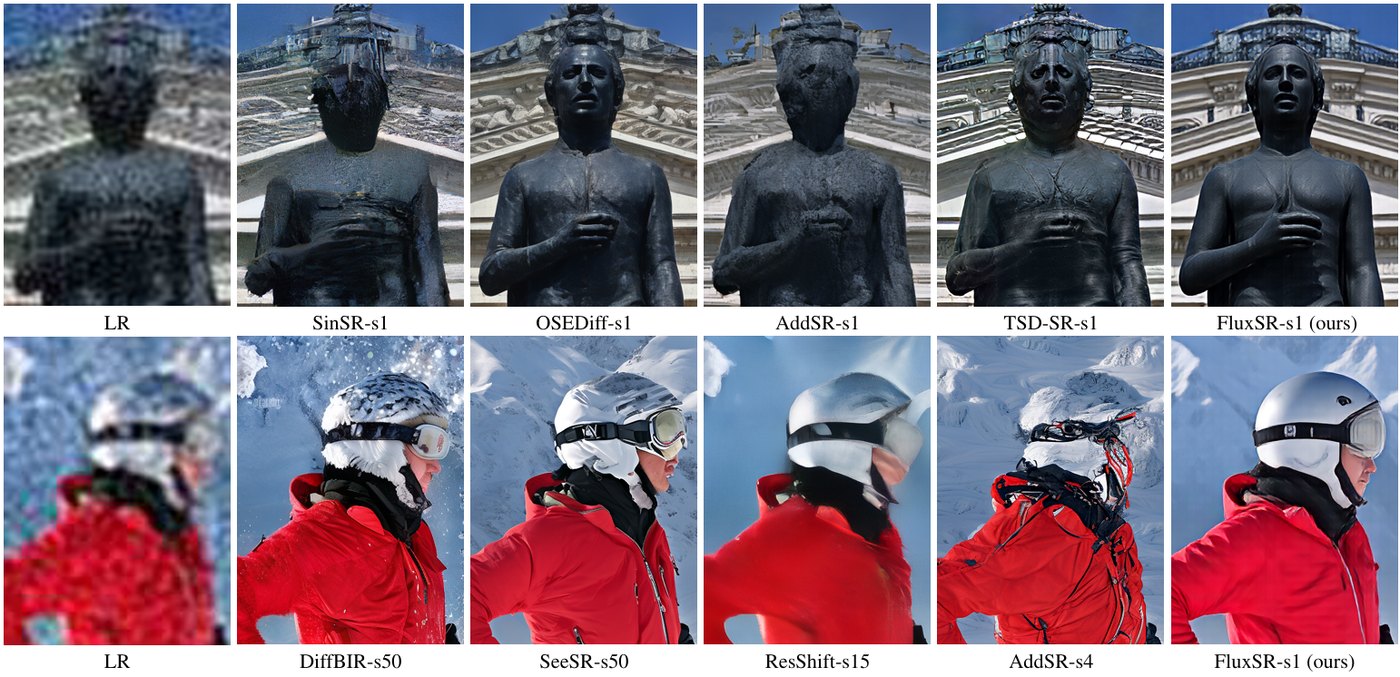
FluxSR 发布面向 Flux.1-dev 的一步式 4x 真实世界超分辨率 LoRA,并附带训练与推理代码以及现成的社区 ComfyUI 节点包。
FLUX-1-dev-non-commercial
 生态工具
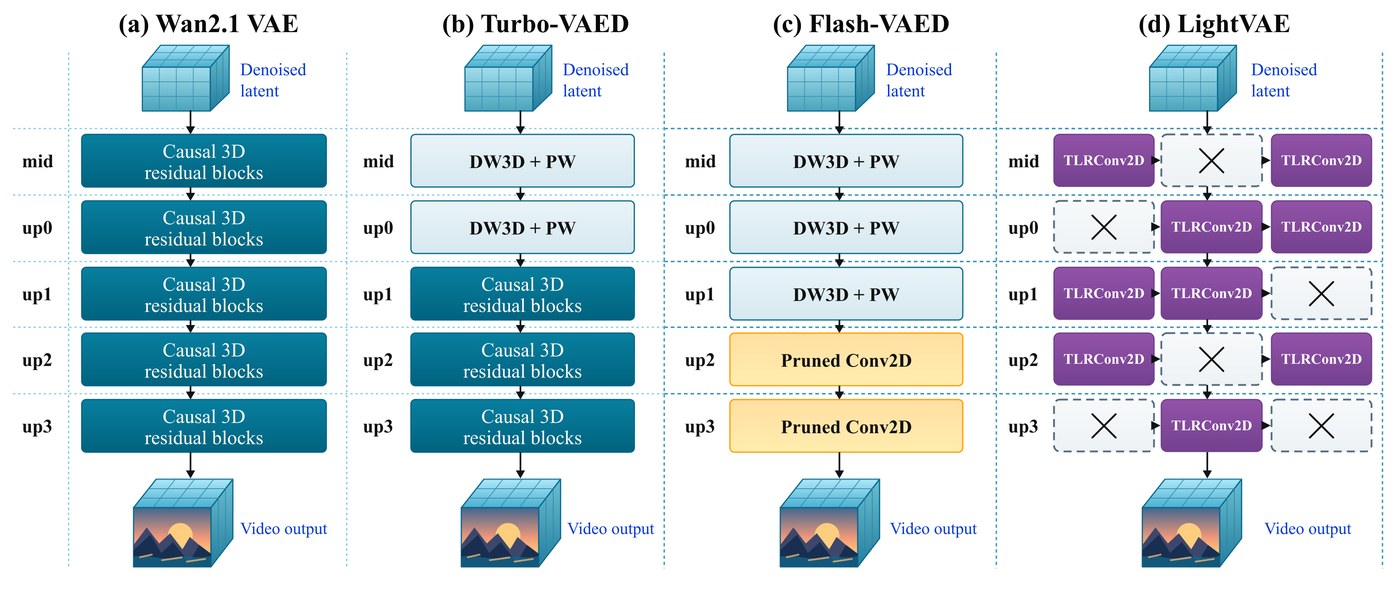
ModelTC 发布 LightVAE:压缩版 Wan2.1、Wan2.2 和 MiniMax-H3 视频 VAE 解码器,保留原始 latent 接口,在 ComfyUI 中最高提速 2.94 倍。
Apache-2.0
 文生视频
Spark-H3 把 Spark-Attn 块稀疏注意力带入 ComfyUI 的 MiniMax-H3:为 RTX 40 和 50 系列提供预构建节点,并在 10% 密度下实现快 1.73 倍的 DiT。
Apache-2.0
 生态工具
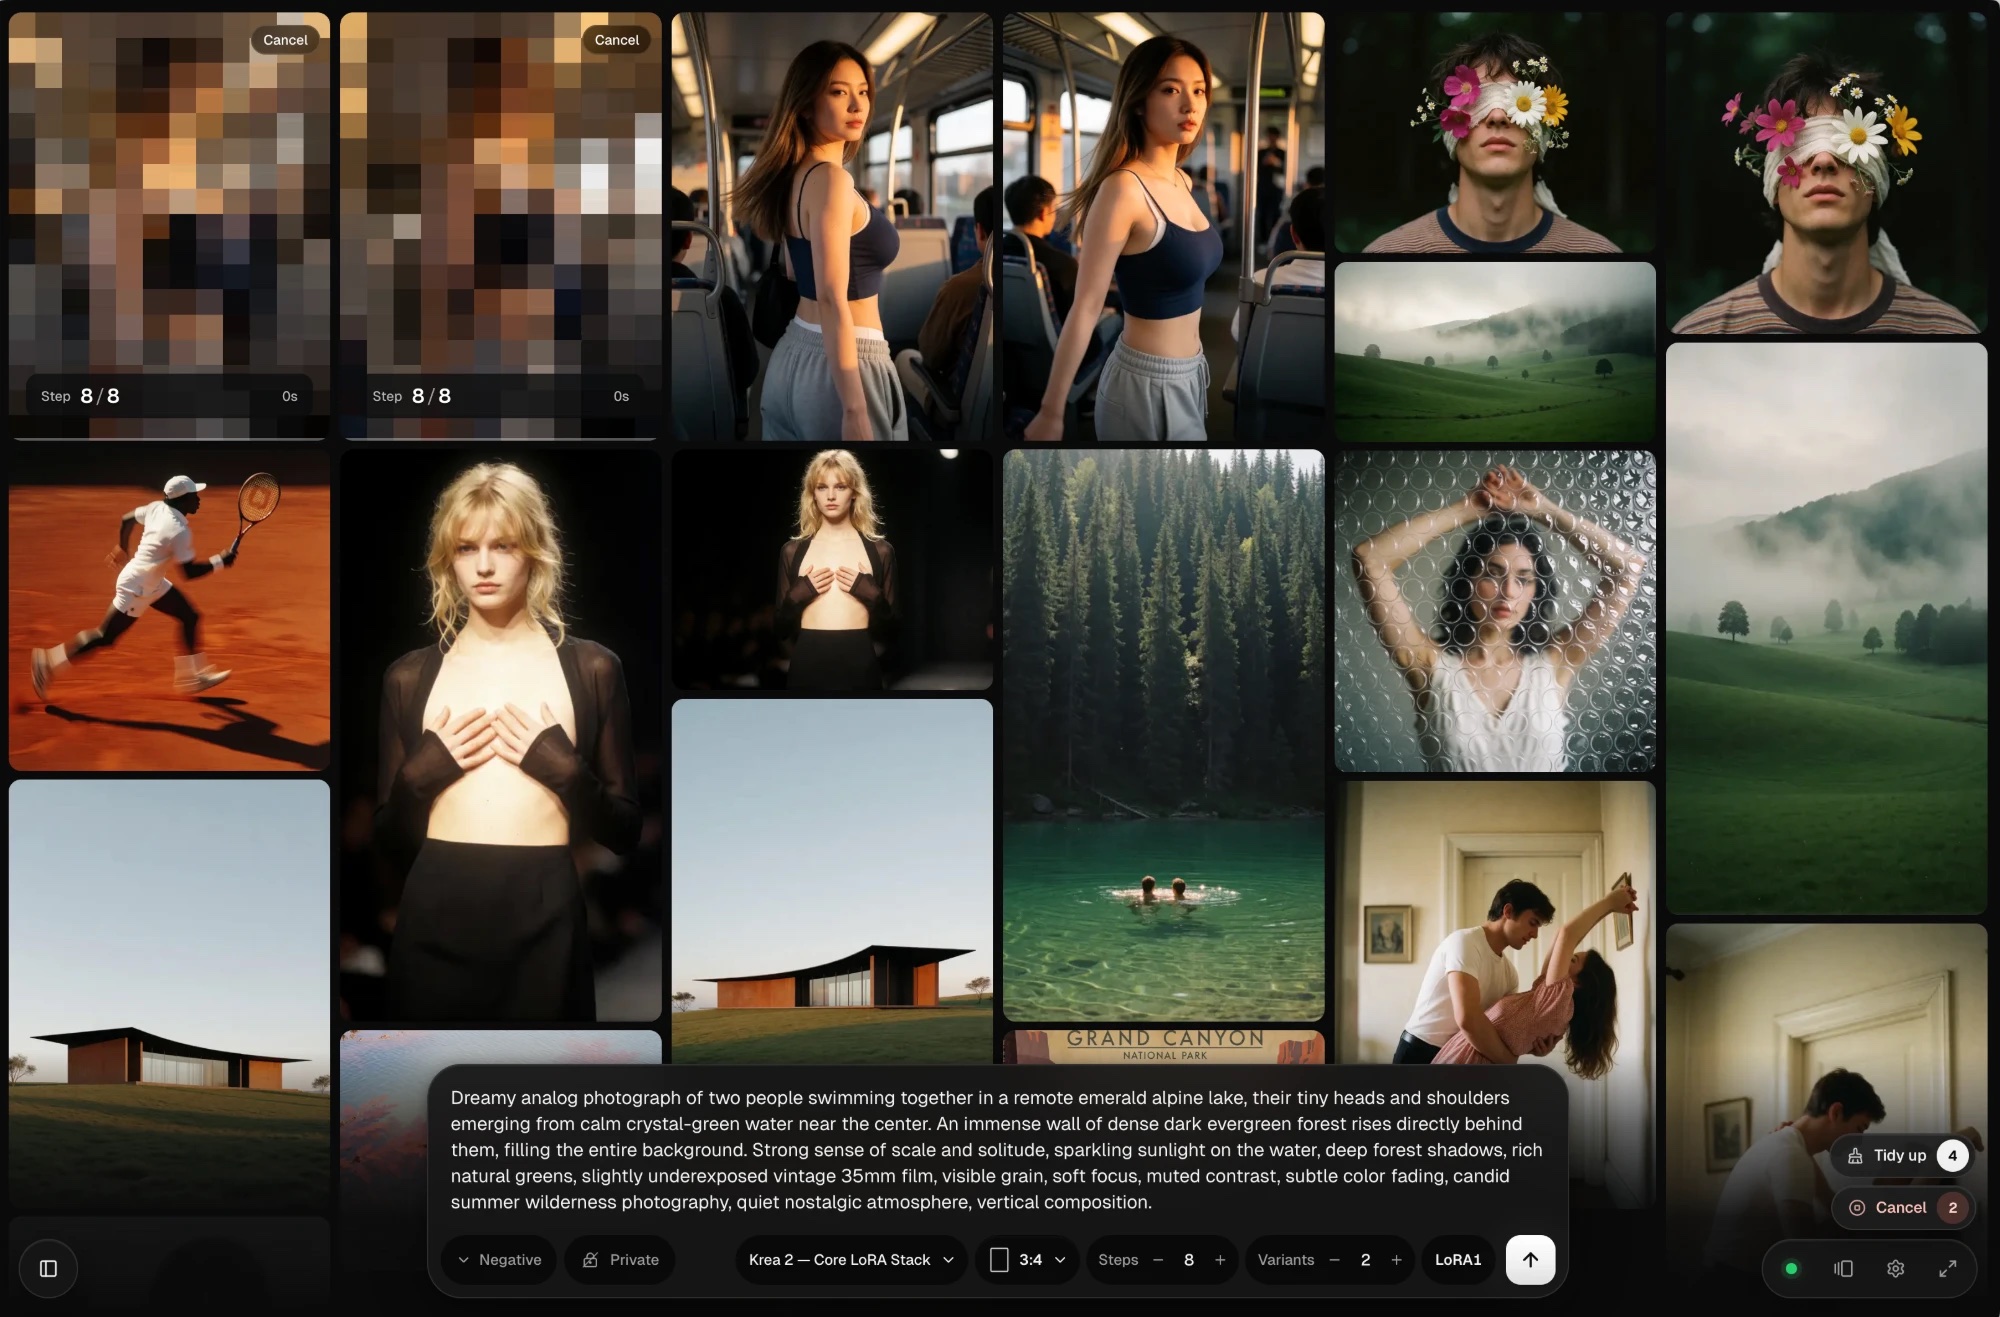
HEISS UI 是 ComfyUI 的开源本地前端:一个提示词输入框加图库,覆盖 28 个模型系列,缺失文件一键下载,无需连接任何节点图。
MIT
 文生图
阿里巴巴官方的 Qwen-Image-2.1-Turbo checkpoint 以 8 步去噪、CFG 1 运行 7B 生成与编辑模型,Comfy-Org 已为 ComfyUI 重新打包权重。
Qwen Research License
 视频编辑
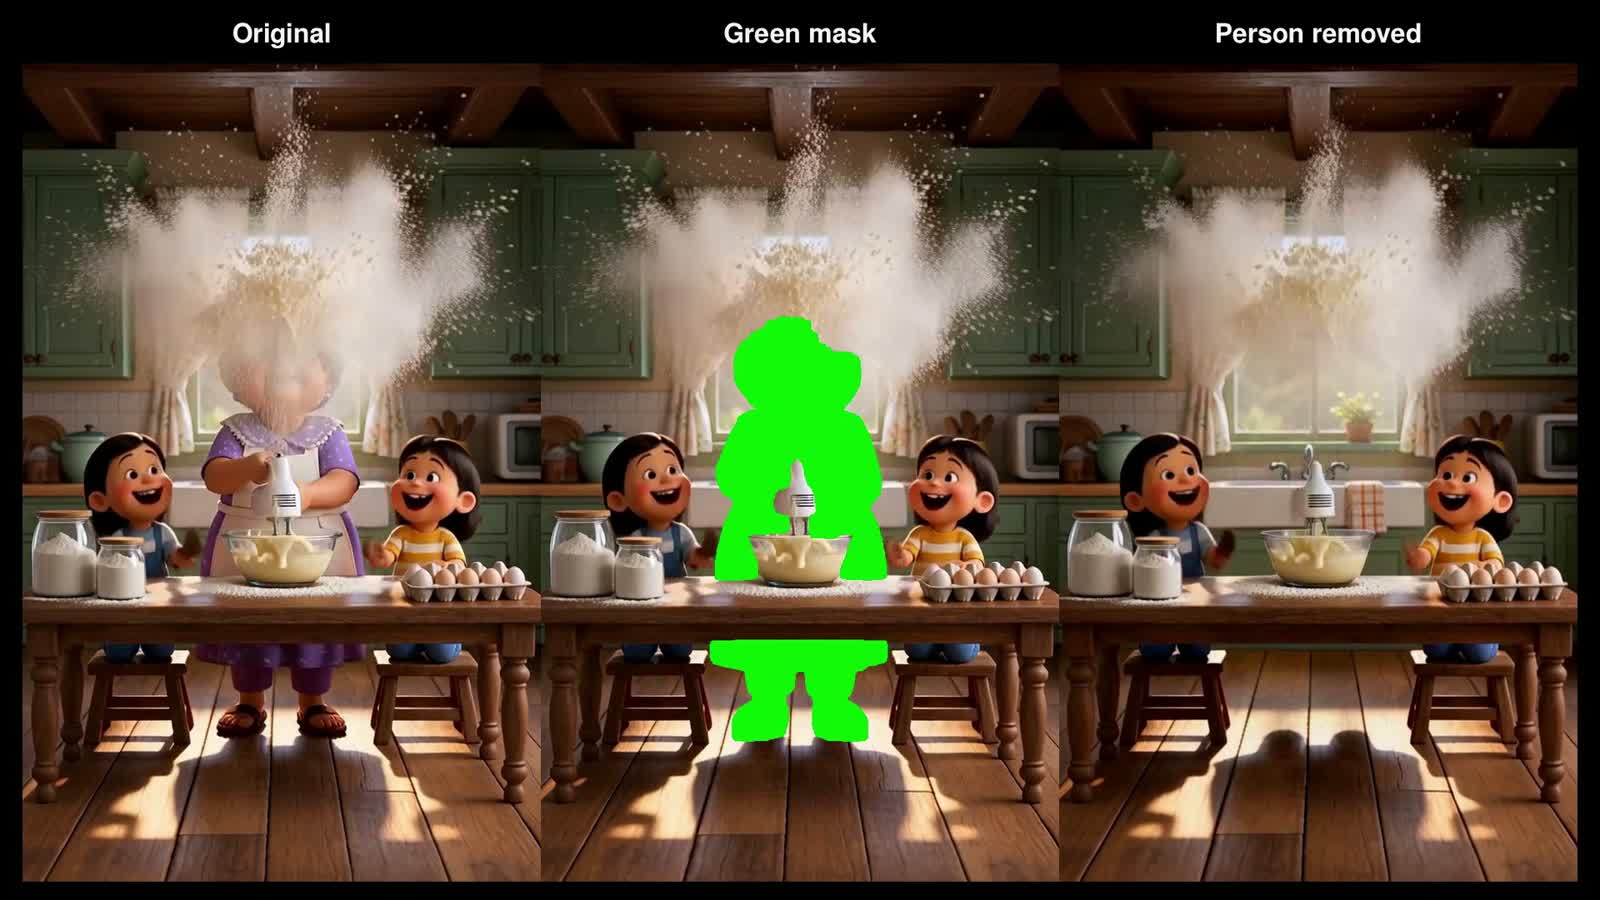
Akatz Labs 的 Person Remover LoRA 使用 SAM 3.1 跟踪人物,将遮罩填充为绿色并在重叠窗口中重建背景,附带现成的 ComfyUI 工作流。
MiniMax H3 Community License
 图像编辑
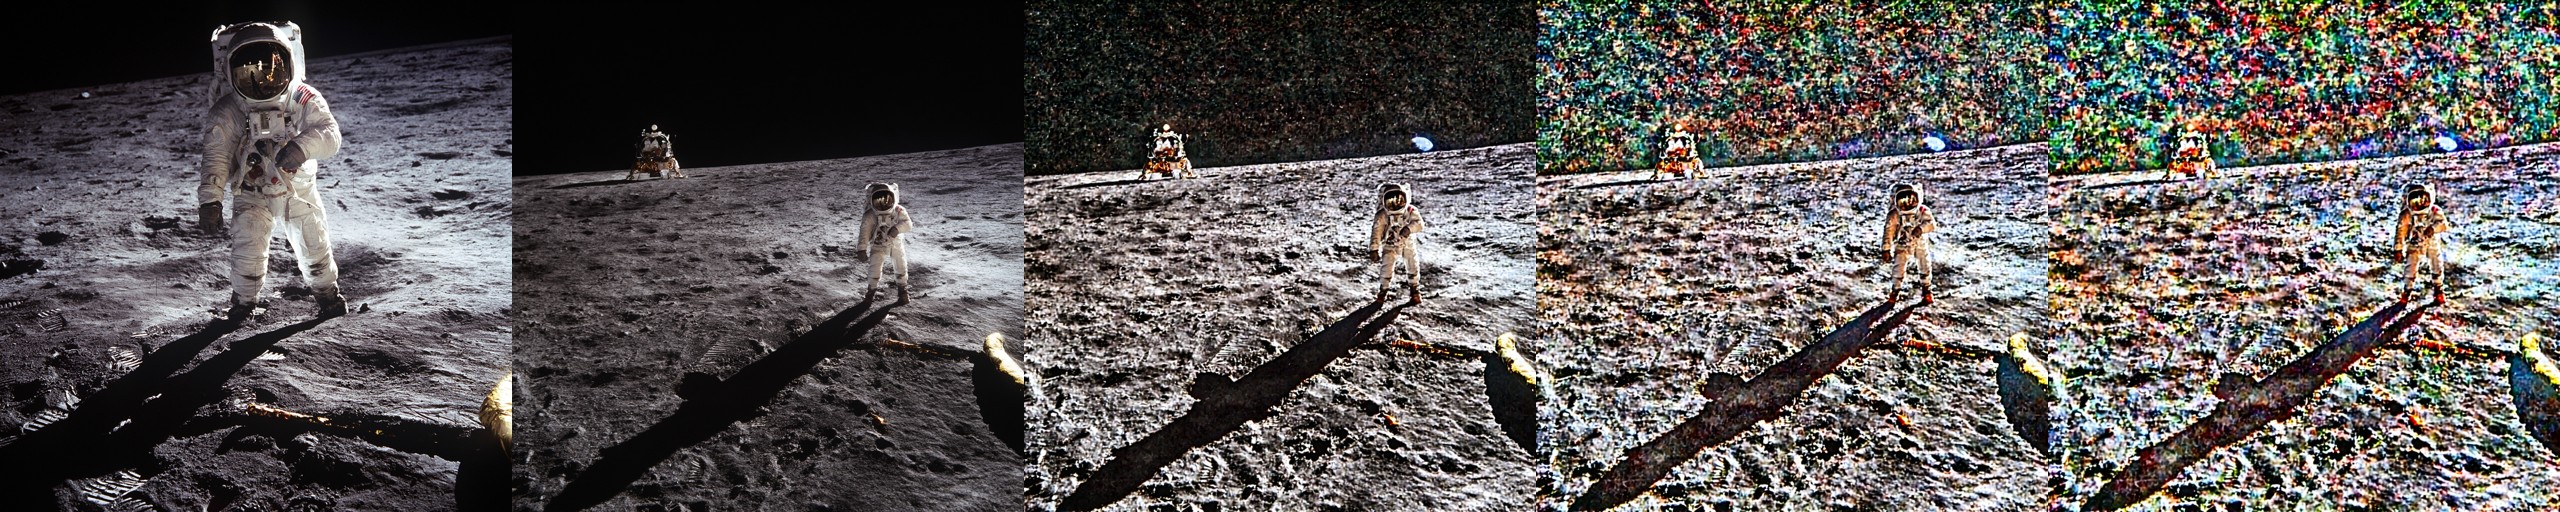
akhaliq 的 Next-Scene LoRA 让 Qwen-Image 2.1 能从单帧渲染出下一个导演镜头,并通过 ComfyUI 的 LoRA 节点串联成完整分镜。
Apache-2.0
 图像编辑
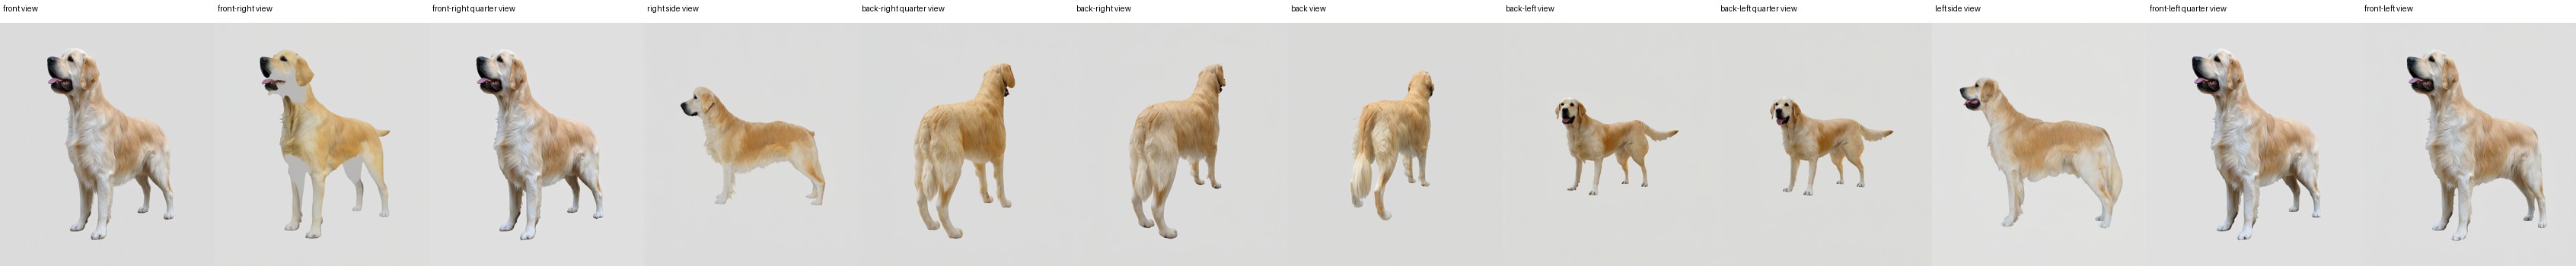
Akhaliq 的 Multiple-Angles LoRA 为 Qwen-Image 2.1 带来相机控制:输入一张照片,从 72 种方位角与仰角取景中任选一种,即可在 ComfyUI 中重新拍摄主体。
Apache-2.0
 文生图
Lodestones 发布 Krea 2 的 Kroma v0.3.1 OPD:一个基于 on-policy 蒸馏的 Turbo 模型,始终保持在基础模型的分布之内,并且 LoRA 训练结果可继续沿用。
 文生视频
FastVideo 发布 FastH3 Trim,这是一个移除 8 个块的 42 块剪枝版 MiniMax H3,可在低至 8 GB 的 GPU 内存中运行带音频的 8 步视频生成,并提供 ComfyUI 重打包文件。
 文生视频
适用于 ComfyUI 的 Kandinsky 6.0 开源权重:29B Pro 与 3B Lite 可生成带 44 kHz 同步音频的 5 秒视频,并支持最高 Full HD 的超分辨率。
MIT
 文生视频
来自复旦大学、腾讯混元与浙江大学的 Prism 采用动态稀疏注意力训练 2K 音视频联合生成模型,速度比全注意力快 2.5 倍,并已发布预览权重。
MIT
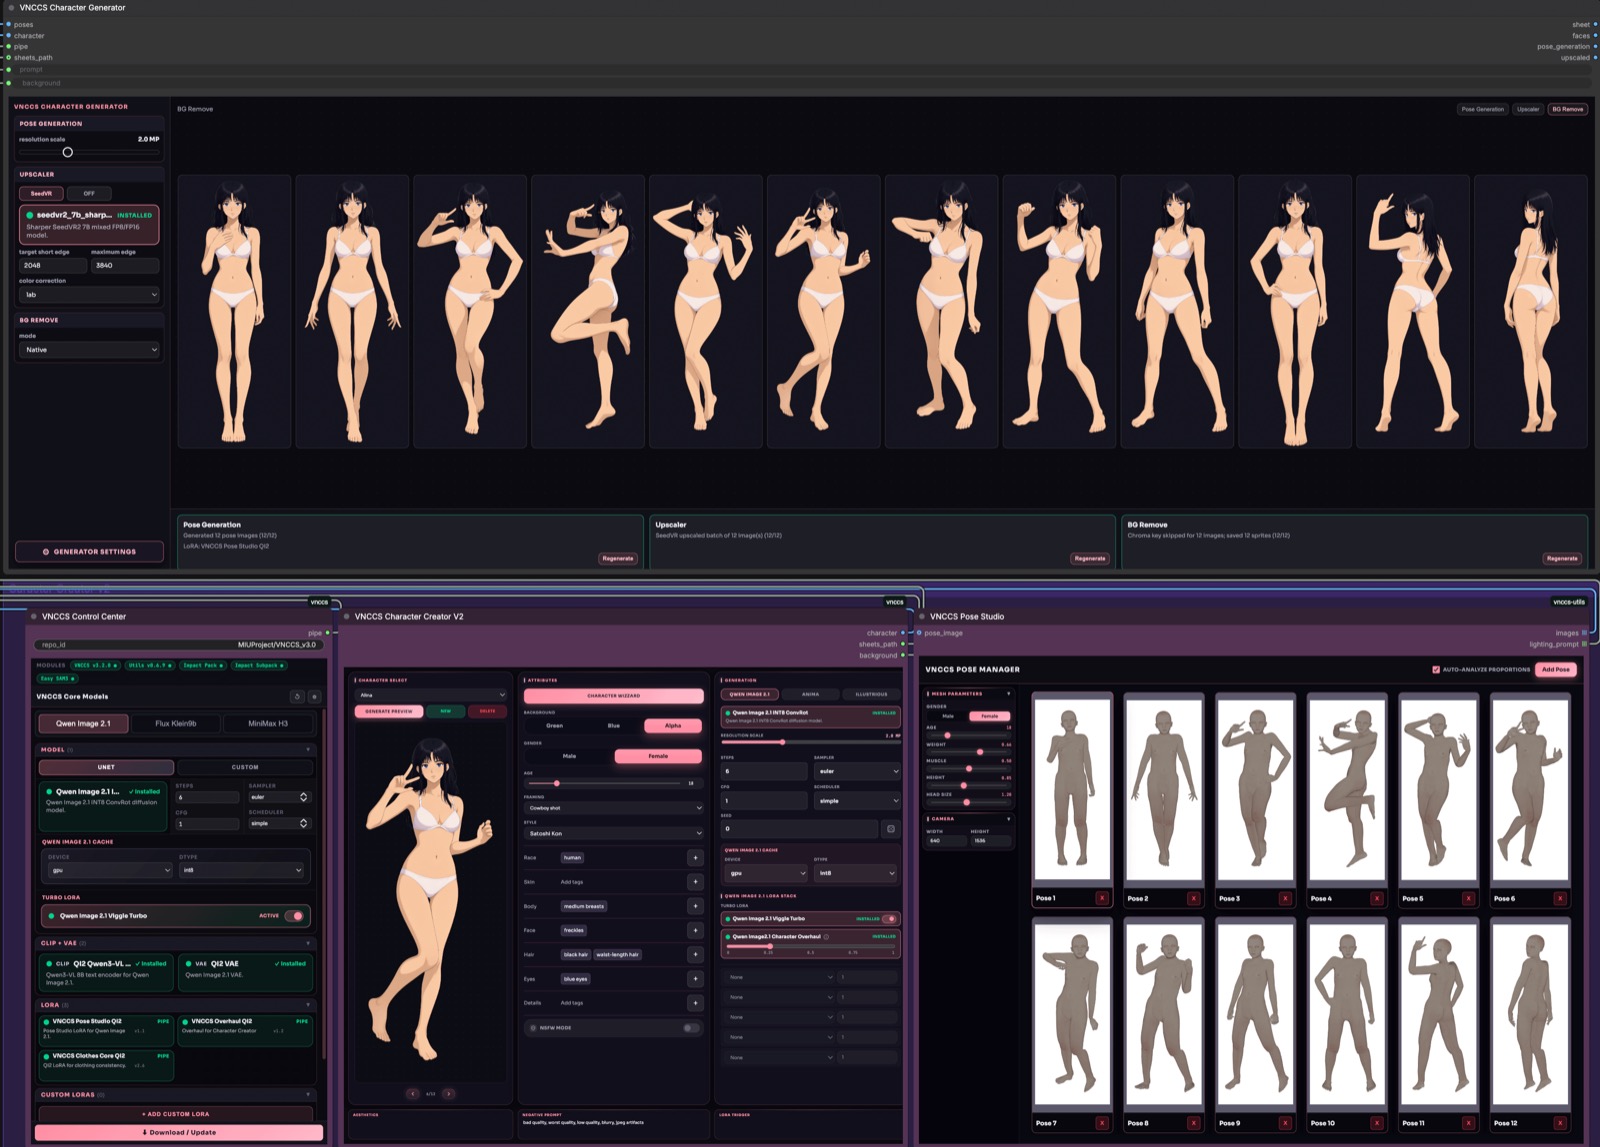 文生图
VNCCS 3.2 在 ComfyUI 角色管线中新增 Qwen Image 2.1 与 MiniMax H3,支持透明精灵图、重构的 Character Creator 以及包含 358 种风格的样式库。
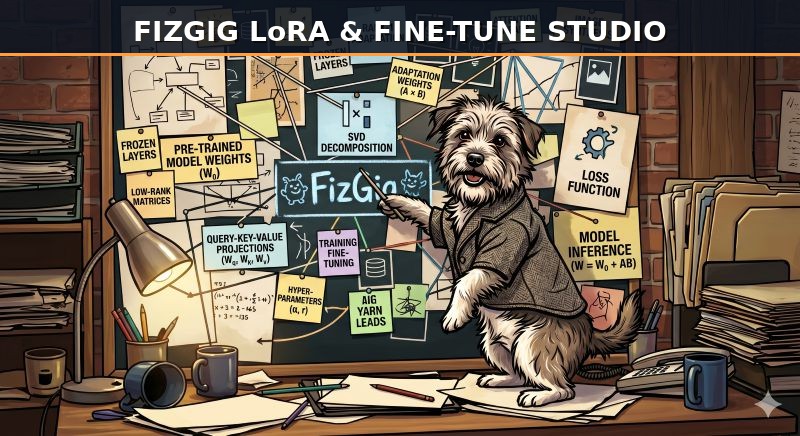 文生图
Fizgig v7 新增 Anima 与 SDXL 训练,为全部六款支持的模型提供完整微调(最低 8 GB 显卡即可),并带来社区可扩展的完整驱动系统。
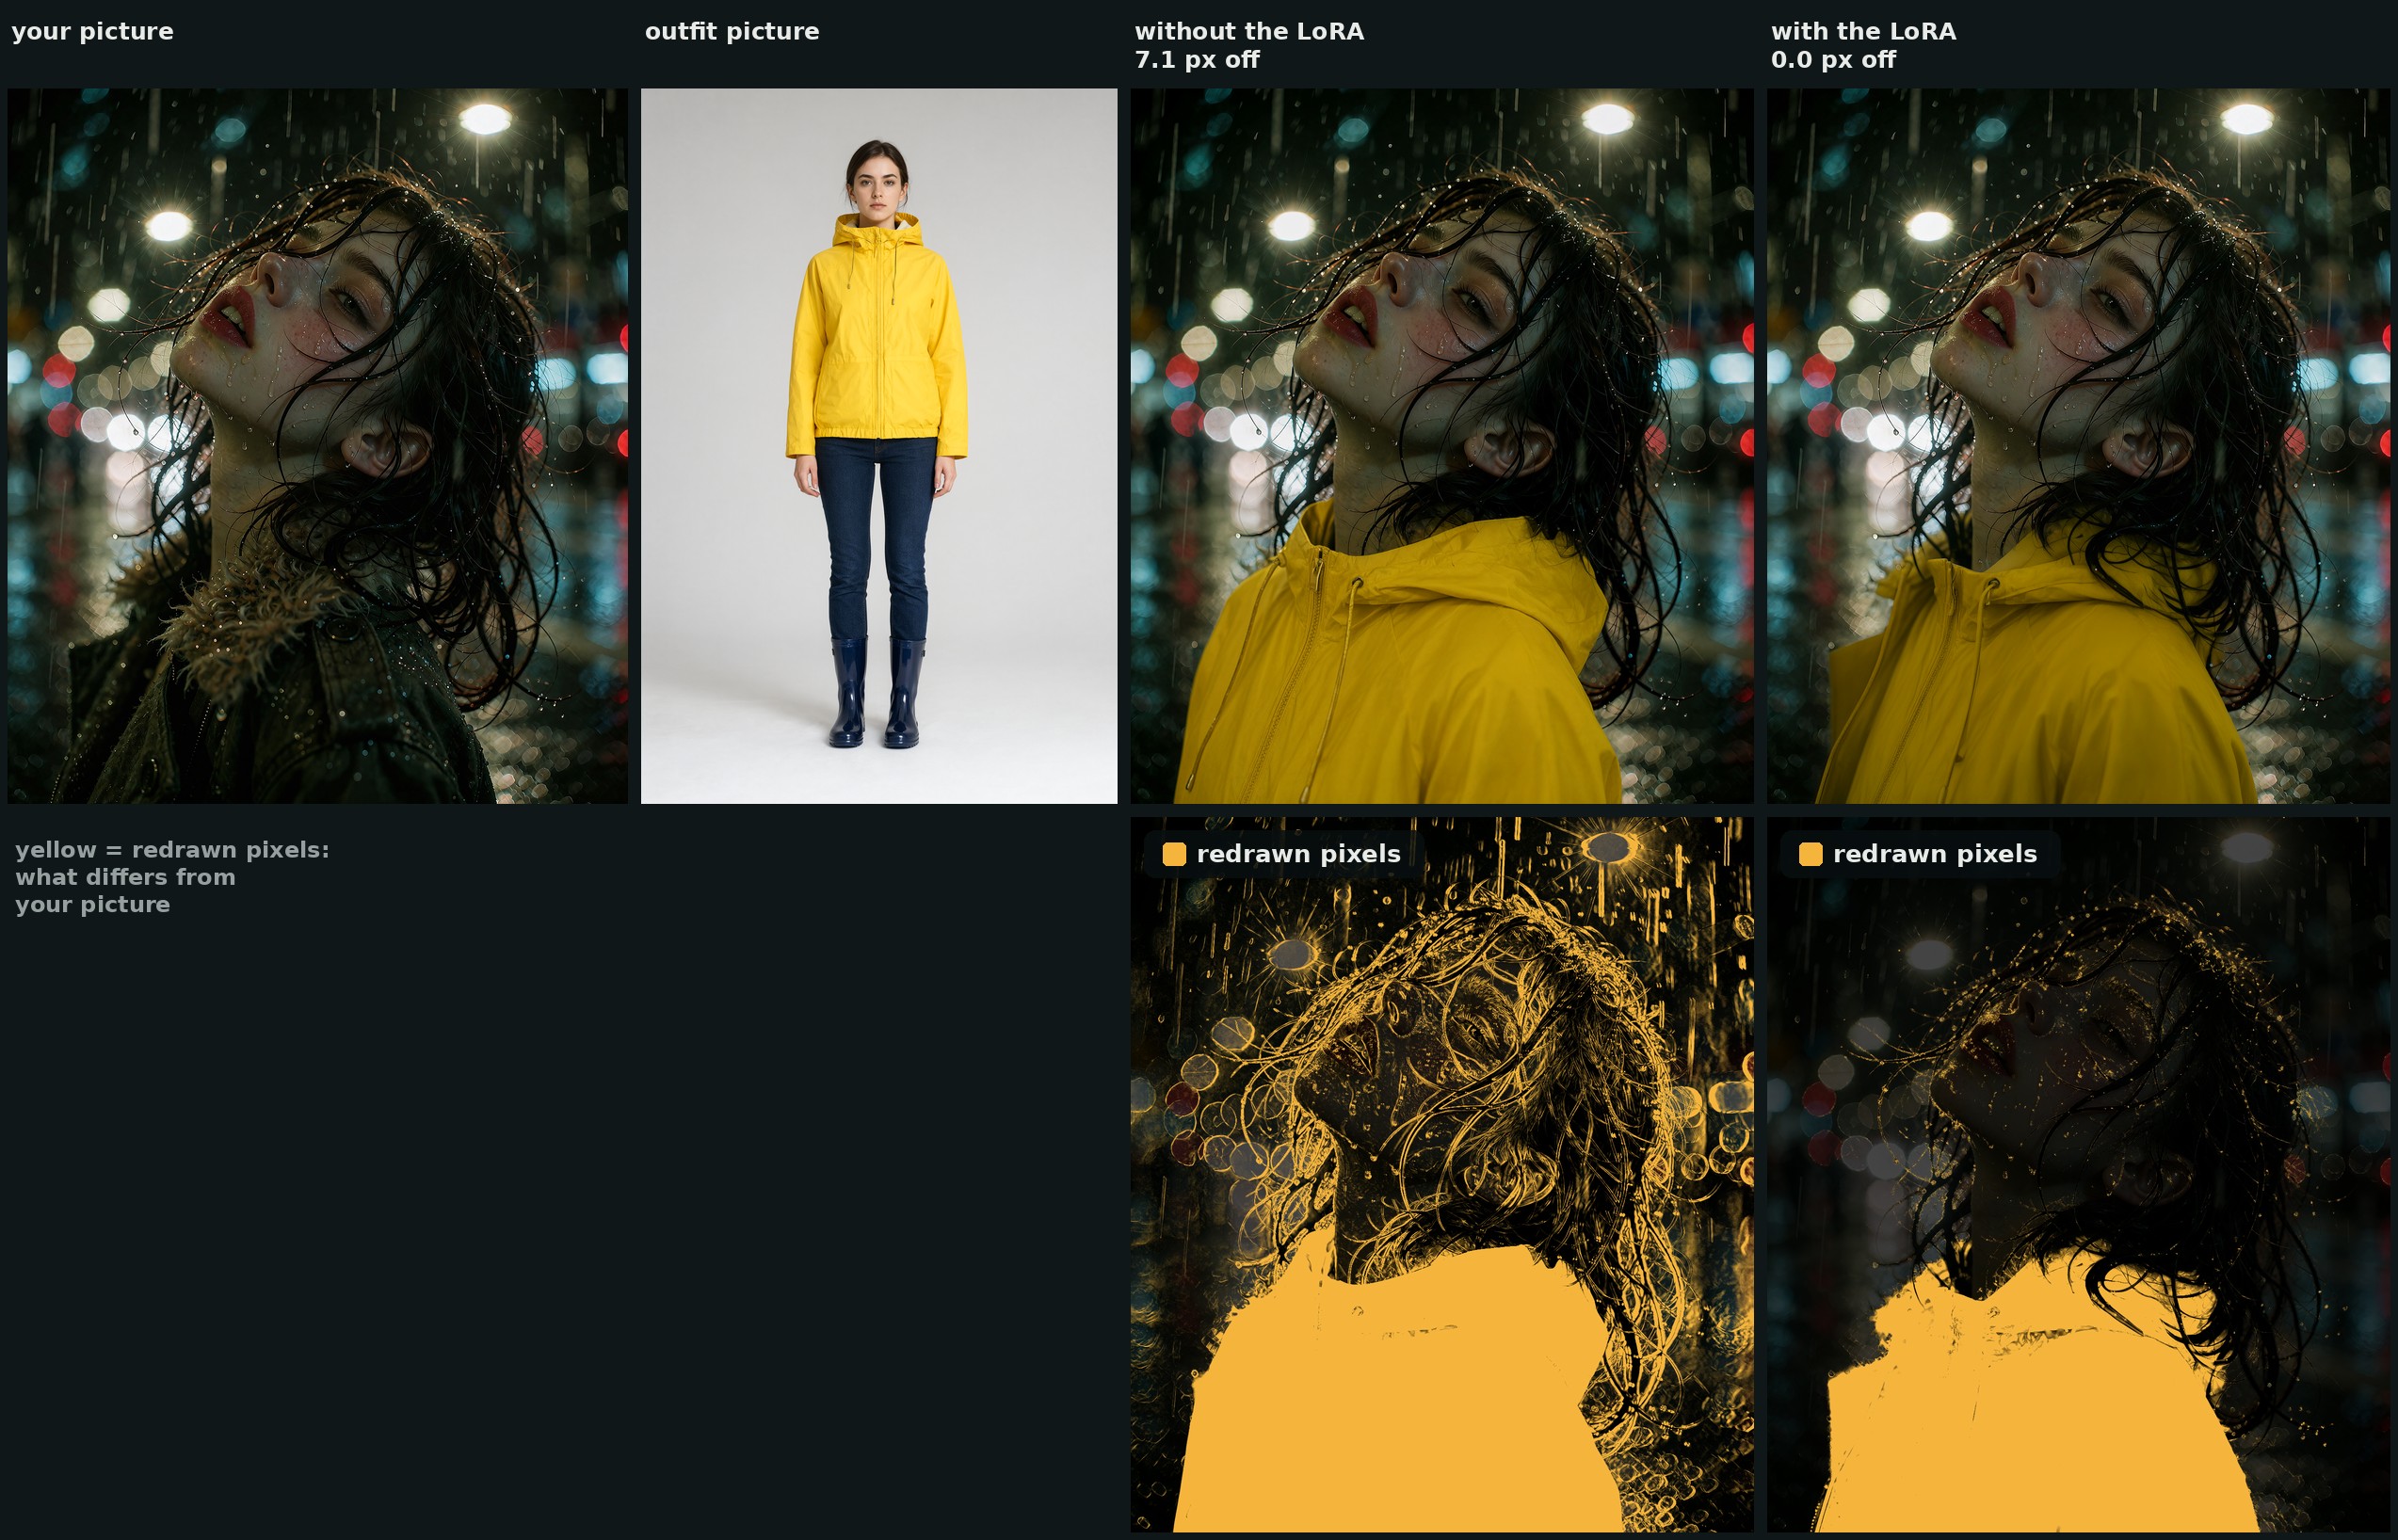 图像编辑
一款适用于 Qwen-Image 2.1 的社区 LoRA 能把换装结果还原到原图之上:构图、面部与背景保持不变,只改变服装,并附带 ComfyUI 工作流。
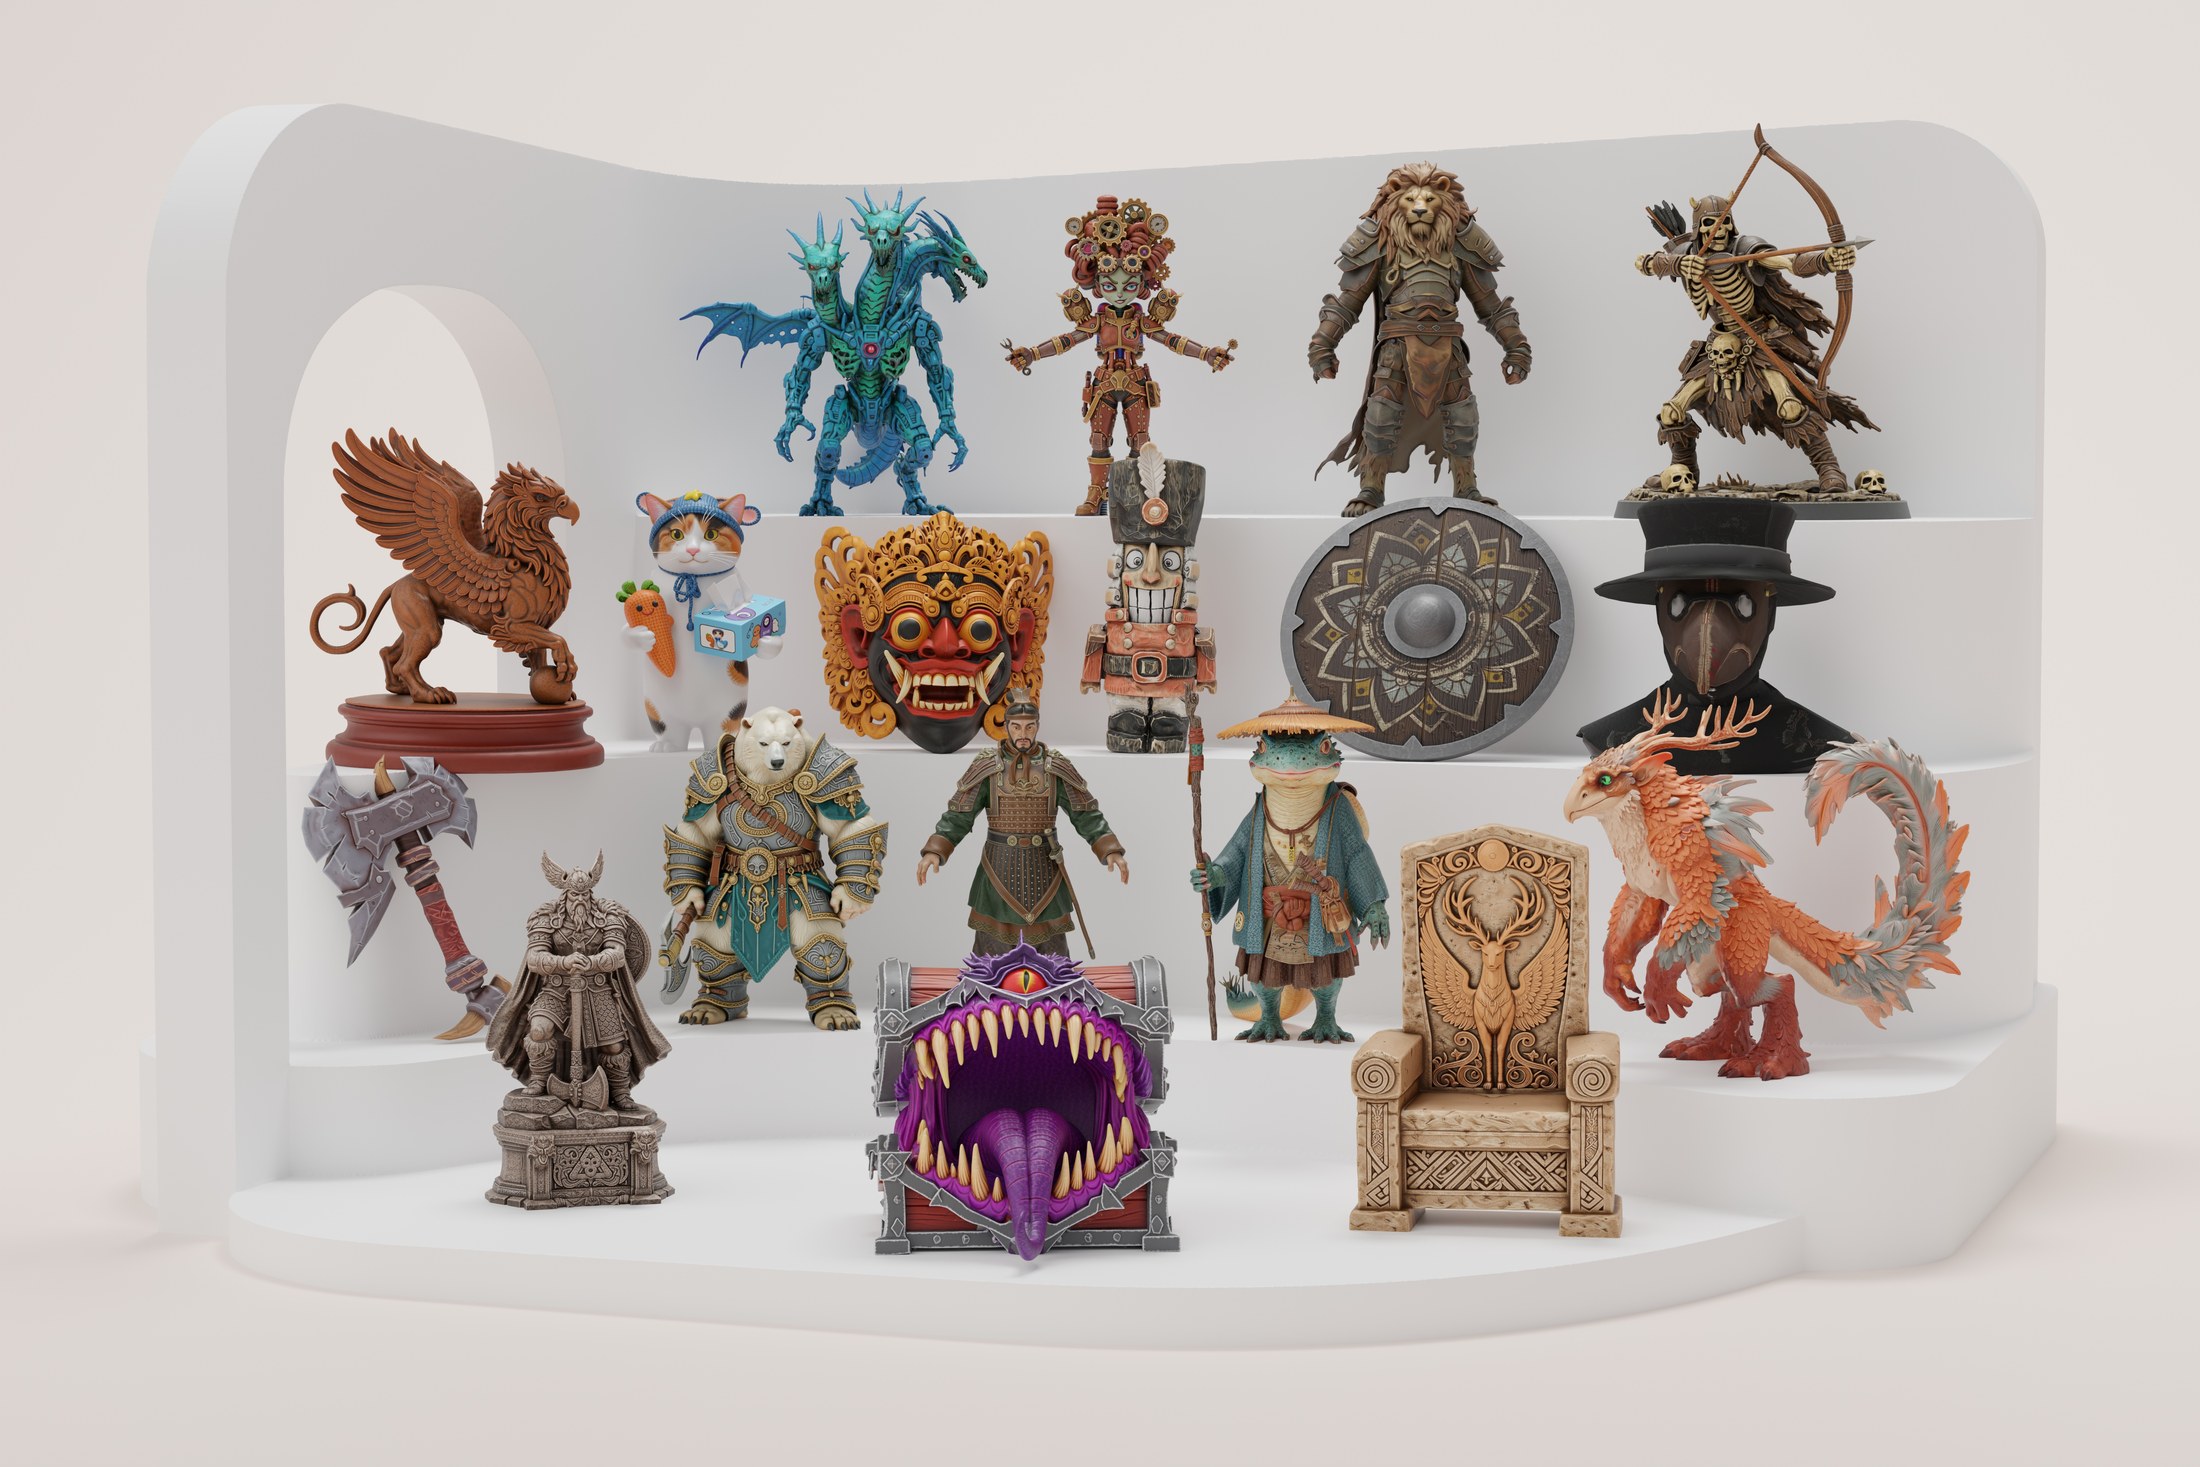 图生 3D
吉林大学与 VAST 的 UltraTex 借助背景 token 丢弃和块稀疏注意力,以 2048x2048 分辨率为 3D 网格生成纹理,并附带 ComfyUI 节点包。