Sesame 发布 CSM 语音模型:实现自然对话交互
ComfyUI Wikinews
Sesame Research 推出双 Transformer 架构的对话语音模型 CSM,凭借开源核心架构实现接近人类的语音交互
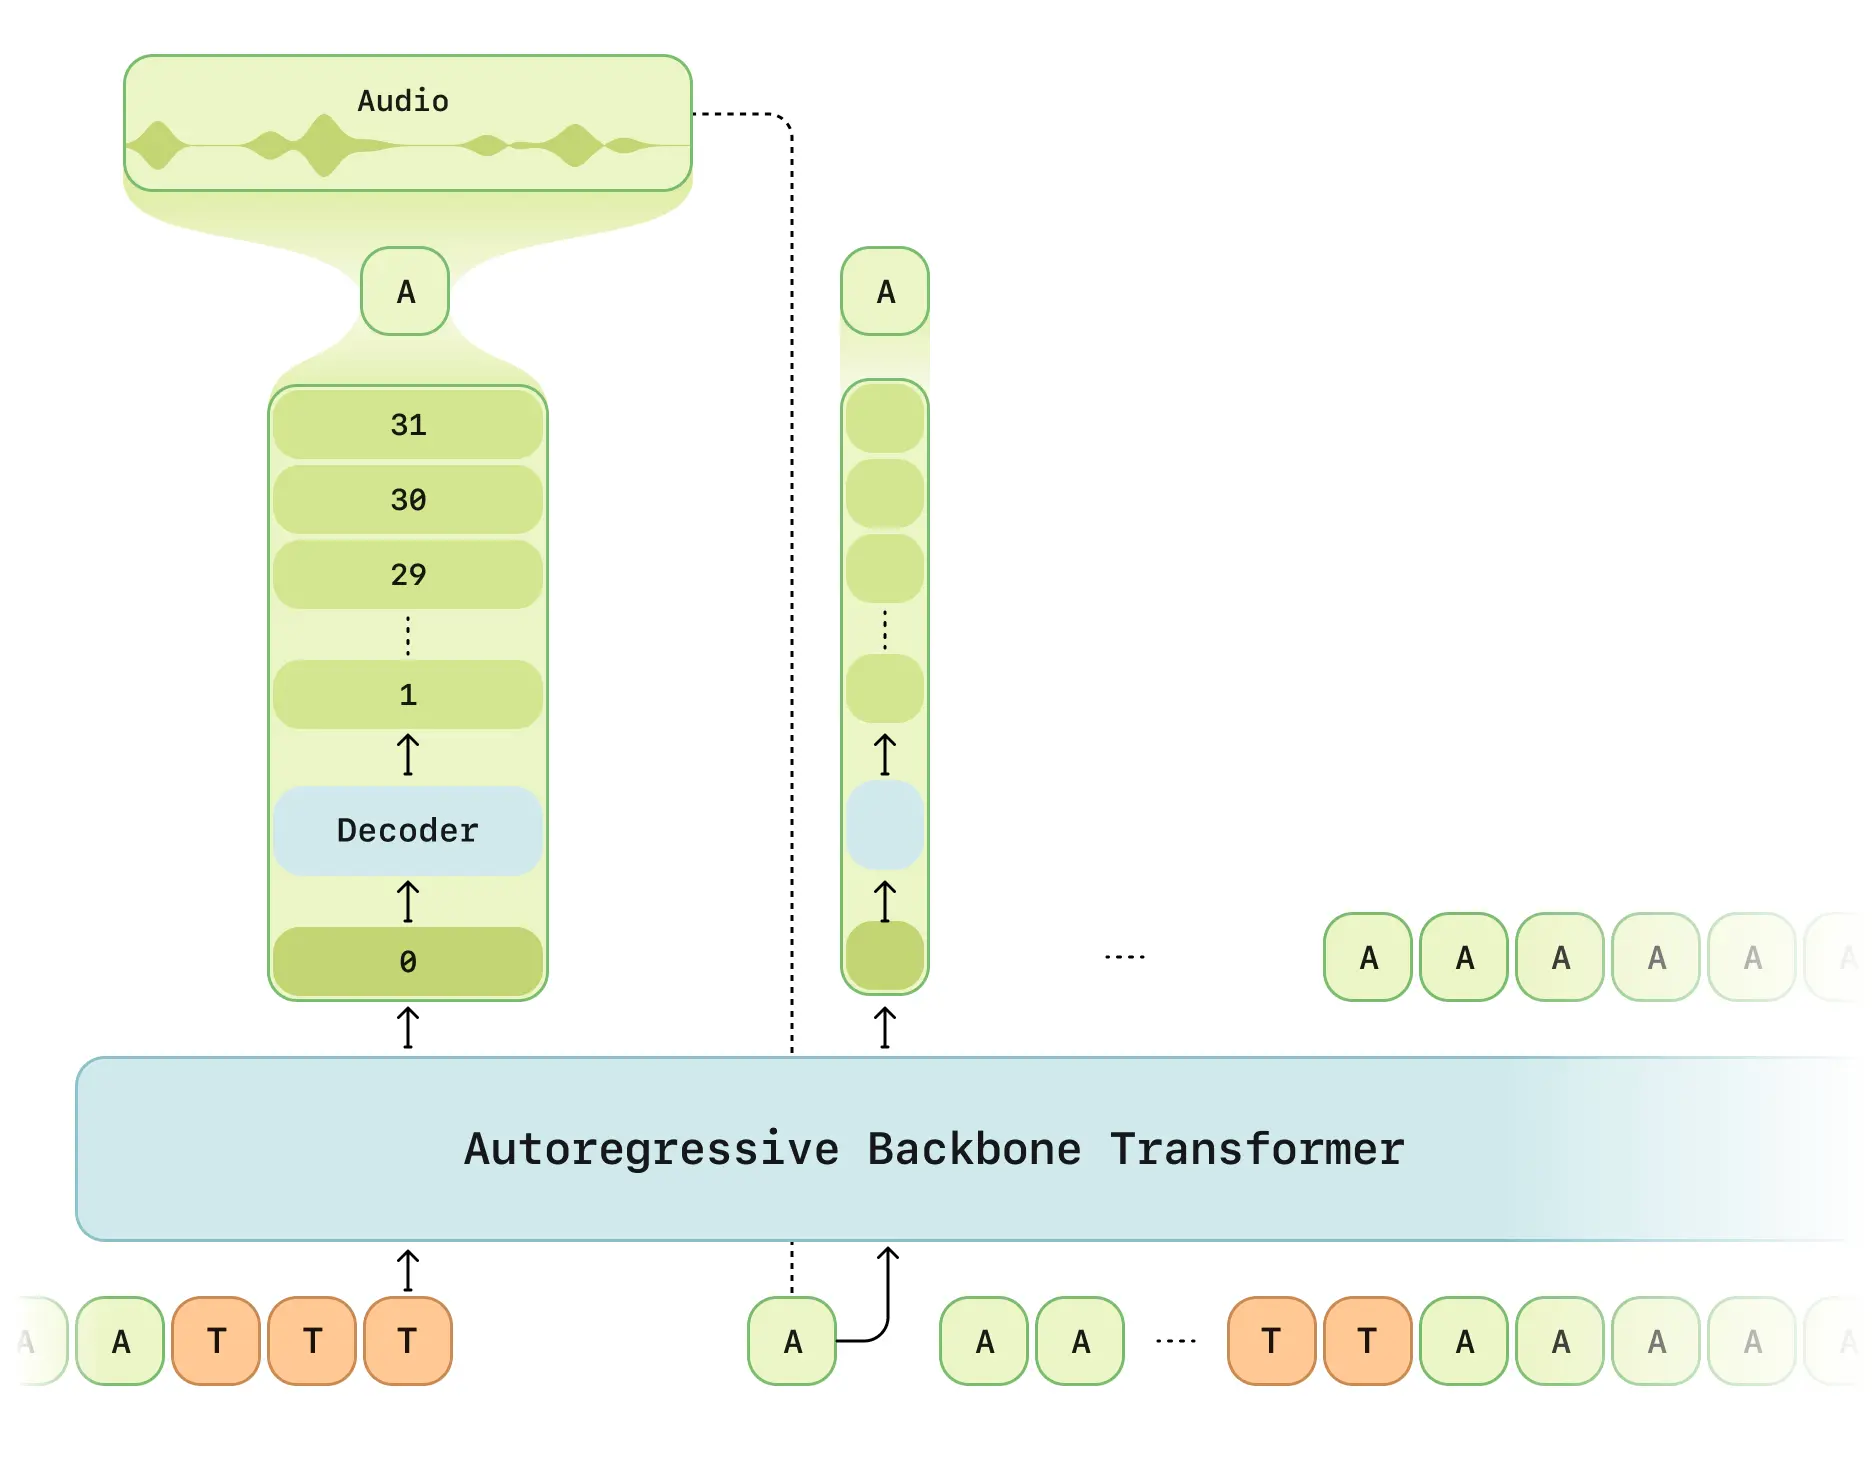
Sesame Research 的**对话语音模型(Conversational Speech Model,CSM)**在官方演示中展现了突破性的能力。双 Transformer 架构实现了接近人类的语音交互。
技术架构
核心设计特点:
- 双阶段处理:多模态主干网络(文本/语音)+ 音频解码器
- RVQ 分词器:Mimi 离散量化器,帧率 12.5Hz
- 延迟优化:解决传统 RVQ 生成延迟问题
- 计算调度:1/16 帧采样以提升效率
- Llama 框架:基于 LLaMA 的主干网络
核心特性
- 上下文感知:2 分钟对话记忆(2048 tokens)
- 情感智能:6 层情感分类器
- 实时交互:端到端延迟 < 500ms(平均 380ms)
- 多说话人支持:同时处理多路语音
技术规格
| 参数 | 详情 |
|---|---|
| 训练数据 | 100 万小时英语对话 |
| 模型规模 | 8B 主干网络 + 300M 解码器 |
| 序列长度 | 2048 tokens(约 2 分钟) |
| 硬件支持 | RTX 4090 或更高 |
开源状态
GitHub 仓库包含:
- 完整的架构白皮书
- REST API 示例
- 音频预处理工具包
- 模型量化指南
⚠️ 限制:
- 核心训练代码尚未发布(计划 2025 年 Q3)
- 需要 API 密钥
- 以英语为主的实现
评估结果
官方基准测试显示:
- 自然度:CMOS 评分与真人录音相当
- 上下文理解:准确率提升 37%
- 发音一致性:95% 稳定性
- 延迟:首帧生成提升 68%
评论
使用 GitHub 登录后即可参与讨论。