 画像編集
ツール
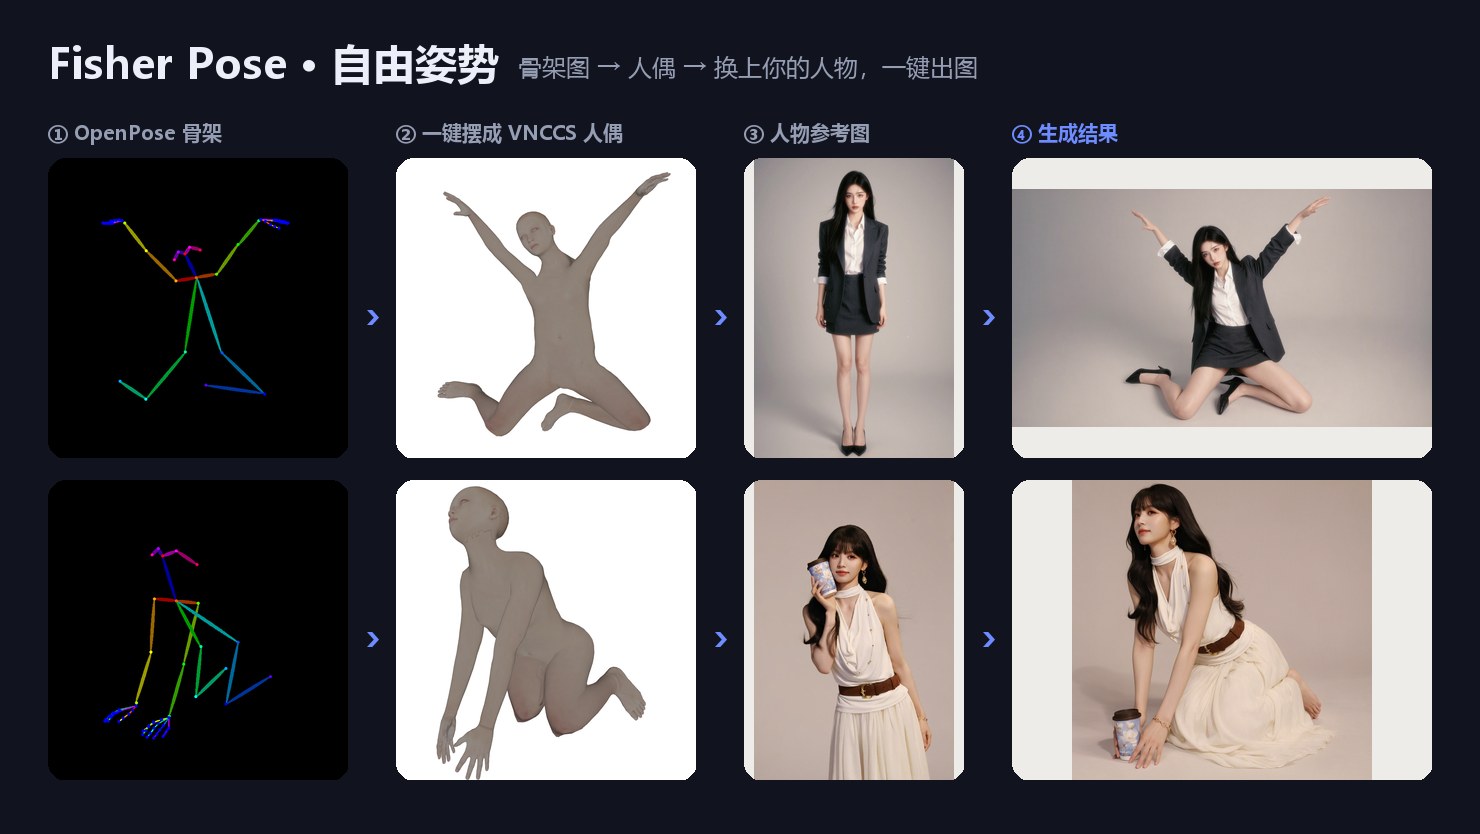
Fisher Pose: Qwen-Image 2.1向けポーズ・カメラエディターFisher Poseは、3Dマネキン、209種類のOpenPoseスケルトン、対応するLoRAを使って、Qwen-Image 2.1でキャラクターを新しいポーズやカメラアングルで描き直すComfyUIノードです。
ComfyUI エコシステムの最新情報:オープンソースモデルのリリース、カスタムノード、ワークフロー、ツールのアップデート。
画像編集Fisher Poseは、3Dマネキン、209種類のOpenPoseスケルトン、対応するLoRAを使って、Qwen-Image 2.1でキャラクターを新しいポーズやカメラアングルで描き直すComfyUIノードです。
 テキスト→画像
madebyollin氏のTexture-Fix-VAEは、Qwen-Image 2.1のVAEデコーダーを再トレーニングし、チェッカーボード状のテクスチャアーティファクトを除去します。ファイルをComfyUI/models/vaeに配置し、通常どおり読み込むだけです。
qwen-research
 テキスト→画像
Alibaba PAIがQwen-Image 2.1を346 MBのPDD LoRAで4ステップに蒸留。テキストから画像への生成と指示ベースの編集に対応し、独自のシグマスケジュールを備えます。
qwen-research
 テキスト→画像
ByteDanceのSeedream 5.0 Flashが、ComfyUIのByteDance画像ノードに高速重視のティアを追加しました。テキストから画像への生成と画像編集のテンプレートを最大2Kで利用できます。
API-Only
 テキスト→画像
Alibaba PAIのQwen-Image 2.1向けControlNet Unionは、8種類の構造制御とインペイントを1つの7.5 GBブランチにまとめ、ComfyUIサポートもコアにマージされました。
qwen-research
 テキスト→画像
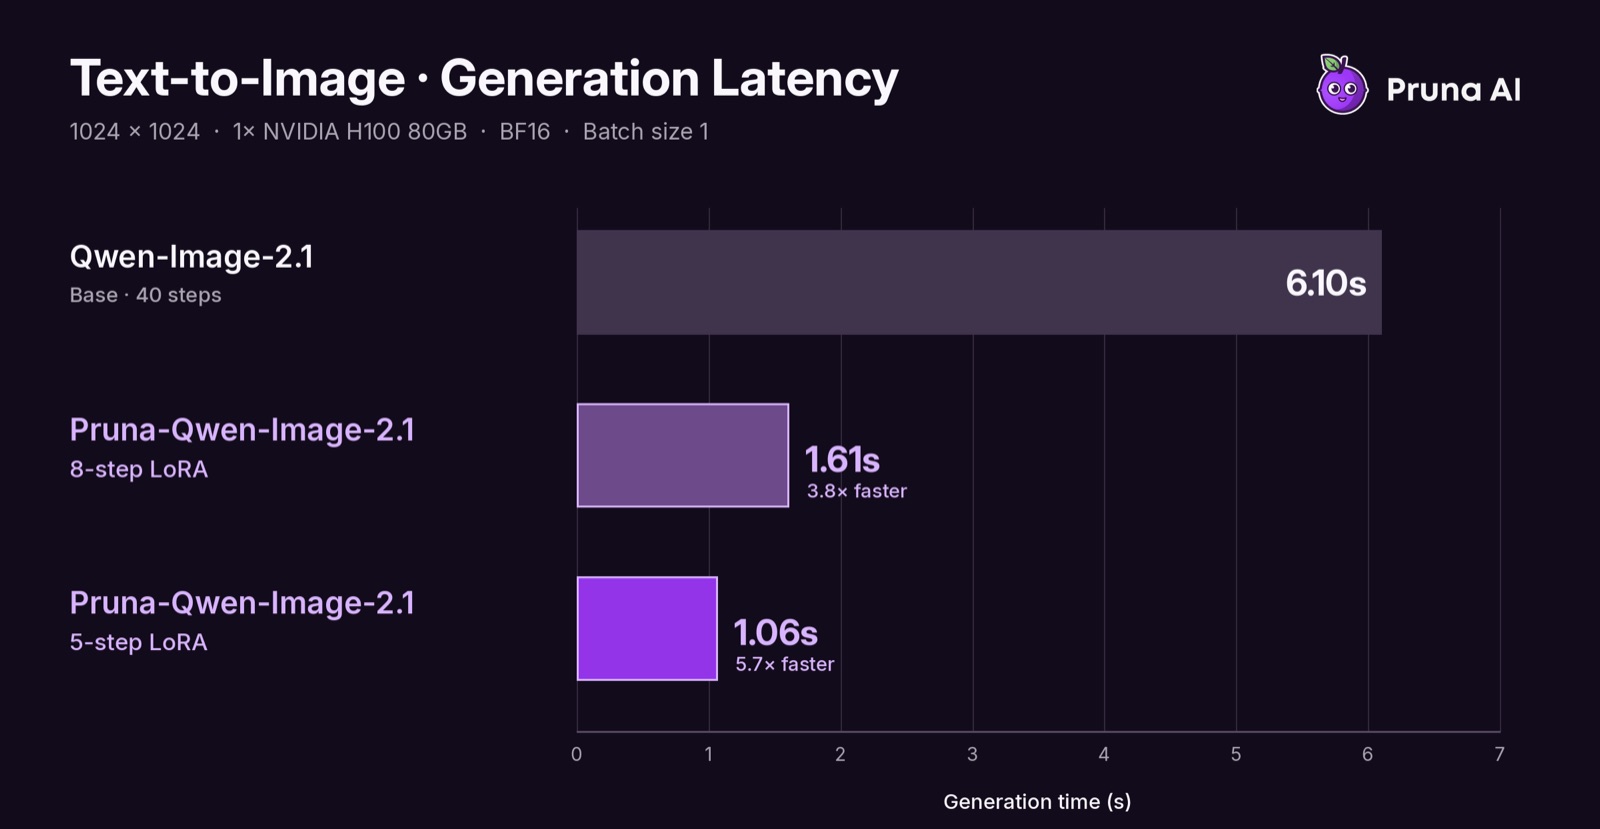
PrunaAI の Pruna-Qwen-Image-2.1 LoRA は、Qwen-Image 2.1 の生成と編集を CFG なしの 5 または 8 ステップに短縮します。コミュニティによる ComfyUI 変換版とステップごとのシグマスケジュールも紹介します。
Qwen Research License
 テキスト→画像
ViggleによるQwen-Image 2.1のv0.2 DMD蒸留は、CFGなしで生成を5ステップに短縮。rank-256 LoRAとして公開され、コミュニティによるComfyUI変換も提供されています。
Qwen Research License
 テキスト→画像
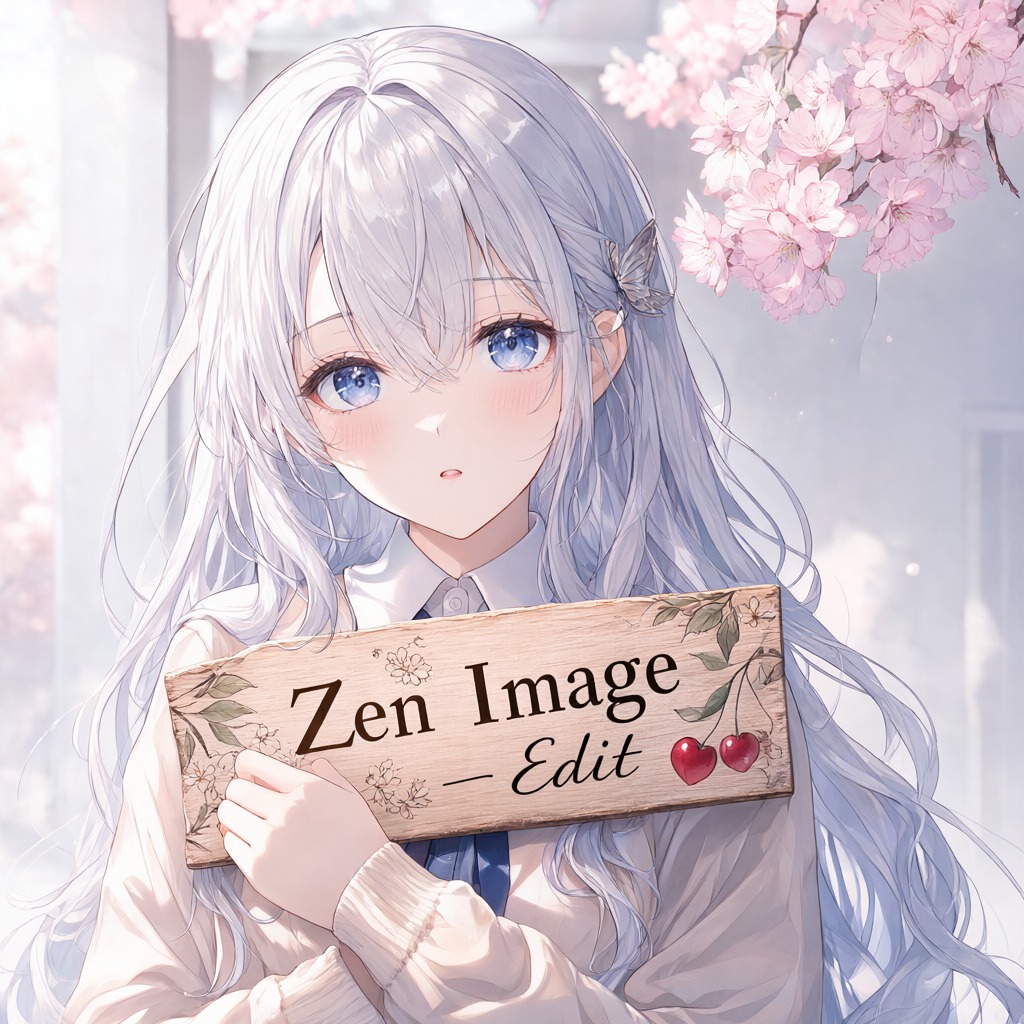
Zen Image EditはQwen3.5-0.8Bのテキストエンコーダーと158MのフュージョンアダプターでQwen-Image 2.1を動作させ、エンコーダーを17.5 GBから1.7 GBに削減します。ComfyUIでの2つの実行ルートを紹介します。
 画像→画像
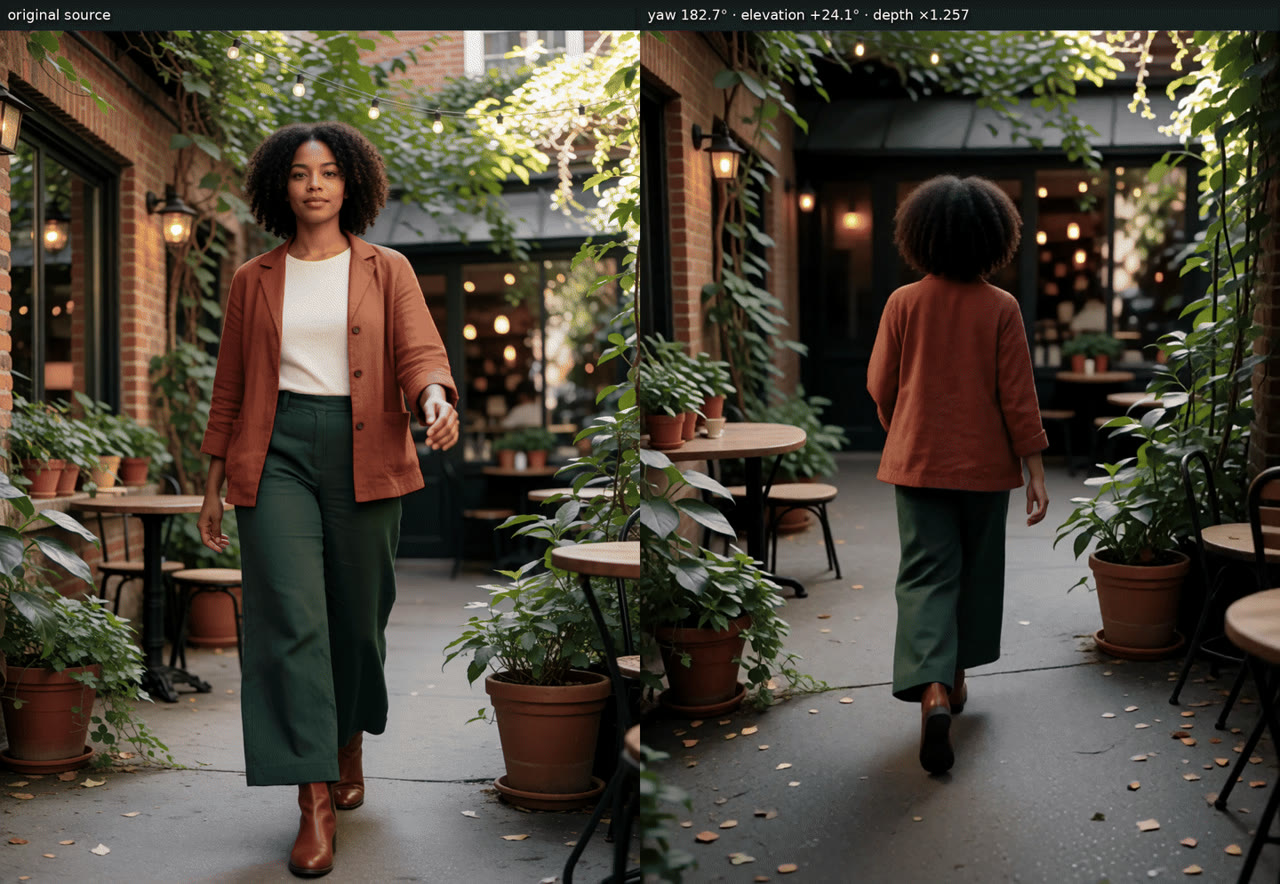
Krea 2 Anyglesは人物写真1枚から3D human normal LoRAで新しいカメラビューを生成します。オービット、仰角、距離を制御するComfyUIノードとワークフローも付属します。
 テキスト→画像
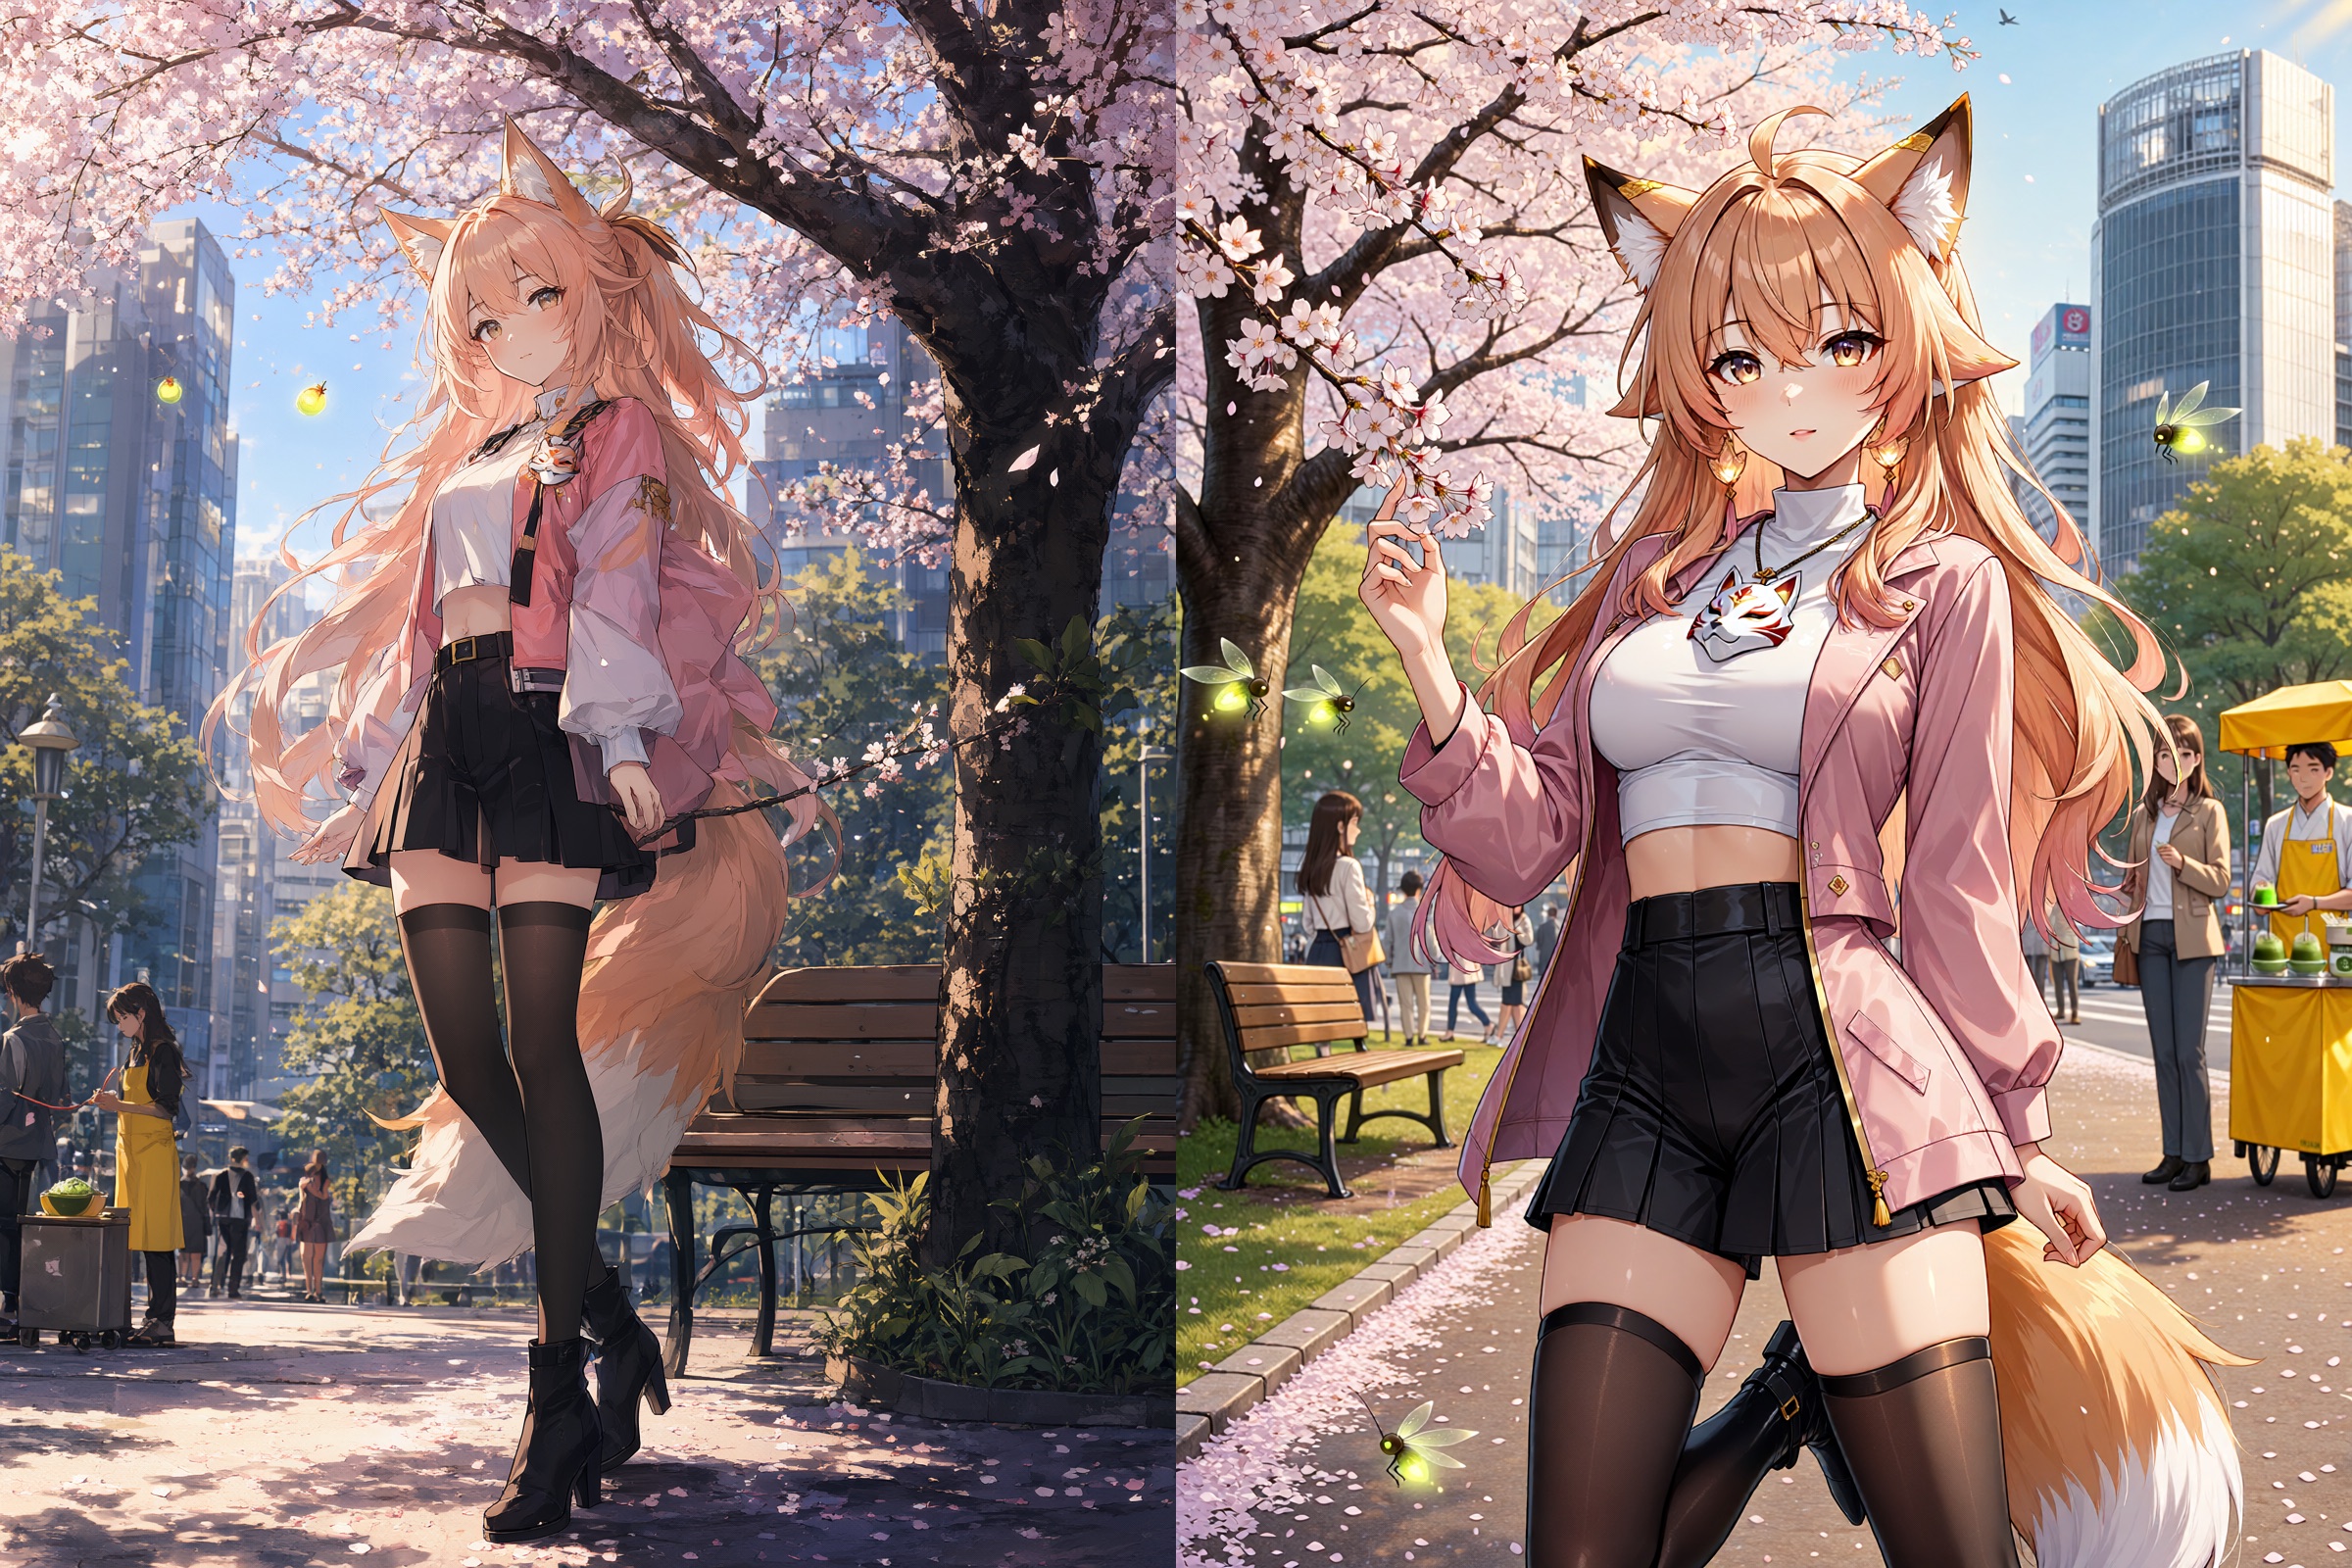
Qwen-Image 2.1 Fixは、20ステップのComfyUIワークフローを同梱したコミュニティ製LoRAです。モデルの色あせと崩れた細部の質感に対処します。
Qwen Research License
 テキスト→画像
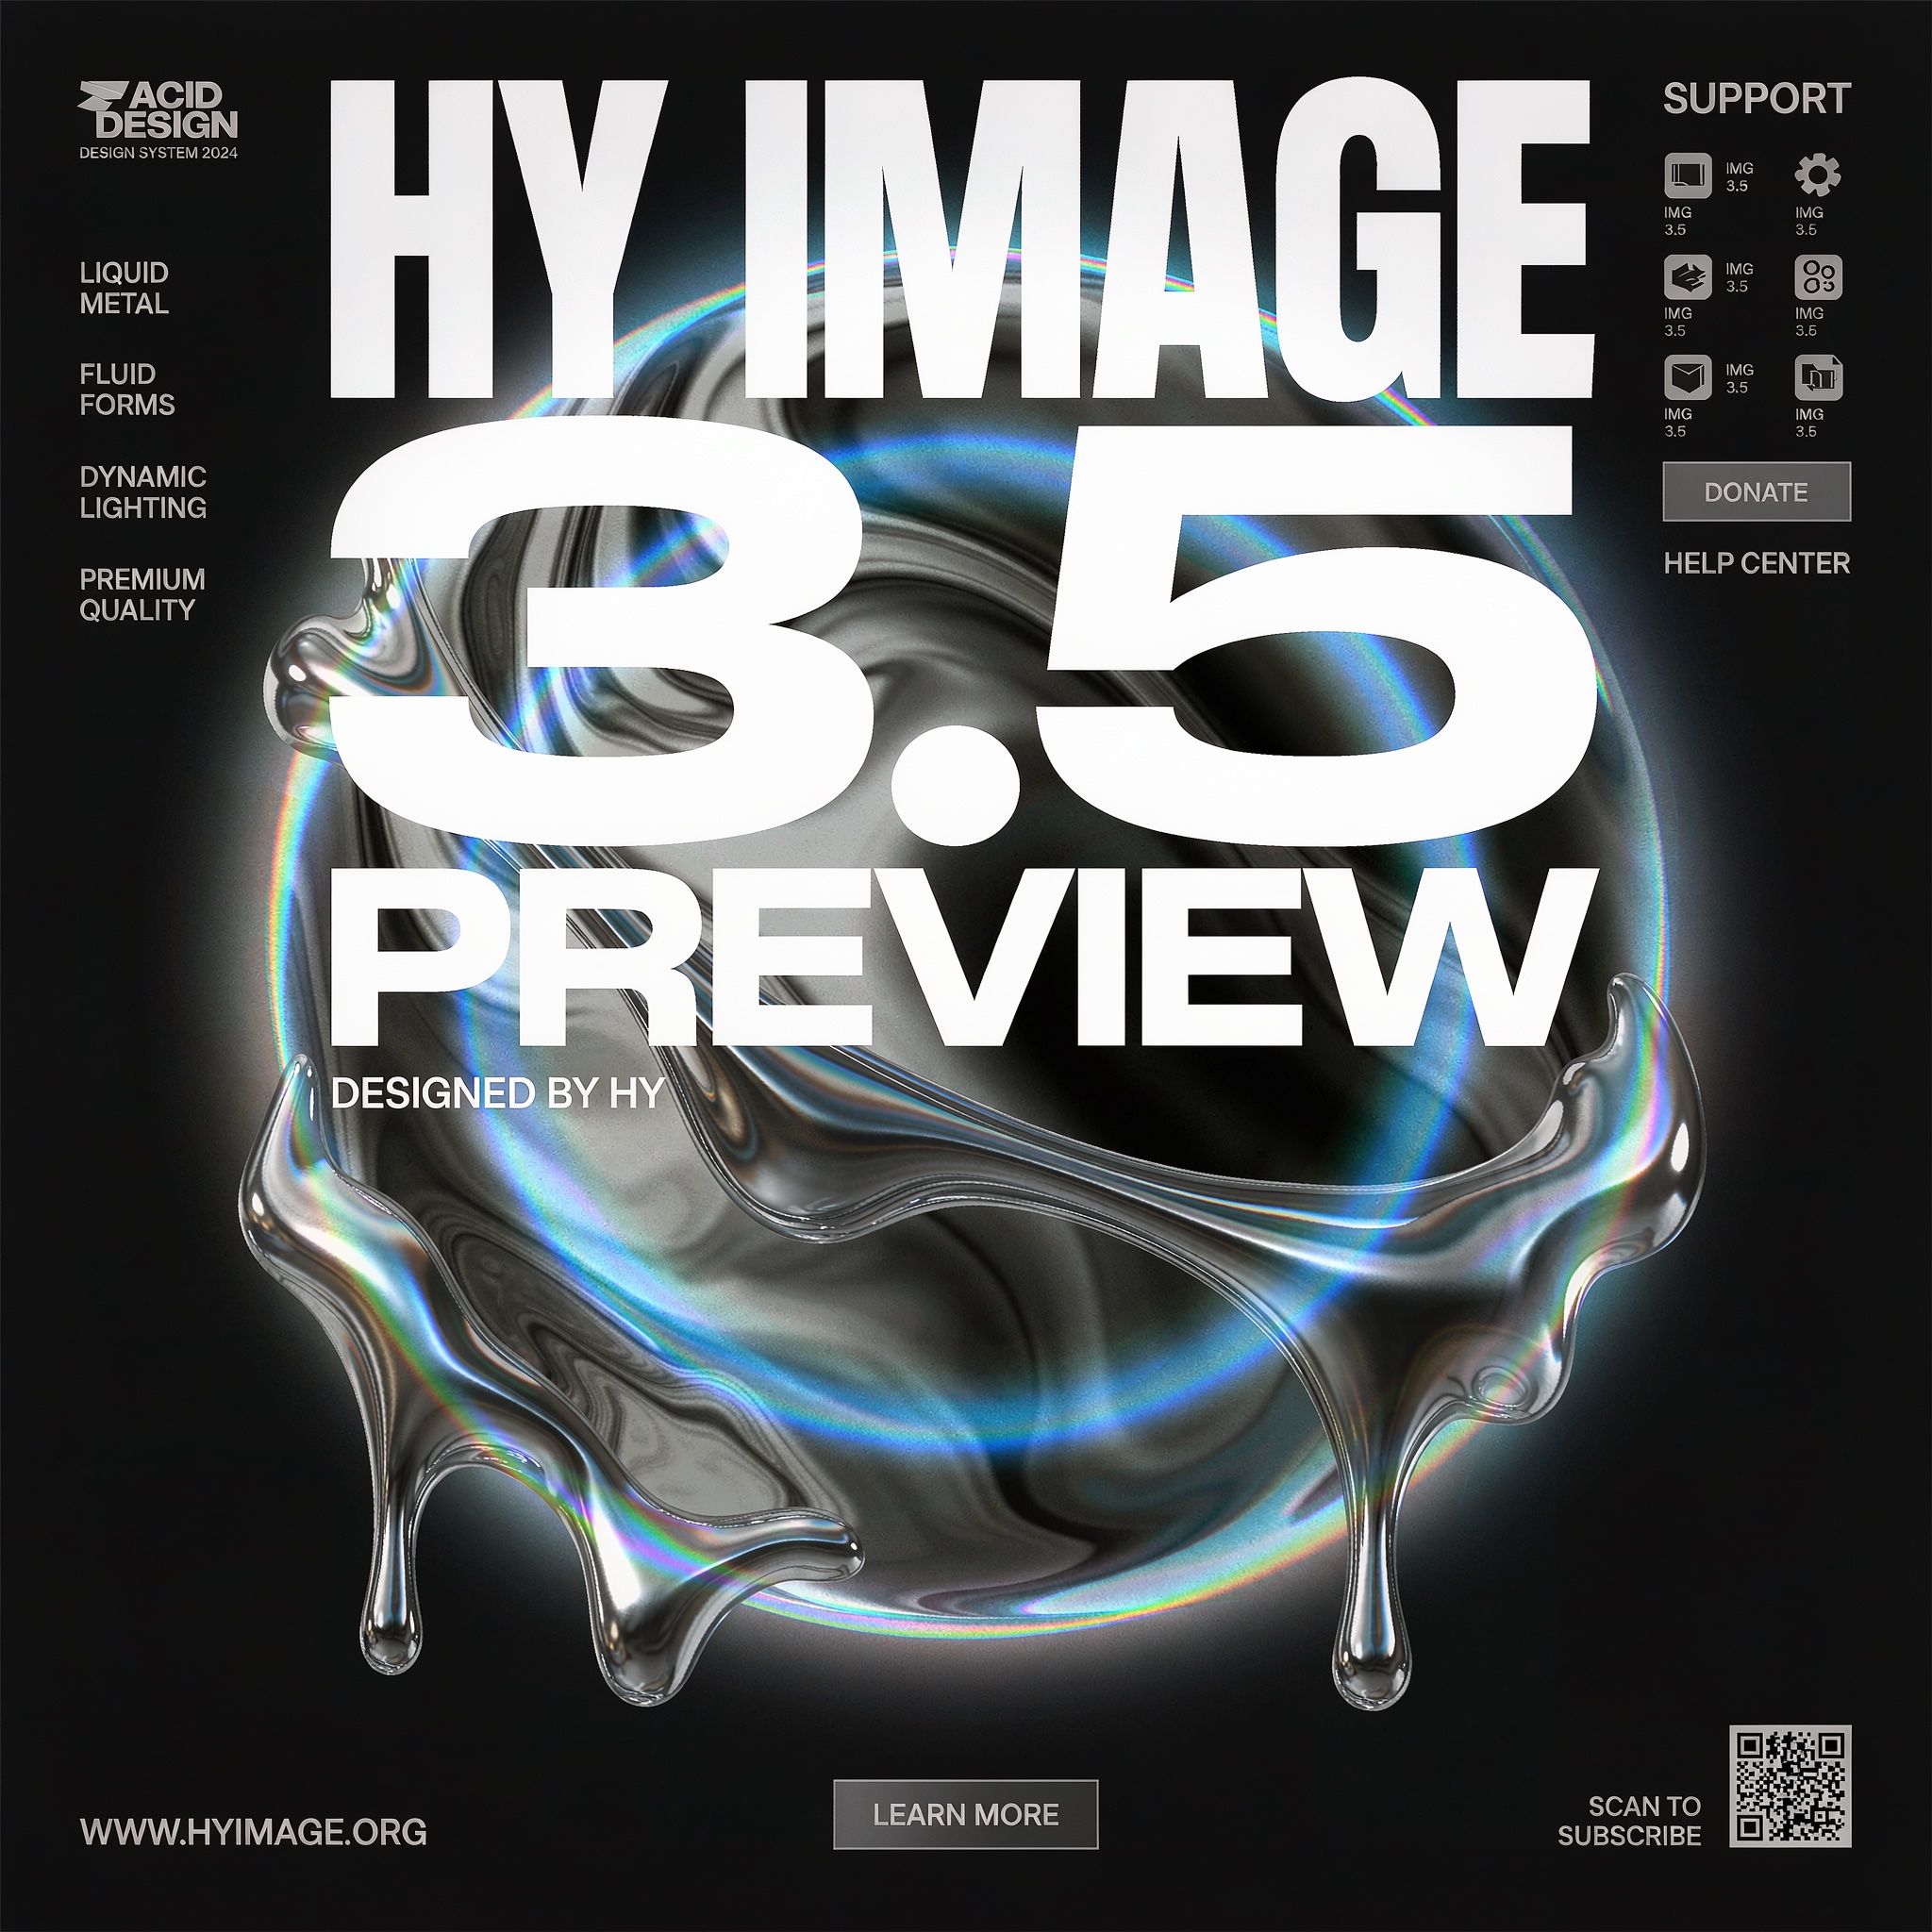
TencentのHY Image 3.5 Previewは、Hunyuan画像APIにテキストから画像へ、参照画像、マルチターン編集を追加し、ComfyUIには新しいテキストから画像へノードと編集ノードを提供します。
API-Only
 動画編集
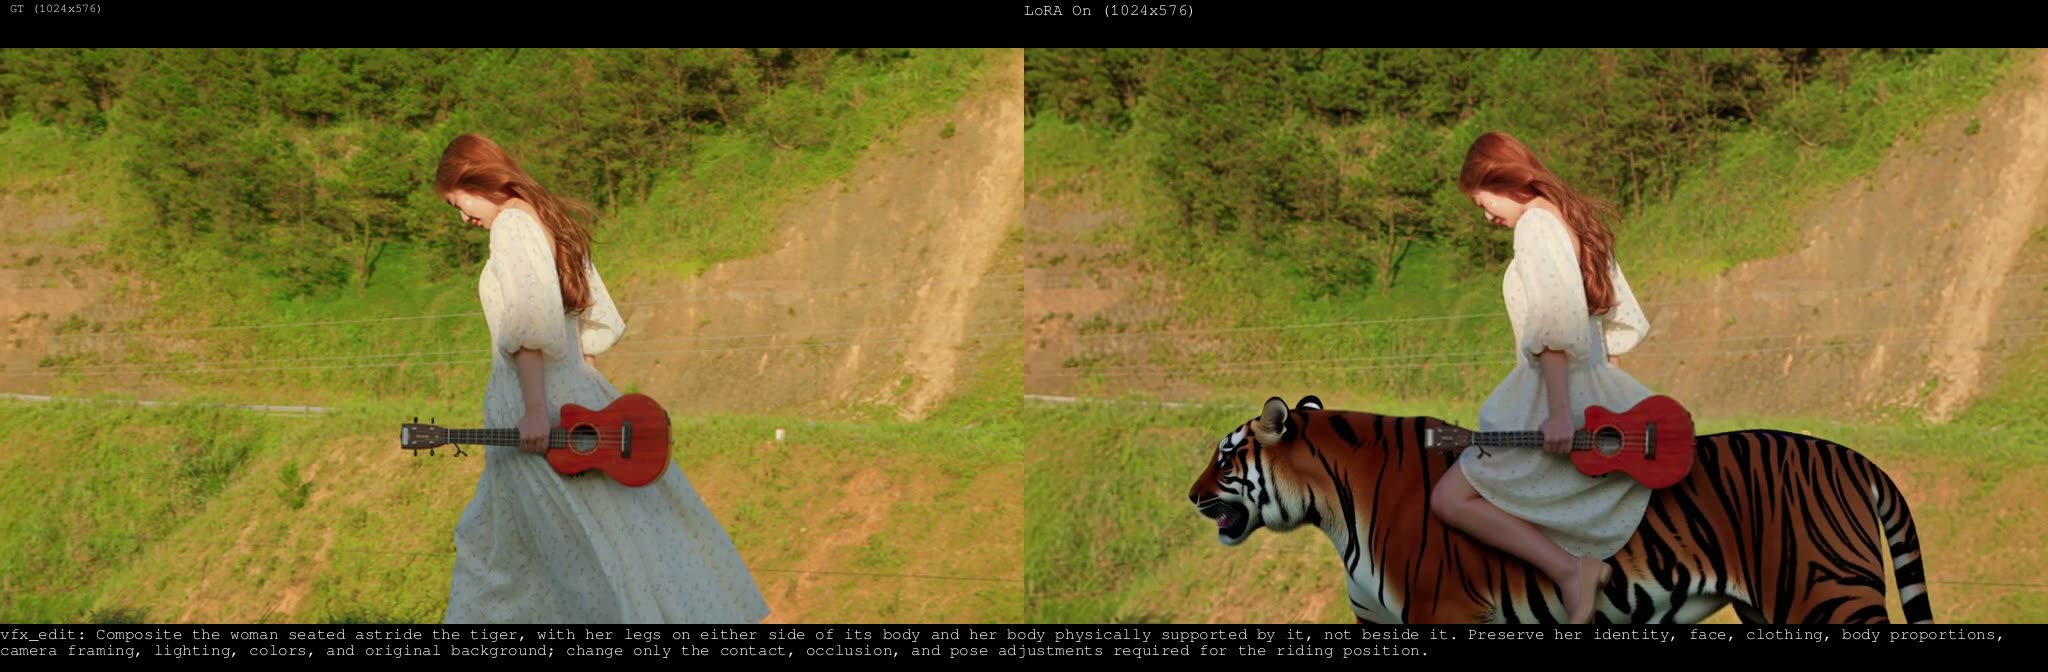
Alissonerdx の MiniMax H3 LoRA パックは、プロンプト指示による VFX Edit に加え、ドキュメント化された Style Transfer と Head Swap アダプターを追加。ComfyUI ワークフローとサンプルクリップも用意されています。
Apache-2.0
 インペイント
MiniMax H3向けAlibaba PAIのControlNet Union 2.0は、Scribble・Layout・Grayコントロールを追加し、注入ブロック数を倍増。ComfyUIも同日に対応しました。
minimax-h3-community-license-agreement
 動画編集
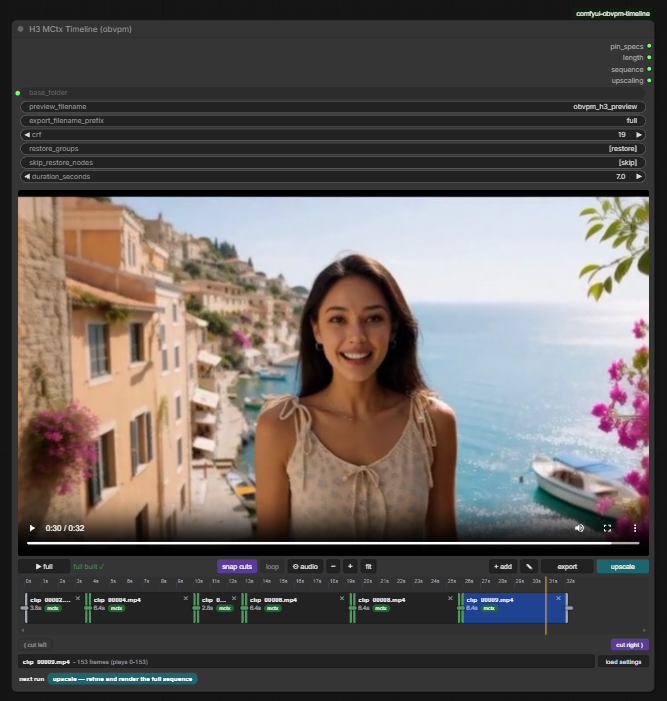
comfyui-obvpm-timelineはComfyUIにMiniMax H3向けのミニ動画エディターを追加します。クリップのExtend、Prepend、Bridge、Loopを、潜在グレードの結合と1パスのアップスケールで実現します。
GPL-3.0
 テキスト→画像
SupraLabsがSupra2-IMGをリリース。1億500万パラメータのDiTテキストから画像へのモデルで、H100 1台で10時間かけてゼロからトレーニングされ、256x256のサンプルを公開しています。
Apache-2.0
 テキスト→画像
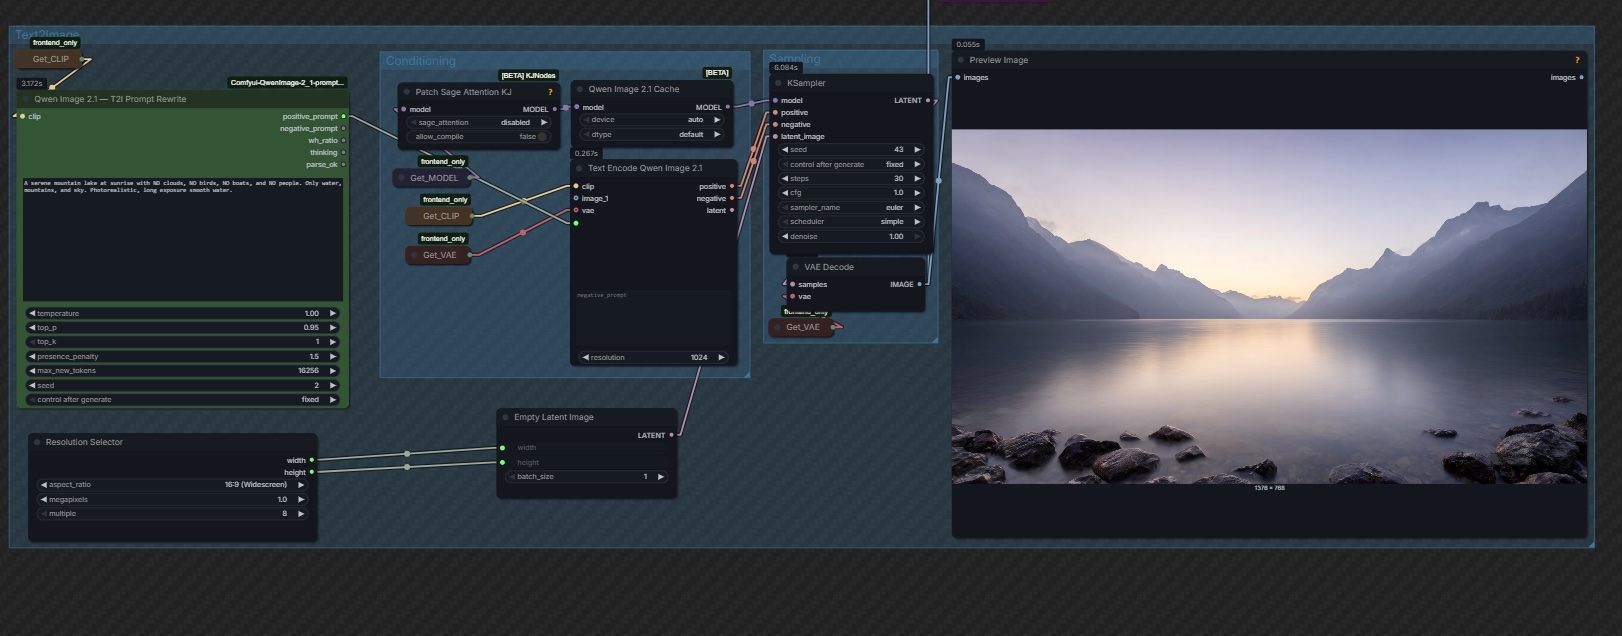
QwenのPE-T2IとPE-I2Iプロンプト書き換えモデルは短いリクエストや編集指示を展開し、コミュニティのノードパックがCLIPを読み込むことで両方をComfyUIで実行します。
 エコシステム
CsetiがCrossView-WarpをMiniMax H3へ移植。MoGe深度ワープを使い、既存映像を新しいカメラアングルから再レンダリングするRef2VA LoRAとComfyUIノードです。
MiniMax-H3-Community
 エコシステム
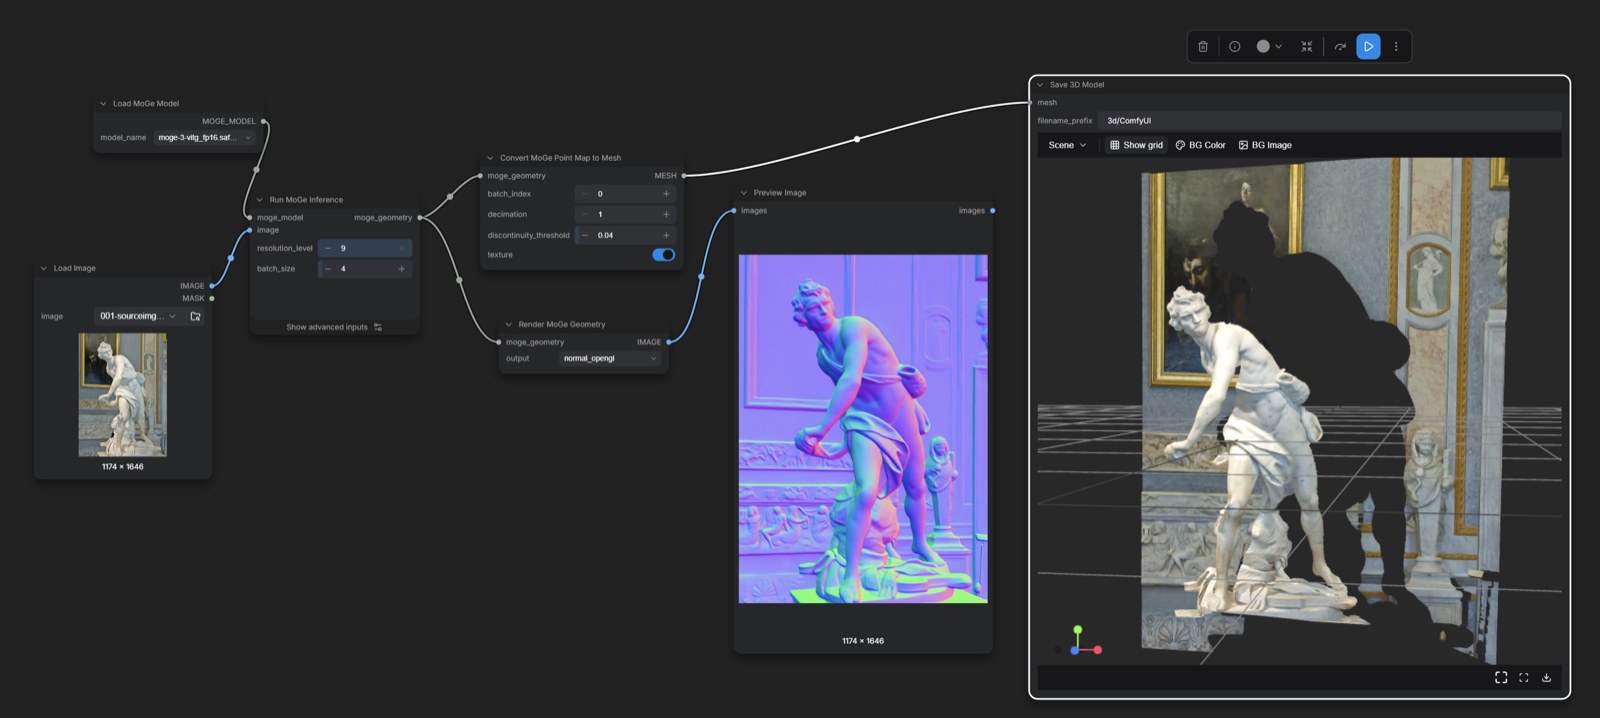
ComfyUI v0.37.0では、3つの公式テンプレートを備えたQwen-Image 2.1のネイティブサポート、MoGe 3ジオメトリ推定、高速化されたQwen3.8テキストエンコーダー、そして自動高速ディスク読み込みが追加されました。
 テキスト→動画
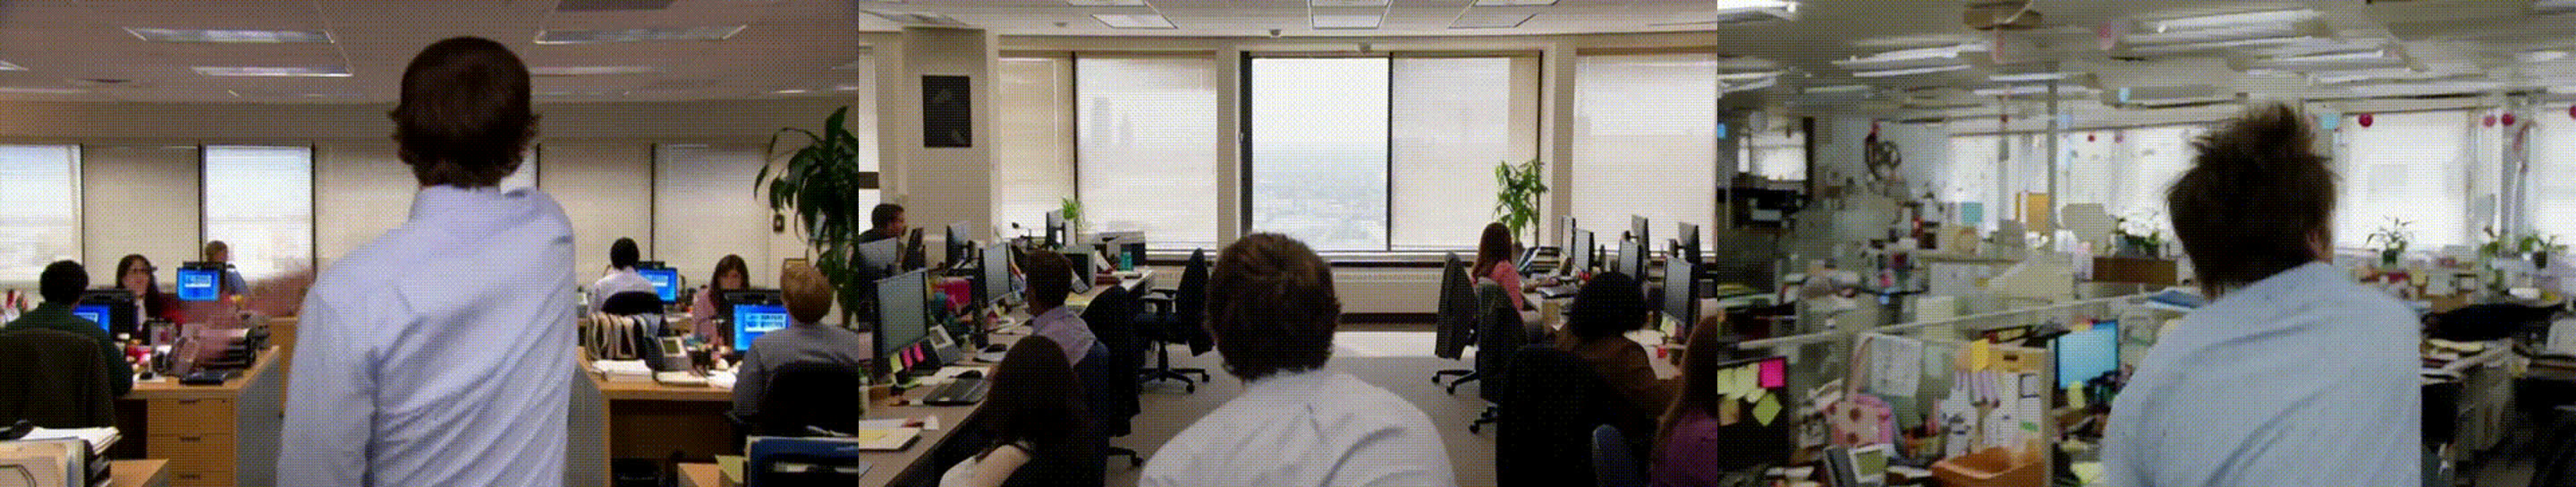
ComfyUI-MiniMax-H3-SPEED V2はEuler、Heun、DPM2、RES Multistepをサポートし、サンプラー対応のSigma Harvestを追加、I2Vキーフレームのリサイズを修正しました。
 テキスト→画像
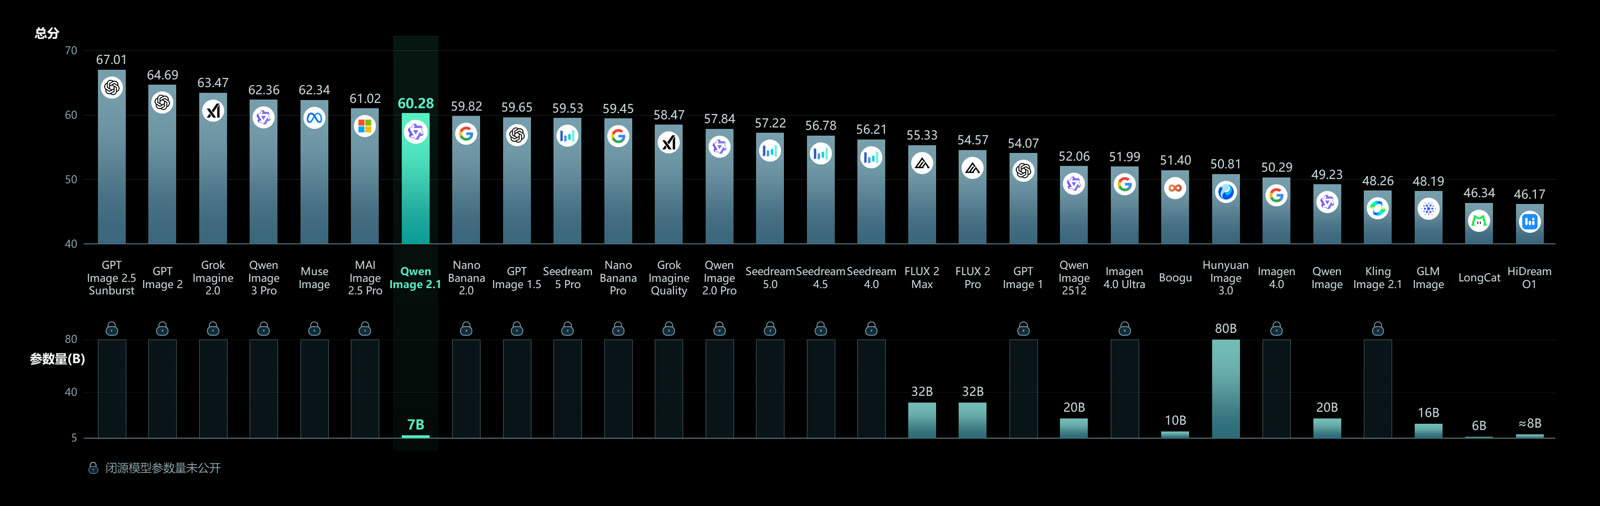
ComfyUI で Qwen-Image 2.1 をダウンロード:qwen_image_2.1_bf16 と int8_convrot の safetensors、qwen3vl_8b テキストエンコーダ、公式の 2K テキストから画像生成・画像編集・背景除去テンプレート。
Qwen Research License