Viggle Turbo v0.2: ComfyUIで5ステップ生成を実現するQwen-Image 2.1蒸留モデル
ViggleによるQwen-Image 2.1のv0.2 DMD蒸留は、CFGなしで生成を5ステップに短縮。rank-256 LoRAとして公開され、コミュニティによるComfyUI変換も提供されています。
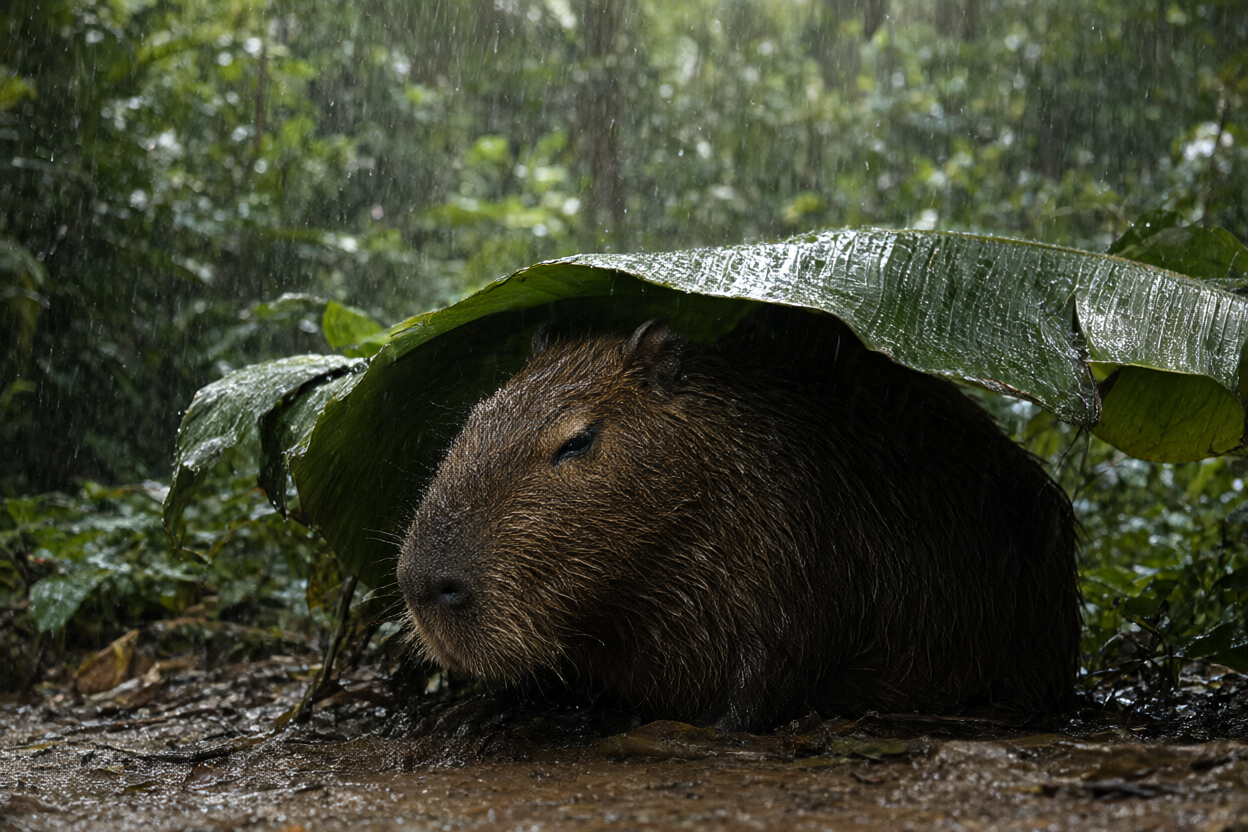
Viggle自身のデモSpaceによる5ステップのテキストから画像への生成サンプル。
v0.2での変更点
最初の公開版であるv0.1はプレビュー版で、出力の多様性が失われ、構図がベースモデルからずれていました。v0.2はより大規模な生徒モデルであり、Viggleは96件のユーザーリクエストからなるホールドアウトセット上で、40ステップのベースモデルとその公式プロンプト拡張と比較して評価しています。
| 指標 | v0.1 LoRA r64 | v0.1 フルファインチューニング | v0.2 LoRA r256、5ステップ |
|---|---|---|---|
| ベースモデルに対するサンプル多様性 | 0.75 | 0.72 | 0.93 |
| ベースモデルに対する構図のずれ | -0.019 | -0.033 | +0.000 |
多様性は8つのシードにわたるプロンプト内DINOv2パッチ距離の平均を、ベースモデルに対する比率で表したものです。ずれは、同じプロンプトとシードに対するベースモデルの出力と比べて画像の重心がどれだけ移動したかを示します。実際には、v0.2はシード間のばらつきをベースモデル並みに保ち、被写体をベースモデルと同じ位置に配置します。一方v0.1は、どのシードでも似たようなレイアウトに押し込めていました。v0.1の成果物は再現性のためにリポジトリに残されていますが、Viggleはそれらをあえて選ぶ理由はないと述べています。
実行方法
蒸留された生徒モデルは、ステップ数ではなく固定のスケジュールでサンプリングします。シグマノード [1.0, 0.875, 0.75, 0.5, 0.25] を使った5ステップ、true_cfg_scale=1.0、そしてネガティブプロンプトなしです。これは4ステップのトレーニングノードのうち、最もノイズの多い区間を2つに分割したもので、Viggleによれば、単純な4ステップ実行で生じる詳細の損失とゴーストのほとんどが解消されます。他のステップ数やCFG値を試しても効果はありません。
組み込む際に重要な詳細がもう2点あります。
- 同梱のscheduler configを使用する、または
shift_terminal=Noneを設定してください。ベースモデルのshift_terminal: 0.02は最終ステップを台無しにします。 - LoRAのスケールは1.0のままにしてください。同梱のadapterではalphaがrankと等しいためです。
テキストから画像への生成は1024と2048の面積で、編集は1024と1536の面積でトレーニングされており、編集では最大3枚の参照画像を受け付けます。その順序によって、プロンプト内で <image1>、<image2>、<image3> がどの画像を指すかが決まります。
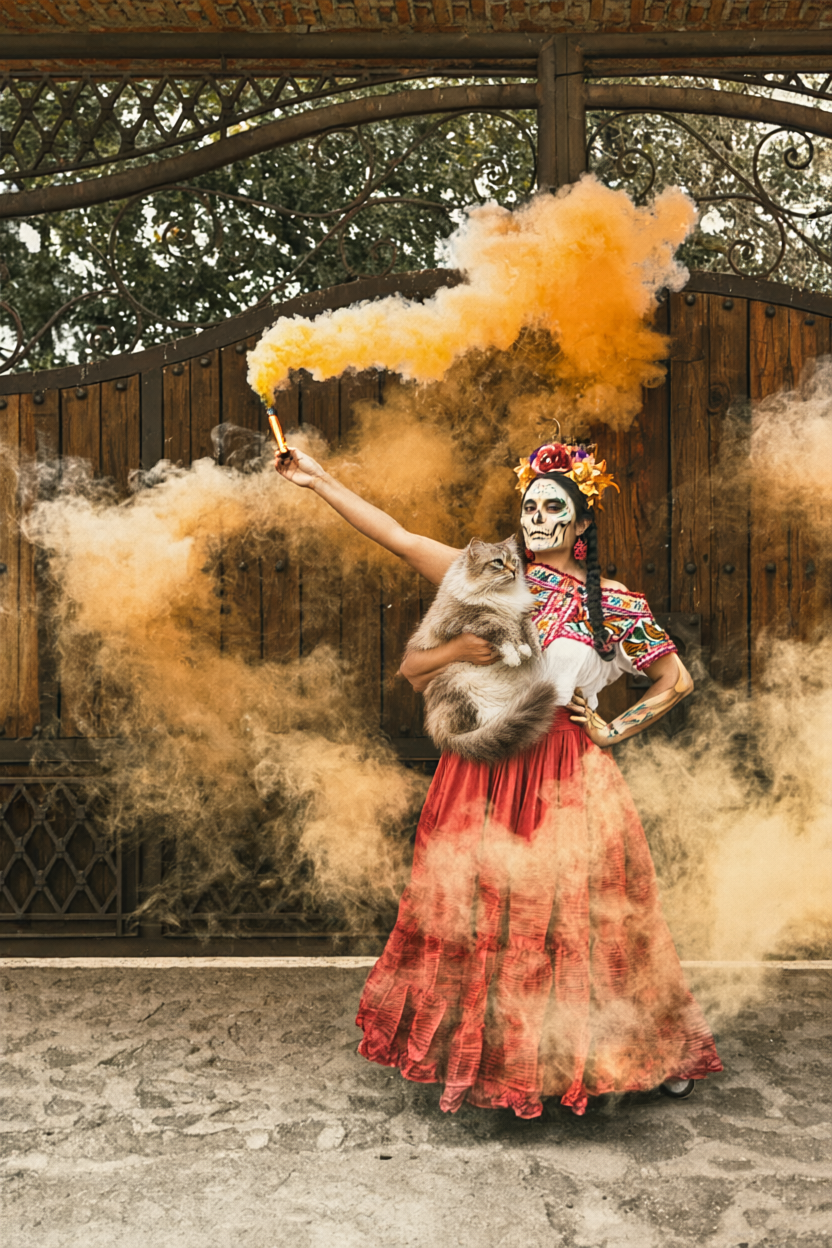
832x1248で5ステップの2枚参照編集。プロンプト: 「The woman from image 1 is holding the cat from image 2 in her arms, keep the background of image 1」。
ComfyUIでの利用可能性
公式リリースは diffusersキー形式 と並行して peft_v0.2 adapterを提供しており、ComfyUIが直接読み込む単一ファイルのkohya形式ではないため、公式のComfyUIワークフローはまだありません。コミュニティはv0.1の公開から1日でこのギャップを埋めました。
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfyは、v0.1のr64 adapterをComfyUIで読み込めるLoRAに変換したものです。- 4ステップ系の量子化ビルドもGGUFリポジトリとして存在します(Abiray、realrebelai)。他のQwen-Image 2.1量子化と同様、低VRAM環境を想定したものです。
ベースとなる Qwen-Image-2.1 のtransformer、テキストエンコーダー、VAE、processorは蒸留版に同梱されていないため、これらはベースモデルから入手する必要がありますが、ComfyUIはすでにネイティブで対応しています。
まだできないこと
Viggleはv0.2が依然としてプレビューであることを明言しています。テキストから画像への生成はベースモデルに近い結果になりますが、複雑な編集ではまだ劣ります。複数参照の構図、顔の入れ替え、本人確認書類の編集では、人物が重複したりゴーストが生じたりすることがあり、「すべて同じままに」というリクエストでは本人の同一性がずれることがあり、小さなテキストや長いテキストの描画は40ステップの場合より頻繁に文字化けします。2K出力は教師モデルに対して検証されておらず、RGBA出力、3枚を超える参照、マスクベースの局所編集は未検証です。
このモデルはすでにComfyUIコミュニティで取り上げられており、リリースはBanodocoの #qwen-image チャンネルやr/StableDiffusionでも話題になっています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。