CrossView-Warp LoRA: MiniMax H3動画に新しいカメラアングルを追加
CsetiがCrossView-WarpをMiniMax H3へ移植。MoGe深度ワープを使い、既存映像を新しいカメラアングルから再レンダリングするRef2VA LoRAとComfyUIノードです。
これはLTX-2.3 IC-LoRA版に続くCrossViewファミリーの3番目のリリースであり、プロンプトによるカメラフレーズではなくMiniMax H3 Ref2VA上に構築された最初のものです。カメラをどこへ動かすかを記述する代わりに、ノードが実際のジオメトリで既存の映像をワープし、その結果をガイドとしてモデルに渡すため、新しいアングルは深度マップが示す位置に収まります。
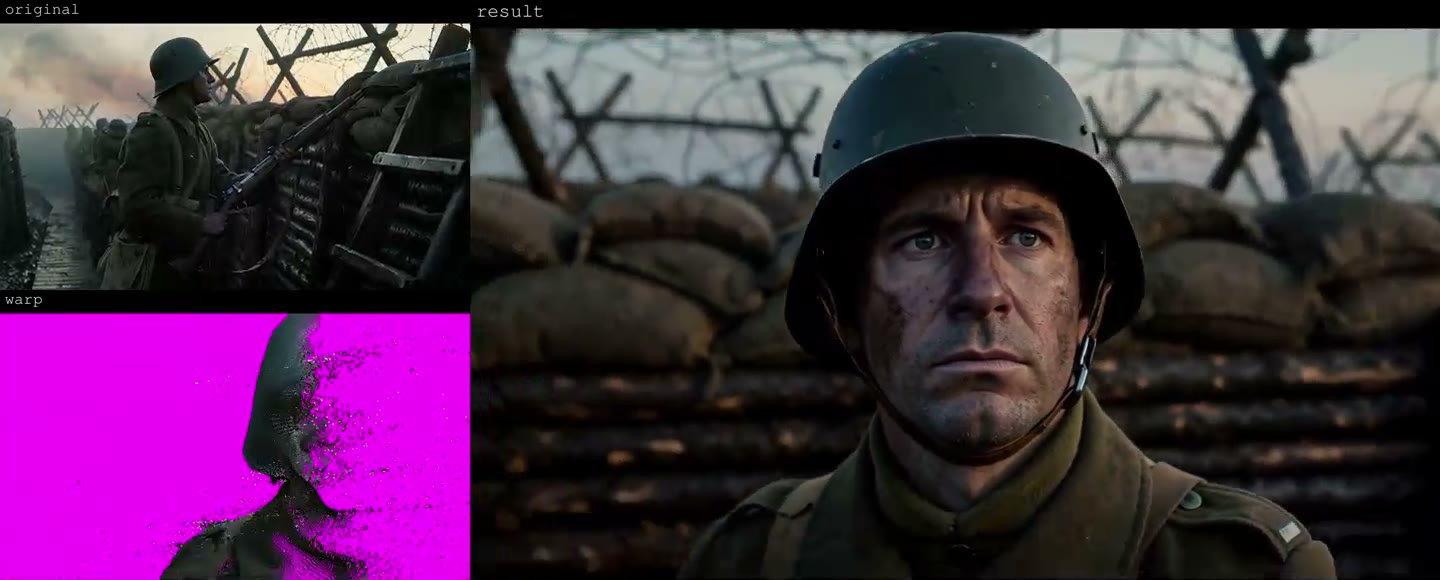
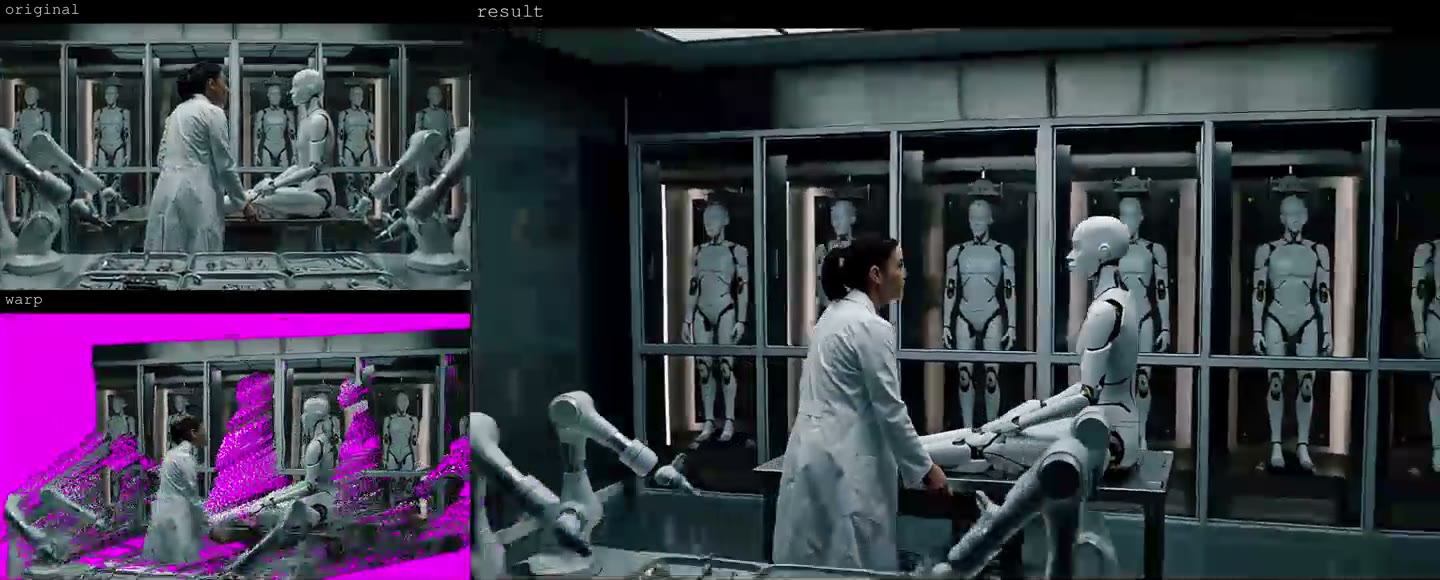
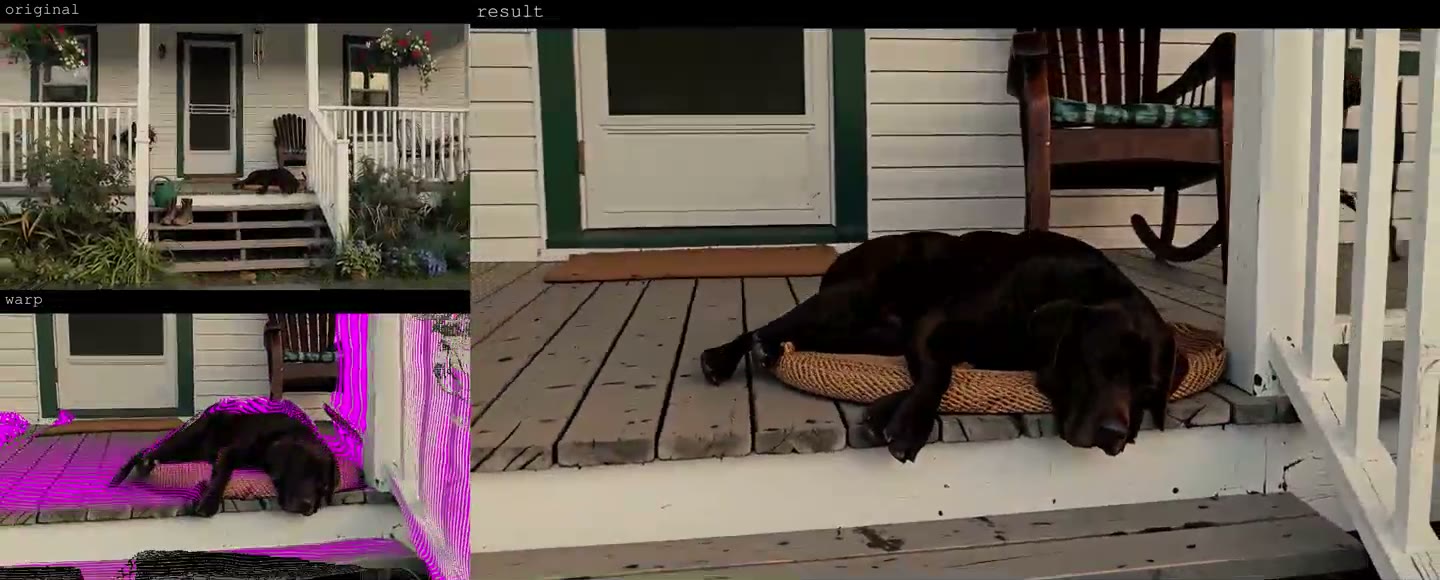
モデルページの各クリップは3パネル比較です。深度ワープ、オリジナル映像、生成結果を並べています。
 |  |
|---|---|
| 2つ目のカメラ移動 | 3つ目のカメラ移動 |
完全な比較クリップはモデルページにあります: 00010、00014。
仕組み
このLoRAは2つの動画を同時に読み取ります。1つ目はクリップの深度ワープで、MoGeジオメトリ推論を実行するCrossViewWarpノードによって生成され、視点の変化を担います。2つ目はクリップ自体で、同一性、ライティング、外観を担います。ワープはフレーム0でモデルのガイドパスに入り、ソースクリップは参照パスに入り、crossviewトリガーワードがアダプターを有効にします。
ジオメトリはテキストプロンプトではなくワープから得られるため、カメラオフセットはノード内で数値として設定され、LTX版と同じコントロールサーフェスを備えています。オリジナルのカメラが捉えなかった領域はノードのプレビューでフラグ付きになり、そこに何を表示すべきかをプロンプトで指定できます。
プロンプトと設定
トリガーワードはcrossviewです。LoRA強度は0.8から1.0の範囲で、4ステップ蒸留パスでは0.8が推奨されます。
| 設定 | 値 |
|---|---|
| トリガーワード | crossview |
| LoRA強度 | 0.8(0.8から1.0) |
| フレーム数 | 124 |
| 第1パス | 0.5 MP、16:9 |
| 第2パス | 1.5 MP、16:9 |
| サンプラー / ステップ数 | res_multistep、DMD 8ステップturbo LoRAで8ステップ |
| シグマシフト | 12 動画 / 3 音声 |
ノードのウォークスルー動画ではカメラ操作を解説しており、上記の設定は公開されているサンプルの生成に使用されたものです。
トレーニングの詳細
| パラメータ | 値 |
|---|---|
| ベースモデル | MiniMax H3、ref2va |
| フレームワーク | musubi-tuner(minimax-h3ブランチ) |
| ストラテジー | aligned_guide_indices = [0]を使用したRef2VA |
| 公開チェックポイント | 6,000ステップ中3,500ステップ |
| LoRAランク / アルファ | 32 / 32 |
| オプティマイザ | adamw8bit、1e-4 |
| ベース精度 | INT8 ConvRot |
| トレーニング解像度 | 512x512、73フレーム |
| スケジュール | 6,000ステップ、バッチ1 |
| 実測 | RTX PRO 6000 Blackwellで20.35秒/ステップ、33時間55分 |
トレーニングセットはLTX v2版で使用されたものと同じ719のBlenderシーンで、カメラオフセットを変えてレンダリングされており、アダプターがワープとそれが示す視点との関係を学習できるようになっています。
入手方法
アダプターは単一のsafetensorsファイルとして公開され、H3 ref2vaチェックポイントにロードされます。リリースノートでは、オリジナルのカメラが捉えなかった領域がノードのプレビューで通知され、そこに何を生成するかを参照画像やプロンプトで誘導できることが指摘されています。
LoRA: Cseti/MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1
ノード: cseti007/ComfyUI-CrossViewWarp
ベースモデル: MiniMaxAI/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。