Zen Image Edit: 0.8BエンコーダーでQwen-Image 2.1をComfyUIで実行
Zen Image EditはQwen3.5-0.8Bのテキストエンコーダーと158MのフュージョンアダプターでQwen-Image 2.1を動作させ、エンコーダーを17.5 GBから1.7 GBに削減します。ComfyUIでの2つの実行ルートを紹介します。
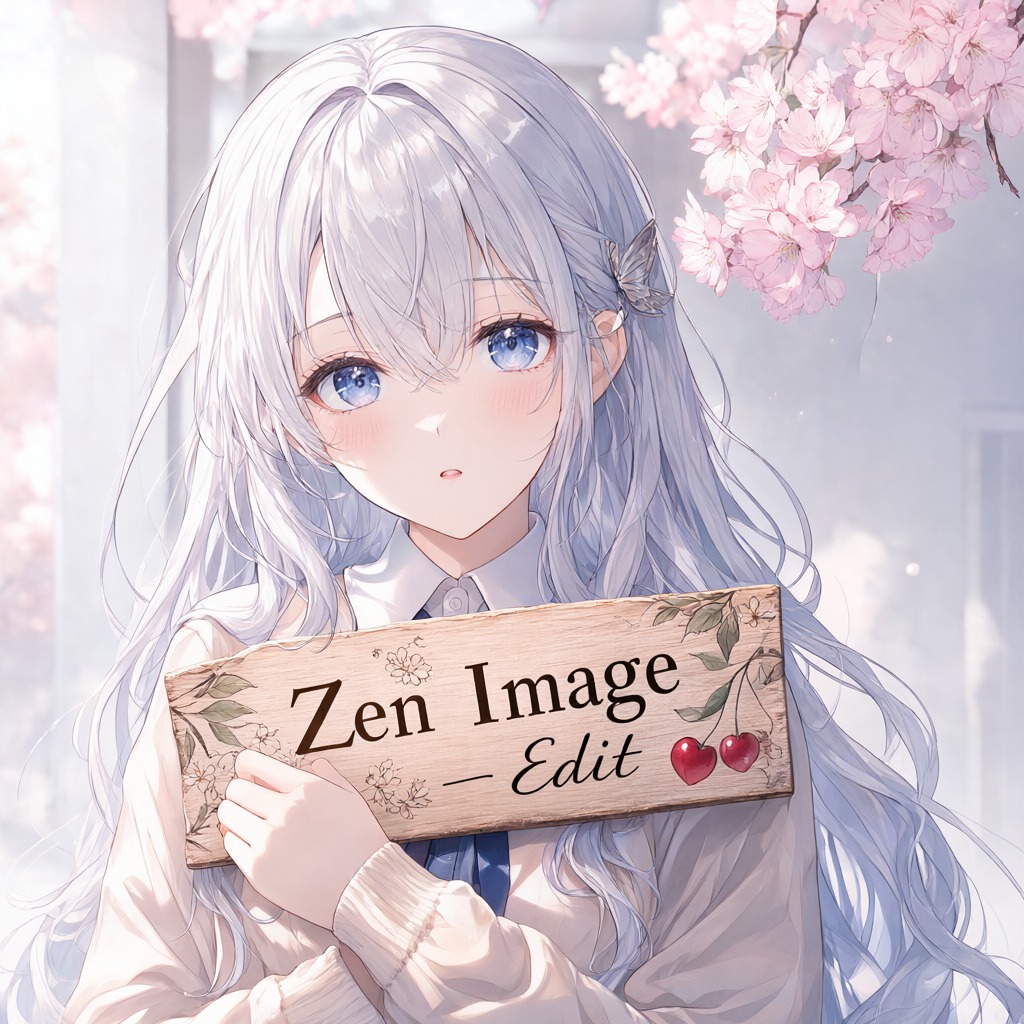
1024 px、30ステップのテキストから画像への生成をパイプラインで実行したもの。ソース: AiArtLab/zen-image-edit。
Zen Image Editが変えるもの
Qwen-Image 2.1の条件付けスタックは、メモリ上に保持するにはコストがかかる構造です。ベースモデルのテキストエンコーダーはfp16で約17.5 GBのQwen3-VL-8Bで、14.5 GBのDiTの隣に置く必要があります。Zen Image Editはこれを小さなマルチモーダルエンコーダーと、大規模なエンコーダーが生成したものを模倣するアダプターに置き換えます。どちらもプレーンテキストから、またテキストを参照画像と一緒に読んだ場合に対応します。
| コンポーネント | Zen Image Edit |
|---|---|
| Transformer | Qwen-Image 2.1 DiT、32レイヤー、14.5 GB fp16、158Mのテキストフュージョンアダプターを統合 |
| テキストエンコーダー | Qwen3.5-0.8B、1.7 GB fp16、トークナイザーとプロセッサーは変更なし |
| 条件付けの忠実度 | ネイティブのQwen3-VL-8Bエンコーダーに対して、テキストでコサイン0.95、編集プロンプトのビジョン位置で0.97 |
| VAE | ファインチューニングされたQwen-Image 2.1デコーダー、16倍空間、fp32 |
| スケジューラー | FlowMatchEulerDiscreteScheduler、単純な静的シフト5.0 |
| ピークVRAM | 常駐で約17.5 GB、enable_model_cpu_offload()の使用時はさらに少ない |
アダプターはDiT内部にテキストフュージョンブロックとして存在するため、モデル全体が1つの自己完結したDiffusersフォルダーとなり、どこにも別途17.5 GBのエンコーダーは必要ありません。サンプラーはベースモデルの動的シフトではなく、単純な静的シフト5.0で動作します。
同梱のアダプターはリビジョンv12です。そのアテンションブランチの位置テーブルは2,304スロットをカバーし、実際の1024 pxの編集ジオメトリでファインチューニングされているため、長い参照シーケンスもゼロパディングされた末尾に落ちずに位置を保ちます。これによりネイティブエンコーダーに対するビジョンのコサインが0.93から0.97に向上し、テキストは0.95のままです。
ファインチューニングされたVAE
同梱のデコーダーは純正のQwen-Image 2.1のものではありません。madebyollin/texture-fix-vae-for-qwen-image-2.1をベースにしたデコーダーのみのファインチューニングで、nearest-exactアップサンプリングが出力ストライドに固定してしまう2 pxの格子を除去するよう学習されています。学習されたのはデコーダーのみで、5,300ステップ以上にわたり、損失項が1つ追加されています。再構成とターゲットの2x2サブラティス平均間のピークツーピーク差です。忠実に再現されたコンテンツはこの項に何も寄与しないため、付加された格子のみがペナルティを受けます。エンコーダーはオリジナルとビット単位で同一であり、潜在空間は変化しません。
| デコーダー | PSNR | LPIPS | 格子 (/255) |
|---|---|---|---|
| オリジナル Qwen-Image 2.1 | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| このVAE | 33.397 | 0.05291 | 0.000 |
512 pxのホールドアウト画像32枚での再構成。モデルカードは、格子は100%ズームでは見えないため、目視ではなく測定していると注記しています。
作例
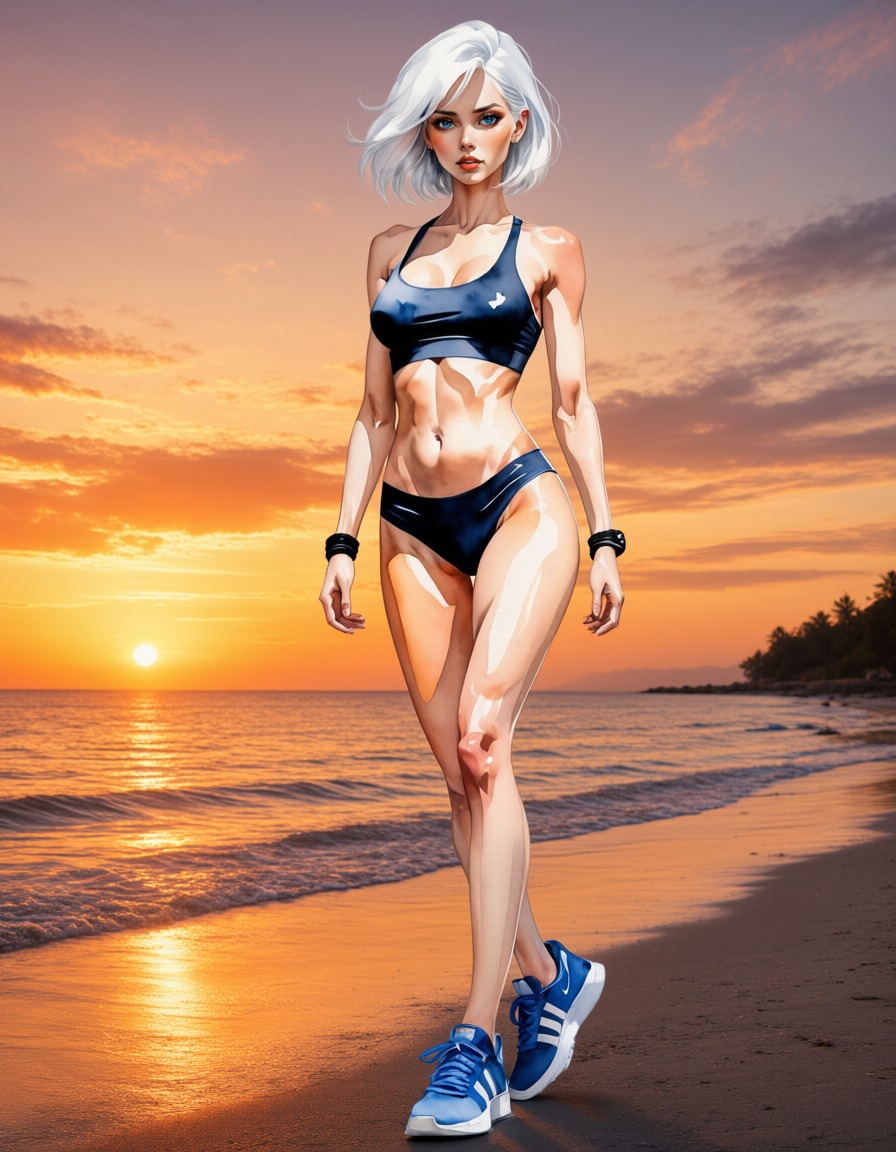
条件画像1枚での編集: 背景が変わり、被写体は維持されます。
 |  |
|---|---|
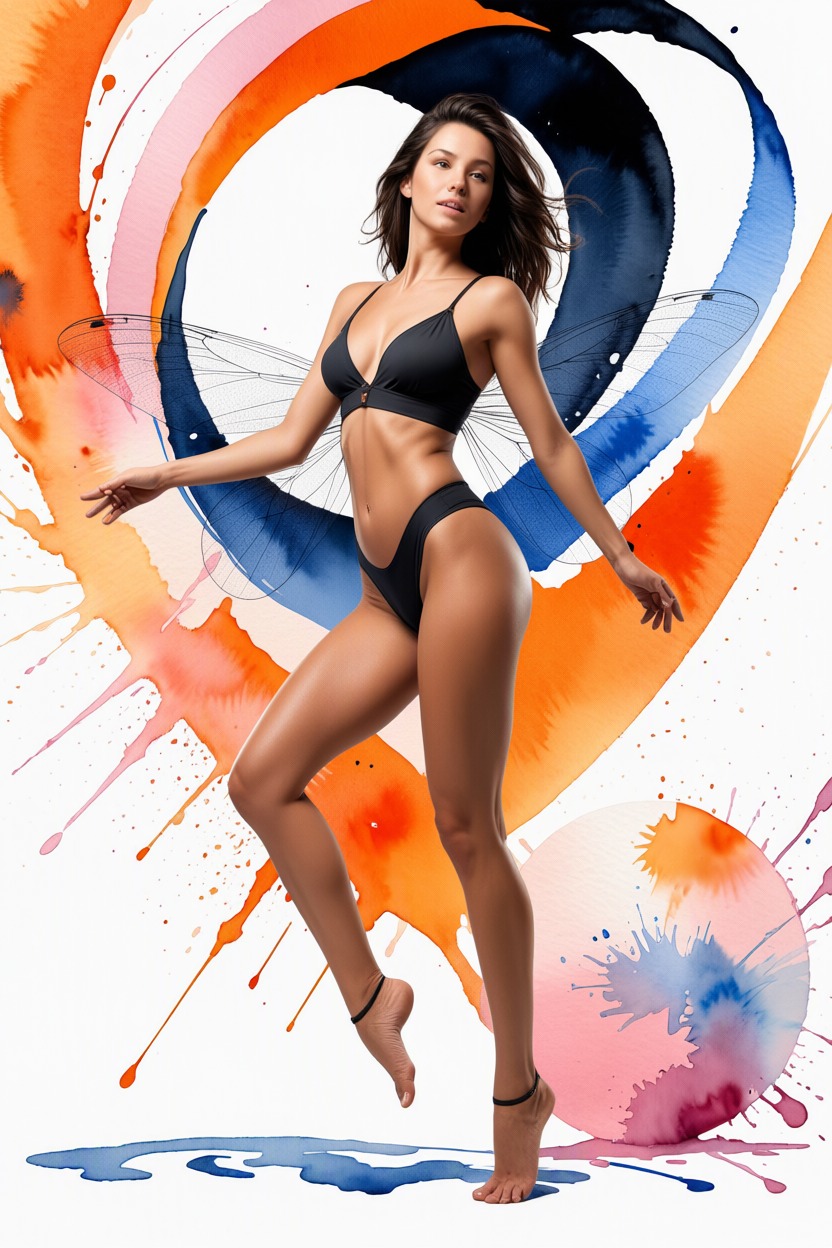
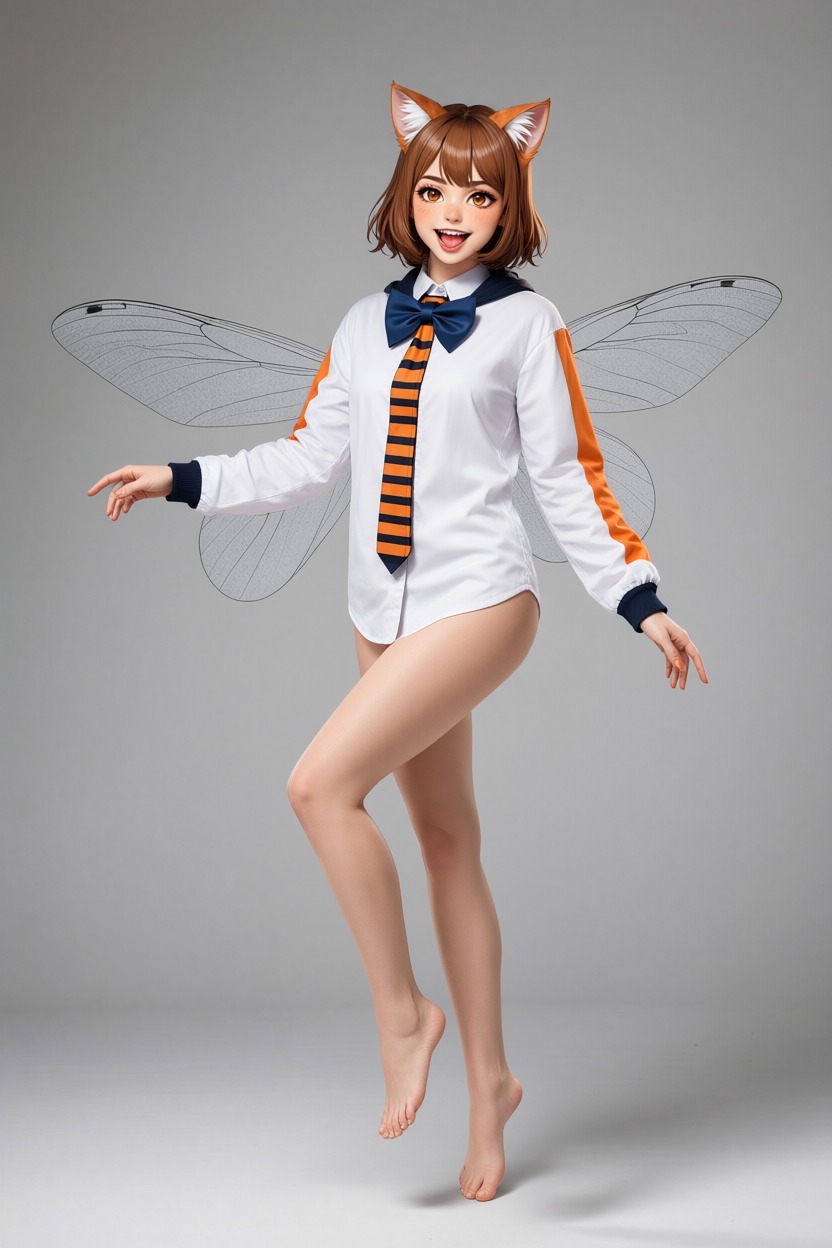
条件画像2枚: <image1> はポーズ、服装、シーンを維持 | 同一性は <image2> からコピーしました |
編集はベースモデルの慣例に従います。最初の画像が編集対象(<image1>)で、それ以降はすべて参照です。モデルカードは、参照を先に渡すことがスワップが「起こらない」通常の原因だと指摘しています。その場合モデルは参照の方を編集してしまうからです。
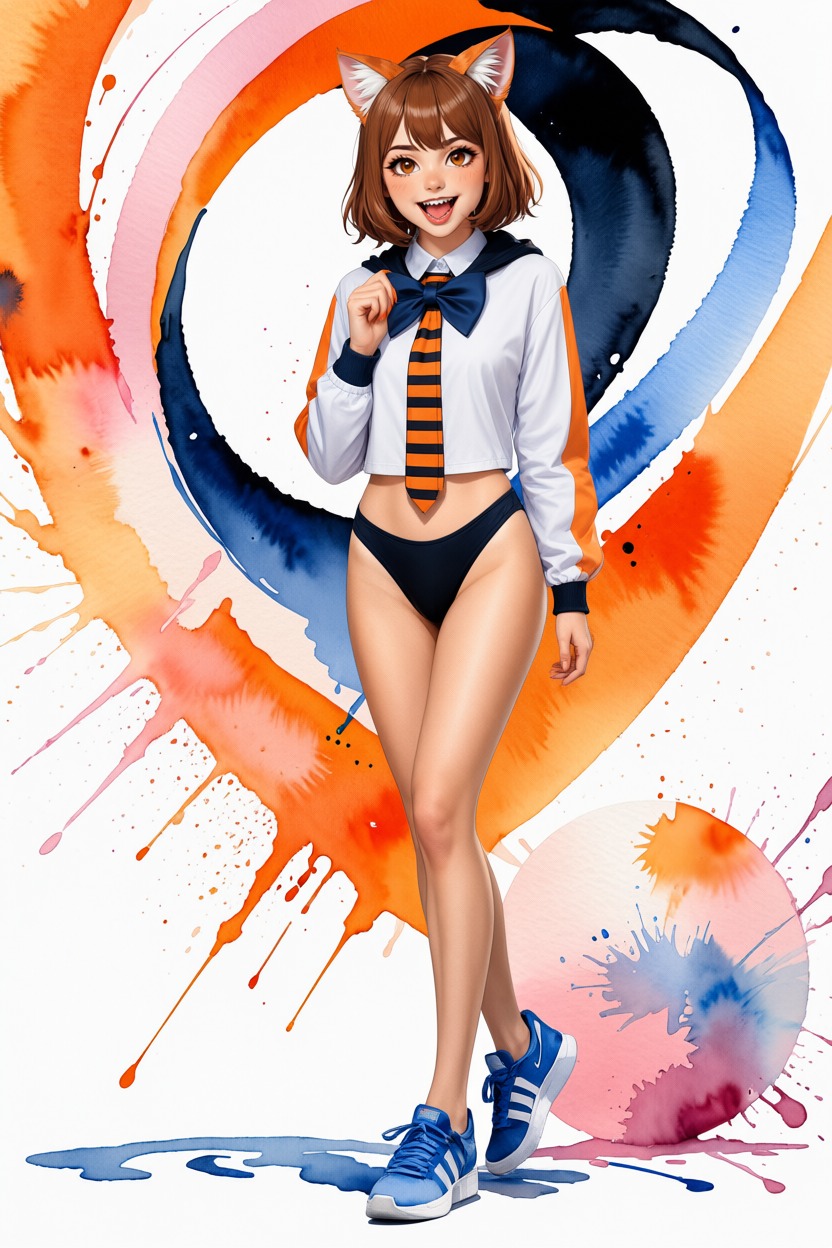
条件画像3枚: ターゲットと構図は <image1> から、人物は <image2> から、色とライティングは <image3> から。
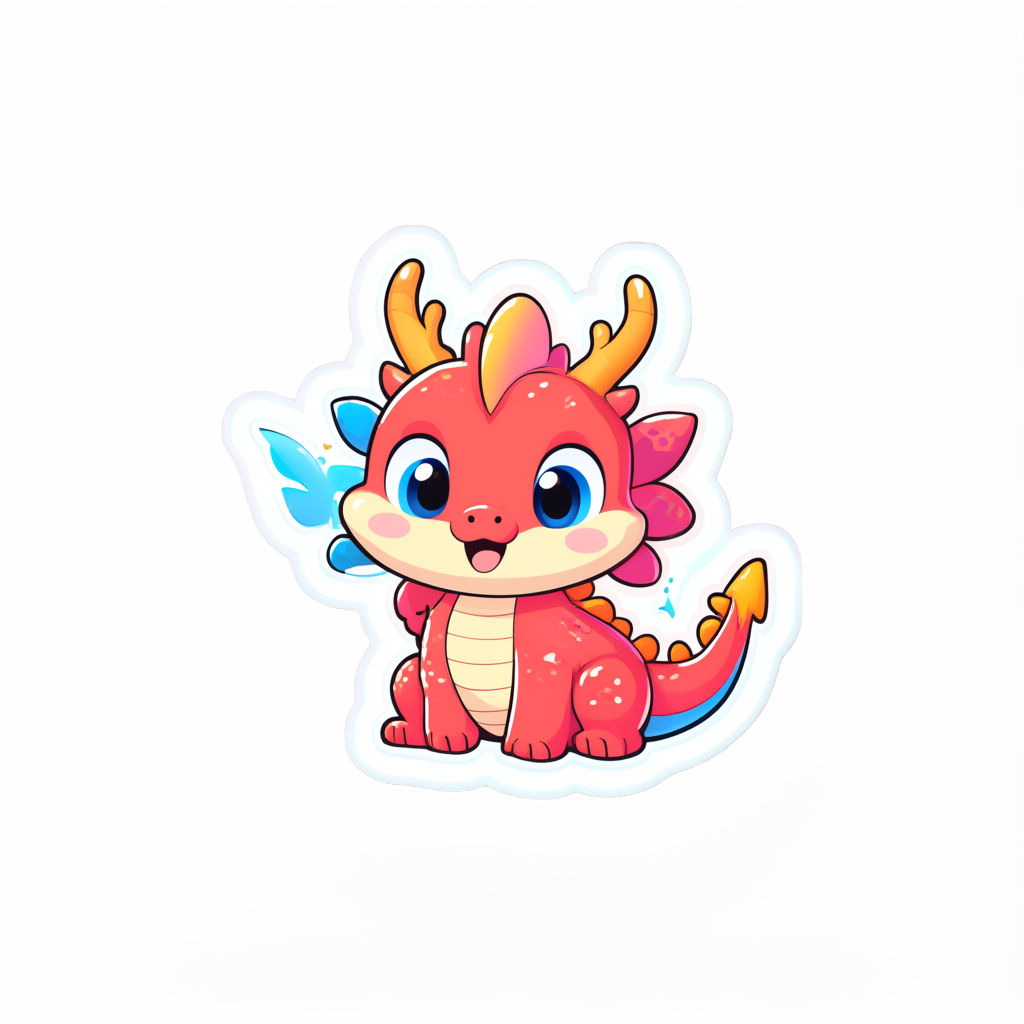
透過(RGBA)生成も同じパイプラインで実行できます。
ComfyUIでの実行
独立したComfyUIルートが2つあり、どちらも17.5 GBのエンコーダーを必要としません。
ノードパック: recoilme/zen-image-edit-comfyui。 DiT、VAE、サンプラー、プレフィックスKVキャッシュは標準のComfyUIのまま(Qwen-Image 2.1サポートを含むビルドが必要)で、ノードが提供するのは小さなエンコーダーとアダプターのみです:
adapter_v12.safetensors(0.64 GB)をComfyUI/models/にダウンロードします。qwen_image_2.1_bf16.safetensorsをmodels/diffusion_models/に、qwen_image_2.1_vae_bf16.safetensorsをmodels/vae/に配置します。どちらも Comfy-Org/Qwen-Image-2.1 から入手します。- テキストエンコーダーを取得します:
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b。 - ComfyUIを再起動します。
transformers >= 5.17が必要です。
作者によると、同じフォルダーのDiffusersビルドに対してコサイン1.0000で、両方のサンプルグラフがエンドツーエンドで検証済みです。
単一ファイルチェックポイント: T8mars/comfyui-Zen-Image-Edit-T8。 ComfyUI Managerからインストール可能なこのルートは、DiT、VAE、Zenエンコーダー、フュージョンアダプター、トークナイザーのアセットを1つの zen_image_edit_qwen21_single.safetensors チェックポイントにまとめ、t8star/Zen-Image-Edit-Comfy として公開しています。そのローダーは MODEL、CLIP、VAE を返すため個別のダウンロードは不要で、CLIP専用ローダーはネイティブのdiffusionおよびVAEローダーと併用できます。変換はComfyUI 0.37.0と24 GBのRTX 5090 Laptopで、テキストから画像へのグラフと画像編集グラフの両方で検証されました。同じリポジトリではViggle turboアダプターも、ComfyUI内蔵ノードで読み込めるLoRAとしてワークフロー付きで再公開しています。
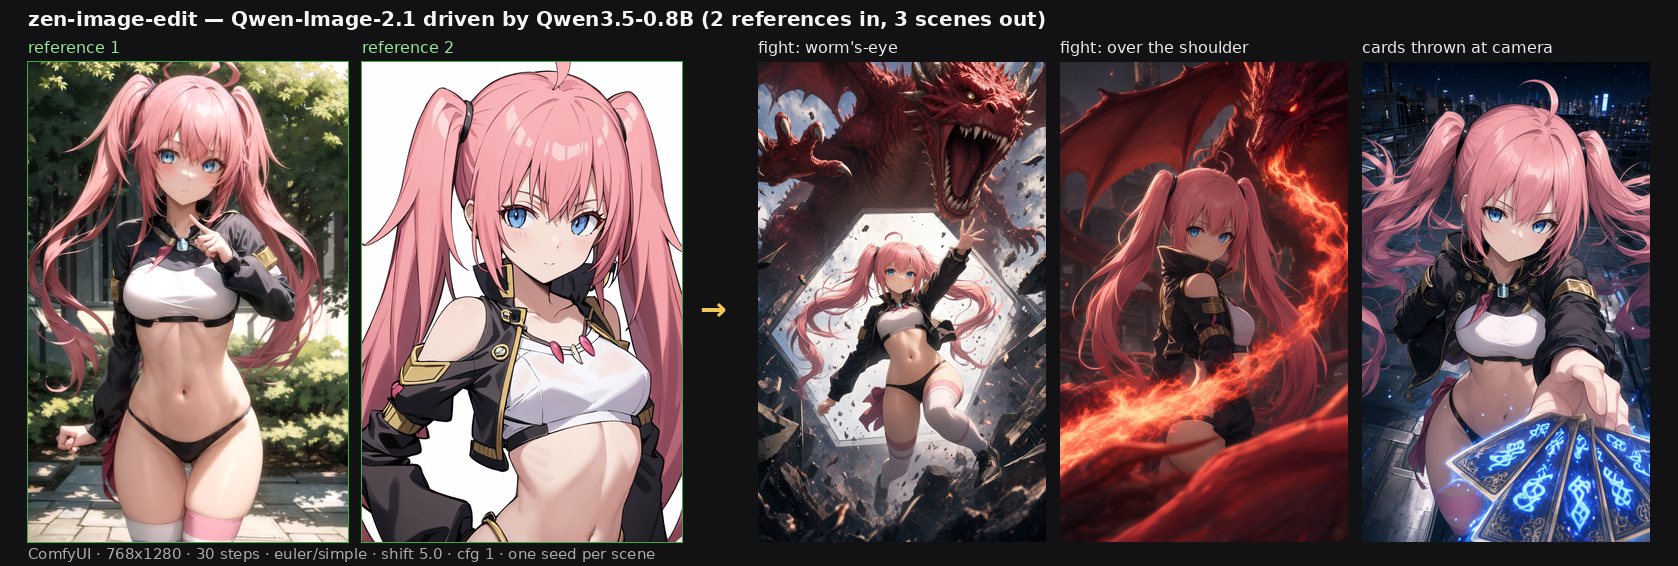
キャラクター参照を2枚入力し、3つのシーンを出力。ComfyUIノードで768x1280。ソース: recoilme/zen-image-edit-comfyui。
文書化されている制限
モデルカードは、見つけられる前に欠点を列挙しています:
- 英語のみ。 アダプターが学習およびテストされたのは英語のみで、他の言語ではドリフトします。
- 看板上の数字。 「OPEN 24 HOURS」は、試したすべてのシードで「OPEN 26 HOURS」と表示されます。単語は問題ありません。
- 写真以外の参照は写真のものよりも忠実に転送されません。アダプターはネイティブエンコーダーを模倣しており、その上限を継承しているためです。
- 1024 pxでバッチサイズが1を超えるとピークは約28 GBに達するため、1回の呼び出しにつき1プロンプトが安全なモードです。
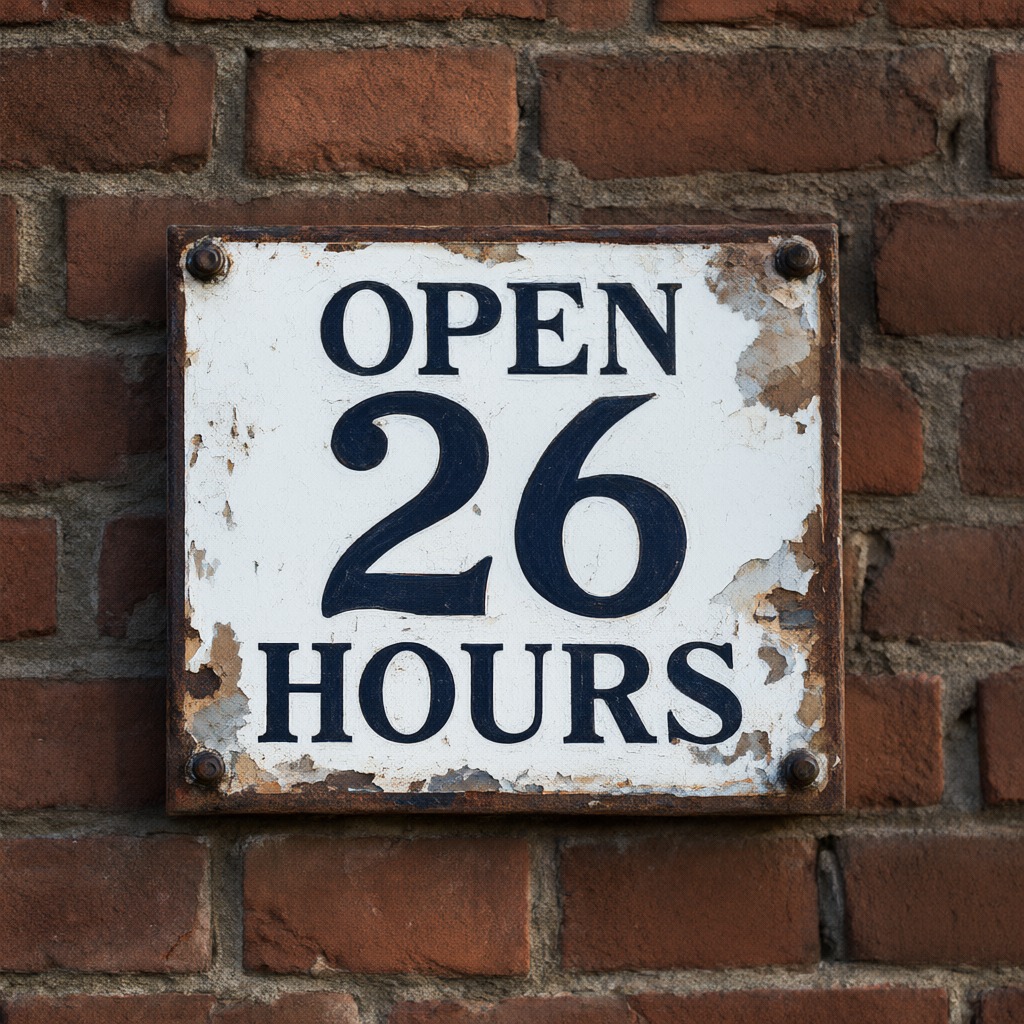
単語は正しく描画されますが、看板上の数字はそうなりません。ソース: AiArtLab/zen-image-edit。
入手方法
重みは AiArtLab/zen-image-edit として公開されています。16 GBのカード向けには recoilme/zen-image-edit-gguf にGGUF Q5_Kビルドがあり、実行中にtransformerを13.55 GiBから4.52 GiBへ削減します。Diffusersパイプラインの実行には、Qwen-Image-2.1サポート付きでビルドされた diffusers と trust_remote_code=True が必要です。
コメント
GitHubでサインインしてディスカッションに参加しましょう。