Fisher Pose: Qwen-Image 2.1向けポーズ・カメラエディター
Fisher Poseは、3Dマネキン、209種類のOpenPoseスケルトン、対応するLoRAを使って、Qwen-Image 2.1でキャラクターを新しいポーズやカメラアングルで描き直すComfyUIノードです。
Qwen-Image 2.1は指示ベースの編集はすでに得意としていますが、ポーズ指定はプロンプトのみの編集がもっとも扱いにくい部分です。特定の手足の角度をテキストで指定したり、カメラを左に40度振るよう指示したりしても、元のポーズのままだったり、ぎこちない近似結果になったりしがちです。Fisher Pose は代わりに、ポーズLoRAの学習に使われたものと同じマネキンで描いたポーズの画像をモデルに渡します。
このノードパックは2026年9月24日に公開され、追加のPython依存関係なしでインストールできます。
2つのモード
| モード | ノード | 内容 |
|---|---|---|
| フリーポーズ | Fisher Qwen2.1 自由姿势 | 任意の単一キャラクターのポーズ: 人間のプロポーションを持つ3DマネキンとVNCCS PoseStudio LoRAが、参照画像の人物を新しいポーズに描き直します |
| フリーカメラ | Fisher Qwen2.1 人物与姿态编码 | 1〜3人のキャラクターのカメラと配置: カメラを周回させ、中国語の編集指示で位置とアクションを変更でき、プロンプトの書き換えはオプション |
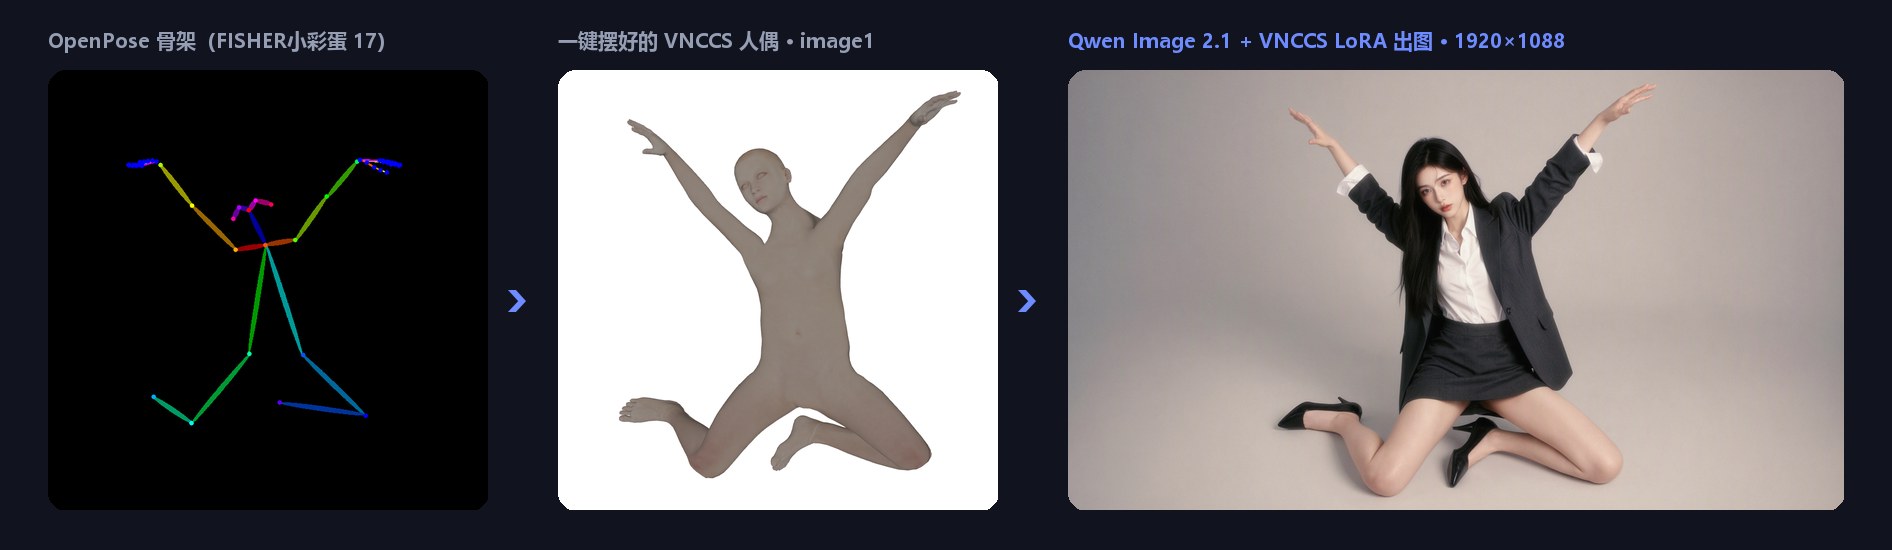
フリーポーズのパイプライン: スケルトン、マネキン、生成結果。
フリーポーズ: LoRAがすでに知っているマネキン
フリーポーズモードは、VNCCS Pose Studio の MakeHuman マネキンをベースにしています。これは VNCCS PoseStudio QI2.1 LoRA の学習に使われたものと同じボディです。マネキンは image1、参照キャラクターは image2 として入力し、プロンプトは Draw character from image2 に固定します。これによりLoRAは一方の画像からポーズを、もう一方から人物の同一性と服装を読み取ります。
このコアに加えて、パックには編集を便利にする機能が揃っています:
- ワンクリックのOpenPoseポージング。 色付きのスケルトン画像をクリックすると、マネキンがそのポーズを取ります。2Dスケルトンには奥行き情報がないため、パックは各ボーンが見かけ上どれだけ短くなるかから深度を推定します。推定が外れた場合は、胴体と各手足のセグメントをワンクリックで前後反転できます。
- 209種類の内蔵スケルトン。 立ち、座り、膝立ち、しゃがみ、横たわり、開脚、吊り下げのポーズが同梱され、クリック可能なライブラリに分類されています。
- My libraryとMy poses。 追加したスケルトン画像はセッションをまたいで記憶され、ポーズを付けたマネキンは体型、プロポーション、キャンバス上の位置、ハンドジェスチャーとともに保存できます。各ポーズは
ComfyUI/user/default/fisher_pose/poses/配下の単一のJSONファイルなので、そのまま他の人に渡せます。 - 手とプロポーションのコントロール。 開いた手、閉じた手、グーのハンドプリセットと握り具合スライダーに加え、頭の大きさ、首、肩幅、胴体、上腕、前腕、太もも、ふくらはぎの部位別スライダー。ポーズを維持したままプロポーションを変更できます。
- キャンバスと出力サイズの分離。 マネキン画像のサイズはエディターで設定し、出力はノード自身の
widthとheightが決めるため、解像度ノードで制御できます。 - 適用とプレビュー。 「apply to node」を押すと、テスト実行なしでマネキンがすぐにノード上に表示されます。
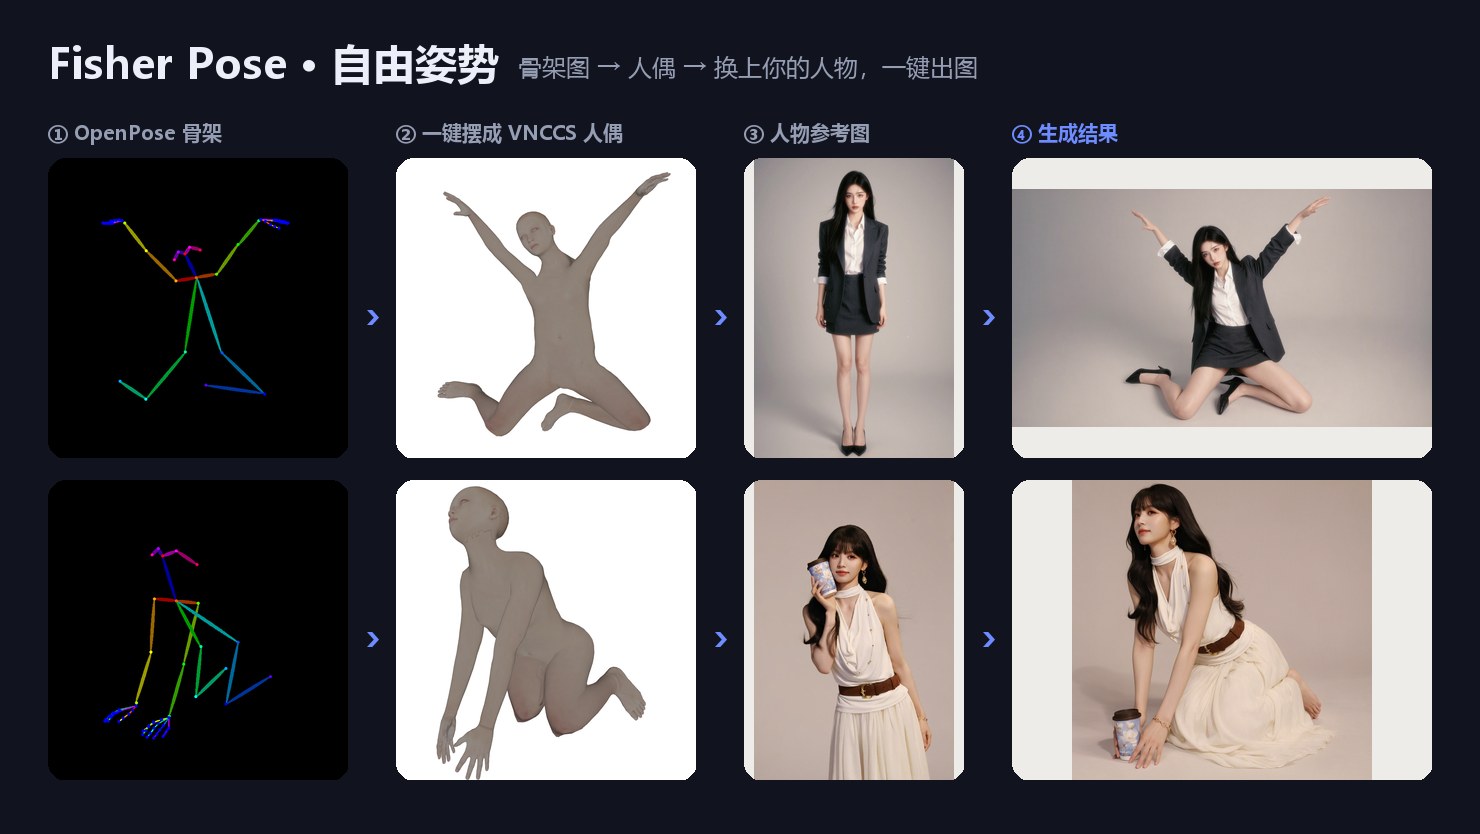
結果例。キャラクター画像が image2、マネキンが image1 で、プロンプトは Draw character from image2 に固定されています。
フリーポーズエディター
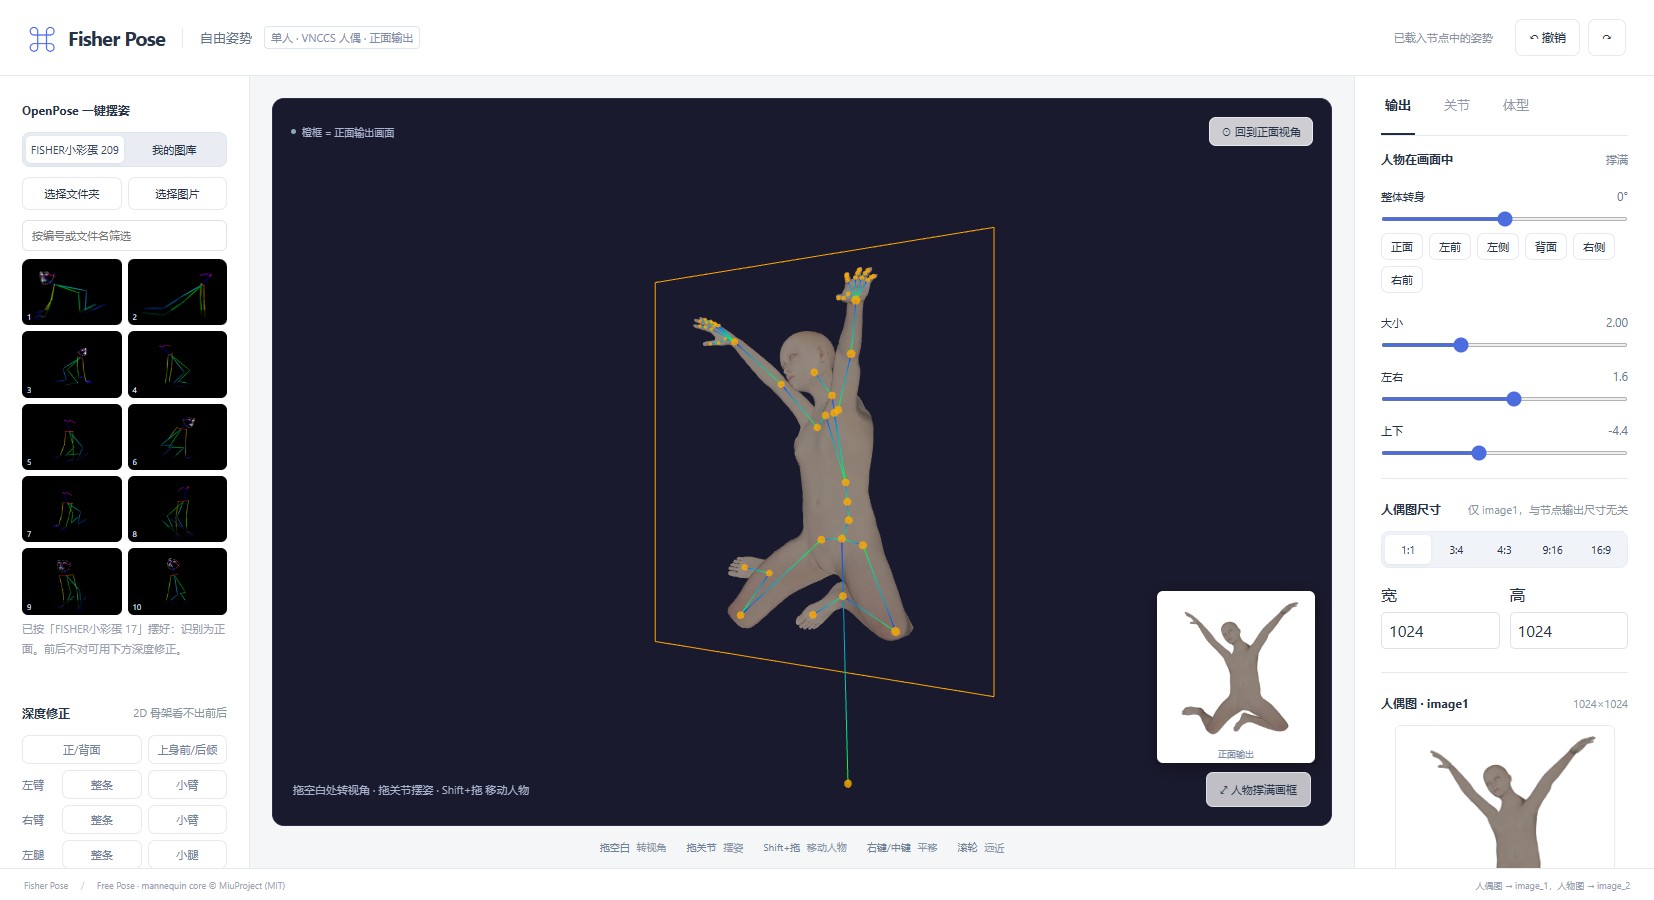
エディターは3Dビューポートで、出力フレームがオレンジの枠で示され、隅には実際の正面レンダリングの小さなライブビューが表示されます。何もない場所をドラッグするとカメラが周回し、関節をドラッグするとマネキンがポーズを取ります(手、足、腰にはインバースキネマティクスが適用されます)。Shiftを押しながらドラッグするとキャラクターが移動します。左パネルにはスケルトンライブラリ、保存済みポーズ、深度補正、ハンドプリセットが並び、右パネルにはキャンバス上のサイズと位置、マネキン画像のサイズ、関節の微調整、体型、プロポーションがあります。
フリーカメラモードは出力に正面を向いたVNCCSカメラを使用し、Qwen-Image 2.1の prompt_rewrite 仕様に従った中国語の編集指示を受け付けます。プロンプト拡張フックはオプションです。
はじめに
リポジトリを ComfyUI/custom_nodes/ にクローンしてインストールし、ComfyUIを再起動してブラウザーを更新します。このパックには追加のPython依存関係はなく、ノードメニューで Fisher を検索するとノードが表示されます。
フリーポーズには以下のファイルが必要です:
| ファイル | フォルダー | 備考 |
|---|---|---|
qwen_image_2.1_*.safetensors | models/diffusion_models | Qwen-Image 2.1 ベースモデル |
qwen3vl_8b_*.safetensors | models/text_encoders | タイプを qwen_image に設定 |
qwen_image_2.1_vae_*.safetensors | models/vae | |
VNCCS_QI2_PoseStudioV1.1.safetensors | models/loras | 必須、strength 1、MIUProject/VNCCS_PoseStudio_QI2.1 から |
また、ComfyUIは TextEncodeQwenImage21 ノードを含む十分に新しいバージョンである必要があります。
同梱のワークフローがすべての手順を案内します: ワークフローを読み込み、人物图 → image2 ノードでキャラクター写真を選び、フリーポーズエディターを開き、スケルトンをクリックするか手動でマネキンにポーズを付け、必要なら深度を補正し、ノードに適用して、出力サイズを設定して実行します。作者推奨の設定はVNCCS公式の値と同じです: 25 steps、cfg 1、euler / simple。extra_prompt フィールドは固定の指示の後に追加の1行を付け加えるもので、英語の使用が推奨されています。
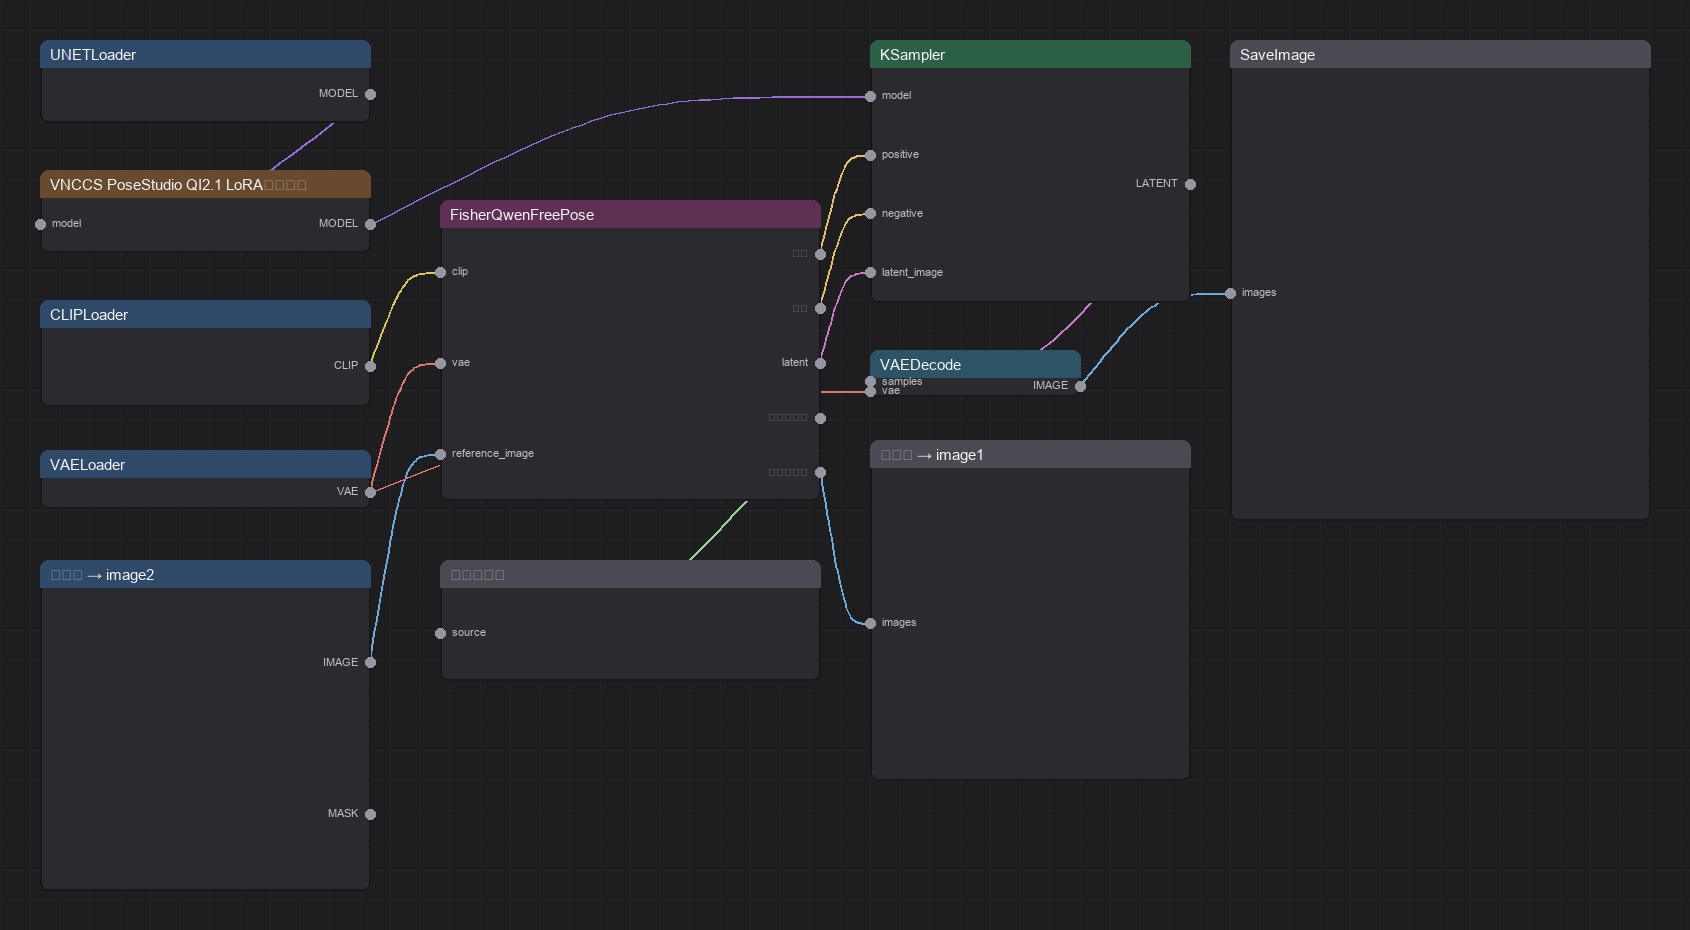
同梱のフリーポーズワークフロー: ベースモデルとVNCCS LoRAを Fisher Qwen2.1 自由姿势 ノードに入力し、続いて KSampler、VAEDecode、SaveImage。マネキン画像と最終プロンプトが並んでプレビューされます。
既知の制限
- フリーポーズは単一キャラクターのみです。OpenPose画像に複数の人物が含まれる場合、最も大きい人物だけが使用されます。
- 2Dスケルトンでは前後を一意に決定できないため、複雑なポーズでは手動での反転や微調整が必要です。頭の向き、指、足はスケルトンから一切読み取られません。
- マネキンが提供するのはポーズのみです。出力のプロポーションがマネキンと大きく異なる場合、キャラクターがフレーム内のどこに収まるかはモデルに委ねられます。
入手方法
ノードパック: Work-Fisher/ComfyUI-Fisher-Pose
必須LoRA: MIUProject/VNCCS_PoseStudio_QI2.1
マネキンとエディターのコア: AHEKOT/ComfyUI_VNCCS_Utils
ベースモデル: Qwen/Qwen-Image-2.1
カメラ語彙のリファレンス: jtydhr88/ComfyUI-qwenmultiangle
コメント
GitHubでサインインしてディスカッションに参加しましょう。