Texture-Fix-VAE: Qwen-Image 2.1向けのよりクリーンなVAEデコーダー
madebyollin氏のTexture-Fix-VAEは、Qwen-Image 2.1のVAEデコーダーを再トレーニングし、チェッカーボード状のテクスチャアーティファクトを除去します。ファイルをComfyUI/models/vaeに配置し、通常どおり読み込むだけです。
ComfyUI/models/vae/ にコピーし、Load VAE ノードで選択するだけです。
Qwen-Image 2.1 は圧縮された潜在空間でデノイズを行い、VAEデコーダー はその潜在をピクセルに戻す最後のステップです。デコーダーがクリーンに再構成できない部分は、サンプリングがどれほど優れていても、完成した画像にそのまま焼き込まれてしまいます。ユーザーはリリース当初からこの症状を報告していました。かすかな2ピクセルのグリッドと、葉や髪、布地など情報量の多い領域でわずかにディザのかかった見た目です。
Texture-Fix-VAEは、まさにこのステップに特化して対処します。エンコーダーは手を加えていないため、潜在形式、サンプリングスケジュール、そしてすべてのLoRAや量子化チェックポイントは変わらず動作し続けます。
前後比較
作者は以下の比較用の潜在を、細かいテクスチャを多く含む写真風のプロンプトから Qwen-Image 2.1 で生成しました:
真夏の太平洋岸北西部の亜高山帯お花畑の風景写真: 苔むした岩の上を縫うように流れる澄んだ山の小川、その周囲にパープルのルピナスと赤いペイントブラシ、背後には密生した原生のダグラスファーとアメリカネズコの森、遠くには雪を頂いた火山、黄金色の午後の遅い光、非常に精細
どちらの列も 同じ潜在 をデコードしているため、違いはデコーダーのみによるものです。
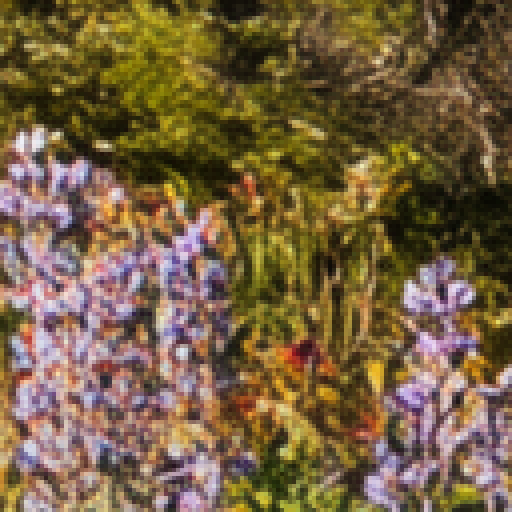 | 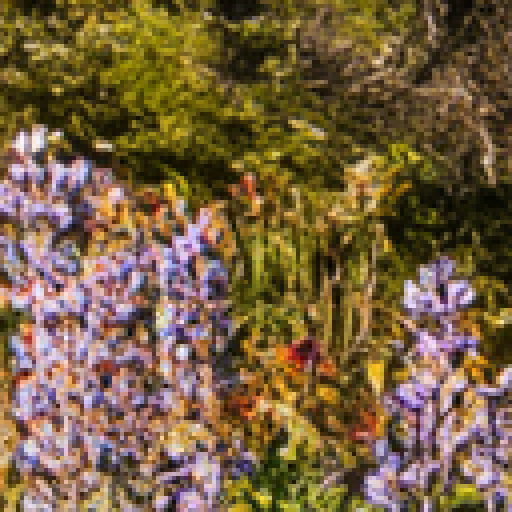 |
|---|---|
| 標準VAE、拡大クロップ | Texture-Fix-VAE、同じクロップ |
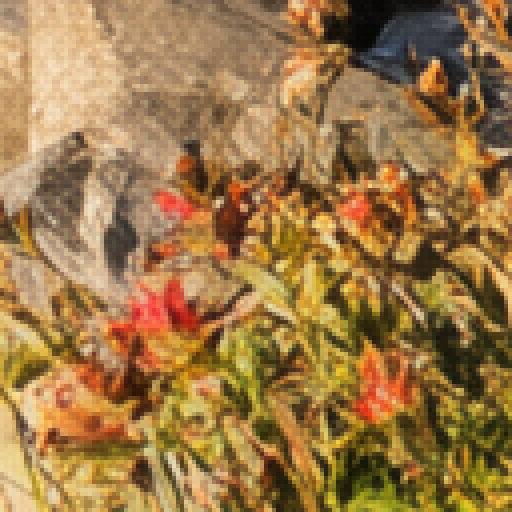 | 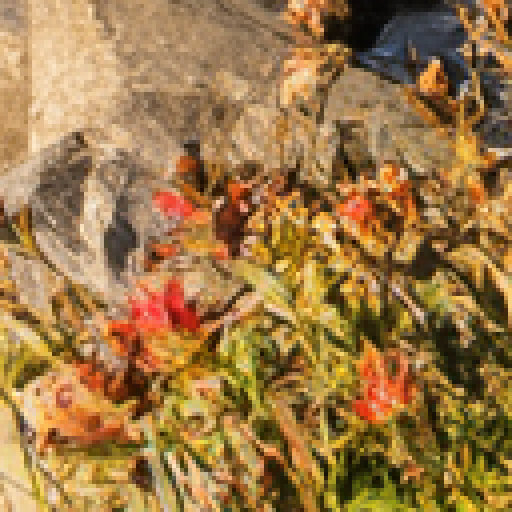 |
|---|---|
| 標準VAE、2つ目の拡大クロップ | Texture-Fix-VAE、同じクロップ |
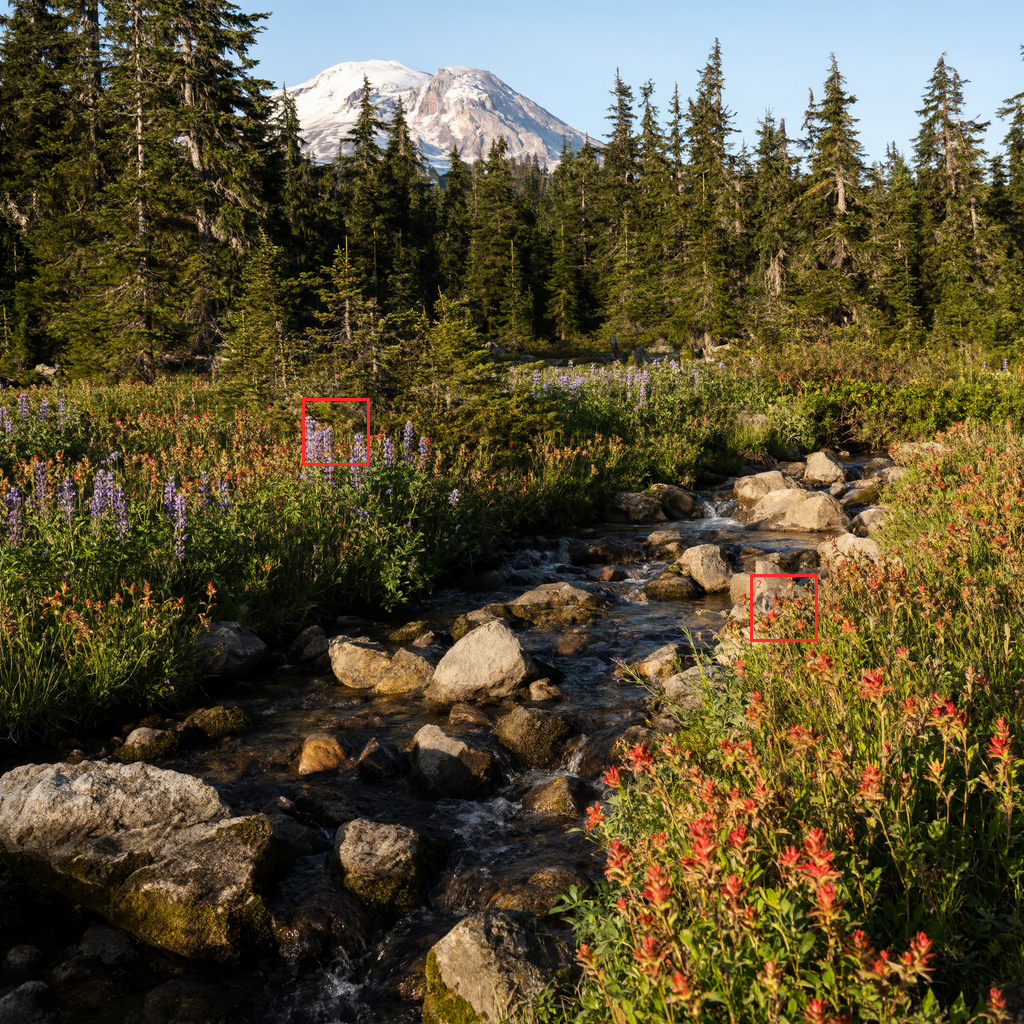 | 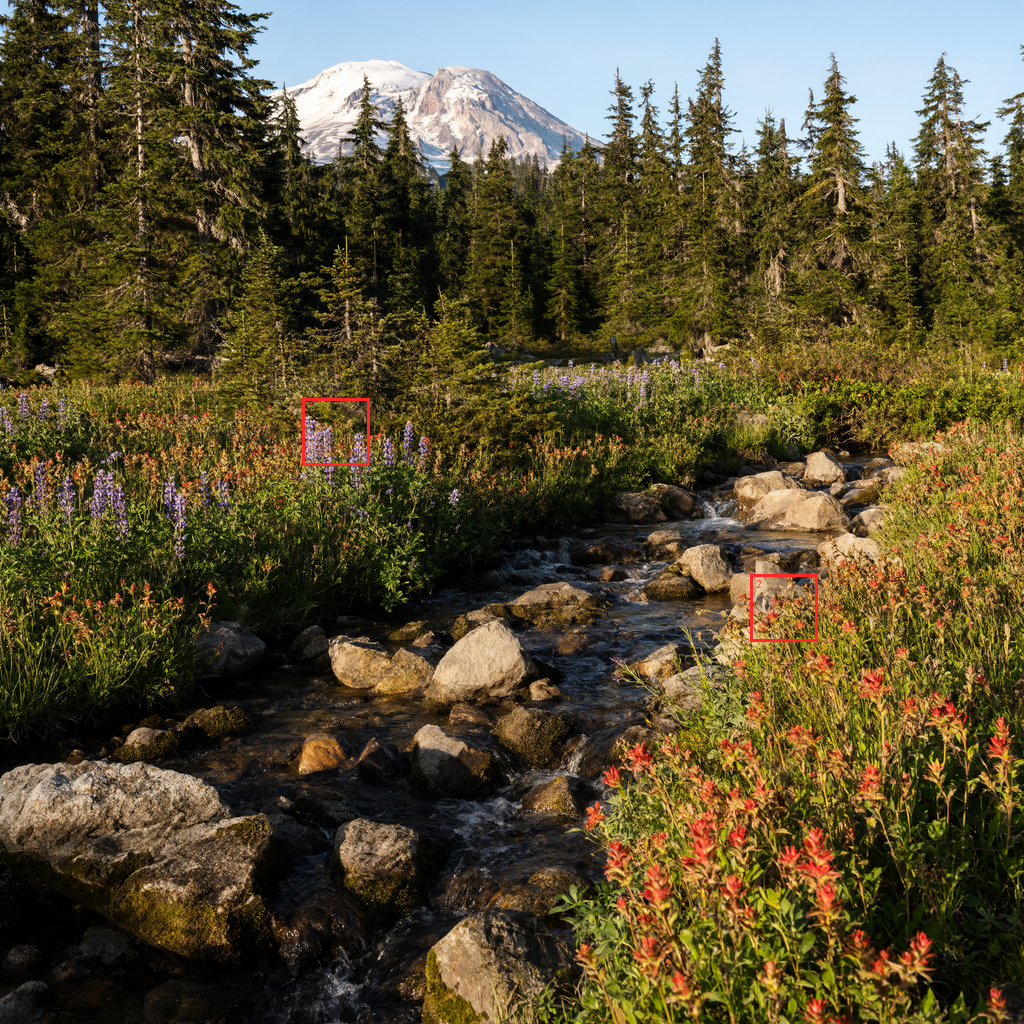 |
|---|---|
| 標準VAE、1024 x 1024のフルデコード | Texture-Fix-VAE、フルデコード |
内部で変わった点
ファインチューニングされたのはデコーダーのみで、およそ 5,000ステップ、学習率3e-5 で行われました。最も解像度の高い2つのデコーダーステージと出力ヘッドは凍結されずに残され、これは約 7.5Mのトレーニング可能パラメータ に相当します。トレーニングには、作者が TAESD のために開発したレシピが使用されました。
このレシピは3つの損失ファミリーを組み合わせており、それぞれが再構成を異なる方向へと導きます:
| 損失 | 報いるもの |
|---|---|
| MSE / MAE (PSNR重視) | 安全な平均化。配置できない細部をぼかしてしまう |
| LPIPS | 知覚的なもっともらしさ。細かいテクスチャではぼかしとチェッカーボード化として現れる |
| 敵対的 (GAN) | 明らかに合成的ではなく本物に見える、シャープでもっともらしい細部 |
ここで違いを生むのは敵対的項です。作者の見解では、元のQwen-Image 2.1 VAEは 機能する敵対的損失項なしで トレーニングされており、それがグリッドの原因だと考えられます。明らかに偽物な構造を罰するものが何もなかったため、知覚的項がチェッカーボード化へと自由に押し進めることができたのです。
指標
| 指標 | Qwen-Image 2.1 VAE | Texture-Fix-VAE |
|---|---|---|
| rFID、低いほど良い (COCO val2017、256²で5000枚) | 3.37 | 2.08 |
| PSNR、高いほど良い (COCO val2017、256²) | 33.30 | 32.86 |
| LPIPS、低いほど良い (COCO val2017、256²) | 0.0357 | 0.0373 |
| PSNR、高いほど良い (DIV2K valid、ネイティブ1024²クロップ) | 32.86 | 32.46 |
| LPIPS、低いほど良い (DIV2K valid、ネイティブ1024²クロップ) | 0.0460 | 0.0480 |
これはGANスタイルのデコーダーでよくあるトレードオフです。知覚品質 (rFID) は約3分の1改善する一方で、再構成精度 (PSNRとLPIPS) はごくわずかに低下します。作者は、この改善は平坦なイラストよりも、細部の多い写真風の画像で最も顕著に現れると述べています。
ComfyUIでの使用方法
texture_fix_vae_for_qwen_image_2.1_bf16.safetensors を ComfyUI/models/vae/ にダウンロードし、Load VAE ノードで qwen_image_2.1_vae_bf16.safetensors の代わりに選択します。ノード、ワークフロー、サンプラーを変更する必要はなく、いつでも元のファイルに戻すことができます。
ComfyUI以外では、同じ重みを通常のdiffusers VAEとして読み込めます:
import torch
from diffusers import QwenImage21Pipeline, AutoencoderKLQwenImage21

vae = AutoencoderKLQwenImage21.from_pretrained(
    "madebyollin/texture-fix-vae-for-qwen-image-2.1", torch_dtype=torch.bfloat16
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", vae=vae, torch_dtype=torch.bfloat16
).to("cuda")
入手方法
重み: madebyollin/texture-fix-vae-for-qwen-image-2.1
ComfyUIファイル: texture_fix_vae_for_qwen_image_2.1_bf16.safetensors
ベースモデル: Qwen/Qwen-Image-2.1
作者の以前の作品: TAESD, sdxl-vae-fp16-fix
コメント
GitHubでサインインしてディスカッションに参加しましょう。