 テキスト→動画
LoRA
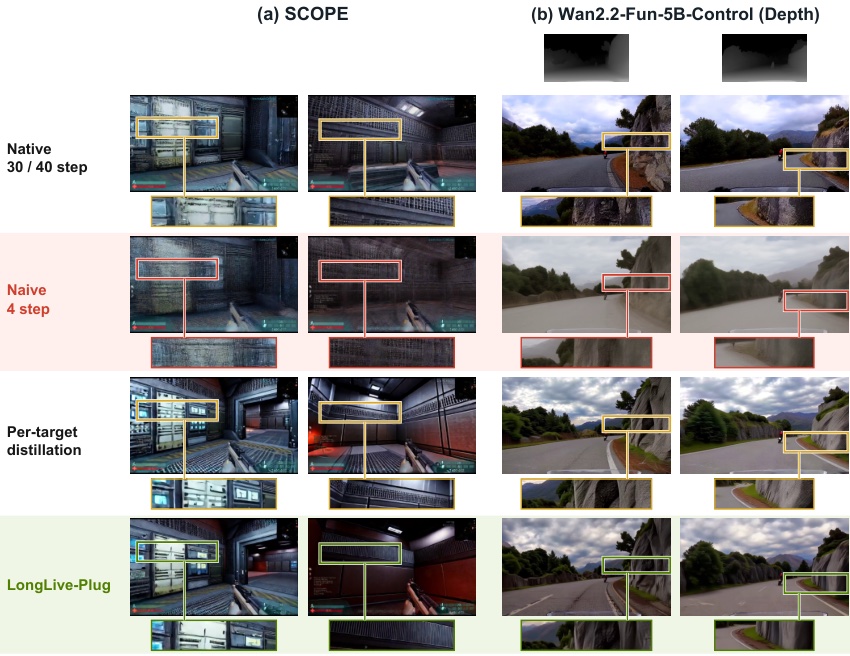
LongLive-Plug: NVIDIAがH3とWan向けのFew-Step LoRAを蒸留NVIDIAのLongLive-Plugは、few-step、CFG、long-contextのLoRAをバックボーンごとに一度蒸留し、54の下流モデルで再利用します。MiniMax H3とWan向けの重みも公開されています。
ComfyUI エコシステムの最新情報:オープンソースモデルのリリース、カスタムノード、ワークフロー、ツールのアップデート。
テキスト→動画NVIDIAのLongLive-Plugは、few-step、CFG、long-contextのLoRAをバックボーンごとに一度蒸留し、54の下流モデルで再利用します。MiniMax H3とWan向けの重みも公開されています。
 エコシステム
ComfyUI v0.38.0では、Ming-Imageのネイティブサポートと公式テンプレートが追加され、Wan ID-V2V、w6a8量子化、HDR LogC3およびACEScct色空間が導入され、SeedVR2とYuE2が高速化されました。
 動画編集
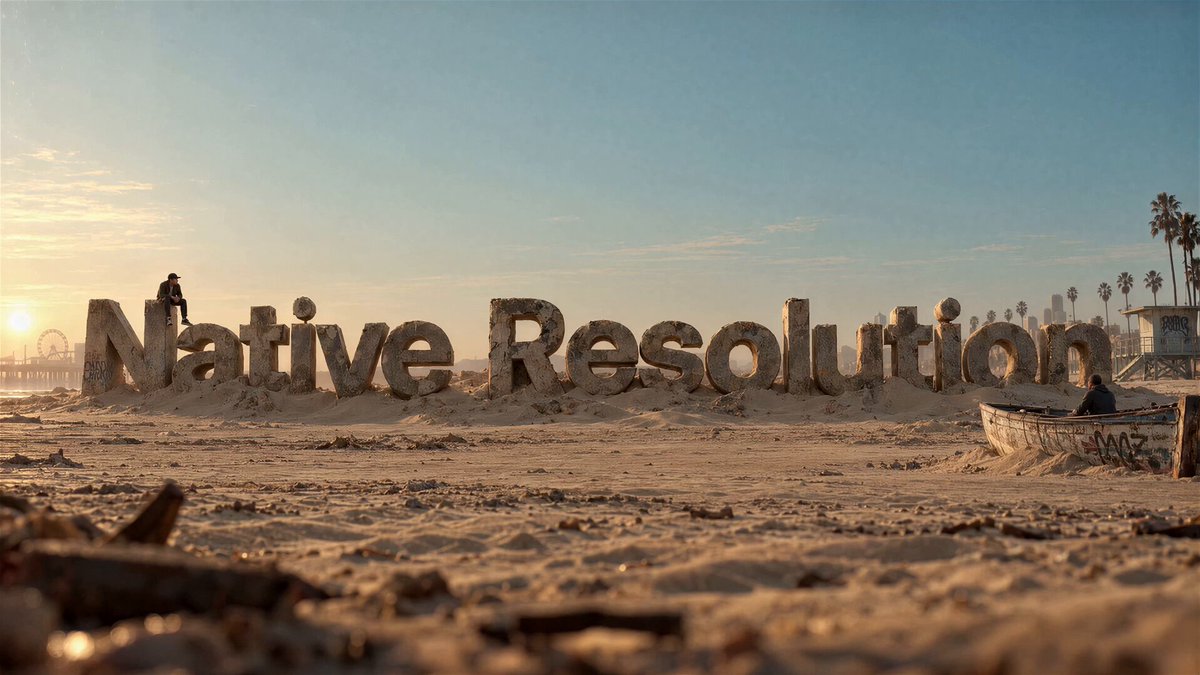
LightricksのNative ResolutionがTiled FusionによりLTX-2.5の4K・8K動画編集をComfyUIに導入します。新しいRefine IC-LoRAとRestore IC-LoRAも同梱されています。
LTX-2.x Community License
 画像→動画
MATLOWのORB360 LoRAは、MiniMax H3 Ref2VAに、静止した被写体の周囲を時計回りに360度旋回するカメラワークを与えます。さらに写真そのものを空間内で回転させるCardSpinバリアントも用意されています。
 テキスト→画像
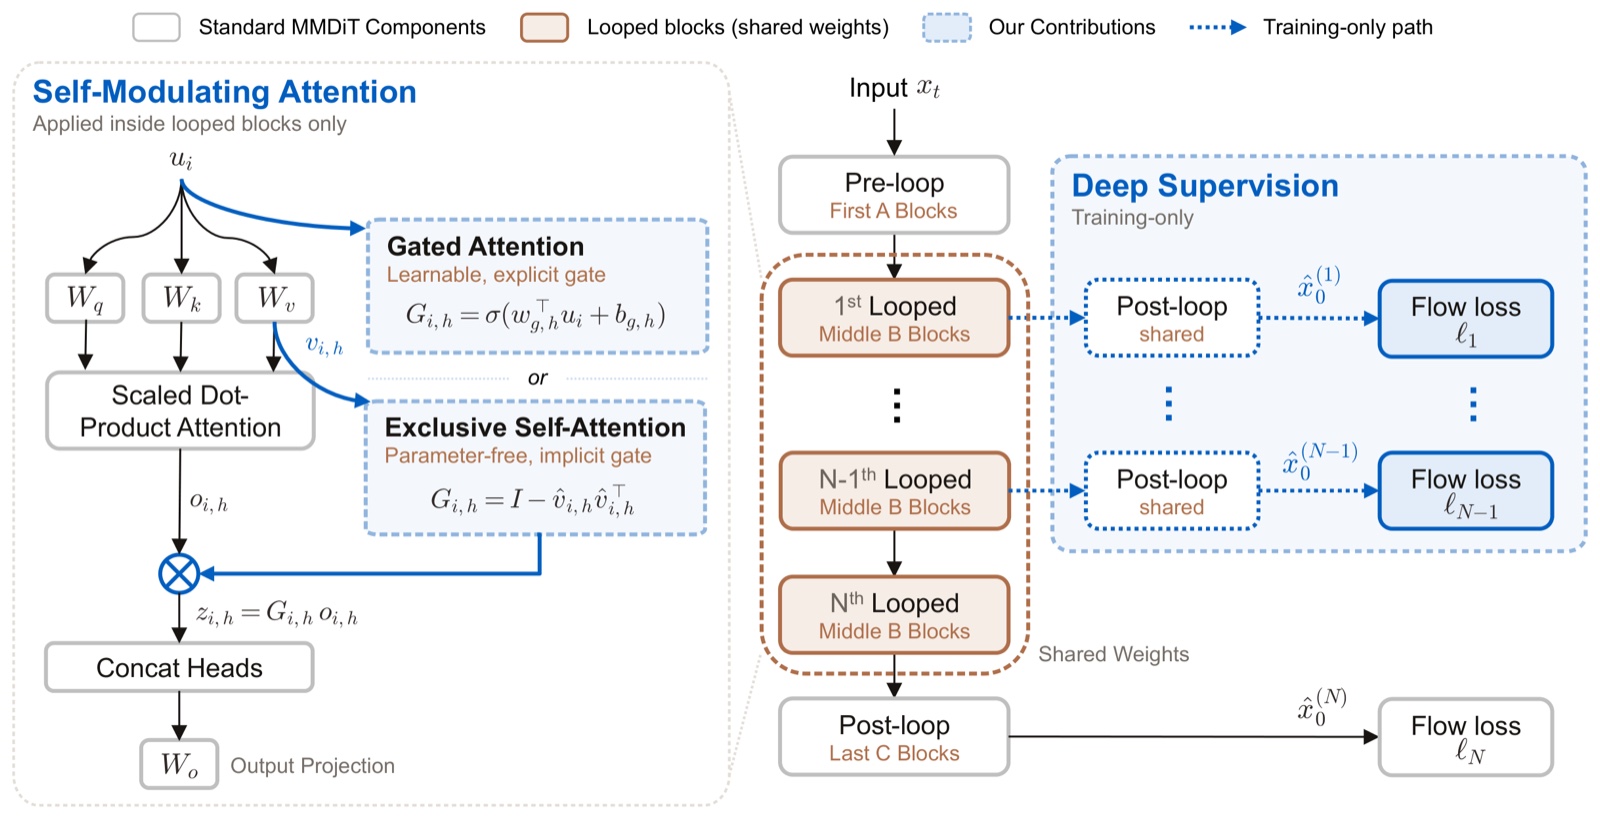
SenseTimeのOpenSenseNovaがLooped-DiTを公開しました。各デノイズステップ内で共有transformerブロックを繰り返し実行することで、小さなモデルがはるかに大きなモデルを上回ります。
MIT
 エコシステム
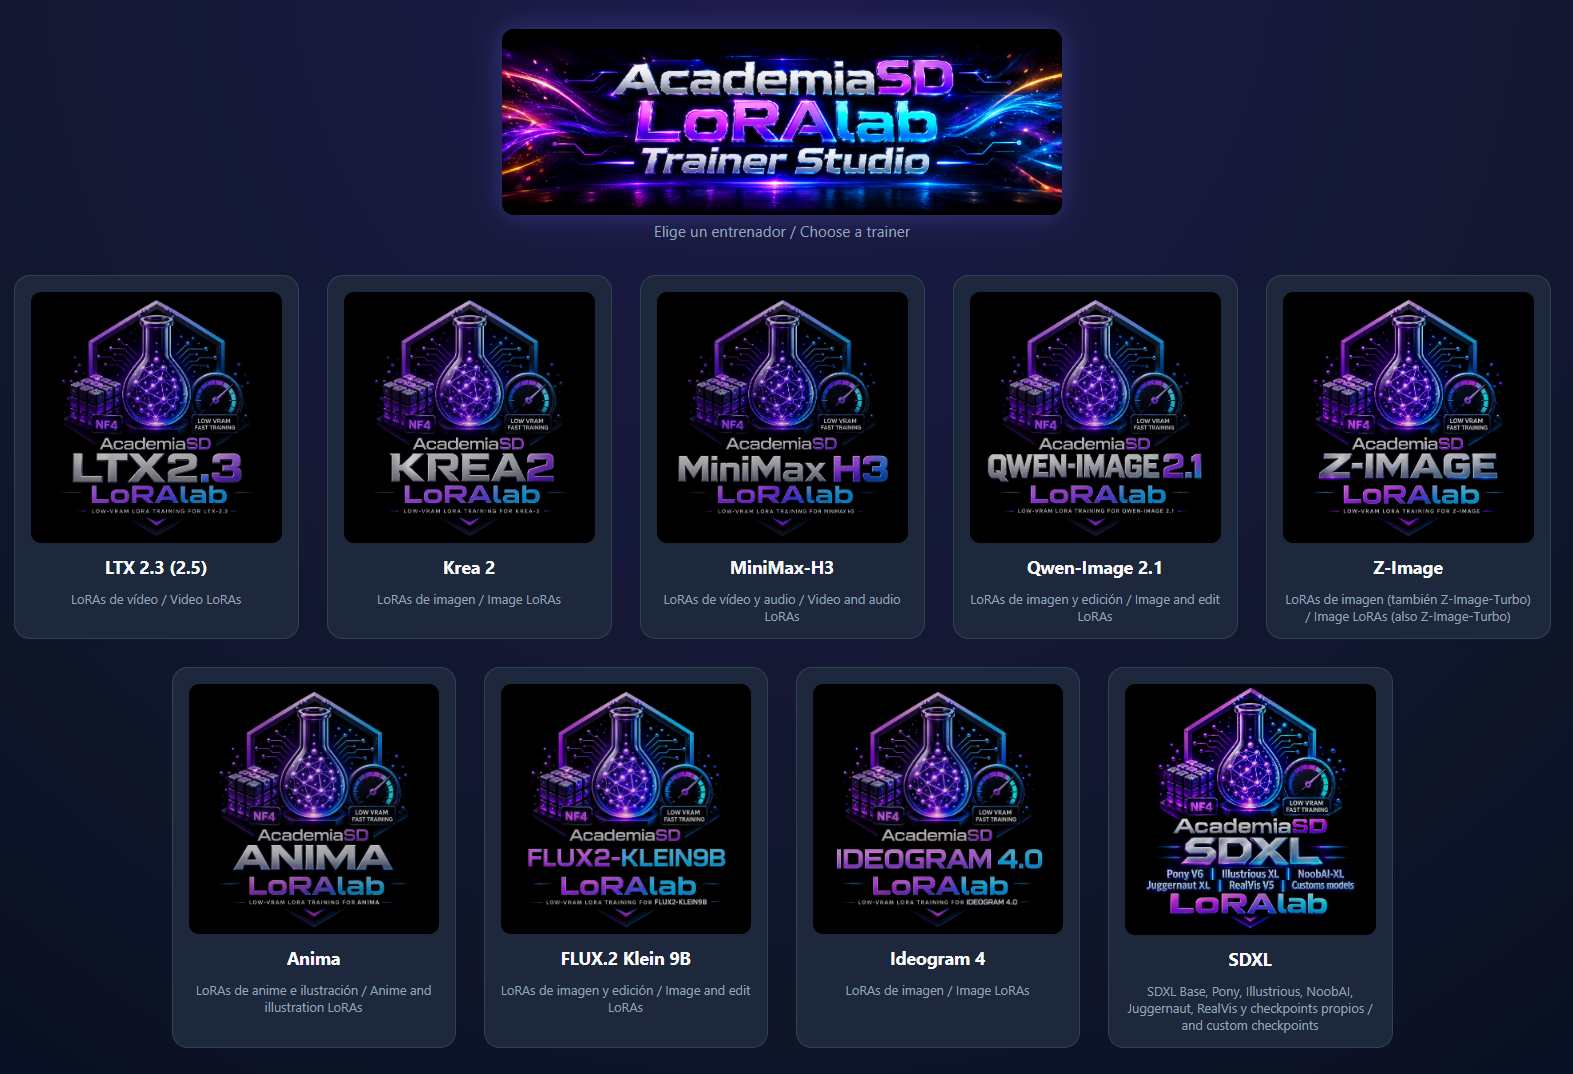
AcademiaSD LoRAlab Trainer Studioは、Qwen-Image 2.1、FLUX.2 Klein、Krea 2、Z-Image、MiniMax-H3などのLoRAトレーナーを1つのランチャーにまとめたツールで、4 GBのVRAMから利用できます。
MIT
 画像編集
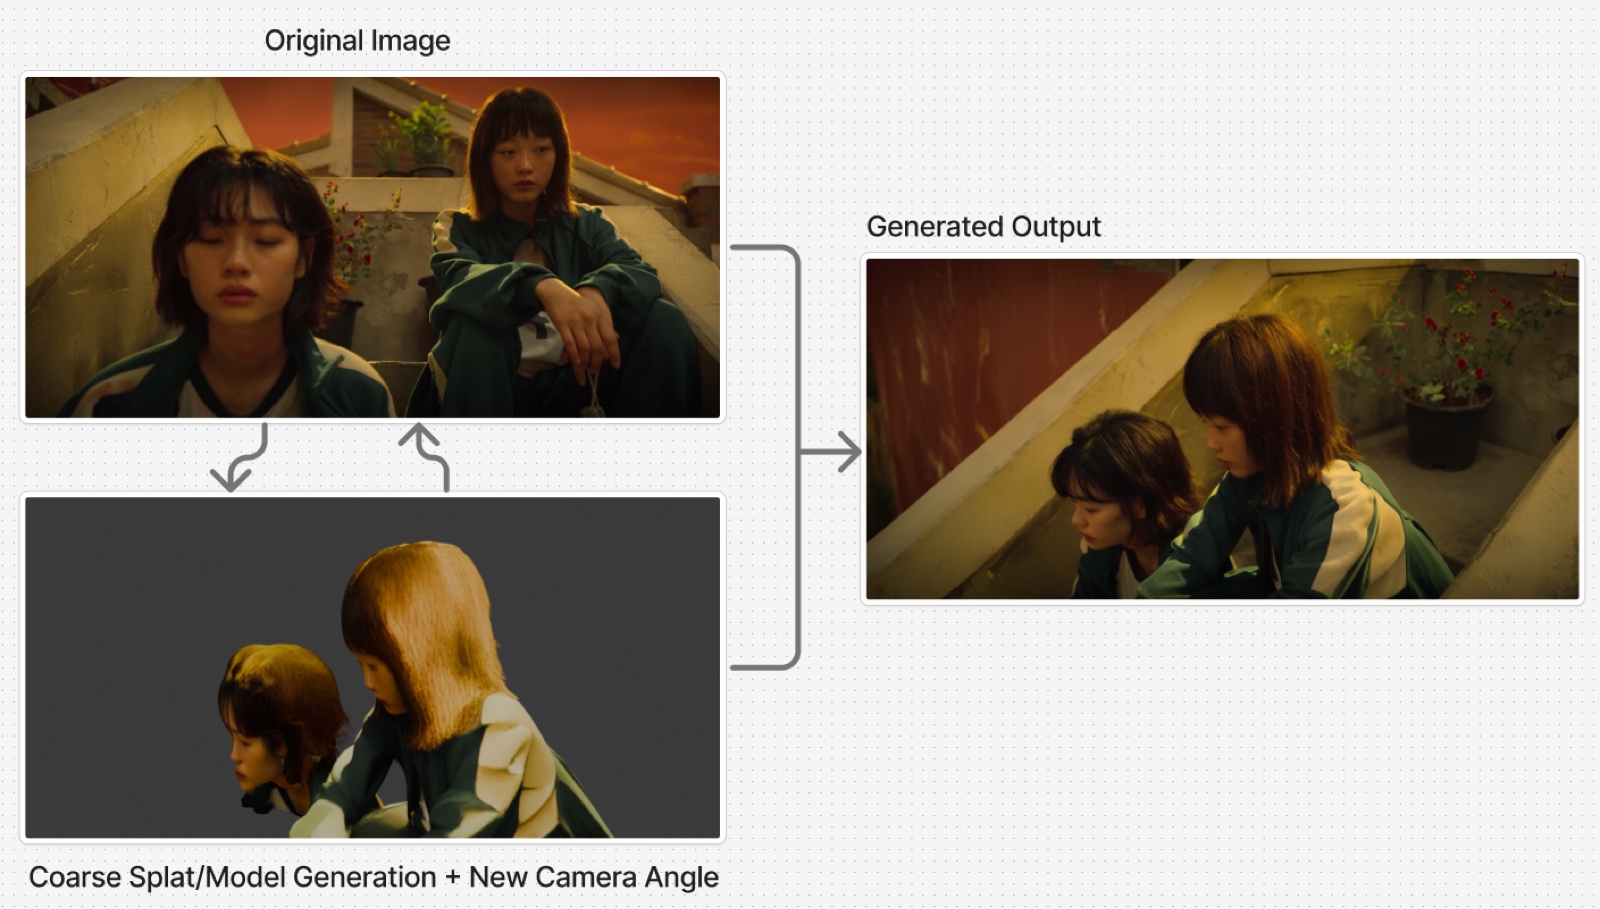
AnyAngleは、写真を任意のカメラアングルへ移動させるQwen-Image 2.1 LoRAです。ガウシアンスプラットや3Dモデルからシーンをレンダリングし、編集モデルにその視点を引き継がせます。
 画像編集
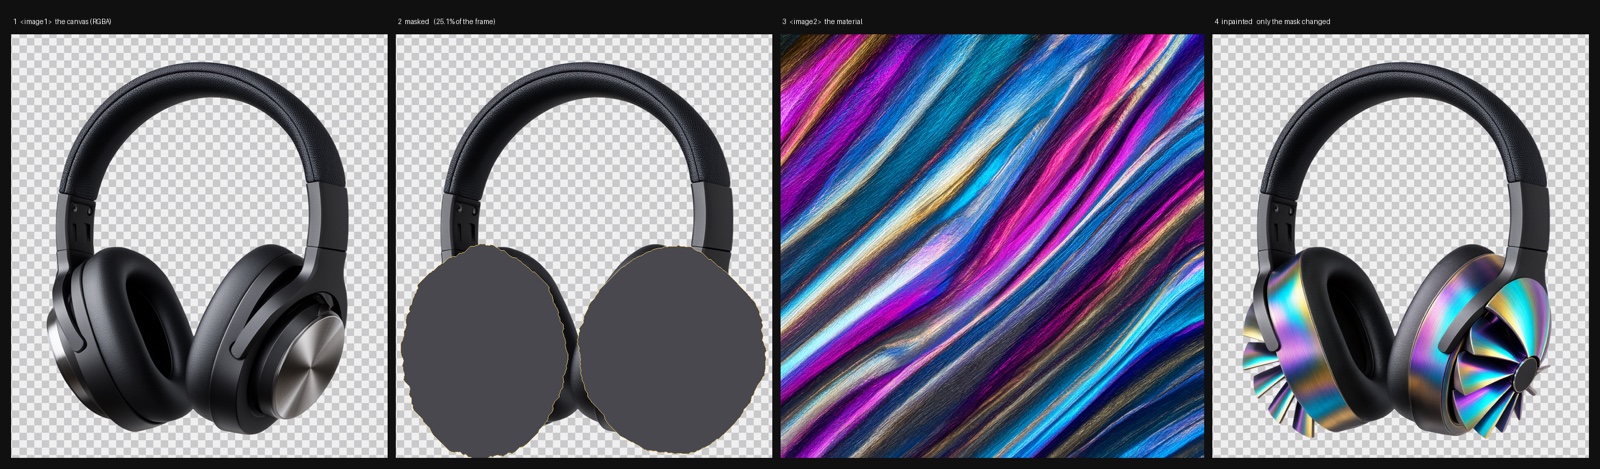
LanPaint 2.2.0はQwen-Image 2.1をマスク付きサンプラーで扱えるようにしました。テキストから画像へのモデルまたは編集モデルをインペイントでき、透明度がピクセルとともに形状を変えます。
 動画編集
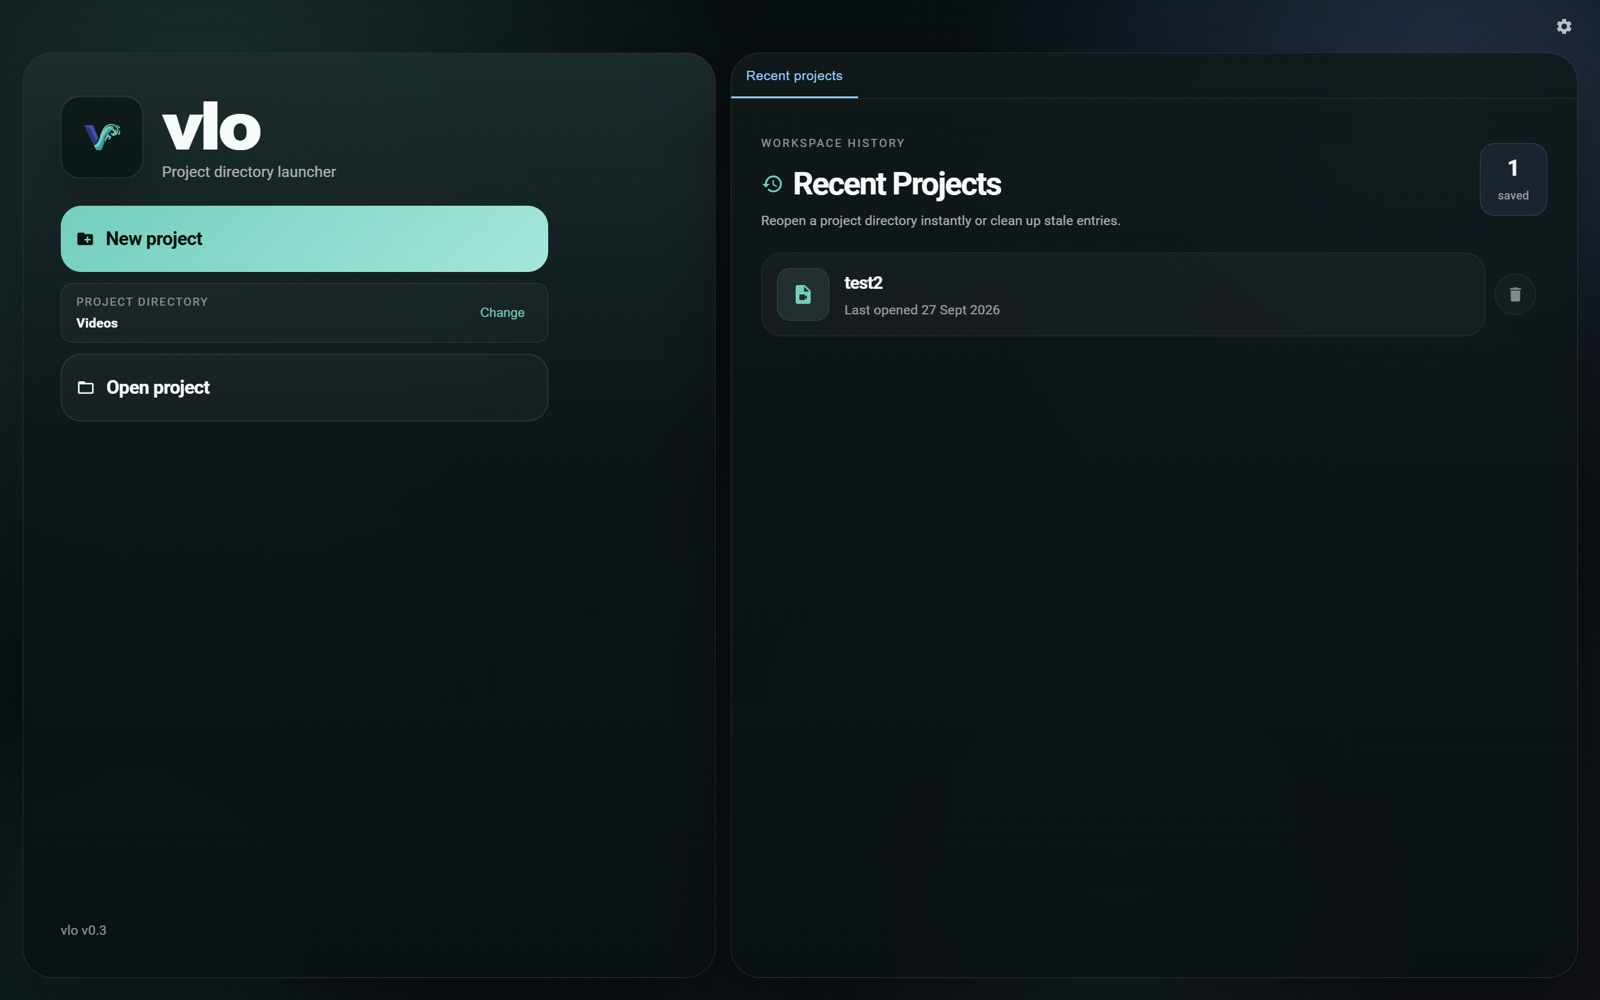
Vlo 0.3は無料のオープンソース動画エディタで、タイムラインからComfyUIを操作します。MiniMax H3とQwenのワークフロー、SAM2マスキング、グレーディング、フレーム精度のエクスポートに対応。
 テキスト→画像
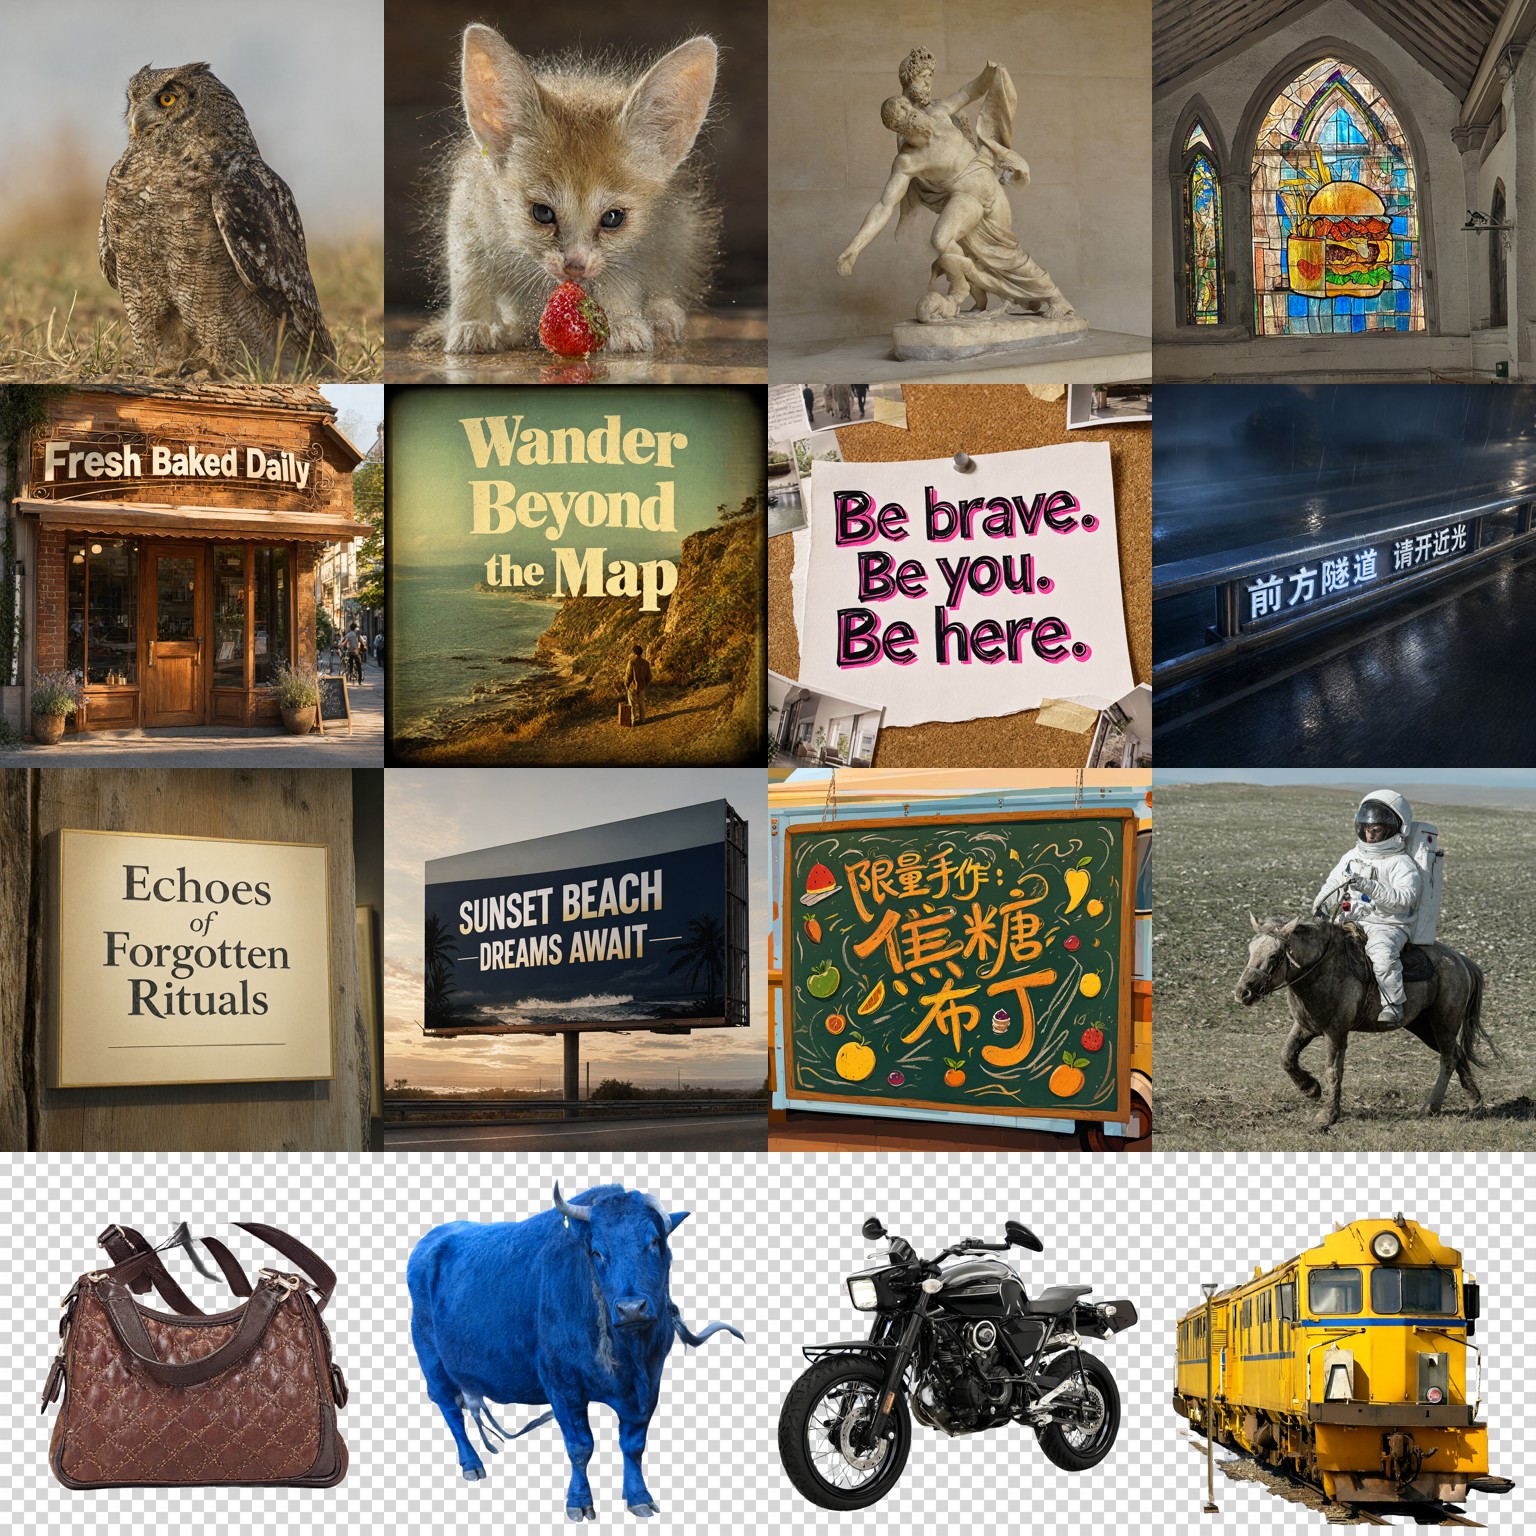
Turbo8はQwen-Image 2.1をCFGなしの8ステップに蒸留し、テキストから画像生成、編集、RGBA出力、被写体抽出をカバーします。すぐに使えるComfyUIワークフローも2つ付属します。
 画像編集
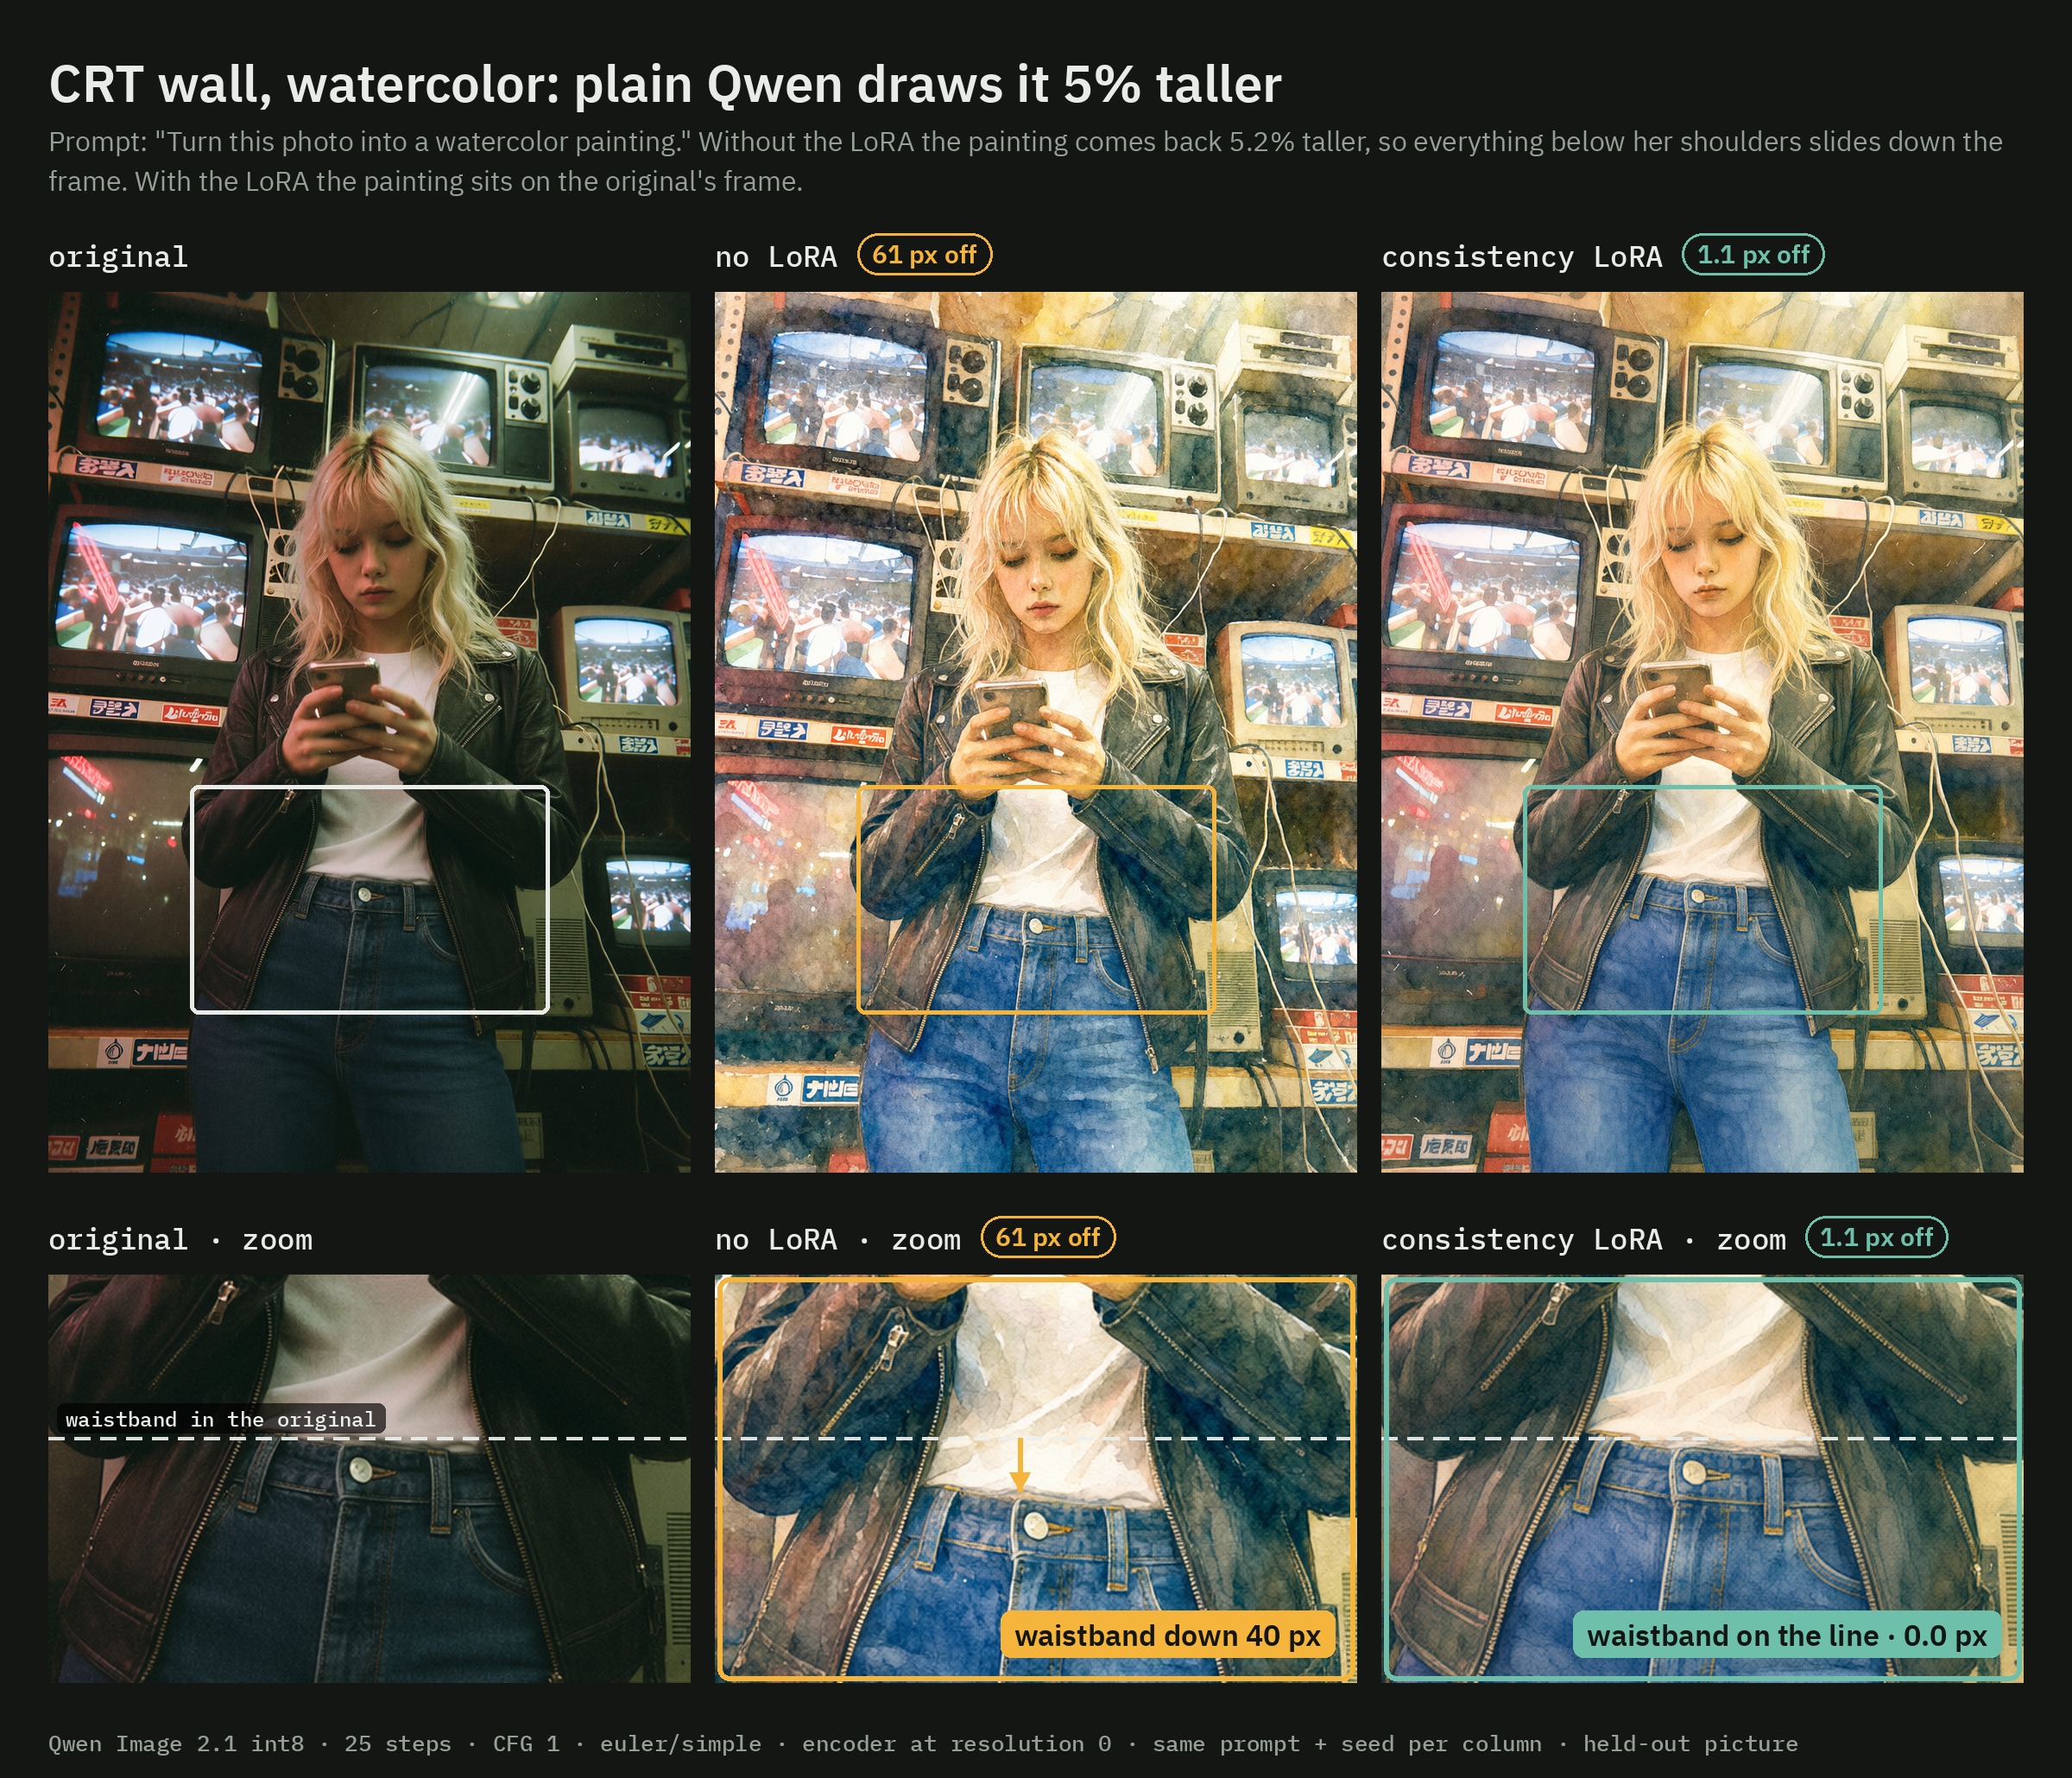
Qwen-Image 2.1 向けのコミュニティ製 LoRA が編集を元のフレーム上に保ちます。同じプロンプトとシードでもドリフトや不要な再描画が発生せず、2 つの ComfyUI ワークフローも用意されています。
 画像編集
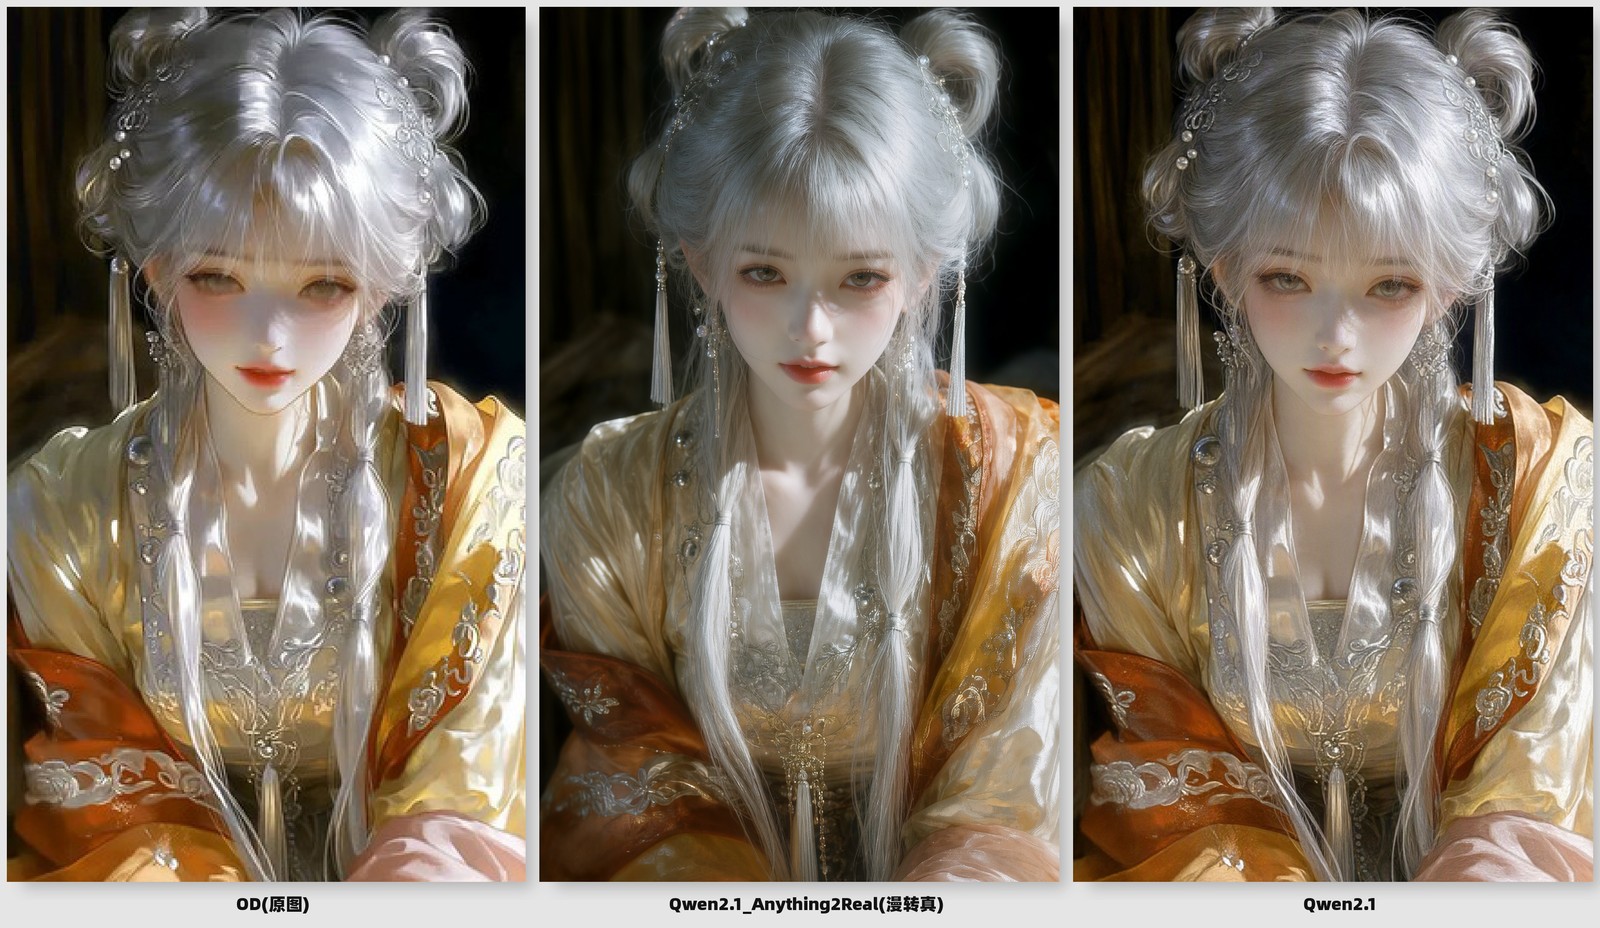
WarmBloodAbanのQwen-Image 2.1 LoRAパックは、アニメキャラクターの一貫性アダプターと、イラストを写真的な人物に変換するアダプターを組み合わせています。
Apache-2.0
 画像→動画
MiniMax H3 FL2VA用のコミュニティLoRAが、1枚の写真からカメラが360度を一周して最初のフレームに戻る動画を生成します。ComfyUIでの推奨設定も解説します。
 テキスト→画像
Fizgig v6.5は、スタジオ独自のトレーニングアダプターによるQwen Image 2.1のLoRAおよびLoKRトレーニング、ターボプレビュー、新しいドライバーシステムを追加し、ComfyUIが読み込めるLoRAを保存します。
 画像→動画
1枚の画像を別の画像へモーフィングするMiniMax H3 LoRA。ComfyUIの開始フレームと最終フレームによるシームレスな遷移の中で、要素・マテリアル・被写体が互いに変換されます。
 動画編集
Akatz LabsのMiniMax H3 Ref2VA向けキャラクタースワップLoRAは、参照動画内の1人の人物をキャラクター画像やキャラクターシートで置き換えます。重みとデータセットも公開されています。
 テキスト→画像
ComfyUI-Fizgig-H3-Still は、真の1フレーム MiniMax H3 潜在を構築しバンディングなしでデコードする2つのノードを追加します。3 MP 以上のクリーンな静止画を生成できます。
 テキスト→動画
DraftモードではSeedance 2.5のクリップを480pでプレビューし、同じDraftから1080pの最終版をレンダリングできます。ComfyUIはDraftモデルオプション、Draft to Finalノード、3つのテンプレートを追加しました。
API-Only
 画像編集
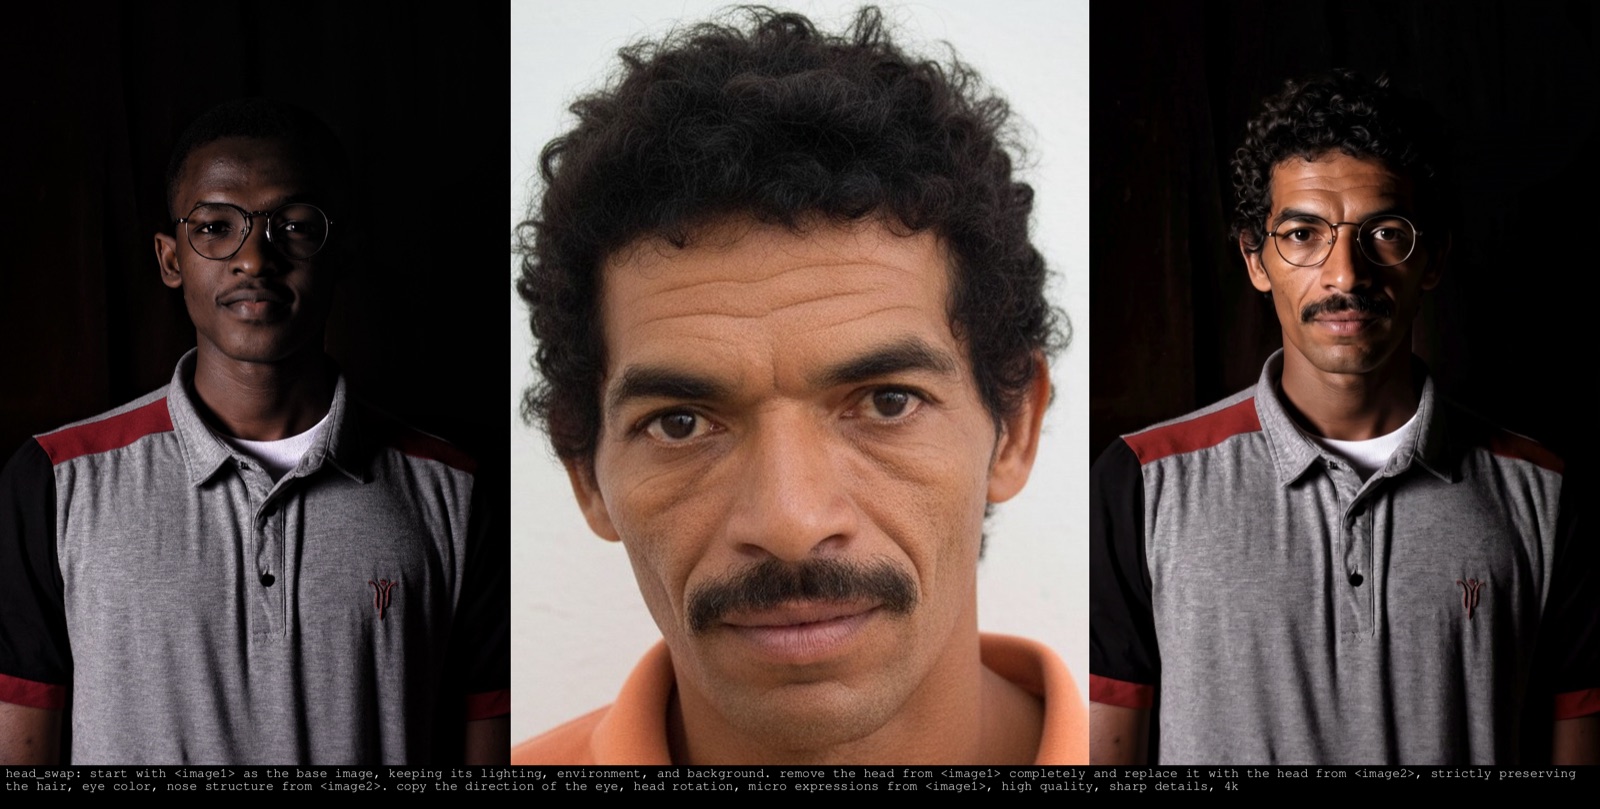
BFS Best Face SwapがQwen-Image 2.1用ヘッドスワップLoRAとすぐに使えるComfyUIワークフローを公開。実験的なLTX-2 in-contextヘッドスワップの重みも追加。
MIT
 インペイント
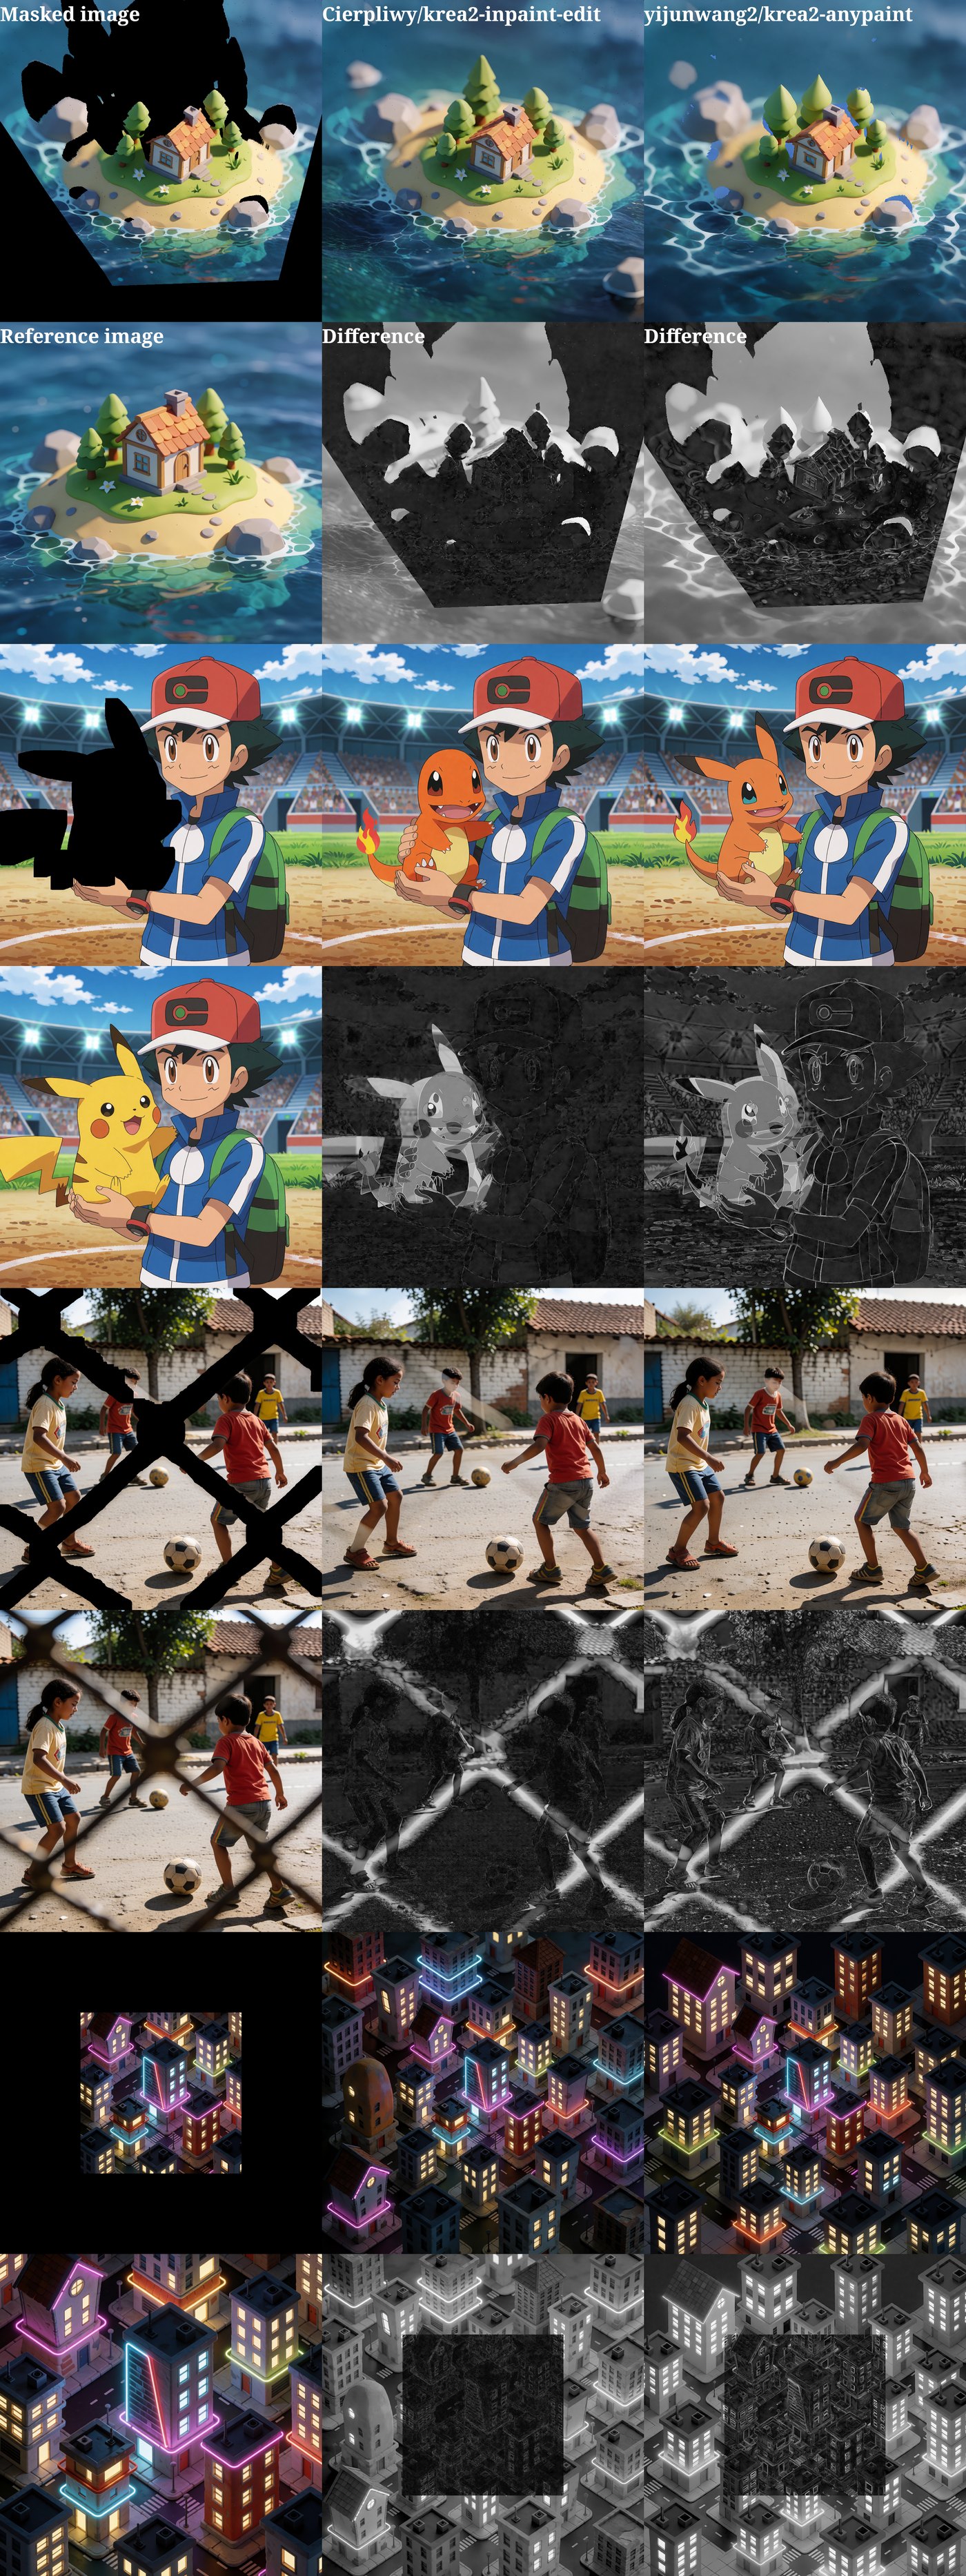
テキストプロンプトから画像の黒くマスクされた領域を再描画するKrea-2-Raw用LoRA。mild、default、strongの3種類のバリアントと、4つのComfyUIワークフロー例を収録。