Fizgig H3 Still: ComfyUI で MiniMax H3 の単一フレーム静止画を生成
ComfyUI-Fizgig-H3-Still は、真の1フレーム MiniMax H3 潜在を構築しバンディングなしでデコードする2つのノードを追加します。3 MP 以上のクリーンな静止画を生成できます。
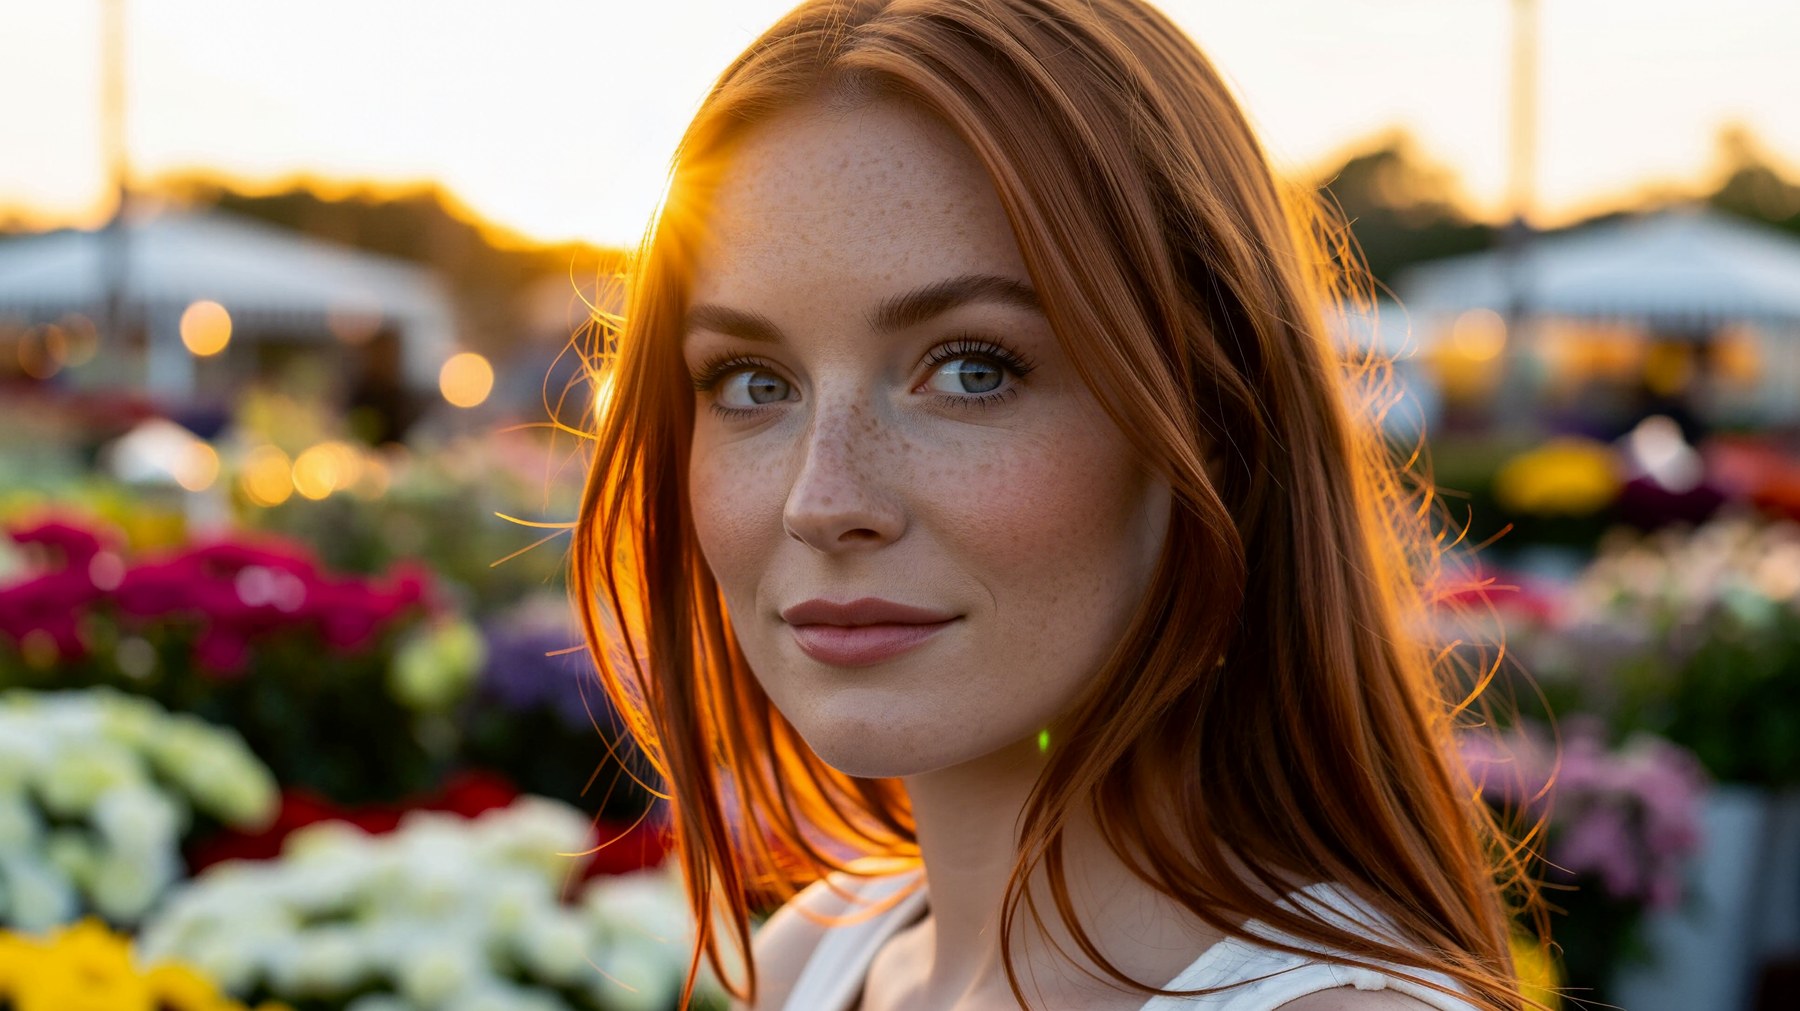
3872x2176 の静止画、Turbo LoRA なし、50 steps、er_sde。Fizgig H3 Still Latent + Fizgig H3 Still Decode を使用。リポジトリ付属の 8 MP サンプルより。
動画モデルに静止画パイプラインが必要な理由
H3 のネイティブ画像は単一フレームですが、標準のパイプラインはそれを1フレームとして扱いません。通常の H3 潜在は最低5フレーム分の長さがあるため、「静止画」は実際には短いクリップの最初のフレームにすぎません。その1フレームだけを標準の VAE Decode ノードでデコードすると、縞状のムラや筋のある出力になります。そのため、従来は5フレームをレンダリングして1枚だけ残すという回避策が使われていました。
このパックは、その問題を2つのノードに分割しています。これは Fizgig が自身の H3 静止画プレビューをレンダリングする方法に由来します。
- Fizgig H3 Still Latent は真の1フレーム潜在を生成します。
- Fizgig H3 Still Decode はその単一フレームをバンディングなしでデコードします。
どちらも ComfyUI 内蔵の MiniMax H3 サポート上で動作し、追加の Python 依存関係は不要です。作者自身のテストでは、MiniMax H3 Single-Frame VAE 500K で扱われている専用の単一フレーム VAE との比較も行っています。そのチェックポイントはより遅く、肌のディテールが少なく柔らかい仕上がりになるため、これらのノードが推奨される方法です。
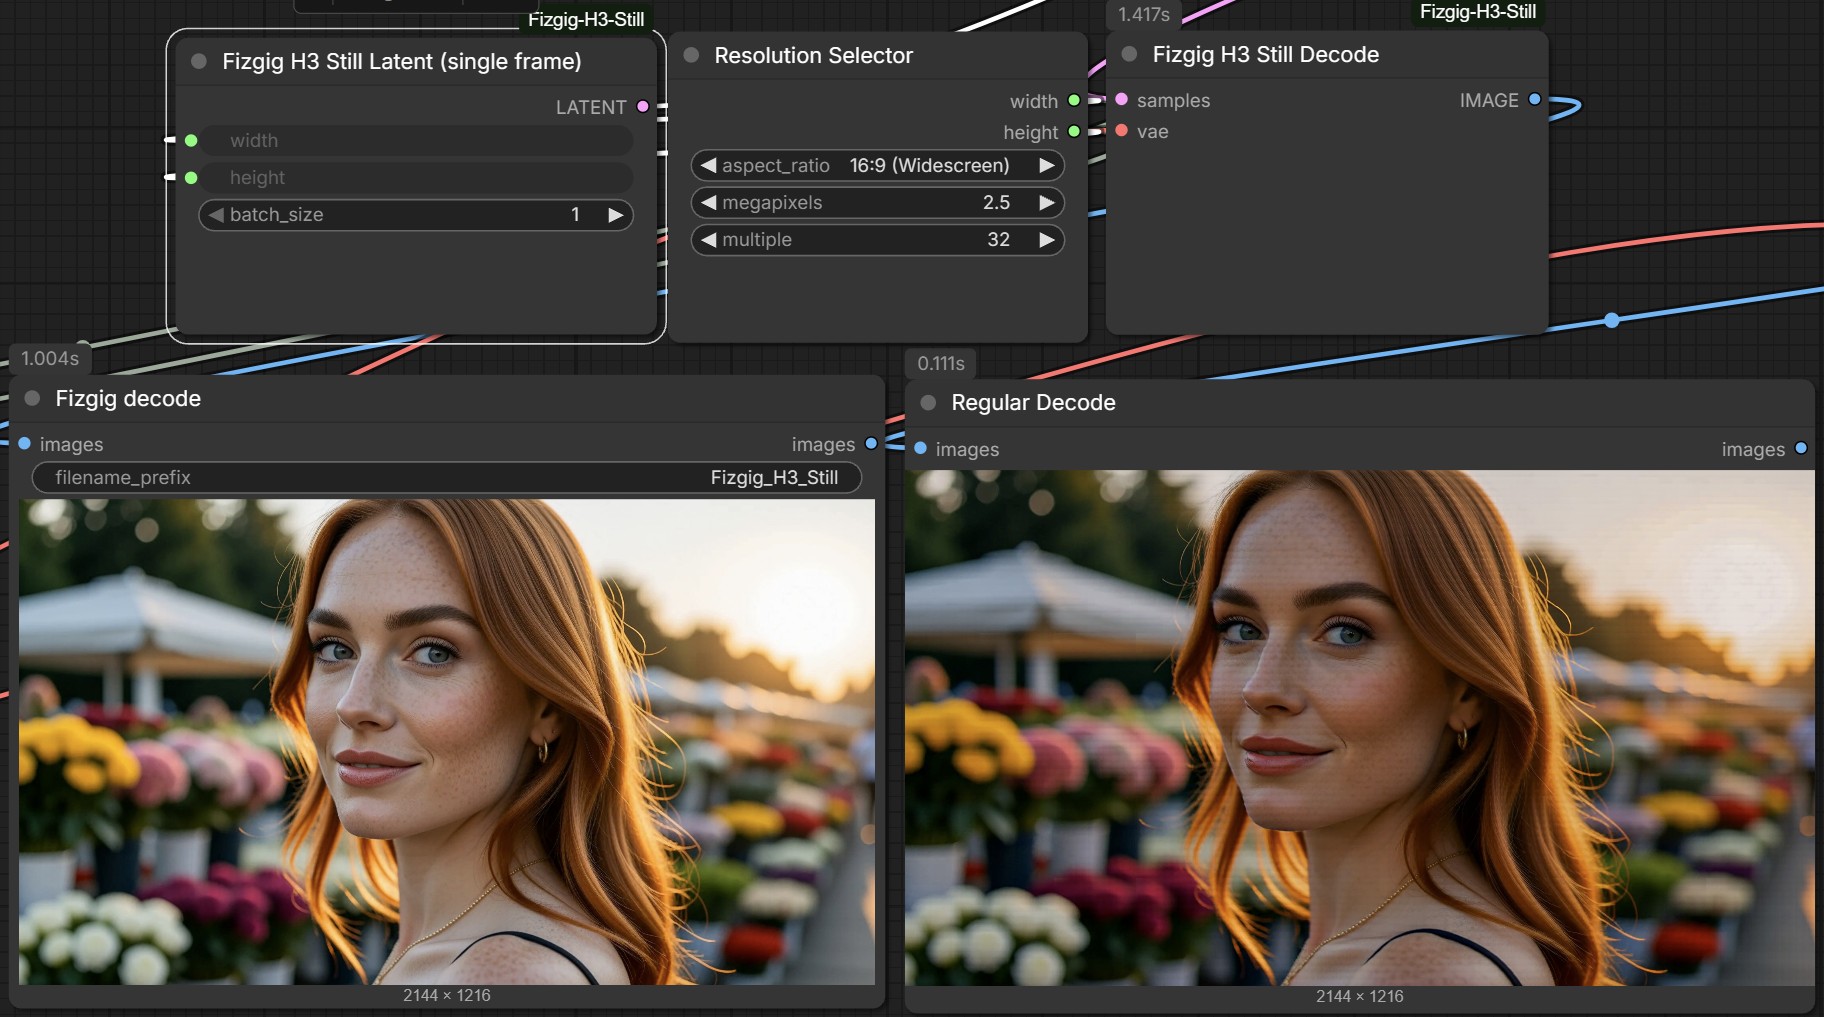
同じシード、2144x1216: Fizgig H3 Still Decode(左)と標準の VAE Decode(右)。
H3 グラフへの組み込み
LATENT 出力は接続しないでおきます。代わりに Fizgig H3 Still Latent をサンプラーの潜在入力に接続し、条件付けノードと同じ幅と高さを使用します。
デコーダーを差し替える
VAE Decode を Fizgig H3 Still Decode に置き換えます。サンプラー出力と動画 VAE を入力として受け取り、置き換えるノードと同じ入力です。
任意で Turbo LoRA を追加する
larryvrh/MiniMax-H3-Turbo-Lora の LoRA を、モデル専用の LoRA ローダー経由で追加します。付属の設定では v4 step-600 EMA ファイルを強度 0.38、20 steps、er_sde サンプラーで使用します。8 MP のサンプルは Turbo なしで 50 steps でレンダリングされています。
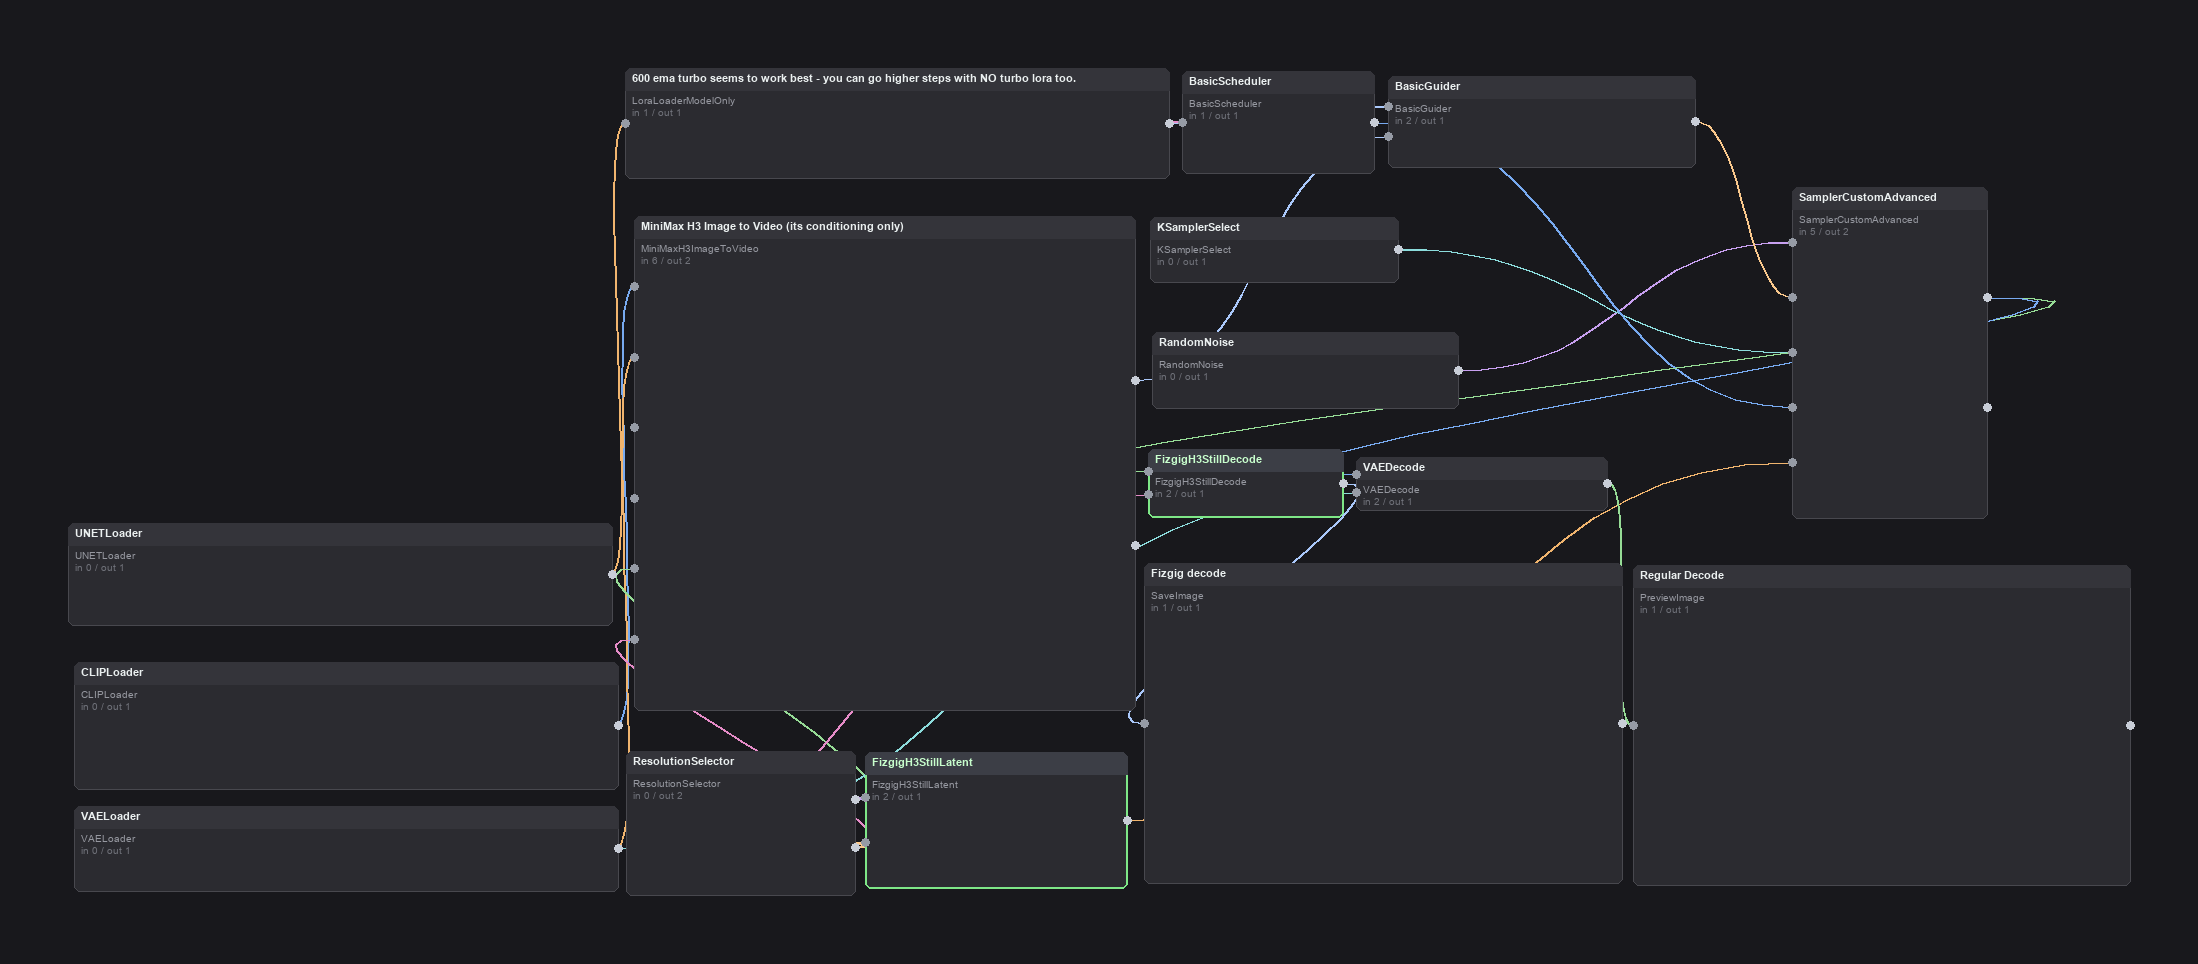
リポジトリに付属するワークフロー JSON からレンダリングした h3_still_text_to_image サンプル。Fizgig H3 Still Decode と標準の VAE Decode でそれぞれ1回ずつ、計2回デコードするため、2つの出力を並べて比較できます。
32 の倍数であればどの幅と高さでも動作しますが、結果が最も良好なのは 3 MP 以上 です。小さい画像は明らかに見劣りします。デコードはタイル方式で、一度に数タイルずつ、VRAM が厳しい場合は1タイルずつ処理するため、大きな静止画でも大型の GPU は必要ありません。このグラフを動画用途に再利用する前に知っておきたい点: 潜在ノードは静止画専用ですが、デコードノードは1フレームより長いものはそのまま標準のデコードへ渡すため、クリップのワークフローに残しておいても問題ありません。
このパックには 編集サンプル も付属しています。写真を MiniMax H3 リファレンスから動画へ に渡し、プロンプト内で <Picture 1> として参照します。H3 の編集はそのサイズが最適なようなので、まず 2.5 MP にアップスケールします。
姉妹パック: H3 Tweaks
同じ作者の以前のノードパック ComfyUI-Fizgig-H3-Tweaks は、同じ探求の動画側を、トレーニング不要の調整項目でカバーしています: 肌のテクスチャ制御、サブシードを維持したままシーンを再生成、Turbo レンダリング用のプロンプト強度ダイヤルなどです。09-25 の更新では、静止画関連の作業と並んで H3 Latent と VAE Decode のノードバリエーションが追加されました。
コミュニティの反応
これらのノードは 2026-09-26 に r/comfyui で広まり、独立したテスターが週末に 8 MP のグラフを 30 steps で実行しました。その所見: 静止画パイプラインによって、ようやく小さな文字組が使えるようになりましたが、非常に細かい文字には向きません。また、レンダリング結果は通常の出力よりも滑らかで、ブロック状のピクセルの継ぎ目や「走査線」は見られませんでした。さらに色味の変化も測定されました: 静止画の経路では、通常出力のわずかにセピアがかった暖かみではなく、純粋なモノクロのフィルムノワール風の見た目になりました。
インストール
cd ComfyUI/custom_nodes
git clone https://github.com/shootthesound/ComfyUI-Fizgig-H3-Still
ComfyUI を再起動すると、両方のノードが Fizgig カテゴリに表示されます。サンプルでは Comfy-Org の H3 ファイルを使用します: models/diffusion_models 内の minimax_h3_fl2va_pruned_int8_convrot.safetensors、models/text_encoders 内の qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors、models/vae 内の minimax_h3_video_vae_int8_convrot.safetensors。編集サンプルではさらに ComfyUI-RMBG の AILab_ImageResize を使用します。
リポジトリ: shootthesound/ComfyUI-Fizgig-H3-Still
姉妹パック: shootthesound/ComfyUI-Fizgig-H3-Tweaks
関連: Fizgig v6 RefMods、MiniMax H3 Video VAE Optimization
ベースモデル: Comfy-Org/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。