MiniMax H3 Transformation LoRA: 2枚の画像をモーフィング変換するガイド
1枚の画像を別の画像へモーフィングするMiniMax H3 LoRA。ComfyUIの開始フレームと最終フレームによるシームレスな遷移の中で、要素・マテリアル・被写体が互いに変換されます。
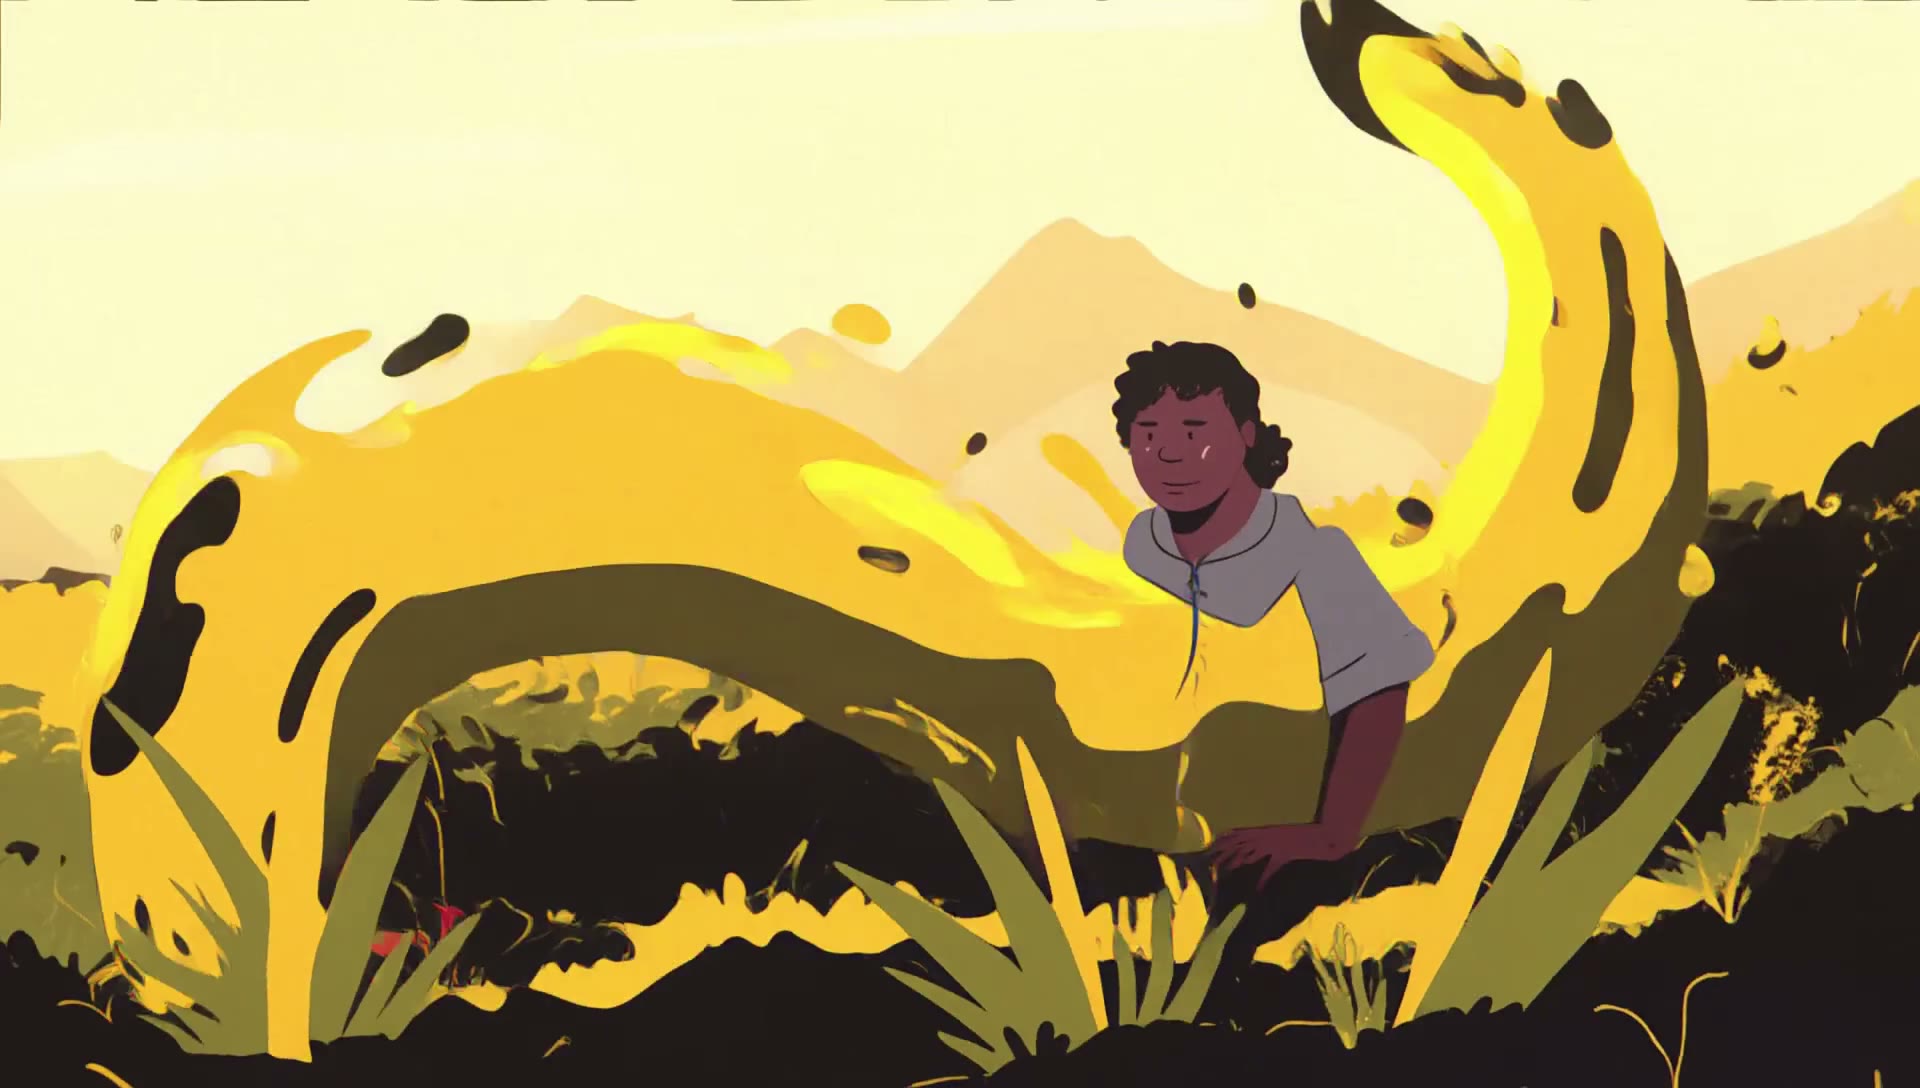
ショーケースクリップの1つからの1フレーム。最初の画像の各被写体に、2番目の画像のそれぞれの対応物が割り当てられています。
できること
MiniMax H3の開始フレーム・最終フレームのパスは通常、2枚の画像を1つの連続したショットの両端として読み取ります。つまりカメラか被写体が動き、シーンは見分けがつく範囲で同じままです。このアダプターは、2つのフレームをそれぞれ開始状態と終了状態にします。その間にあるものすべてが遷移であり、モデルは画像全体をクロスフェードするのではなく、個々の視覚要素をその遷移に沿って運ぶように学習されています。
対応関係がプロンプトで明示されるため、1回の変換で複数の変換を同時に扱えます。下のサンプルでは、グレーのTシャツの人物が2番目の画像の少女になり、黄色のシャツの人物が黄色い草になり、緑のシャツの人物が何もない背景になり、そのすべてが1つのクリップの中で起こります。
プロンプト形式
このアダプターはトリガーワードとアクションコネクターを使用し、各被写体・マテリアル・要素がどのように対応物へ変わるかをプロンプトで指定すると最もよく機能します。
- トリガーワード:
Tr@nsf0rmation_style - アクションコネクター:
Tr@nsf0rmation into
推奨テンプレートは次のとおりです。
integrated_multimodal_description: [Shot 1] Tr@nsf0rmation_style, Picture 1 Tr@nsf0rmation into Picture 2 with individual elements and subjects Tr@nsf0rmation into one another.モデルカードにある、より具体的な例です。
integrated_multimodal_description: [Shot 1] Tr@nsf0rmation_style, Picture 1 Tr@nsf0rmation into Picture 2 with individual elements and subjects Tr@nsf0rmation into one another. The bald person in grey T-shirt and blue jeans from <Picture 1> Tr@nsf0rmation into the Girl in <Picture 2>. The person in the Yellow shirt from <Picture 1> Tr@nsf0rmation into the yellow grass from <Picture 2>. The person in the green shirt from <Picture 1> Tr@nsf0rmation into the blank background in <Picture 2>.サンプル
多要素シーンの再構成: 最初の画像の各人物が、2番目の画像の異なる要素へとモーフィングされます。
2つのシーン間のストレートな視覚変換。
鉛筆のストロークの変化。個々の鉛筆のストロークが互いに変換される、より具体的なプロンプト変種を使用しています。
流動的な遷移、意味的なモーフィング、複雑な被写体の入れ替え、高忠実度の流れを扱ったさらに7本のクリップがモデルカードにあります。
推奨設定
| 設定 | 値 |
|---|---|
| ベースの重み | MiniMax H3 FL2VA または Ref2V(例: Comfy-Org/MiniMax-H3 の minimax_h3_fl2va_pruned_int8_convrot.safetensors) |
| チェックポイント | Transformation_style_c1-st2500 は完全に収束したもの、-st1600 はよりソフトで軽量 |
| LoRA強度(st2500) | 1.0〜1.2 |
| LoRA強度(st1600) | 1.0〜1.4 |
| スタック構成 | st2500を1.2、st1600を1.4で併用。ショーケースクリップで使用 |
| サンプラー / スケジューラー | simple と組み合わせた res_multistep または euler。ResMultistepが最も安定した遷移になります |
| ステップ数 | DMD turboアダプター使用時は12、スタンダードなら25〜30 |
| sigma shift | shift_video 8.0、shift_audio 3.0 |
| 解像度 | 852 × 480 または 1024 × 576、1080pまでアップスケール可能 |
ComfyUIでの実行
ファイルはComfyUIの命名規則(Transformation_style_*_comfyui.safetensors)で配布されているため、カスタムノードは不要です。
- 使用したいチェックポイントを
ComfyUI/models/loras/にダウンロードします。 - MiniMax H3のU-Netローダーの後に LoraLoaderModelOnly ノードを追加し、
strength_modelを1.0〜1.2に設定します。 - 開始画像とターゲット画像を開始フレーム・最終フレームの条件付けノードに渡します。
- 上記のように、
Tr@nsf0rmation_styleトリガーとTr@nsf0rmation intoコネクターを使ってプロンプトを記述します。
入手方法
- LoRAの重み: Ashmotv/transformation_lora
- ベースモデルの再パッケージ: Comfy-Org/MiniMax-H3
コメント
GitHubでサインインしてディスカッションに参加しましょう。