Qwen-Image 2.1 Consistency LoRA: 編集を元のフレームからずらさない
Qwen-Image 2.1 向けのコミュニティ製 LoRA が編集を元のフレーム上に保ちます。同じプロンプトとシードでもドリフトや不要な再描画が発生せず、2 つの ComfyUI ワークフローも用意されています。
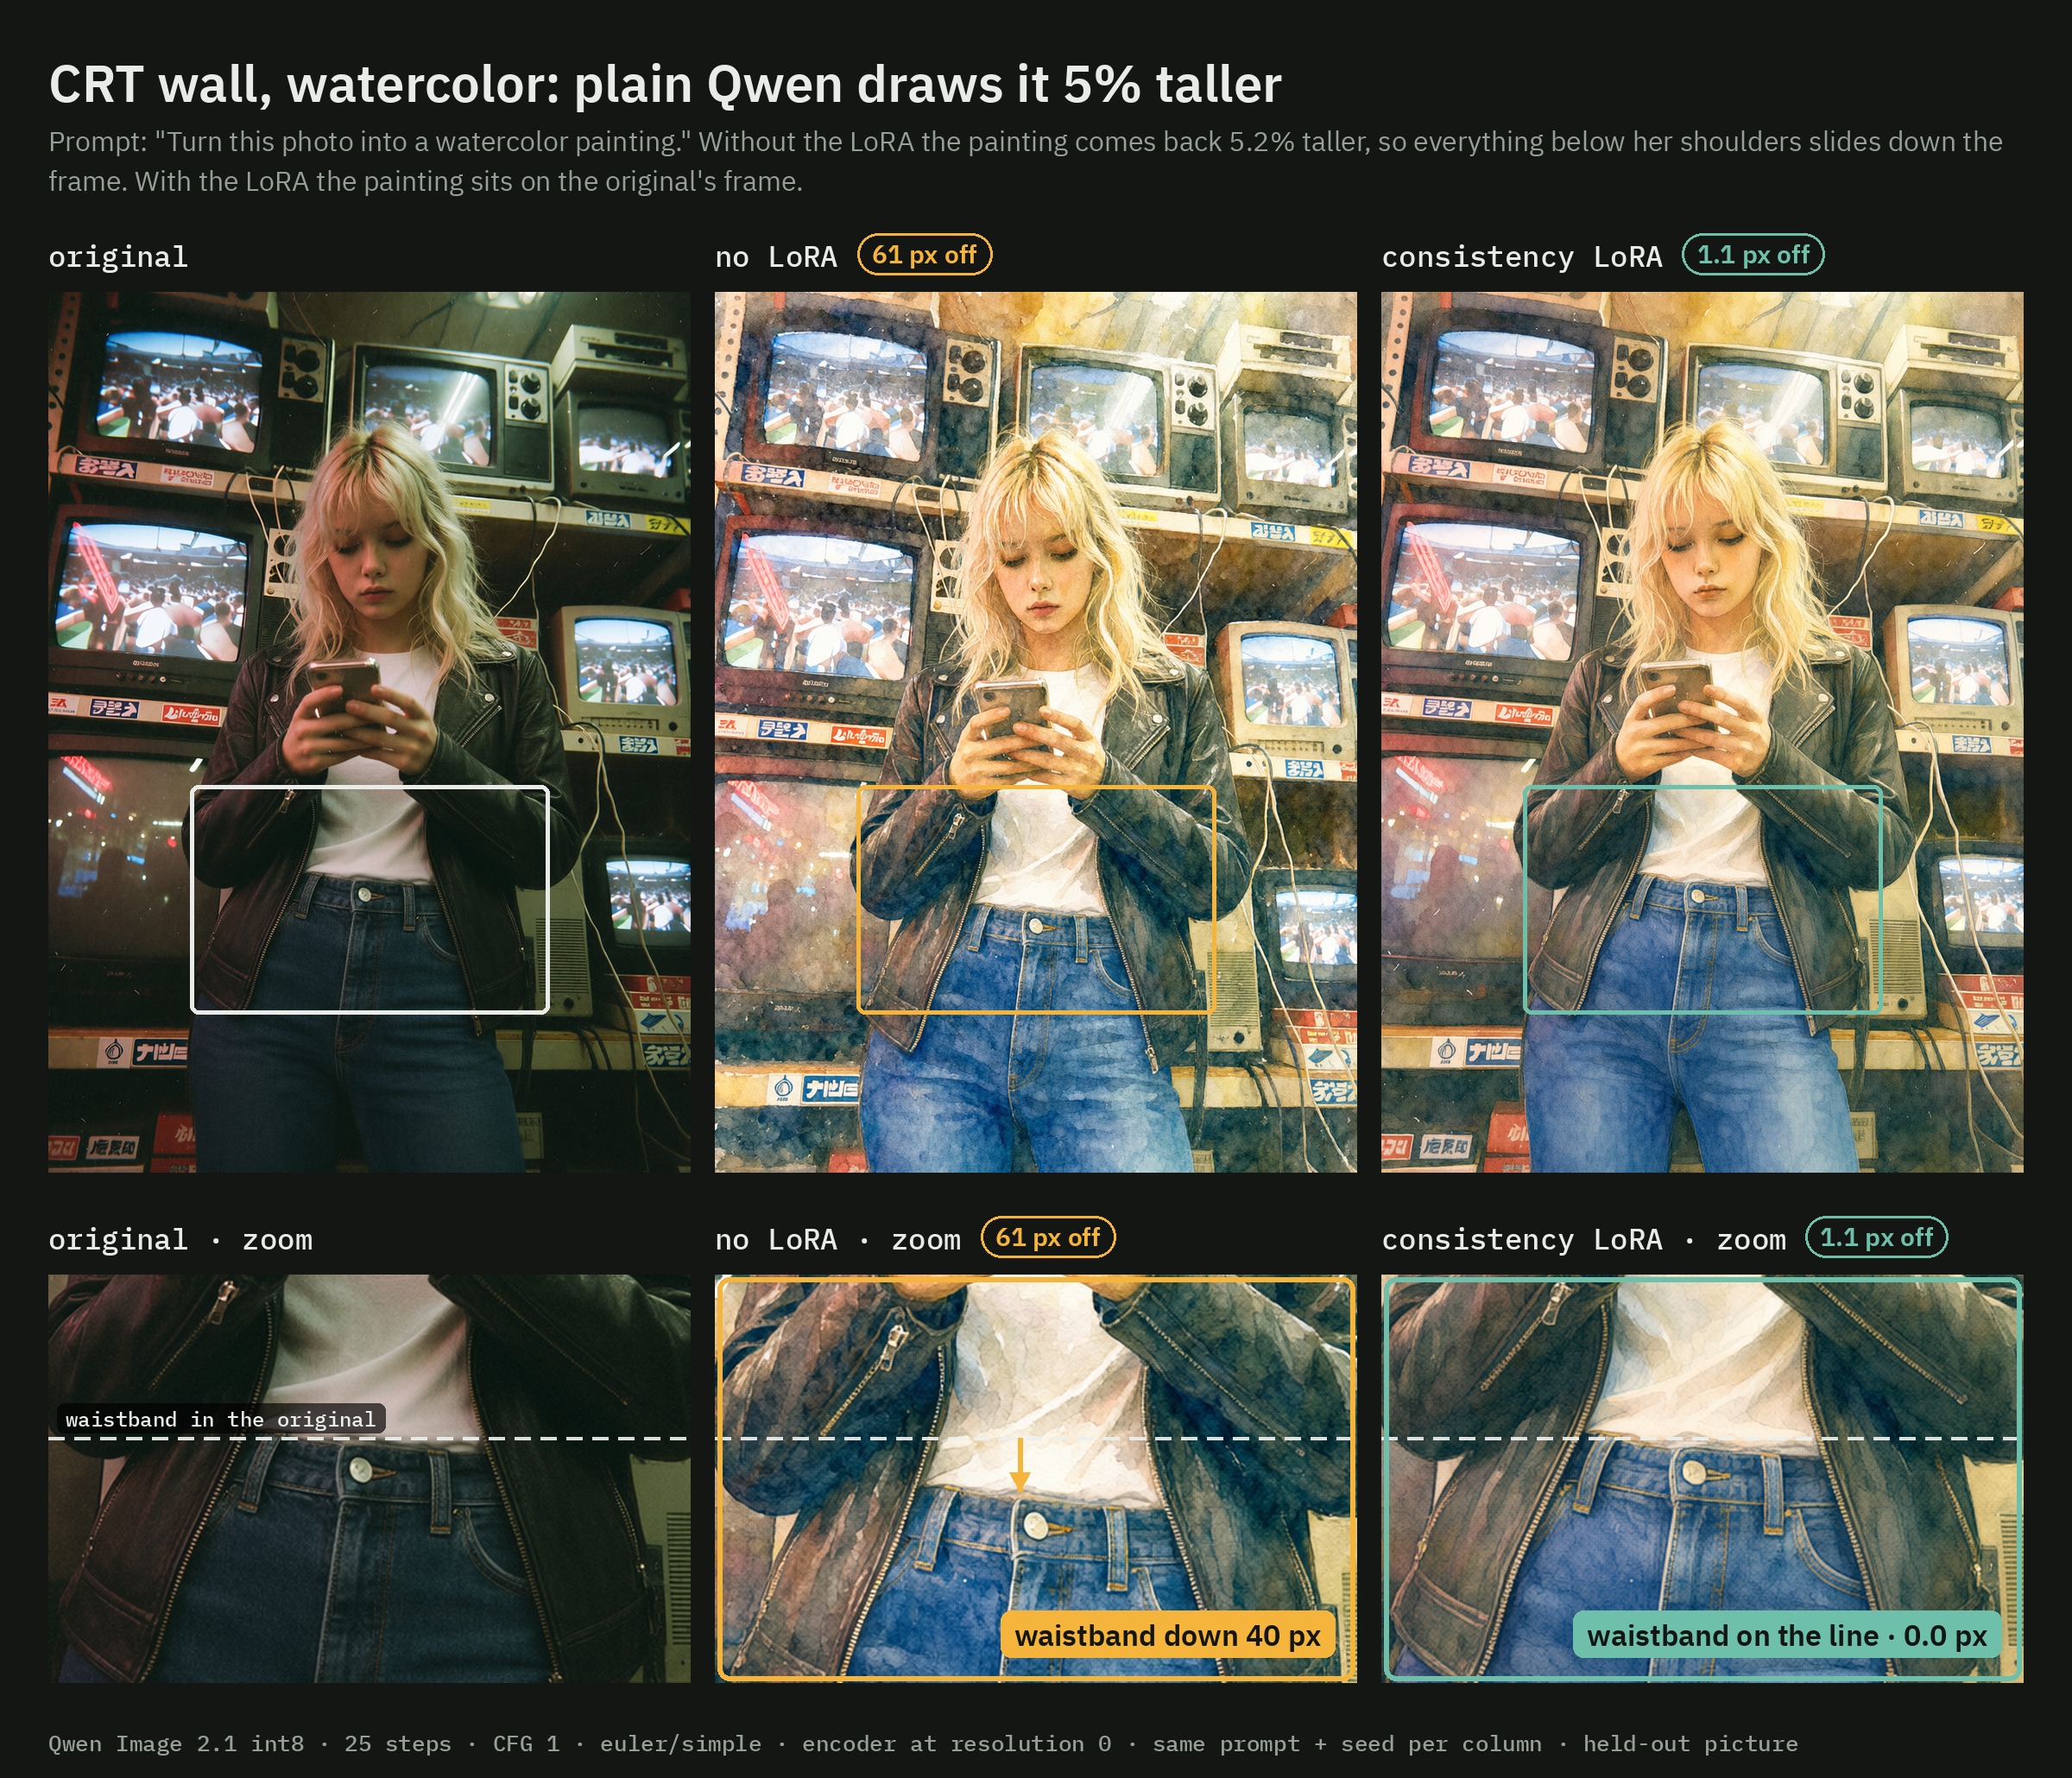
破線はオリジナルで特徴が位置する場所を示し、矢印はそれがどれだけ移動したかを示します。各列で同じプロンプトとシードを使用し、Comfy-Org の INT8 Qwen-Image 2.1 重みで ComfyUI 上でレンダリングしました。
解決する問題
Qwen-Image 2.1 の編集はすべて新規生成であるため、モデルは指定した部分だけを変更するのではなく、画像全体を再構成します。全体的なリスタイルでは、これがドリフトとして現れます。ウエストバンドが 40 px 下がり、地平線が 25 px 上がり、顔がオリジナルと揃わなくなる、といった具合です。ローカル編集では再描画として現れ、編集対象の外側にある髪の毛、看板、テクスチャまで一緒に描き直されます。
この LoRA は、編集をオリジナルのフレーム上で行わせます。トリガーワードはありません。読み込んで、いつもどおり編集指示を書けば、変更部分以外のピクセルは元の位置に留まります。
測定されたドリフト
モデルカードには、トレーニングセットに一度も含まれていないホールドアウト編集の数値が報告されています。オフセットは、オリジナルと比較して測定した画像内で最もずれの大きいコーナーの値です。スタイル列は各レンダリングを素の Qwen-Image 2.1 の見た目と比較したもので、距離が小さいほど近い一致を意味します。
| ホールドアウト編集、素の Qwen 2.1 と LoRA の比較 | LoRA なし | step 1500 | step 2000 |
|---|---|---|---|
| リスタイル (36): 最大コーナーずれ、中央値 | 24.3 px | 1.6 px | 0.9 px |
| リスタイル: 最大コーナーずれ、最悪ケース | 61.1 px | 12.9 px | 3.5 px |
| ずれが 3 px 未満のリスタイル | 3 % | 75 % | 97 % |
| リスタイル (15): 素の Qwen の見た目に対する色距離 | 7.0 | 6.3 | 10.9 |
| 再ライトとローカル編集 (12): 最大コーナーずれ、中央値 | 0.7 px | 0.1 px | 0.1 px |
素の Qwen-Image 2.1 の 2 つのシードは、この色スケール上で互いに 7.0 異なります。つまり step 1500 のリスタイルは、素の Qwen が自分自身と似ているのと同じくらい素の Qwen に似ています。step 2000 はより正確に位置が揃いますが、見た目が変わり始めます。紙がより白くなり、インクとグアッシュの色味が減ります。
2 つ目のセットは、ホールドアウト写真に対する 18 件の色変更と削除の編集で、ドリフトではなく再描画を測定しています。各レンダリングはまずオリジナルと位置合わせされるため、カウントされるのはオフセットではなく実際の再描画です。
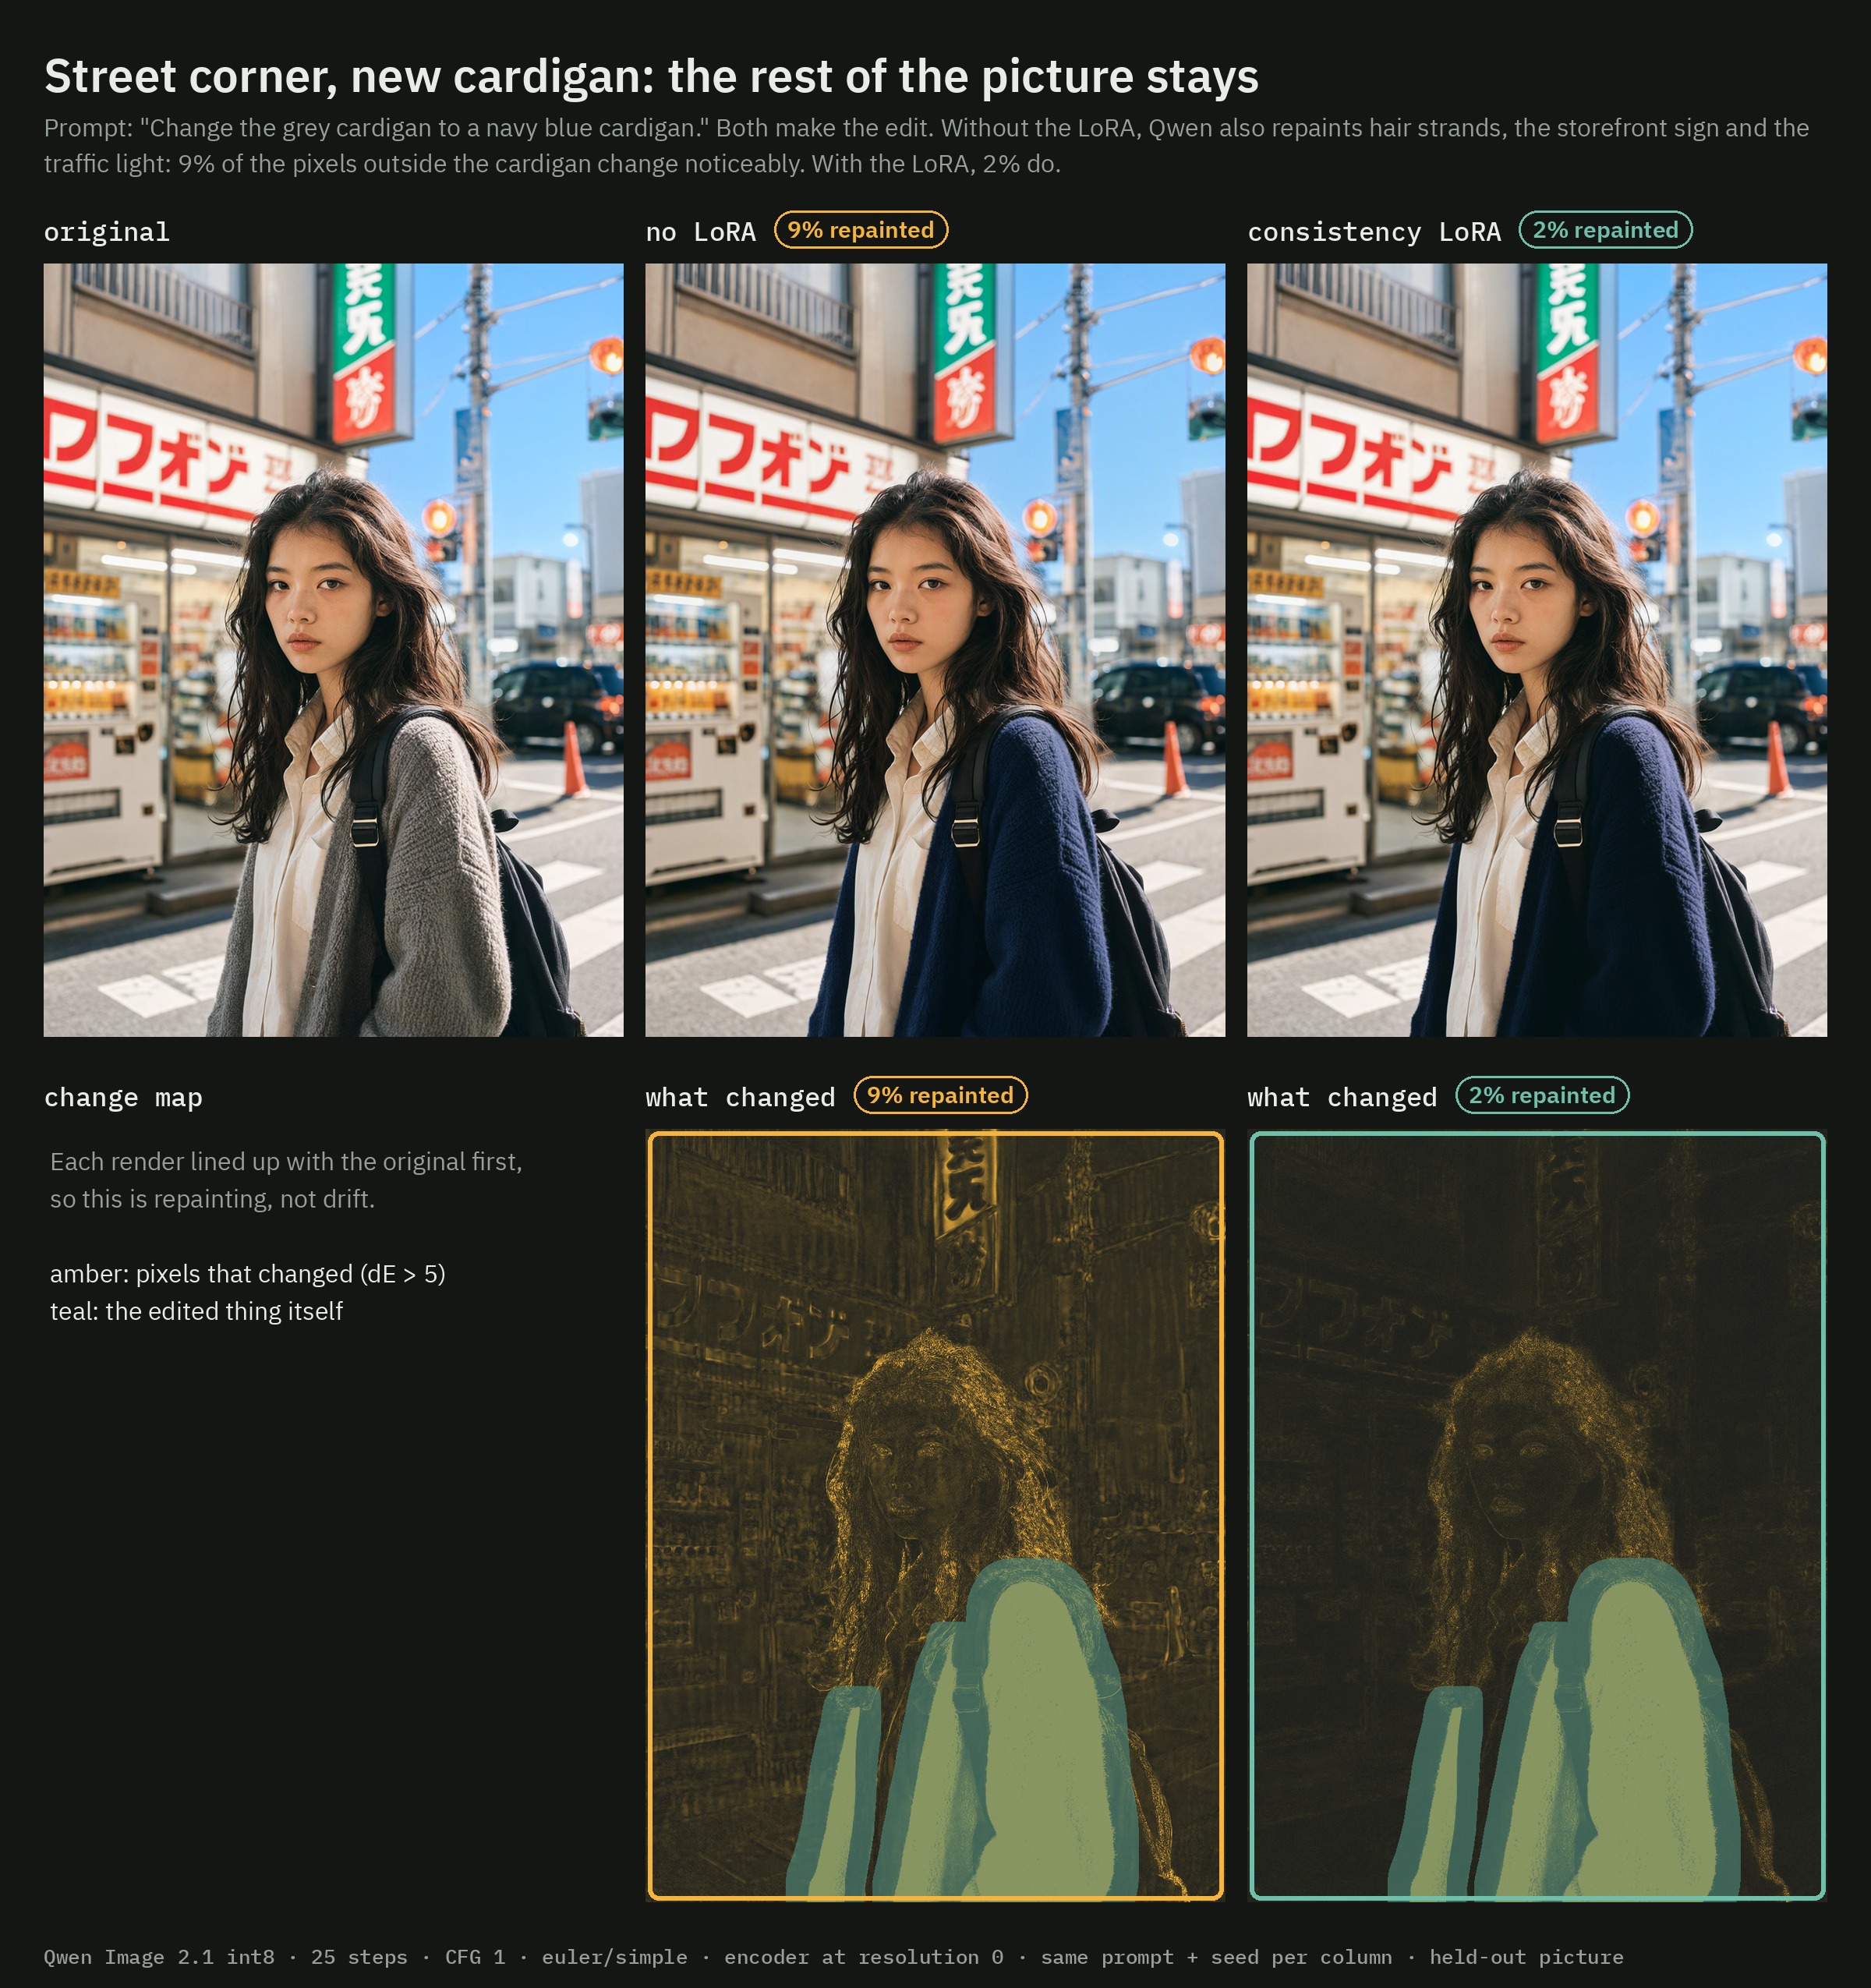
| 編集対象の外側 | LoRA なし | step 1500 | step 2000 |
|---|---|---|---|
| 目立って変化したピクセル | 12.8 % | 7.5 % | 7.5 % |
| オリジナルに対する PSNR | 27.7 dB | 31.6 dB | 31.7 dB |
参考までに、Qwen-Image 2.1 VAE だけで画像をエンコード・デコードすると、37 dB で約 2 % のピクセルが変化します。これが下限値です。編集自体は、LoRA の有無にかかわらず 18 件すべてで行われています。
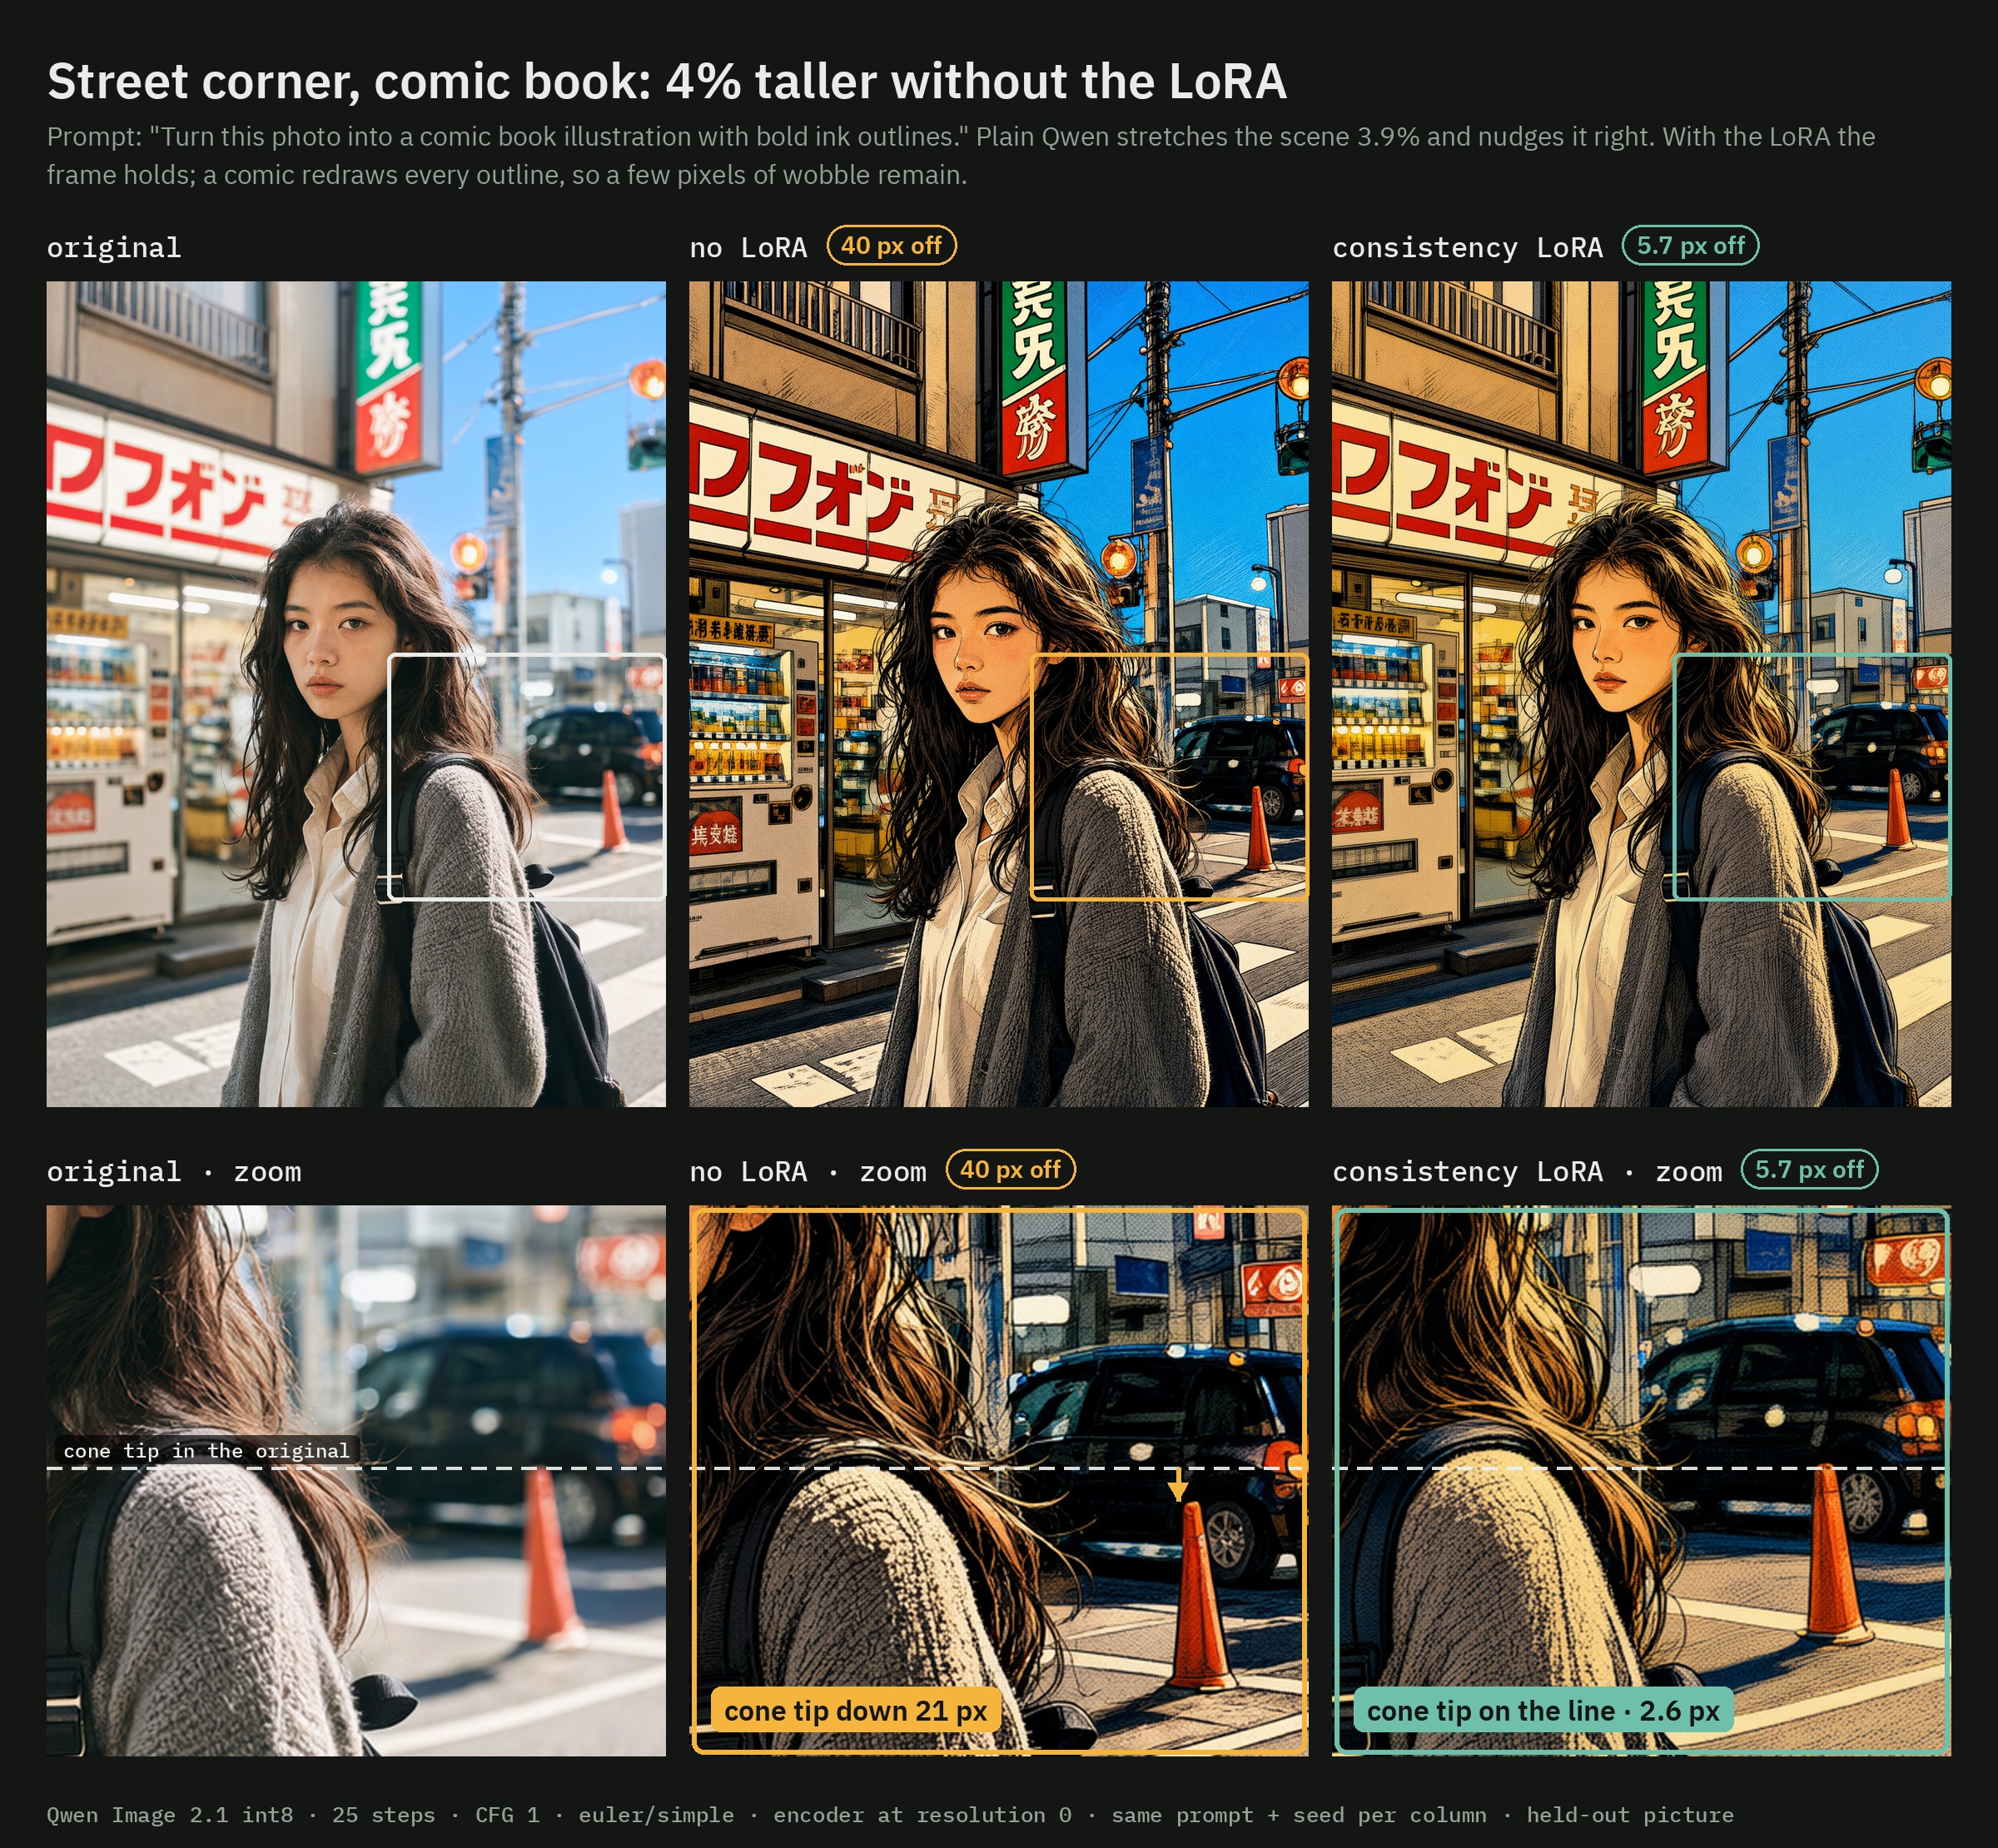
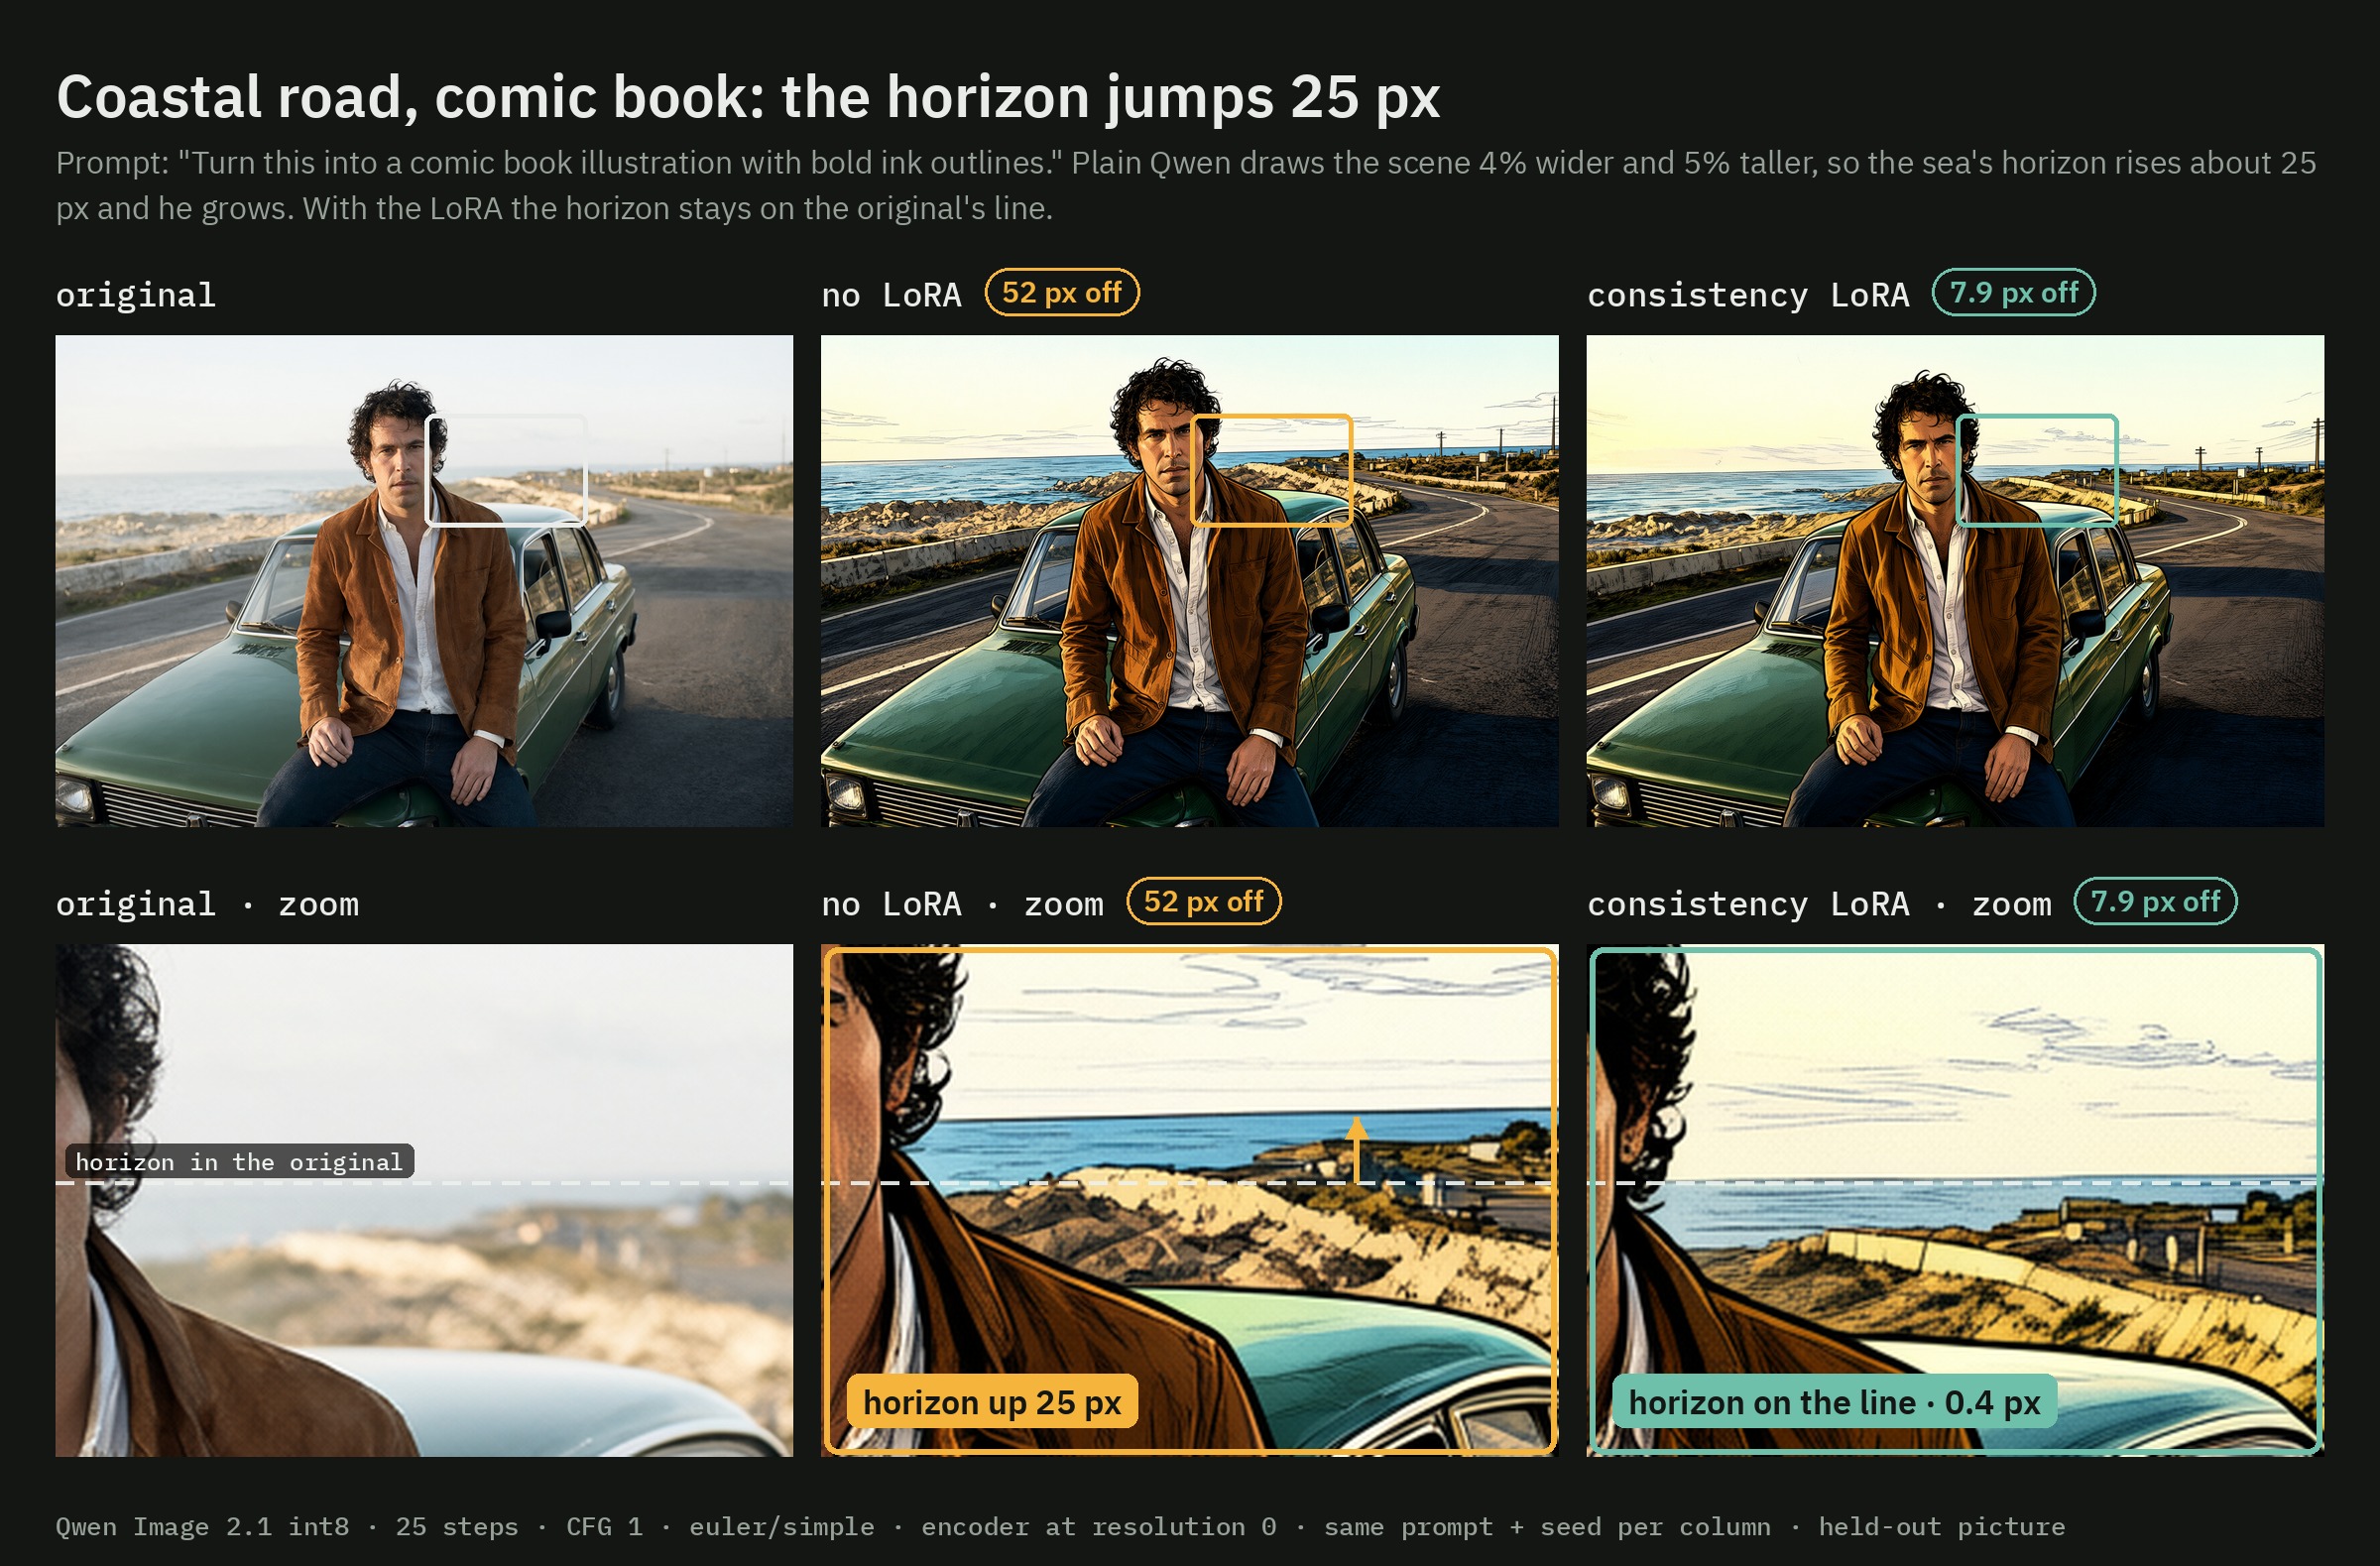
同じ編集を LoRA ありとなしで並べて実行した比較です。モデルカードより。
step 1500 か step 2000 か
| ファイル | 備考 |
|---|---|
qwen-image-2.1-consistency.safetensors | step 1500。推奨の出発点です。Qwen 本来の見た目を維持します。 |
qwen-image-2.1-consistency-2000.safetensors | step 2000。最も正確に整列しますが、絵画は少し淡くなります。 |
どちらも rank 32 で、ComfyUI のキー命名(diffusion_model.transformer_blocks.*)を使用しており、384 個のテンソルすべてが Comfy-Org の Qwen-Image 2.1 重みにロードされます。
ComfyUI での実行方法
このアダプターはモデル専用の LoRA なので、カスタムノードは不要です。任意の Qwen-Image 2.1 編集グラフに追加するには:
.safetensorsファイルをComfyUI/models/loras/に置き、モデルローダーの直後に LoraLoaderModelOnly ノードを strength 1.0 で追加します。strength を下げるとドリフトが一部戻ります。- Text Encode Qwen Image 2.1 ノードを使い、
image_1に画像を、resolutionを 0 に、prompt に編集指示を設定します。 - エンコーダーの
latent出力を Kサンプラー でサンプリングします。25 steps、CFG 1、eulerとsimple、denoise 1 です。これ以外のサイズの潜在を使用すると、Qwen はサイズ比の分だけズームしてしまい、どの LoRA でも元に戻せません。 - Qwen-Image 2.1 の VAE は RGBA をデコードするため、VAEデコード でデコードし、続いて Split Image with Alpha を使用します。
これらの数値は、このパックの Qwen-Image 2.1 Edit サンプルグラフから得られたものです。リポジトリには 2 つの既成ワークフローが同梱されています:
2 つ目のワークフローは LoRA をオフにし、代わりに Realign to Source ノードを使って、完了した編集をオリジナルに位置合わせし直します。何かを移動させる必要がある編集にはこちらが適しています。どちらも作者の ComfyUI-AusBoss ノードで構築されていますが、カードには同等のノードでも問題ないと記されています。
トレーニング方法
データセットは実際の Qwen-Image 2.1 編集から構築されており、ドリフトを測定して各ターゲットから取り除くことで、すべてのトレーニング例がソースのフレーム上に収まるようになっています:
- 257 枚の画像から作られた 950 の編集ペア: このデータセット用に Qwen-Image 2.1 でレンダリングした 110 枚のポートレート、133 枚の Unsplash 写真、作者の参照フォルダーから厳選した 14 枚の画像。
- ペアの種類: 順方向ペア(画像から編集へ)、逆方向ペア(編集から画像へ)、および編集対象の外側ではオリジナルのピクセルを保持するローカル編集。
- トレーニング: Comfy-Org INT8 ConvRot ベースで
arch: qwen_image_2を指定して ostris/ai-toolkit を使用し、参照はターゲットのサイズに保ちました。Rank 32、alpha 32、AdamW8bit で lr 1e-4、バッチ 1、shifttimesteps、ターゲット解像度 1408。H100 1 台で 3,000 ステップを実行し、1 ステップあたり約 1.9 秒、250 ステップごとにチェックポイントを保存しました。
制限事項
カードは、このリリースの適用範囲がどれほど狭いかを率直に述べています。9 月 28 日の更新で作者は、データセットが特定の種類の編集に対して LoRA を過適合させた可能性があり、新しいポーズや頭の向きなど実際の動きを必要とする要求を無視することがあると書いています。新しいデータセットがまとまり次第 v2 が計画されており、それまではそうした編集にはリアラインワークフローが推奨の方法です。
その他に明記されている制限:
- 4 ステップや 8 ステップの turbo LoRA、2 MP、CFG 1 超ではまだテストされていません。
- コミックやアニメのリスタイルではすべての輪郭が描き直されるため、一部の形はそれ自体で数ピクセルずれることがあります。step 1500 での最悪のリスタイルでは、コーナーが 12.9 px ずれていました。
- これは画像を所定の位置に保つものです。弱い編集を強くするものではありません。素の Qwen がその編集をまったく行わない場合、LoRA でもそれは変わりません。
入手方法
- LoRA の重み: ausboss/Qwen-Image 2.1 Consistency LoRA
- ベースモデルの再パッケージ: Comfy-Org/Qwen-Image-2.1
- 作者のノードパック: ausboss/ComfyUI-AusBoss
コメント
GitHubでサインインしてディスカッションに参加しましょう。