Turbo8: Qwen-Image 2.1向け8ステップ蒸留LoRA
Turbo8はQwen-Image 2.1をCFGなしの8ステップに蒸留し、テキストから画像生成、編集、RGBA出力、被写体抽出をカバーします。すぐに使えるComfyUIワークフローも2つ付属します。
Qwen-Image 2.1は2026年9月20日のリリース以降、いくつかの少ステップ化アプローチを集めてきました。Prunaの5ステップおよび8ステップLoRA、Viggleのturbo LoRA、そしてAlibaba PAI公式の4ステップFun Acc蒸留です。Turbo8は同じ競争におけるコミュニティからの提案であり、その際立った特徴はカバレッジの広さにあります。テキストから画像生成だけを高速化するのではなく、RGBAや複数参照の編集パスを含むベースモデル全体の挙動を維持するようトレーニングされており、これらのパスは以前のアダプターではうまく扱えていませんでした。
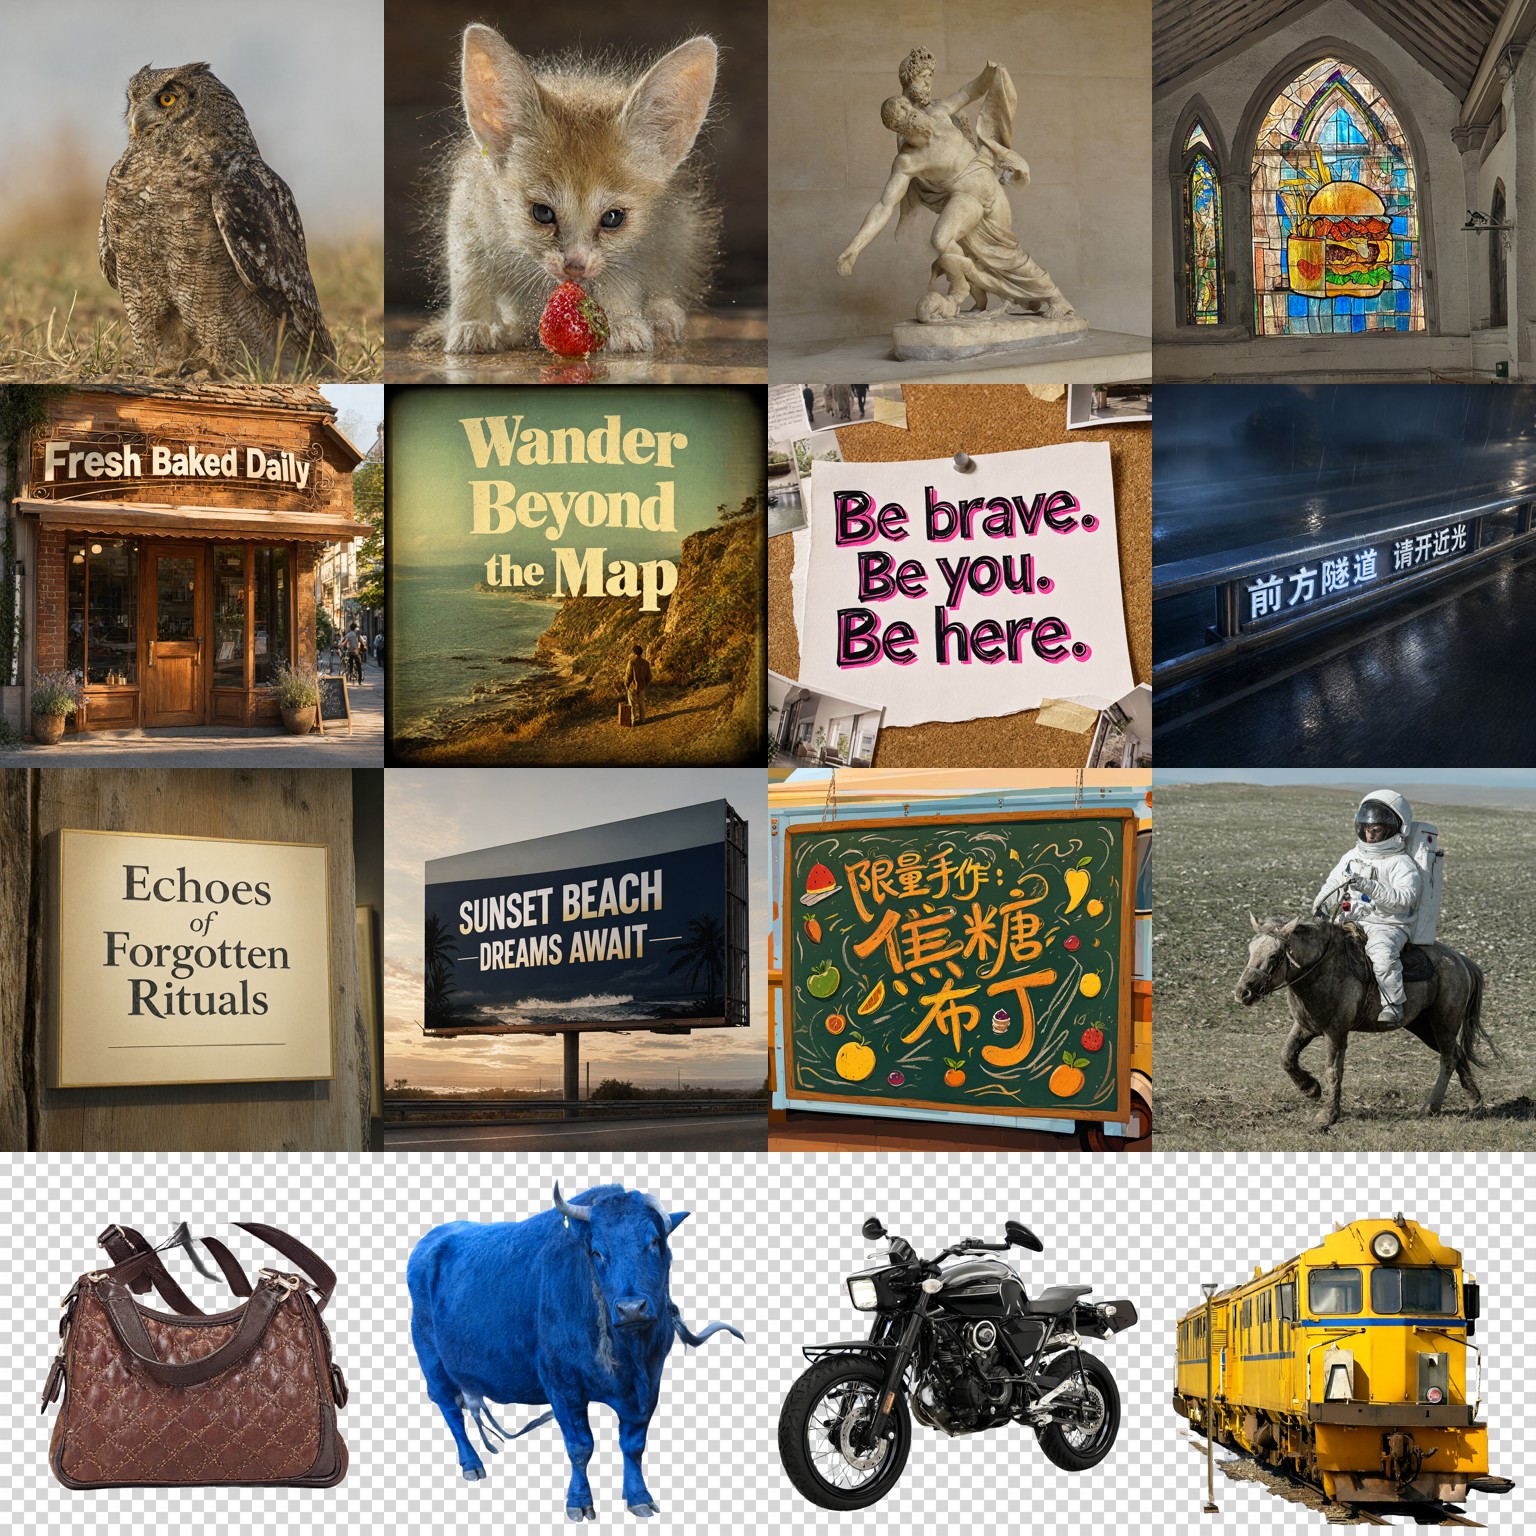
すべてのサンプルはTurbo8を8ステップ・CFG 1・1024²・最初のシードで使用し、プロンプトごとの選別は行っていません。プロンプトはホールドアウト評価セットから表示用に選ばれたものです。出典: Turbo8-LoRA-Qwen-Image-2.1。
できること
このアダプターはQwen-Image 2.1のアテンション、MLP、モジュレーション、タイムステップ埋め込みレイヤーに対するrank-128 LoRAで、ベースの重みを変更しないまま蒸留されています。推論時は**8ステップ、CFG 1、サンプラーeuler、スケジューラーsimple**で動作し、作者は8ステップを超えたりCFG 1を上回ったりしても結果は改善しないと述べています。
狙いは単一タスクではなくカバレッジです。モデル本来の2Kまでのテキストから画像生成、英語と中国語のテキストレンダリング、最大10枚の参照画像を使った指示編集、透明生成、そして被写体抽出(写真を渡してRGBAの切り抜きを要求する)に対応します。モデルカードにはトレーニング手法も記載されており、それは3段階のレシピです。まず生徒モデルの8つのノイズレベルで記録した3,100件の固定ノイズ40ステップ教師レンダリング、次に3,000ステップの軌道回帰、そしてfake-score criticとGANヘッドを用いた2,500ステップのDMD2分布マッチングです。criticは同じ凍結transformer上の2つ目のLoRAです。
ComfyUIでの実行
Turbo8はComfyUIネイティブのQwen-Image 2.1サポートを直接対象としています。
turbo8_lora_step2500.safetensorsをComfyUI/models/loras/に配置します。comfyui/turbo8_t2i.json(テキストから画像生成とRGBA)またはcomfyui/turbo8_edit.json(編集と抽出)を読み込みます。- **steps 8、CFG 1、サンプラー
euler、スケジューラーsimple**を維持します。
T2IグラフにはModelSamplingFluxノード(max_shift 0.6935、base_shift 0.5)が含まれ、幅と高さに接続されています。これにより、LoRAの蒸留時に使用された解像度依存のノイズスケジュールが、2Kでも再現されます。モデルカードによると、227個のLoRAレイヤーすべてがComfyUI上でマッピングされ、1024²の画像はRTX PRO 6000で約4秒かかります。
教師モデルとの比較
モデルカードでは、Turbo8を自身の教師モデルである40ステップのベースモデルと、192件のホールドアウトプロンプト(DrawBenchと追加シード、テキストレンダリング用プロンプト、RGBA被写体、OmniEditの編集と抽出)で評価しています。
| 指標 | 教師モデル(40ステップ) | Turbo8(8ステップ) |
|---|---|---|
| PickScore、T2I | 22.15 | 21.94 |
| CLIPScore、T2I | 26.89 | 26.89 |
| PickScore、RGBA | 20.51 | 20.07 |
| テキスト完全一致(OCR) | 95.0% | 75.0% |
| テキスト文字精度 | 99.6% | 95.3% |
| 透明率(RGBA + 抽出) | 0.875 | 0.925 |
| シード多様性(低いほど多様) | 0.705 | 0.670 |
| 教師モデルとの編集類似度(DINOv2) | n/a | 0.967 |
| 教師モデルに対する抽出アルファIoU | n/a | 0.85 |
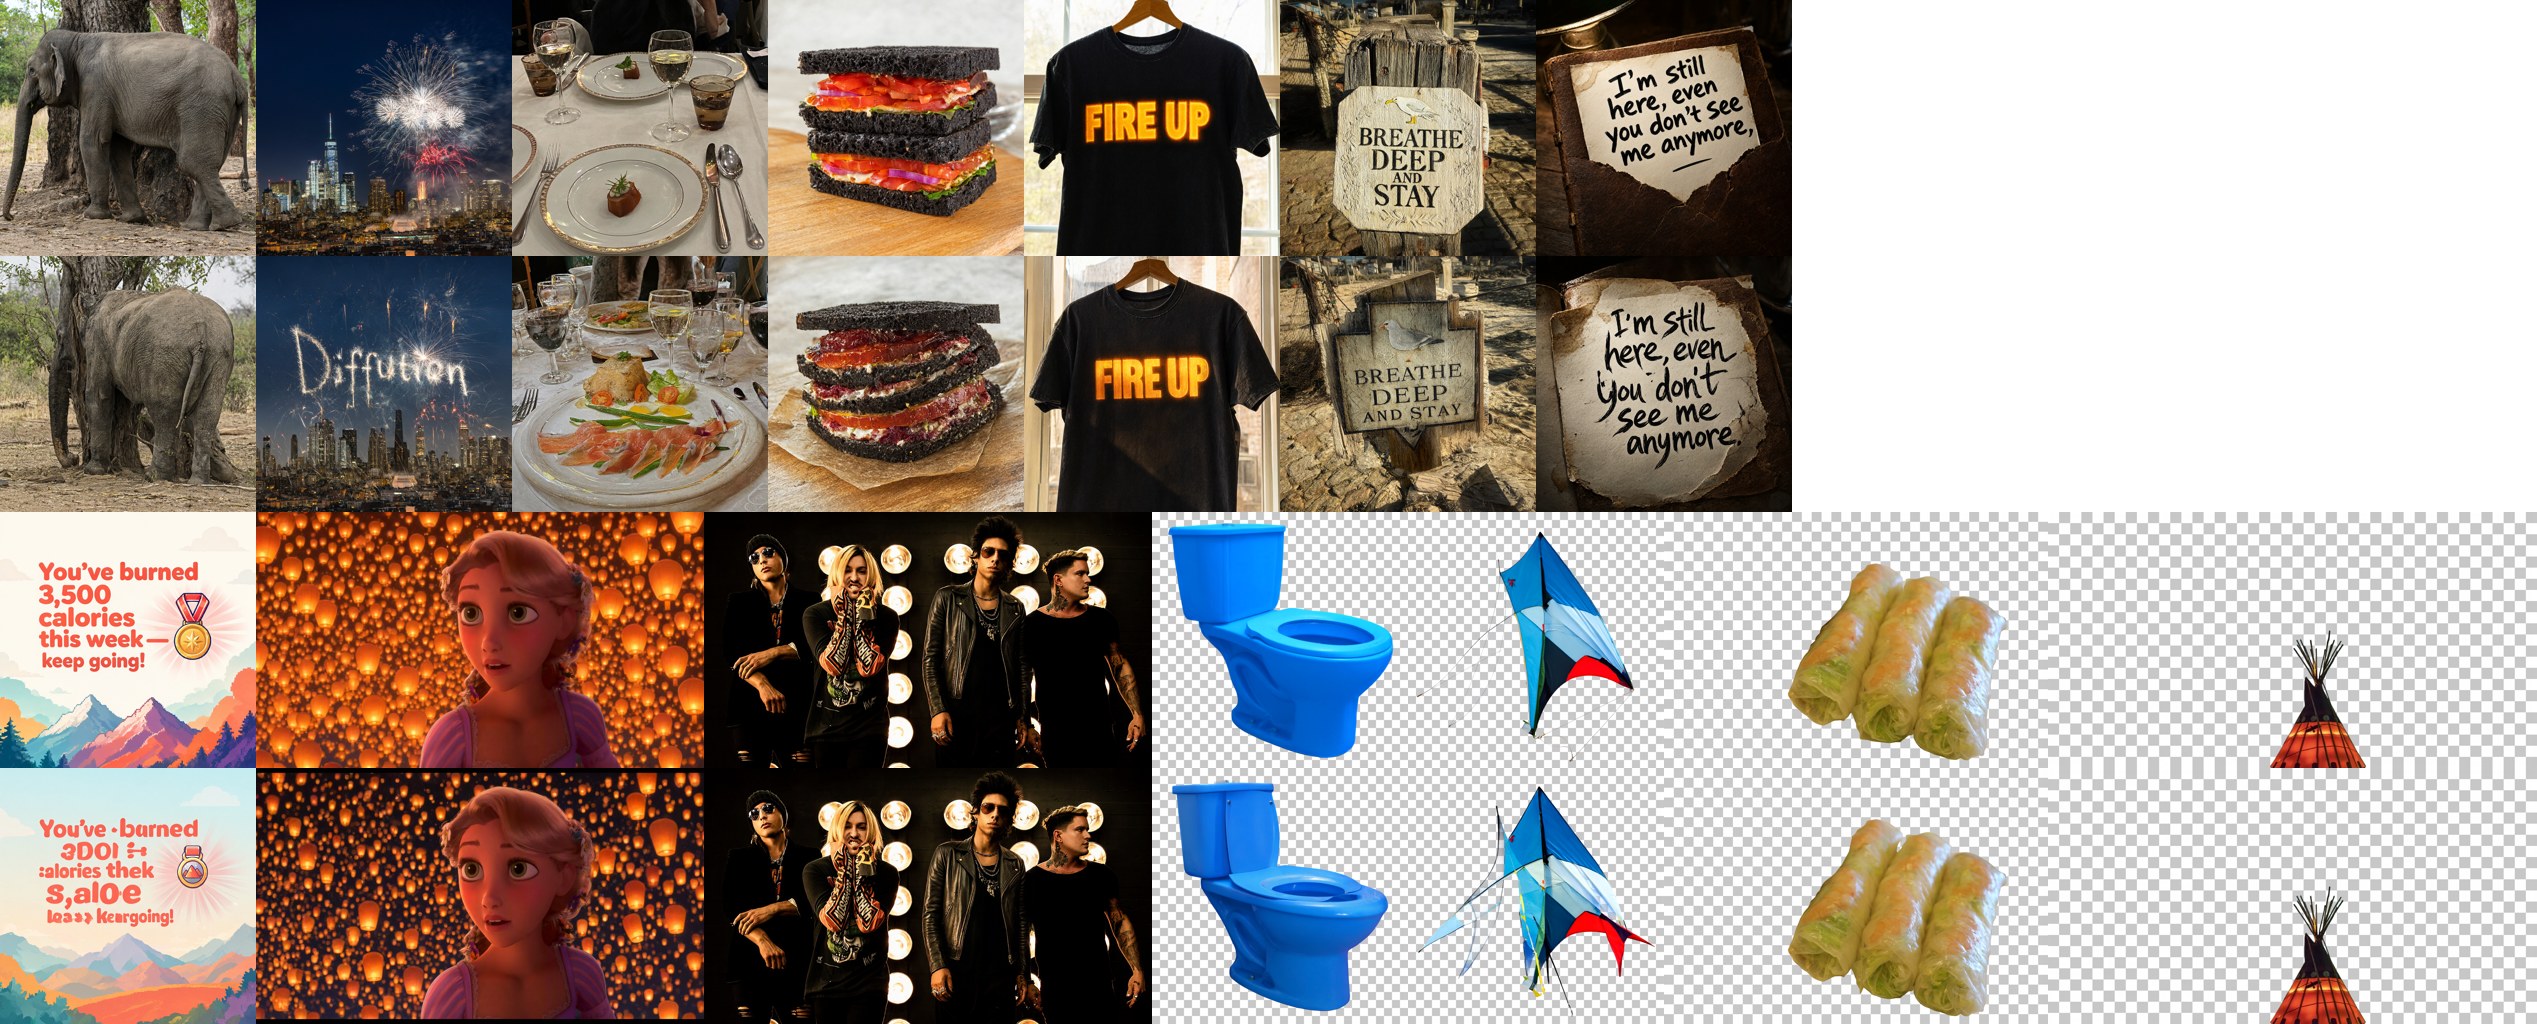
40ステップの教師モデル(各ペアの上段)と8ステップのTurbo8(下段)、同一シード。サンプルはテキストから画像生成、テキストレンダリング、編集、RGBA、抽出をカバーしています。
文書化されている制限
モデルカードでは、これらのギャップを利用者が発見する前に明示しています。
- 密なテキストや長いテキスト(段落、小さな文字)は40ステップの場合よりはるかに劣化しますが、短い見出し、看板、ラベルは引き続き信頼できます。
- 一部の込み入ったシーンでは、同一シードでも構図が教師モデルと異なることがあります。
- 抽出はベースモデルの失敗ケースを引き継ぎます。評価では16件の抽出のうち3件が教師モデルとTurbo8の両方で空になり、Turbo8は切り抜きに周囲のコンテキストをより多く残すことがあります。
コミュニティでの評価
Banodocoの#qwen-imageチャンネルでは、その後の数日間にユーザーがTurbo8を以前の少ステップ化アプローチと比較検証しました。共通の知見は、編集で性能を維持するには強度を下げ、8ステップより多くする必要があるというものでした。報告は、身体の破綻が現れる前に強度0.65、約16ステップに落ち着き、複数のユーザーが編集用途では6ステップのViggle turboより優れていると評価しつつ、一部の作業では依然としてPrunaの8ステップスケジュールを好んでいました。
コメント
GitHubでサインインしてディスカッションに参加しましょう。