LongLive-Plug: NVIDIAがH3とWan向けのFew-Step LoRAを蒸留
NVIDIAのLongLive-Plugは、few-step、CFG、long-contextのLoRAをバックボーンごとに一度蒸留し、54の下流モデルで再利用します。MiniMax H3とWan向けの重みも公開されています。
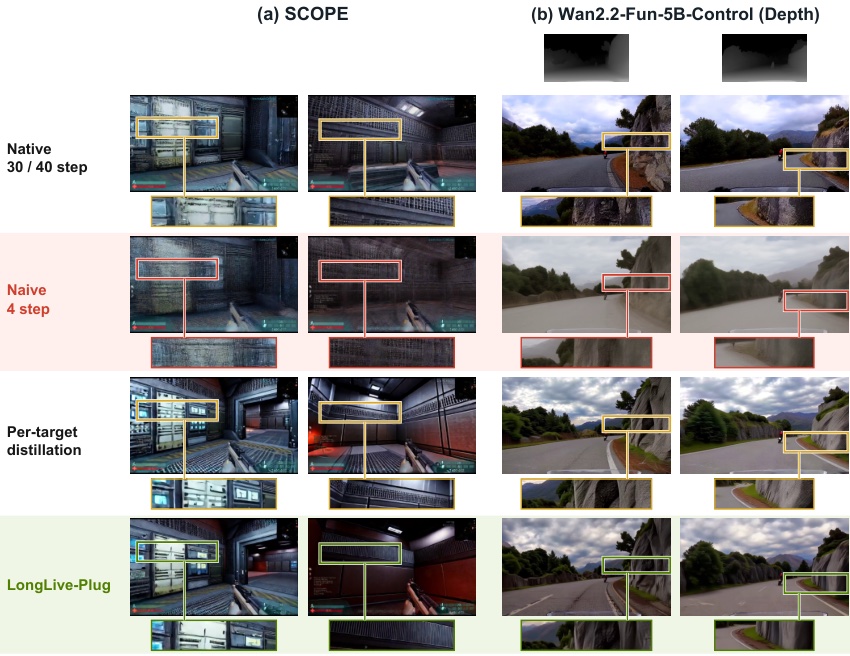
論文のFigure 3からの対応フレーム。単純な4ステップサンプリング(2列目)ではフレームがぼやけますが、転送されたアダプタ(4列目)は4ステップでも維持されます。ボックスは各手法で同一の座標を示しています。
一度の蒸留で、多くの下流モデル
特殊な動画モデルの構築は、サンプリングステップを削減したり、長いロールアウトを維持したりするために、蒸留段階で終わることがよくあります。その段階は通常、モデルごとに繰り返されます。タスクデータを収集し、teacherを実行し、再び最適化するという流れです。depth条件付きのWanファインチューニングと、同じバックボーンでトレーニングされたロボティクス世界モデルは、それぞれ独自のfew-step LoRAを必要としました。
LongLive-Plugはその作業を3つの機能に分割し、バックボーンファミリーごとに一度蒸留したうえで、通常のLoRAとして持ち越します。
- Few-step LoRA: サンプリングステップを削減。分布マッチングとCFGガイド付きteacherでトレーニング。
- CFG LoRA: classifier-freeガイダンスを単一の条件付きフォワードパスに折り込みます。
- Long-context LoRA: 因果的自己回帰ロールアウトにおけるエラーの蓄積を補正します。
これらのアダプタは、下流モデルが加える変更に耐えられるよう設計されています。条件付けブランチの追加や出力チャネルの拡張によって無効になることはないため、同じファイルセットを完全なファインチューニング、タスクLoRA、追加の制御モジュールを備えたモデルに適用できます。
CFGの重みはダイヤルのように機能する
ガイダンスは通常、ステップごとに2回のコストがかかります。条件付きパスが1回、無条件パスが1回です。CFG LoRAは2回目のパスを不要にし、ガイダンスがアダプタに蒸留されているため、アダプタが1つの固定スケールでトレーニングされていても、LoRAの重み自体 がガイダンス制御になります。これを上げると、無条件ブランチを再実行することなくプロンプトの属性が強化されます。
重要な点は、結合されたLoRA全体をスケーリングしても同じ効果は得られないことです。更新とステップ数を同時に動かしてしまい、出力が劣化します。そのためfew-stepとCFGのアダプタは別ファイルであり、別々に重み付けされます。論文の推奨比率は few-step : CFG = 1 : 0.5 であり、モデルカードでも、これらの数値はアダプタの重みであり、モデル本来のCFGスケールではないことが繰り返されています。
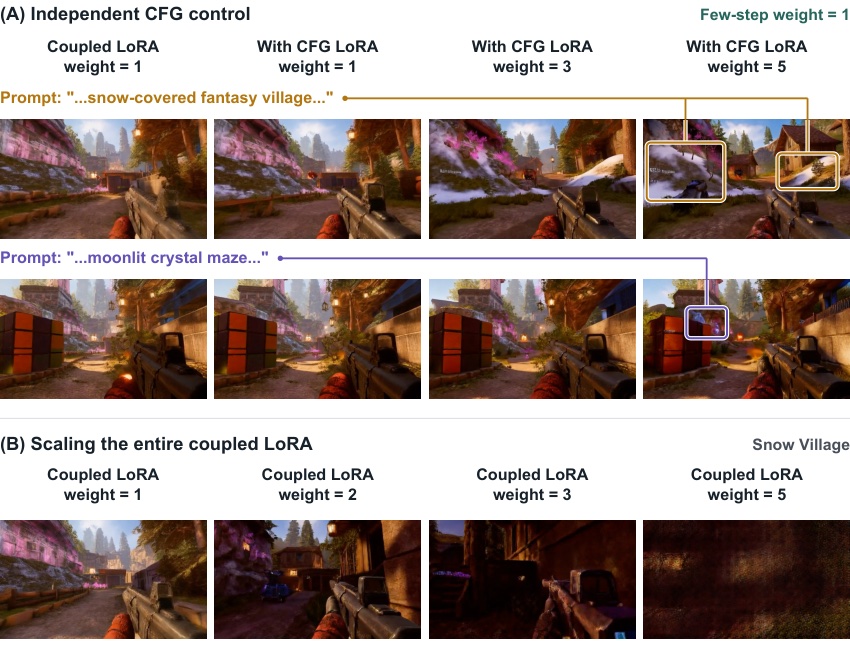
論文のFigure 5。結合されたLoRAだけをスケーリングしてもプロンプトにほとんど反応しませんが、別々に重み付けしたCFG LoRAを追加すると、結合LoRAを固定したまま、ボックスで示した属性が強化されます。
公開されたもの
Hugging Faceコレクションには6つのアダプタが含まれ、バックボーンごとに1つのfew-stepファイルと1つのCFGファイルがあります。
| ベースモデル | Few-stepアダプタ | CFGアダプタ | 備考 |
|---|---|---|---|
| MiniMax H3 | LongLive-Plug-MiniMax-H3-few-step (2.6 GB) | LongLive-Plug-MiniMax-H3-cfg (2.6 GB) | PEFT形式。カードでは、現時点では2つを別々に使用することが推奨されており、併用はまだ推奨されていません |
| Wan2.1-T2V-14B | LongLive-Plug-Wan2.1-T2V-14B-few-step (1.2 GB) | LongLive-Plug-Wan2.1-T2V-14B-cfg | PEFTエクスポートとともに generator_lora_lightx2v.safetensors を同梱 |
| Wan2.2-TI2V-5B | LongLive-Plug-Wan2.2-TI2V-5B-few-step (1.3 GB) | LongLive-Plug-Wan2.2-TI2V-5B-cfg | PEFTの adapter_model.safetensors |
Wan2.1-14Bのfew-stepファイルは、既存のWanワークフローにそのまま投入できるものです。ComfyUIのWan LoRAローダーがすでに読み取る lightx2v 命名でエクスポートされているため、他のWan高速化LoRAと同様に ComfyUI/models/loras/ に配置します。MiniMax H3のアダプタはPEFTエクスポートであり、ComfyUIが読み込む前に変換が必要です。Kijaiは変換済みのbf16バージョンを Kijai/MiniMax-H3-experimental に minimax_h3_ELM_longlive_plug_4step_lora_bf16.safetensors(1.96 GB)として公開しています。
カバレッジとコスト
論文では、3つのバックボーンファミリーにわたる54の下流モデル(Wan2.1-14Bで24、Wan2.2-TI2V-5Bで24、MiniMax H3で6)と8つのタスクカテゴリ(世界モデリング、ロボティクス、構造条件付き生成、カメラとトラジェクトリの制御、動画編集と復元、被写体とアバターの生成、音声とRGBAの生成、スタイル適応)におけるトレーニング不要のデプロイを検証しています。ネイティブの20〜50ステップのスケジュールと比較して、ベース蒸留アダプタを適用すると4ステップかつCFG不要の推論が可能になり、ノイズ除去ステップが5倍〜12.5倍削減されます。
コストの議論は論文のもう半分です。ベース蒸留は約 80 H100 GPU時間(32 GPUで700イテレーション、およそ2.5時間)です。代わりに4つの下流タスクを個別に蒸留すると、さらに83.9(depth)、150.0(世界モデリング)、86.8(pose)、56.1(ロボティクス)のGPU時間、合計で約 456.8 かかります。ベースアダプタを再利用する場合は固定の約80 GPU時間のままで、タスク固有のデータ収集も不要です。
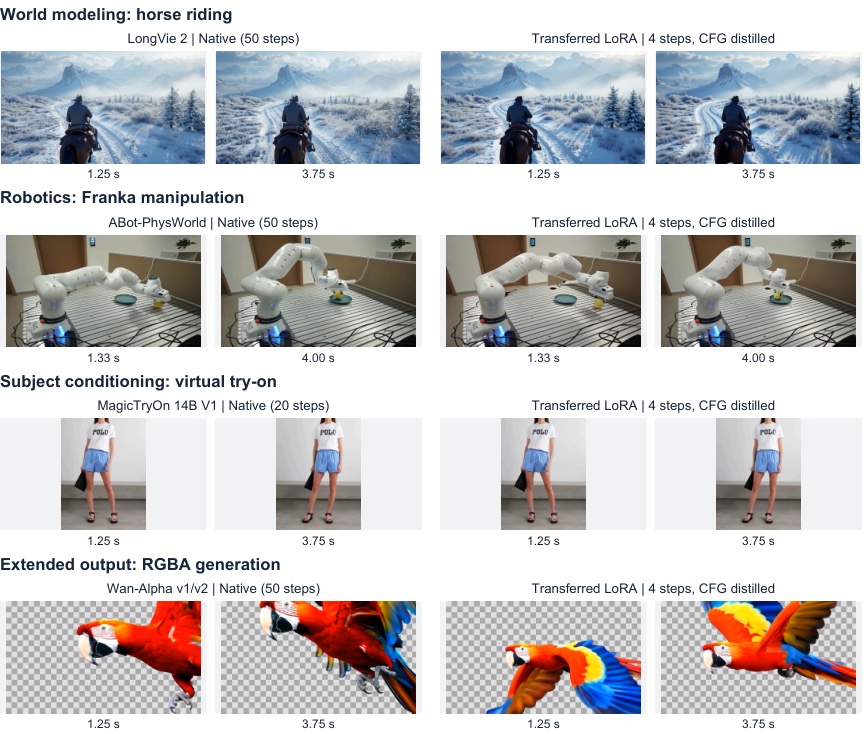
論文のFigure 9: LongVie 2、ABot-PhysWorld、MagicTryOn、Wan-Alpha。世界モデリング、ロボティクス、被写体の条件付け、RGBA出力をカバーし、それぞれ4ステップ転送後の同じタイムスタンプのネイティブフレーム2つと比較しています。
MiniMax H3
今回のリリースのH3側は最も範囲が狭いです。検証された54モデルのうち6つがH3であり、論文では、10件のH3比較は反復実行の信頼区間がない単一シードのケースであり、ネイティブのデフォルトはグラウンドトゥルースではなく参照動作点であり、静止フレームでは音声品質や同期を評価しないと述べています。例では、4ステップのH3が単純な4ステップEulerサンプリングよりもキャラクターの輪郭をよく保持する一方、外観は蒸留前のマルチステップ結果と依然として異なる可能性があることが示されています。
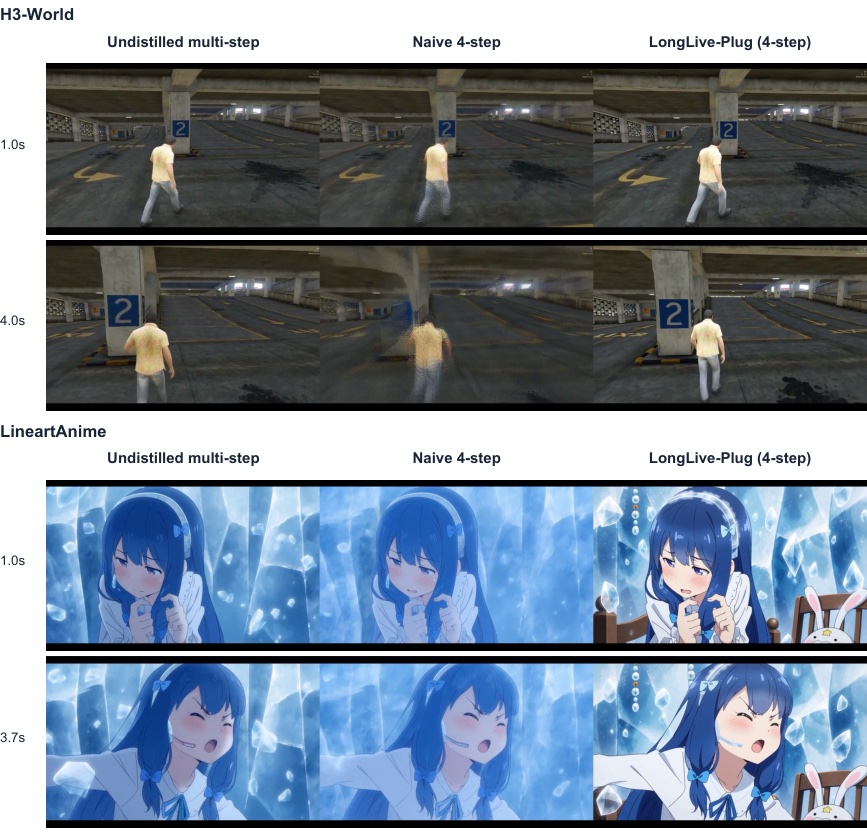
論文のFigure 11: 前進アクション条件でのH3-WorldとLineartAnime。蒸留前のマルチステップ推論、単純な4ステップサンプリング、LongLive-Plugによる4ステップ推論を比較しています。
制限
- 転送のアイデアは、蒸留対象のバックボーンで機能します。Wan2.1、Wan2.2、MiniMax H3はそれぞれ独自のアダプタセットを持ち、論文はファミリー間の再利用を主張していません。
- H3への効果は信頼区間のない10件の単一シードケースで測定されており、音声トラックは評価に含まれていません。
- MiniMax H3では、現時点では2つのアダプタを1つずつ使用する必要があるため、few-stepの速度とCFG制御を組み合わせることはまだできません。
- ガイダンス制御は新しいサンプラーではなく重みのダイヤルです。両方を得るには、few-stepとCFGのファイルを別々に読み込み、重み付けする必要があります。
利用可能性
プロジェクトページ: nvlabs.github.io/LongLive/LongLive-Plug
論文: arXiv 2609.38154
デモ動画: YouTube
重み: Efficient-Large-Model/longlive-plug
H3 few-stepアダプタのComfyUI変換: Kijai/MiniMax-H3-experimental
コメント
GitHubでサインインしてディスカッションに参加しましょう。