AcademiaSD LoRAlab: 9つのLoRAトレーナーを1つのランチャーに統合するComfyUI向けツール
AcademiaSD LoRAlab Trainer Studioは、Qwen-Image 2.1、FLUX.2 Klein、Krea 2、Z-Image、MiniMax-H3などのLoRAトレーナーを1つのランチャーにまとめたツールで、4 GBのVRAMから利用できます。
models/lorasフォルダーへのワンクリックエクスポートまで、同じWebインターフェースを備えています。
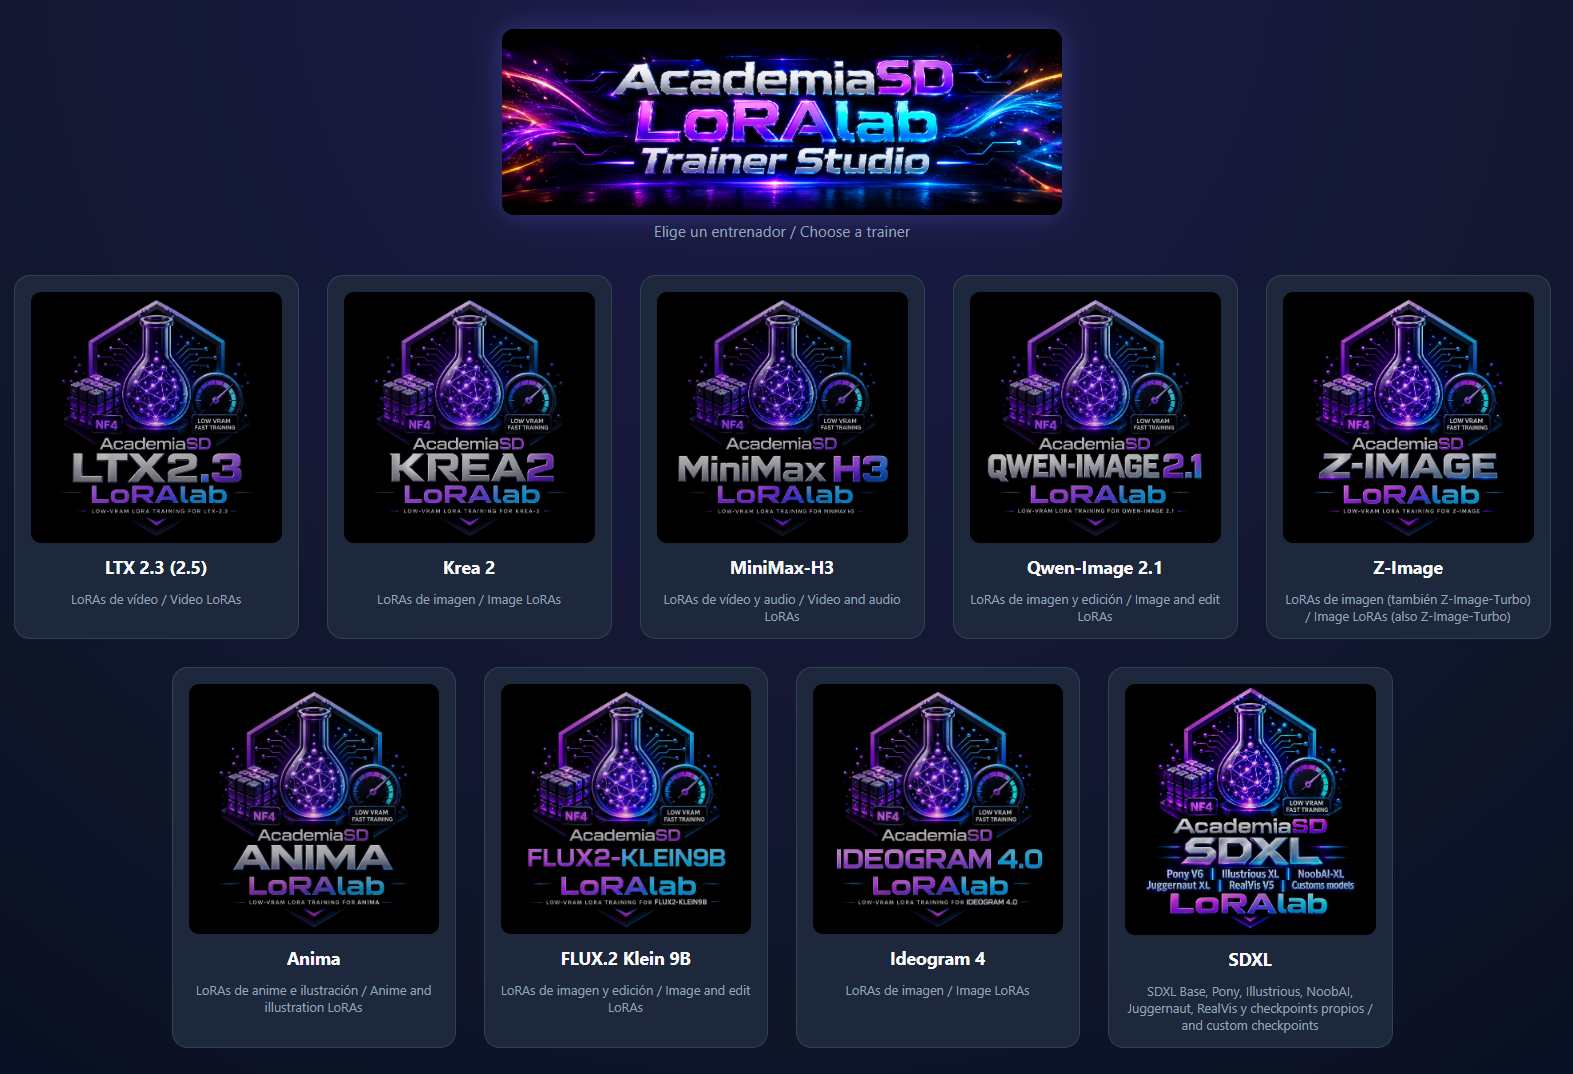
ランチャー: トレーナーを選ぶとブラウザーで開き、モデル、プロジェクト、設定は共有されたままになります。
トレーニング対象と必要なVRAM
| トレーナー | トレーニング対象 | 最低VRAM |
|---|---|---|
| Qwen-Image 2.1 | キャラクター、オブジェクト、スタイルのLoRA、さらに編集LoRA(前 → 後) | 8 GB |
| Krea 2 | Krea 2 RawおよびTurbo向けのキャラクター、オブジェクト、スタイルLoRA | 8 GB |
| Z-Image | Z-ImageおよびZ-Image-Turbo向けのキャラクター、オブジェクト、スタイルLoRA | 8 GB |
| Anima | アニメ・イラストのキャラクターおよびスタイルLoRA | 4 GB(NF4)/ 6 GB(BF16) |
| FLUX.2 Klein 9B | キャラクター、オブジェクト、スタイルのLoRA、さらに編集LoRA | 12 GB |
| Ideogram 4 | JSONキャプション付きのキャラクター、オブジェクト、スタイルLoRA | 12 GB |
| SDXL | SDXL Base、Pony、Illustrious、NoobAIなどのSDXLチェックポイント向けLoRA | 4 GB(NF4)/ 12 GB(BF16) |
| LTX-2.3(およびLTX-2.5) | LTX動画モデル向けのキャラクターおよびスタイルLoRA(画像からトレーニング) | 12 GB |
| MiniMax-H3 | 画像、クリップ、音声から作成する動画LoRA、さらにトレーニング不要のRefMods | 8 GB |
最低要件は、コンピュートケイパビリティ7.5以降のNVIDIA GPU(RTX 20xx / GTX 16xx以降)、CUDA 13用の580シリーズ以降のドライバー、そして16 GBのシステムRAMです。MiniMax-H3の動画クリップには、さらにPATH上にffmpegが必要です。GTX 10xxカードは対象外です。CUDA 13用のPyTorchはRTX 20xx世代から対応しています。
トレーナーごとに1つのインターフェース
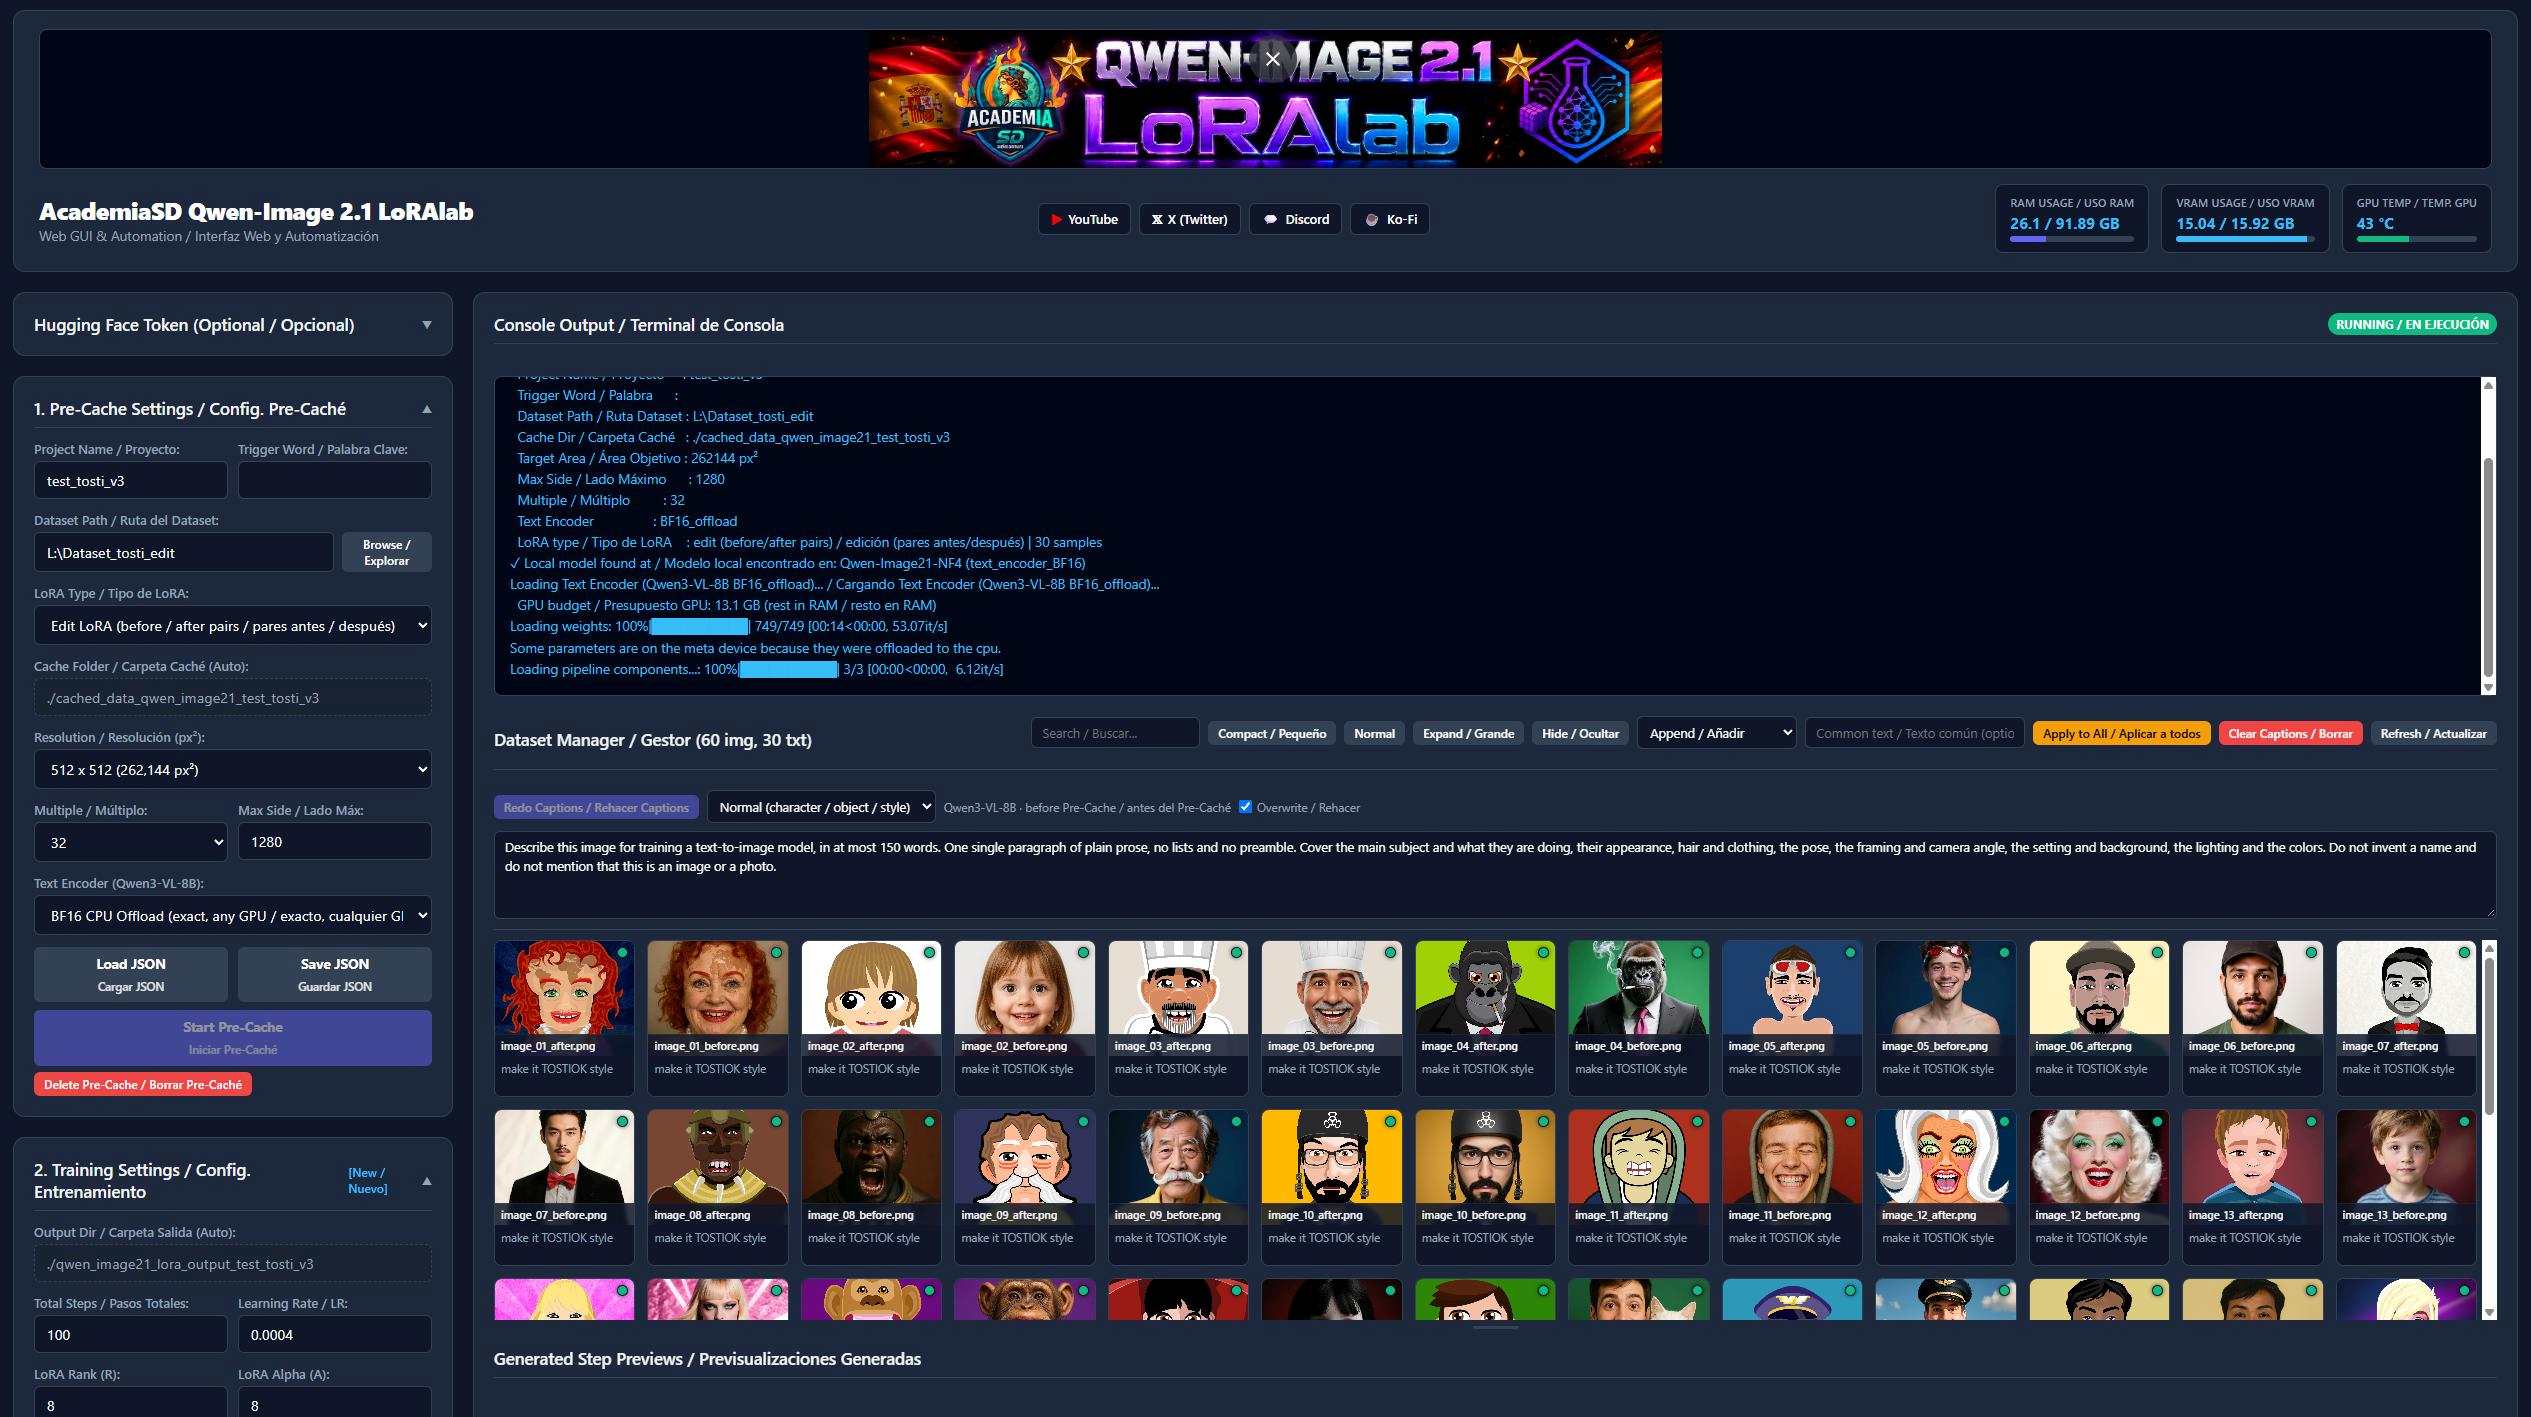
Qwen-Image 2.1トレーナー。9つのトレーナーはすべて同じパネルを共有しています。
すべてのトレーナーは同じ5つのステップに従います:
- プロジェクトとデータセット。 プロジェクトに名前を付け、任意でトリガーワードを追加し、データセットフォルダーを指定します。各画像には同じ名前の
.txtキャプションが必要で、画像はフォルダーまたは.zipとしてドラッグインできます。 - キャプション(任意)。 視覚言語モデルが、トリガーワードを先頭にして各画像のキャプションを書き込みます。プロンプトは編集可能で、上書きしない限り既存のキャプションは保持されます。
- 事前キャッシュ。 テキストエンコーダーとVAEが、選択した解像度で1回だけ実行され、その出力はディスクに保存されます。再実行時には変更のない画像がスキップされ、その後はGPUの100%がトレーニングに使われます。
- トレーニング。 ステップ数、学習率、rank、アルファを設定して開始します。設定は実行中にも変更でき、次のステップで適用されます。また、Stop Trainingは正確なステップを保存するため、数日後に再開してもステップを失いません。
- エクスポート。
Send to Modelsは、LoRAをComfyUI(またはForge / A1111)のmodels/lorasフォルダーにコピーします。このフォルダーはスタジオがトレーナー間で記憶します。ステップのチェックポイントはブラウザーからダウンロードすることもでき、エクスポートされたLoRAにはCivitaiやLoRAマネージャーが読み取るkohya形式のメタデータが付属します。
スタジオは同じネットワーク上の別のマシンからも使用できます。ランチャーにはユーザー名とパスワードによるリモートアクセスモードがあるため、トレーニングPCに触れることなく、ノートPCからデータセットをアップロードし、トレーニング済みのLoRAをダウンロードして戻せます。
トレーニング中も鮮明なプレビュー
これらのモデルの中には、サンプリングを注視する必要があるほど低速なものがあり、Qwen-Image 2.1、Krea 2、FLUX.2に対するComfyUIのデフォルトのLatent2RGBプレビューはブロック状の色になります。READMEが推奨する組み合わせは、kijaiのKJNodesと、ComfyUI/models/vae_approx/に配置するAcademiaSDの小型オートエンコーダーです: TAE-Qwen-Image-2.1、TAE-Krea-2、TAE_Flux2_AcademiaSD。これらをモデルとサンプラーの間にあるModel Preview Overrideノードに挿入します。
インストール
プラットフォームごとに1つのインストーラー、そしてすべてのトレーナーで共有される1つのvenv(CUDA 13.0上のPyTorch 2.14、GitHub版Diffusers、Transformers、PEFT、bitsandbytes、Flask):
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.gitWindowsではInstall_LoRAlab-TrainerStudio.batをダブルクリックします。Linuxではすべての.batに相当する.shがあり、ランチャーが適切な方を選択します。Install_Triton&SageAtten220.batは、必要であればTritonとSageAttention 2.2を追加します。更新はUpdate_LoRAlab-TrainerStudio.batの1つだけで、モデル、データセット、プロジェクト、設定は保持されます。このプロジェクトには、RunPodテンプレートとクラウドトレーニング用のDockerイメージも用意されています。
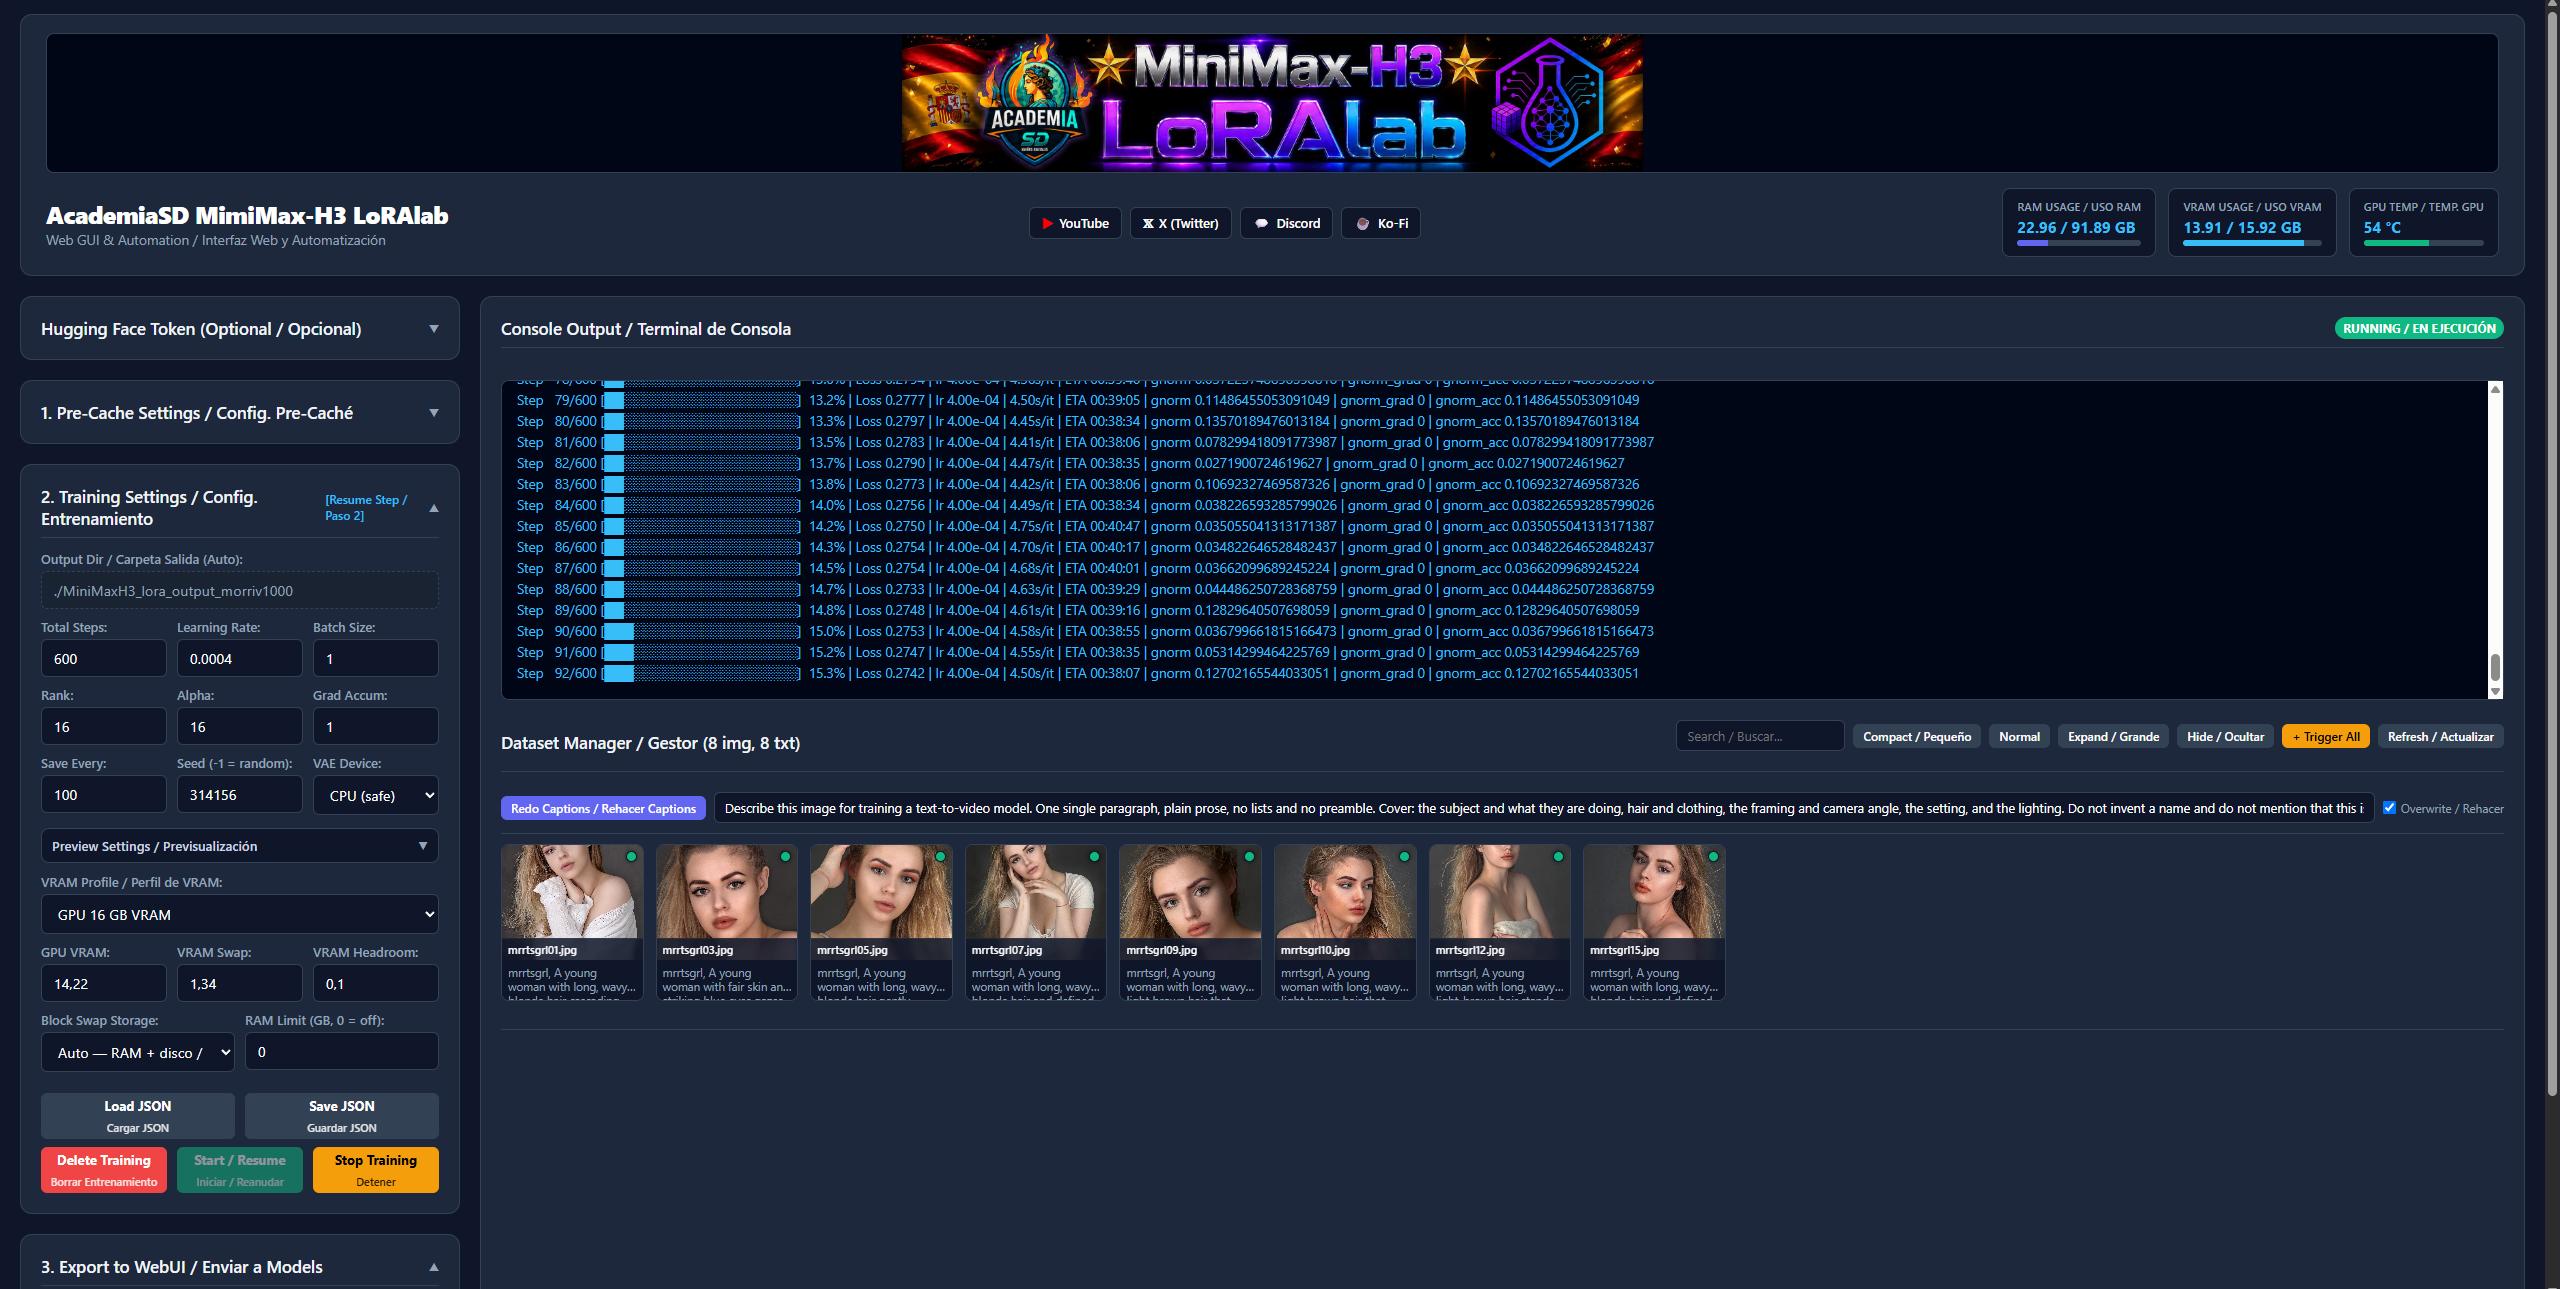
MiniMax-H3トレーナー。スタジオにある2つの動画トレーナーのうちの1つです。
作者はこのスタジオを初期段階の作品と位置付けています。トレーナーは矢継ぎ早に追加されたため、デフォルトのトレーニング設定とプレビュー設定がすべてのモデルに適しているとは限らず、不具合はIssuesで報告することが想定されています。
入手先
AcademiaSD LoRAlab Trainer Studioはgithub.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudioにあり、Hugging FaceにはAcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Trainingなどの量子化済みトレーニングパッケージが公開されています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。