Qwen-Image 2.1 Fun Acc LoRA:公式の4ステップ蒸留アダプター
Alibaba PAIがQwen-Image 2.1を346 MBのPDD LoRAで4ステップに蒸留。テキストから画像への生成と指示ベースの編集に対応し、独自のシグマスケジュールを備えます。
このアダプターは、Alibaba PAIが8月にMiniMax H3 PDD Acc LoRAで用いたのと同じ手順に従っています。強力なベースモデルを用意し、Parallel Decoding Distillation(PDD、arXiv 2607.26004)で蒸留し、抽出したLoRAと参照結果を再現するために必要な推論コードを公開するというものです。Qwen-Image 2.1自体は2026年9月20日にリリースされ、すでにComfyUIでサポートされているため、これは登場からわずか数日のモデルを高速化したバリアントとなります。
リポジトリに含まれるもの
| アダプター | models/Qwen-Image-2.1-Fun-Acc-4Step.safetensors、346 MB、rank 64、BF16でnetwork_alpha 64 |
| ベースモデル | Qwen-Image 2.1(Qwen/Qwen-Image-2.1)、重みは変更なし |
| ステップ数 | 4 NFE(pdd_num_steps: 4、pdd_block_size: 1) |
| タスク | テキストから画像への生成と指示ベースの画像編集 |
| 学習対象 | img_in、modulation.1、norm_out.linear、タイムステップ埋め込み、全32個のtransformerブロックのattn.to_q/to_k/to_v/to_out.0とimg_mlp、さらにtxt_in.in_layer / txt_in.out_layer |
| 推論専用の追加要素 | アテンションのnorm_q / norm_kとtxt_in.text_normは、LoRAペアではなく完全なパラメータとして保存 |
| デフォルトのサンプルサイズ | 2048 x 2048(pdd_sample_size) |
| サンプリング精度 | native_time_fp32_state |
シグマスケジュールは実装の詳細ではなく、リリースの一部です。pdd_config.jsonは4ステップのスケジュールを1.0, 0.9169867, 0.7861579, 0.549491, 0.0に固定しており、エクスポート形式はqwenimage21_extracted_prefused_v1です。これらの数値があるため、これは単純に差し替えるだけのLoRAではありません。デフォルトのシグマを使う汎用の4ステップサンプラーでは、蒸留された挙動を再現できません。
比較
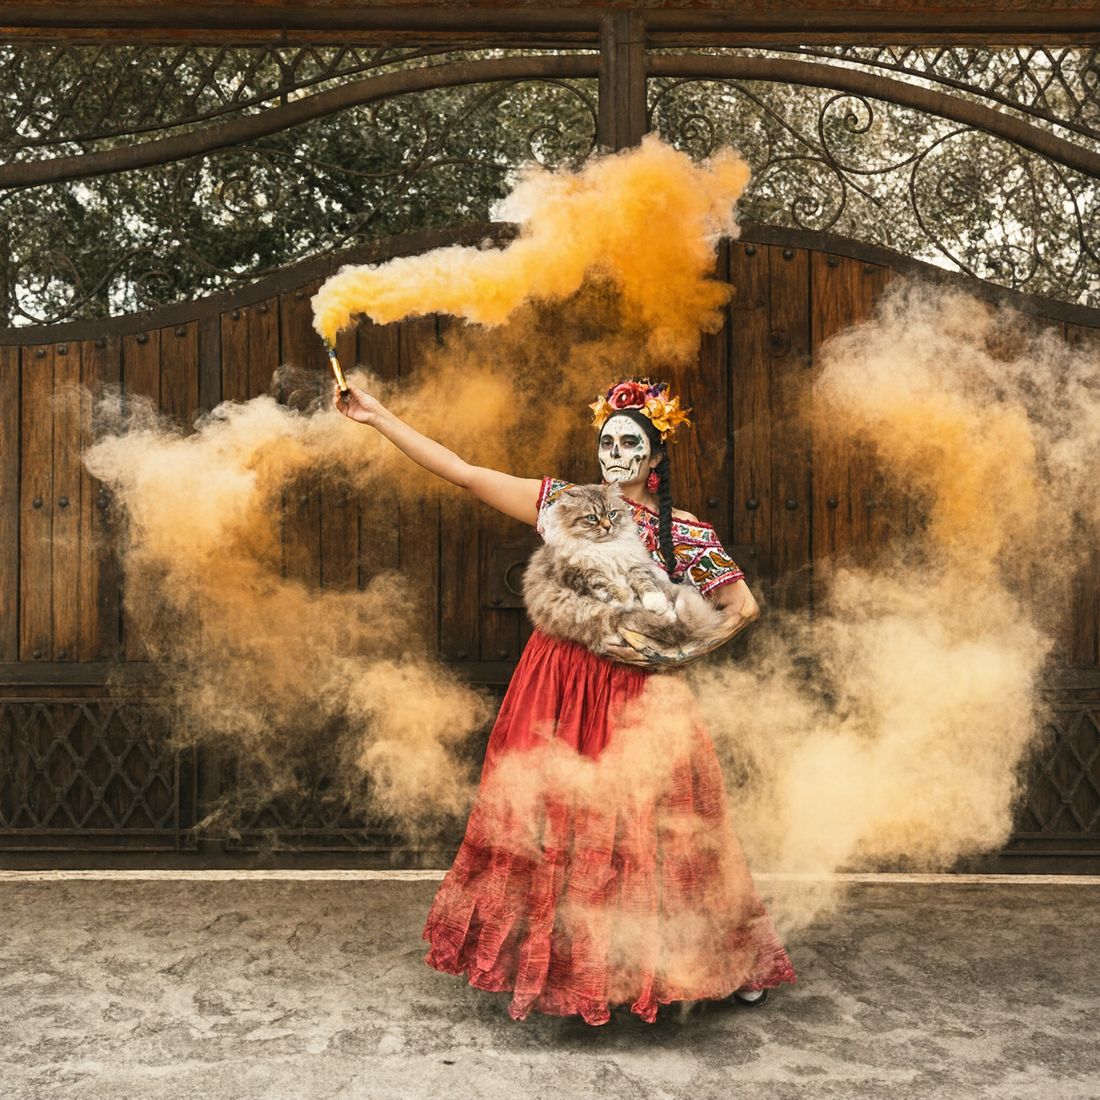
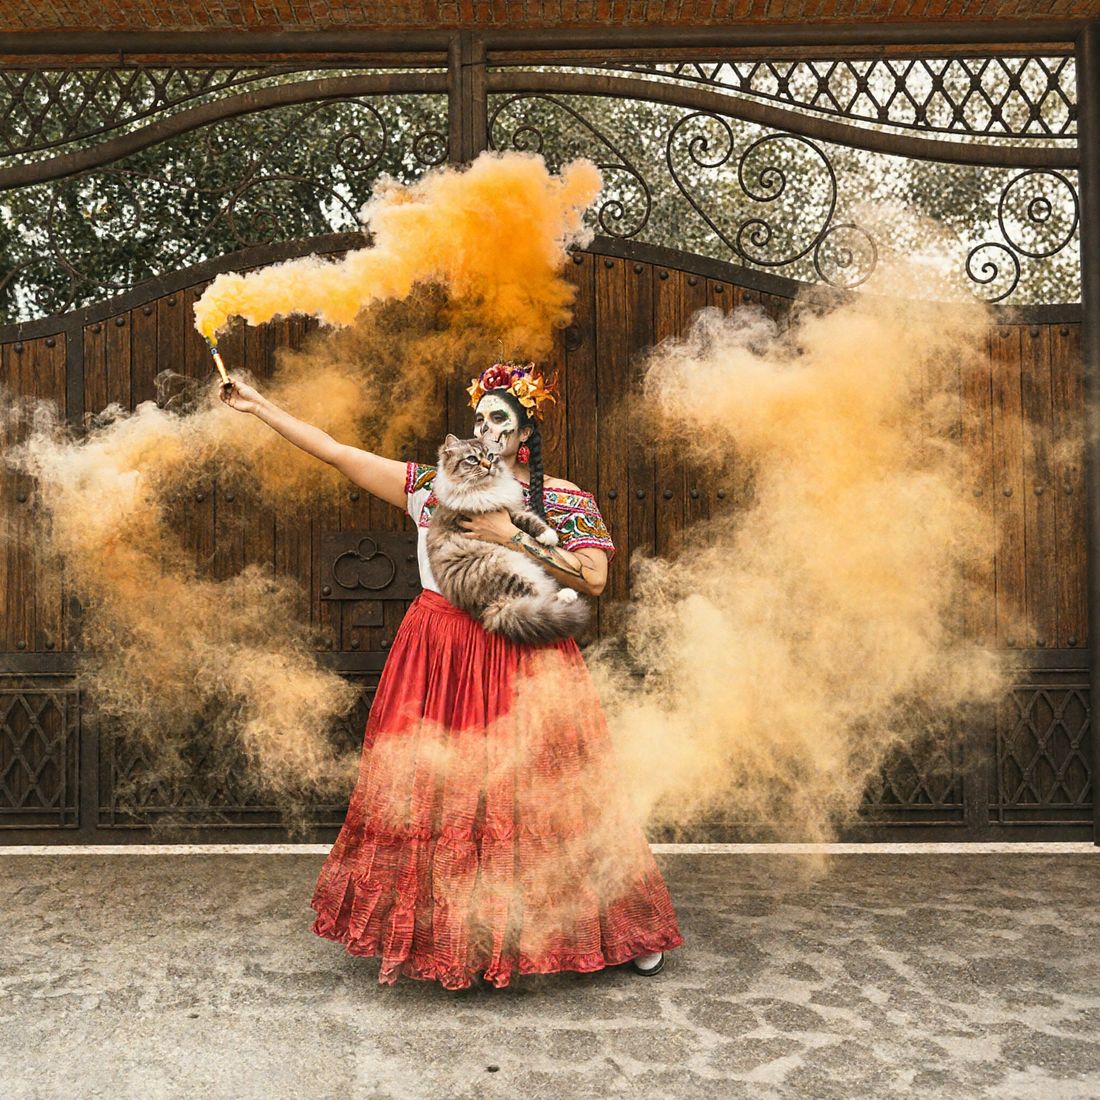
モデルカードでは、すべての例について3者比較が公開されています。teacherの40 NFE、PDD LoRAの4 NFE、Viggle v0.1 fullの4 NFEです。PDDは自身のteacherだけでなく、このモデル向けのもう一つの4ステップ手法、すなわち9月上旬にリリースされたViggle turbo LoRAとも比較されています。
 |  |  |
|---|---|---|
| teacher:40 NFE | PDD LoRA:4 NFE | Viggle v0.1 full:4 NFE |
テキストから画像への生成サンプル。プロンプトはPDD論文から引用。3枚のパネルはすべてシード42を使用。
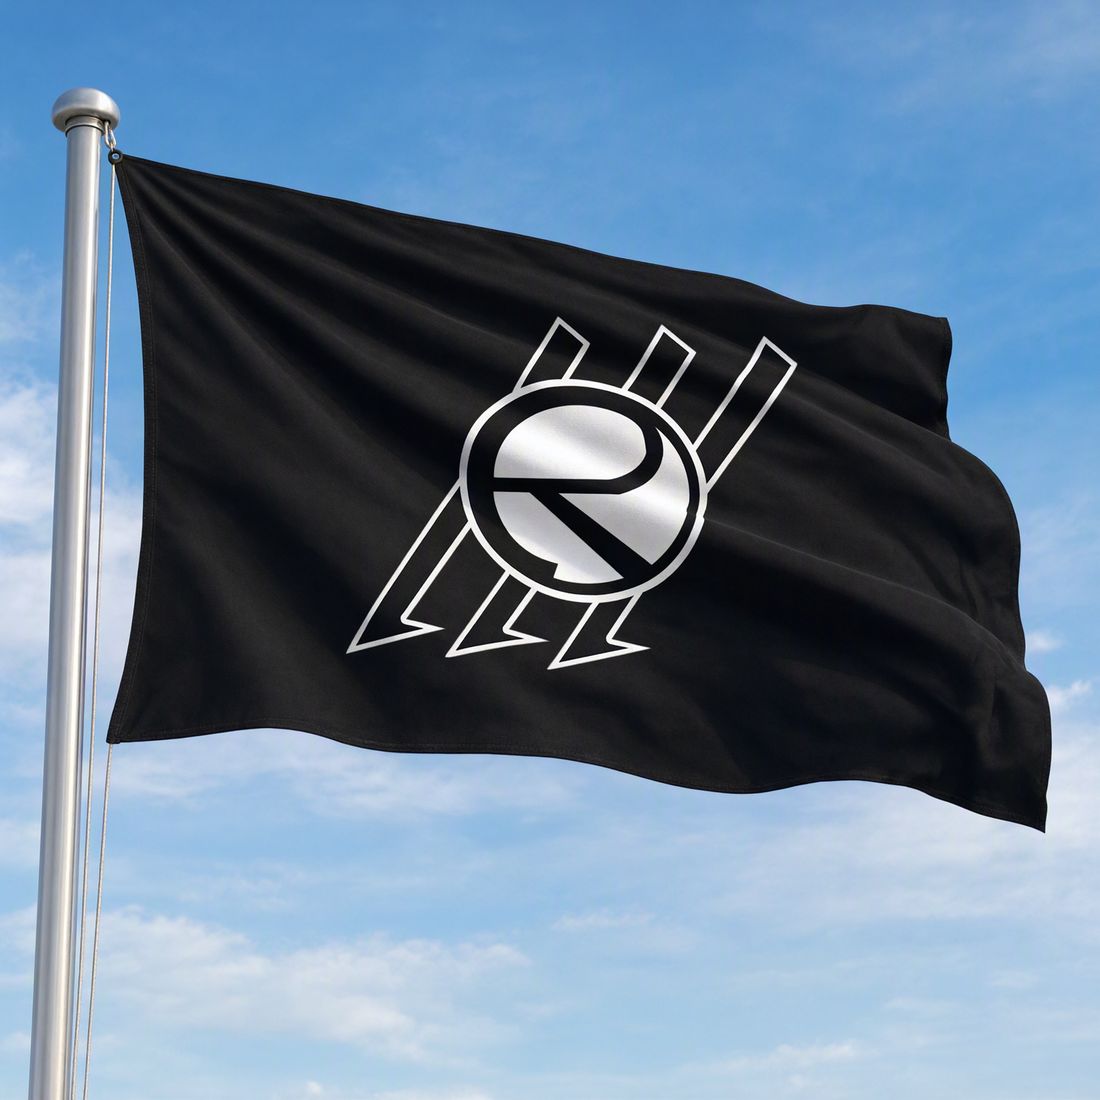
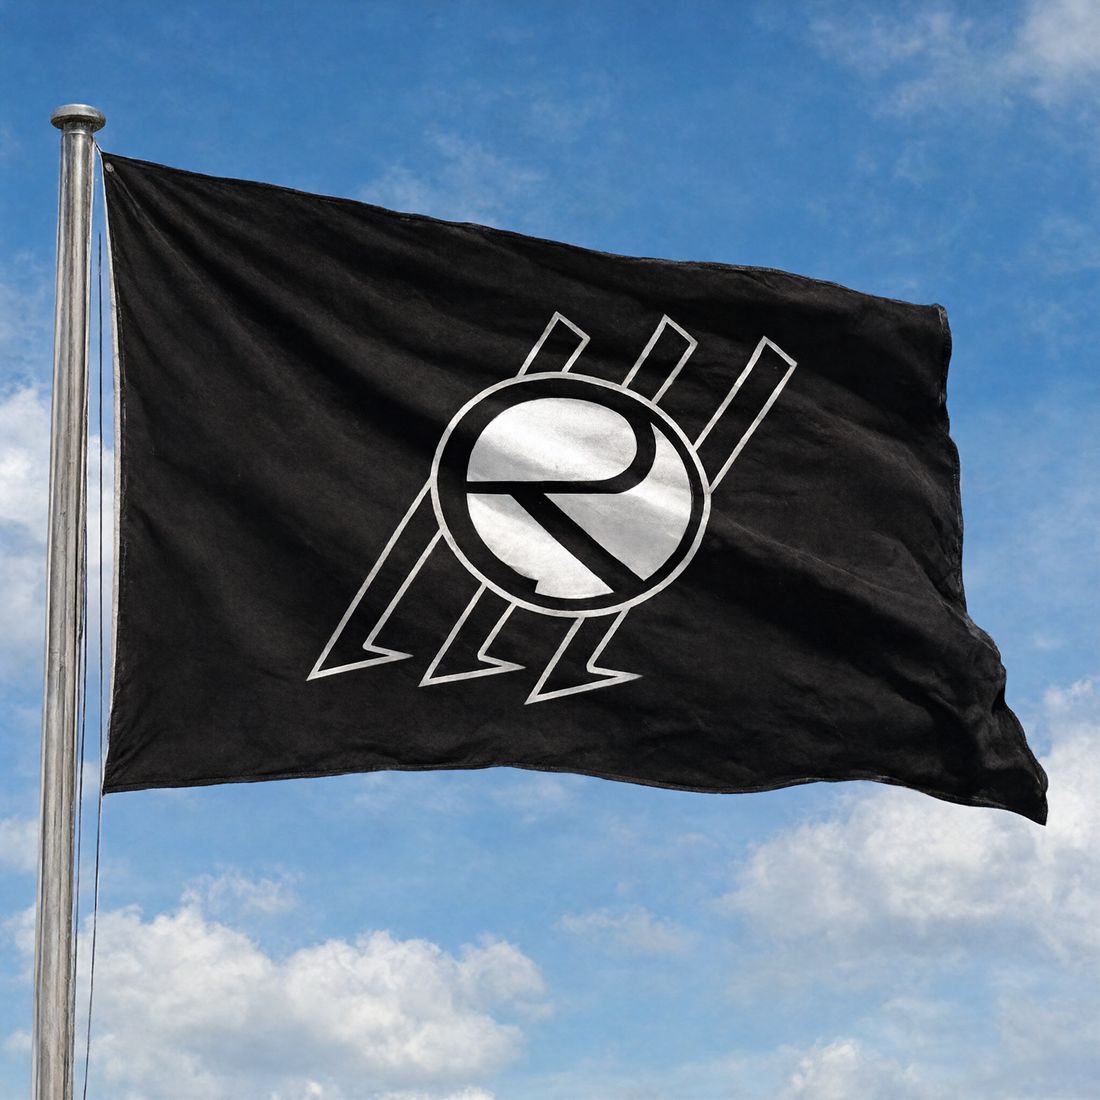
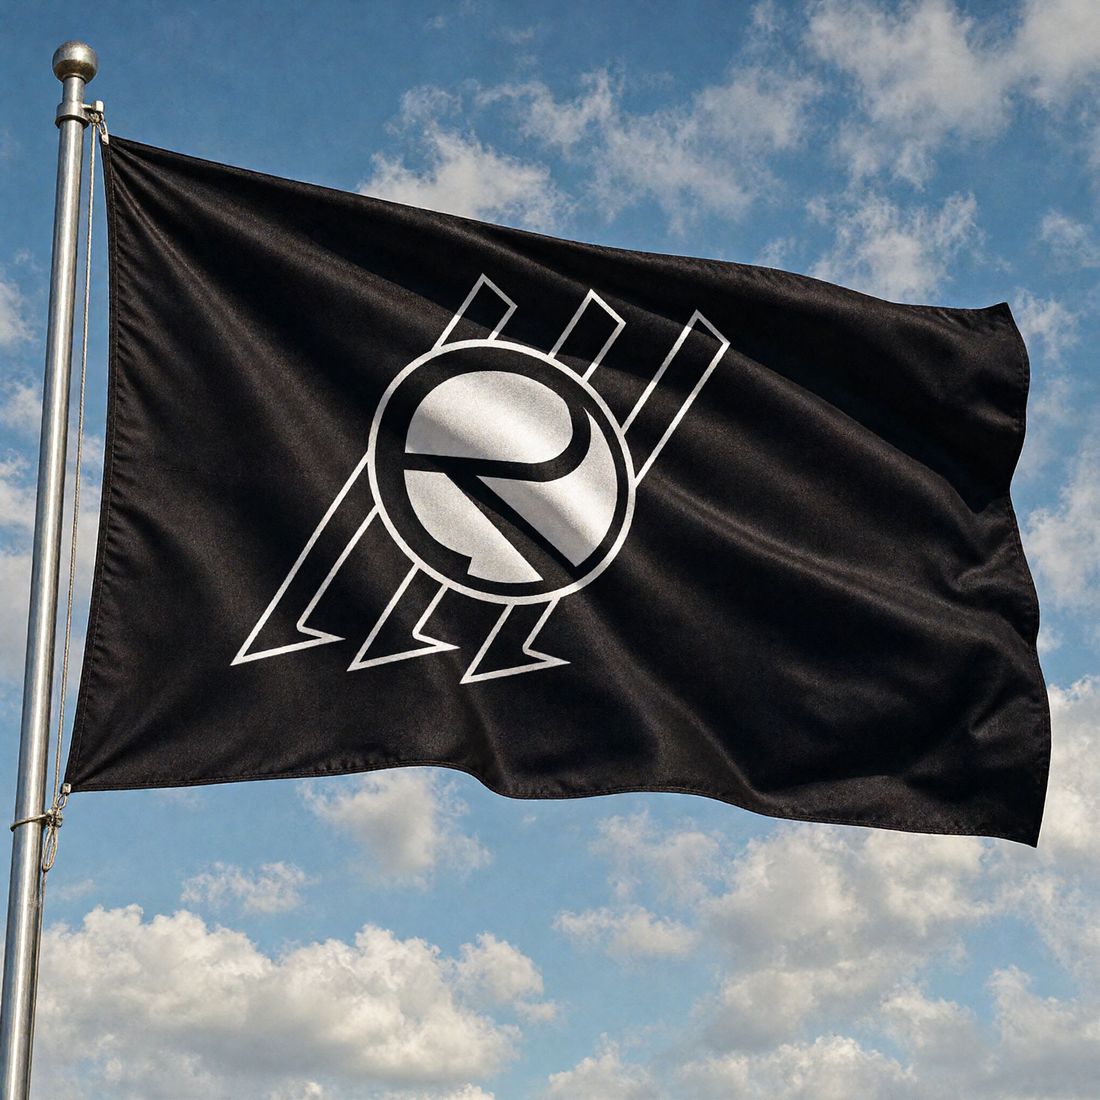
編集も同じアダプターでカバーされ、複数参照の編集も含まれます。以下の例では参照画像内の旗を描き直しており、3列目はViggle turbo LoRAによる同じ4ステップ手法です。
 |  |  |  |
|---|---|---|---|
| 参照画像 | teacher:40 NFE | PDD LoRA:4 NFE | Viggle v0.1 full:4 NFE |
 |  |  |
|---|---|---|
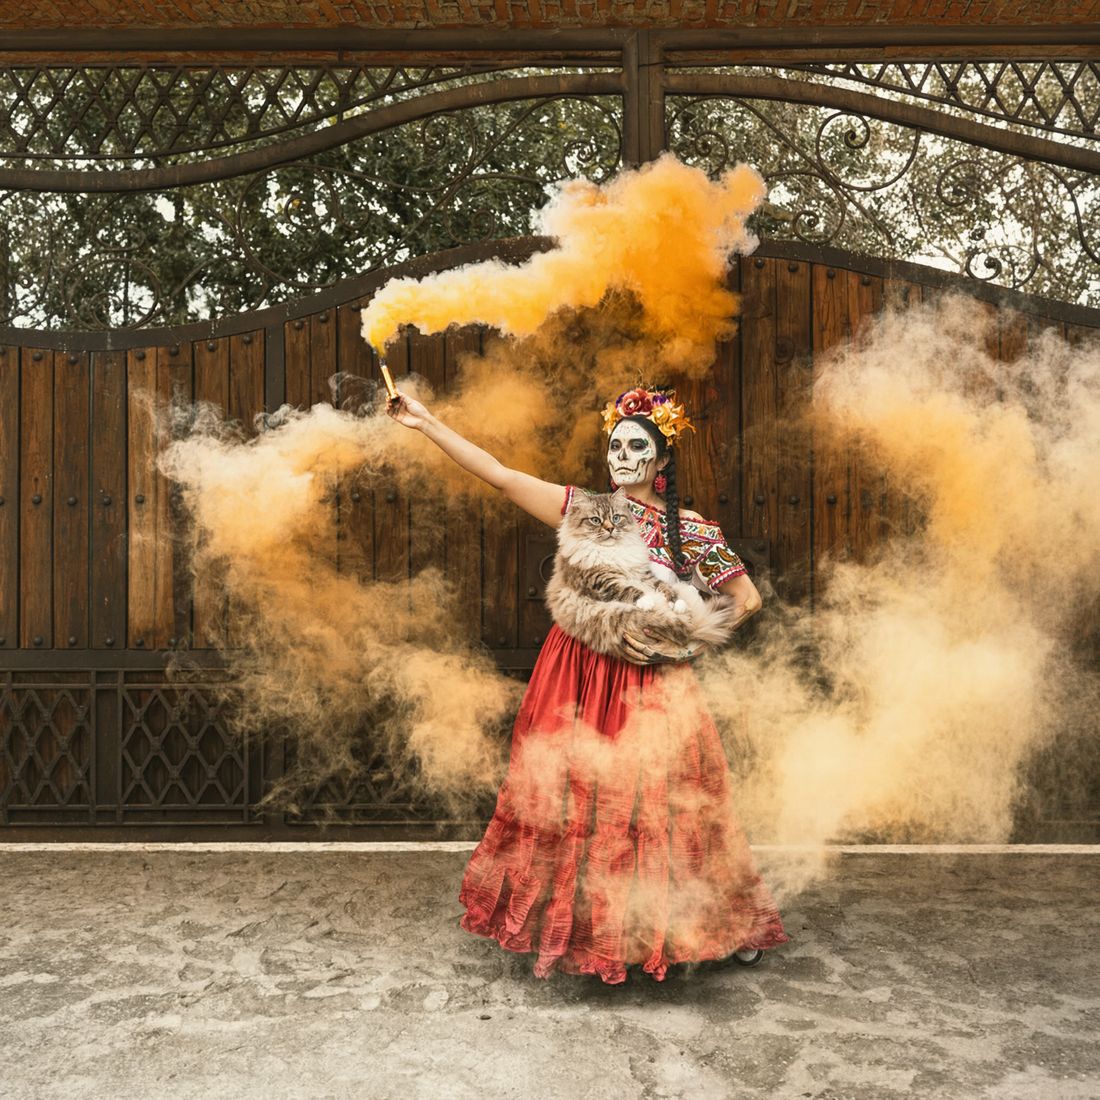
| teacher:40 NFE | PDD LoRA:4 NFE | Viggle v0.1 full:4 NFE |
2参照の編集サンプル(人物と猫)、シード43。
文書化された制限事項
モデルカードでは、後から気づくのではなく、teacherに対する既知のギャップを2つ挙げています。
- 密で小さなテキストは著しく劣化することがあり、文字のストロークが歪み、可読性が低下します。
- 一部の編集出力はteacherよりもわずかにぼやけて暗く見え、細部の明瞭さが低下します。
入手方法
公式のComfyUIサポートはなく、このリリースは公式パイプライン向けに書かれています。
- Diffusersのみ: 同梱の
qwenimage21_pdd.pyとlora_utils_pdd.pyをスクリプトと同じ場所に置き、python predict_t2i.py(生成)またはpython predict_t2i_edit.py(編集)を実行します。 - VideoX-Fun:
videox_fun.pipelineからQwenImage21Pipelineを公開しているチェックアウトを使用し、predict_t2i_videox_fun.pyまたはpredict_t2i_edit_videox_fun.pyを実行します。
ComfyUI向けには、今のところ実験的な手段しかありません。KijaiがComfyUIリポジトリのQwen-Image 2.1 PDDブランチを公開しており、このLoRAはComfyUIのローダーで使う前に変換が必要です。スケジュールと、LoRAではないnorm_q / norm_k / text_normパラメータが蒸留の一部であるため、このアダプターのComfyUI変換はサポートされた経路ではなくコミュニティによる作業として扱ってください。
同じチームによる以前のMiniMax H3向け高速化アダプターは、この一連のリリースがどのように機能するかを示す最も近い参照点です。そこでも、蒸留されたLoRAはベースモデル用の標準的なLoRAとしてではなく、独自の推論レシピとともに提供されていました。
コメント
GitHubでサインインしてディスカッションに参加しましょう。