Supra2-IMG: 10時間でトレーニングされた1億パラメータのテキストから画像へのモデル
SupraLabsがSupra2-IMGをリリース。1億500万パラメータのDiTテキストから画像へのモデルで、H100 1台で10時間かけてゼロからトレーニングされ、256x256のサンプルを公開しています。
モデルリポジトリの公式Supra2-IMGバナー。
概要
Supra2-IMGは非常に小さなDiTです。1億410万パラメータで、Flan-T5の128トークンのコンテキストから256x256の画像を生成します。テキストの条件付けは凍結されたFlan-T5-Baseエンコーダから得られ、潜在はSD-VAE-FT-MSEでデコードされます。そのため、これらのコンポーネントはいずれもcheckpointに同梱されておらず、それぞれのリポジトリから取得します。
| コンポーネント | 値 |
|---|---|
| パラメータ | 1億410万(D_MODEL 576、深さ14、ヘッド数9、ヘッド次元64、MLP比率4.0) |
| 解像度 | 256x256(潜在32x32、パッチサイズ2) |
| テキストエンコーダ | Flan-T5-Base、凍結、128トークンのコンテキスト |
| VAE | SD-VAE-FT-MSE |
| checkpoint | model_final_ema.pt |
SupraLabsは1億パラメータのSupra2言語モデルを手がけた独立系ラボであり、Supra2-IMGは同じ「小さく作る、ゼロからトレーニングする」というアプローチを画像生成に適用したものです。モデルは生のPyTorchコードと重みとして公開されています。inference.py、config.json、model_final_ema.ptです。
トレーニング
この実行は意図的に小規模に抑えられており、まさにそこがこのリリースの狙いです。
- データセット: LucasFang/FLUX-Reason-6Mデータセット全体を10エポック、準備後に560万枚の画像。
- キャプション選択: 各画像は
caption_composition、caption_entity、caption_text、caption_style、caption_imaginativeの順に利用可能な最初のキャプションを採用し、各サンプルで最も高品質なアノテーションを保持します。 - ハードウェア: RunPod上のNvidia H100 SXM 80GB 1台、データ準備を含めて9時間、2.5TBのディスクを使用。
モデル全体が数百メガバイトに収まるため、小規模な事前トレーニングの研究や、8B規模ではコストがかかりすぎるファインチューニング実験のベースとして実用的です。
サンプル
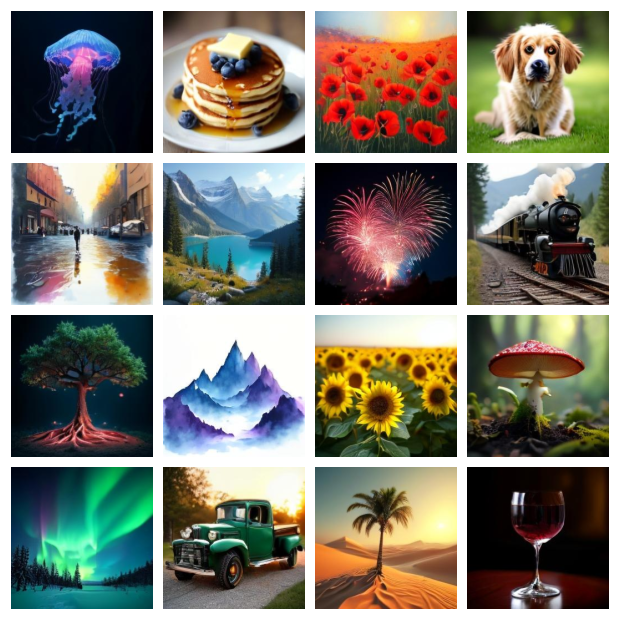
モデルリポジトリの公式サンプル。いずれも厳選された実行結果ではなく、推奨設定で生成されたものです。
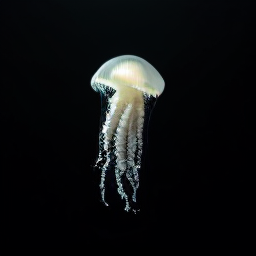
同梱の推論スクリプトで生成された256x256の出力例。
利用可能性
ComfyUIのサポートはありません。Supra2-IMGは独自のSupraDiTアーキテクチャを採用した素のPyTorchリリースであり、diffusersのpipelineではないため、ComfyUIのテンプレートやノードは公開されていません。実行するには同梱スクリプトと2つの外部コンポーネントが必要です。
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
--seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png推奨されるサンプリング設定は、シード0、CFG3.0、50ステップです。
- 重みとコード: SupraLabs/Supra2-IMG
- テキストエンコーダ: google/flan-t5-base
- VAE: stabilityai/sd-vae-ft-mse
- ラボ: supra-labs.com
コメント
GitHubでサインインしてディスカッションに参加しましょう。