Qwen-Image 2.1: ComfyUIで動作する7Bのテキストから画像生成・画像編集モデル
Qwen-Image 2.1はAlibabaの7Bオープンウェイト画像モデルで、ネイティブRGBA透過、最大10枚の参照画像からの編集、day-0のComfyUIサポートと公式テンプレートを備えています。
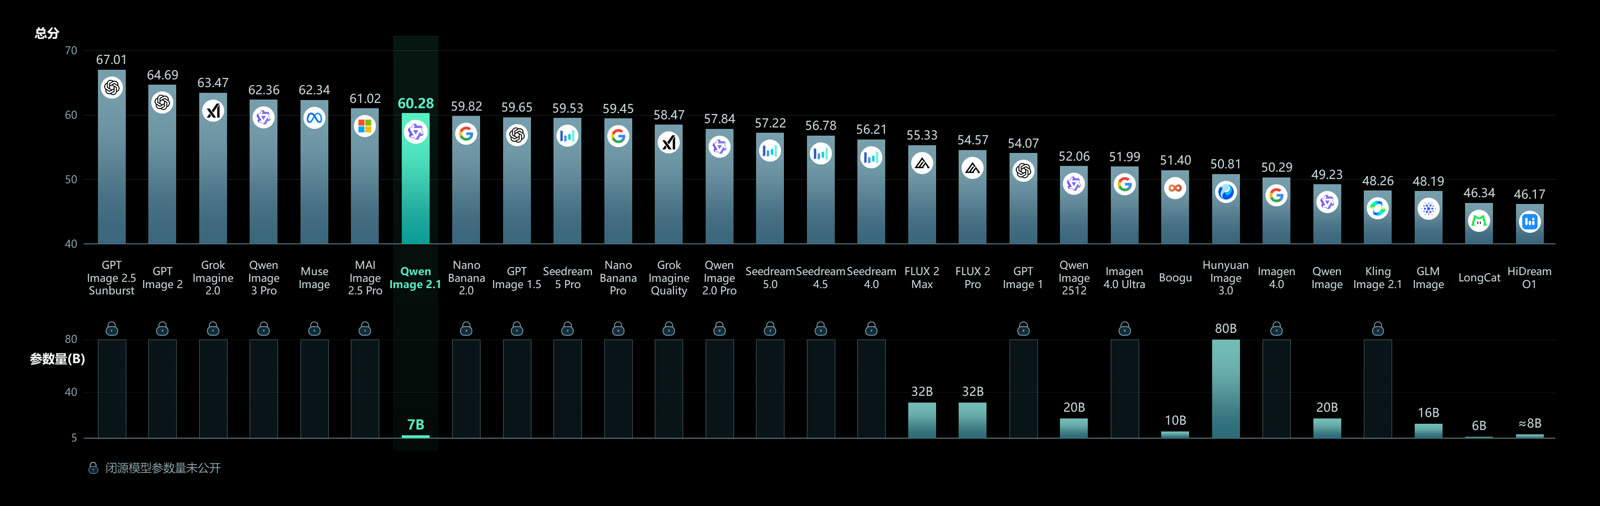
公式Qwen-Image 2.1モデルカードからの例。
Qwen-Image 2.1の新機能
以前のQwen-Imageの生成では、Qwen2.5-VL-7Bテキストエンコーダーを備えた20BのMMDiTバックボーンを使用していました。Qwen-Image 2.1は視覚生成側を32層のシングルストリームDiTで構成される7Bコンポーネントに置き換えており、4つの主要な変更点は次のとおりです。
- コンパクトで効率的。 混合粒度アテンションとプレフィックスKVキャッシュの再利用により、20B系よりもはるかに低い計算コストで高品質を維持します。
- ネイティブな透過、生成と編集の統合。 1つのモデルがテキストから通常の画像または透過(RGBA)画像を書き出し、透過レイヤーを編集し、写真から被写体を抽出します。
- 多用途な編集。 1リクエストあたり最大10枚の参照画像、サークルやペイント注釈、または別途マスクで指定するローカル編集、人物や製品の同一性の保持。
- リアルなテクスチャと洗練された美学。 タイポグラフィ、ポートレートのライティング、細部が向上しました。
ネイティブ出力サイズは、以前のワークフローが使用していた1024クラスの正方形よりも幅広です。1:1で2048x2048、4:3で2400x1792、3:2で2528x1696、16:9で2752x1536となり、対応する縦長比率も用意されています。
実際のアルファチャンネルによる透過画像
最大の特徴は、ファイルにそのまま残るアルファです。単色の背景で生成してから別のマッティングモデルで被写体を切り抜くのではなく、Qwen-Image 2.1は透過自体を書き出すため、ステッカー、製品レンダー、UIアセットがそのまま合成可能な状態で出力されます。モデルカードでは、これをトリガーするための明示的なプロンプト形式を推奨しています。
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.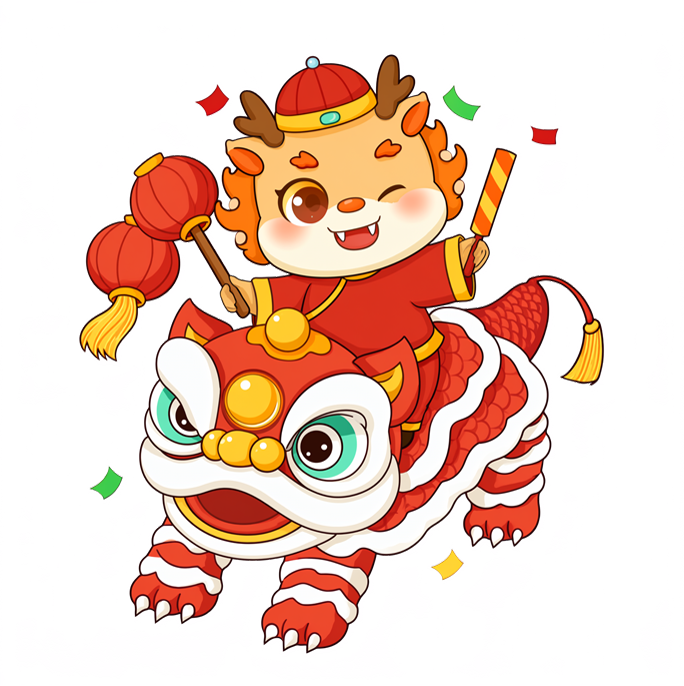
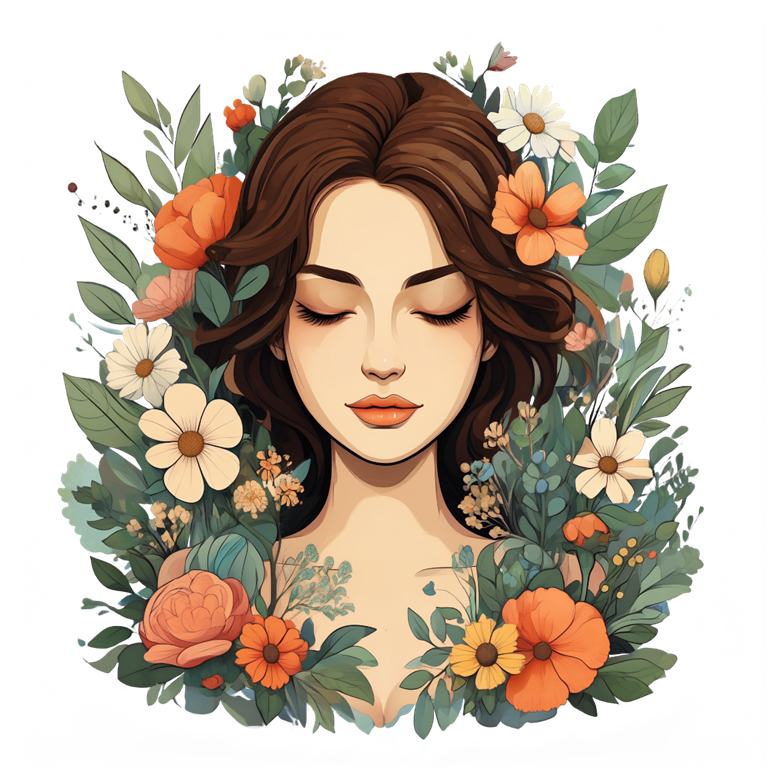
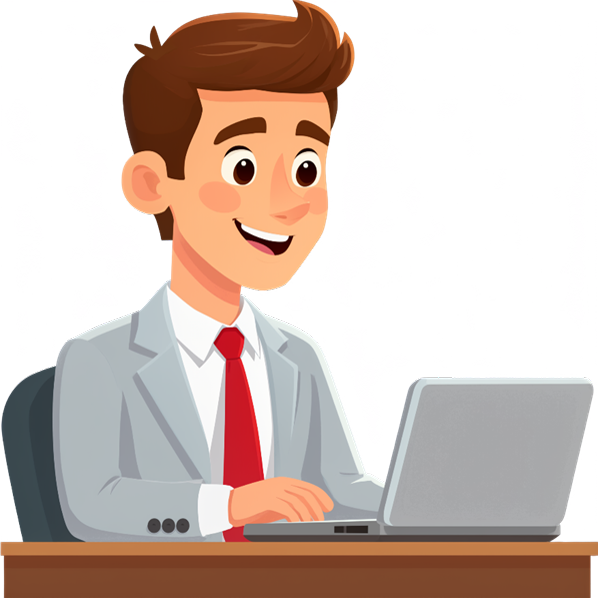
公式ショーケースそのままの、ネイティブな透過画像生成。ファイルにはアルファチャンネルが含まれており、描かれたチェッカーボードではありません。
最大10枚の参照画像からの編集
編集では、参照画像の枚数枠が重要になります。Qwen-Image 2.1は1回のパスで最大10枚の画像を受け付けるため、別々に生成したものを繋ぎ合わせることなく、集合写真の構図、複数製品のシーン、キャラクターシートを作成できます。ローカル編集は、サークル、ペイント注釈、またはマスクノードで指定できます。
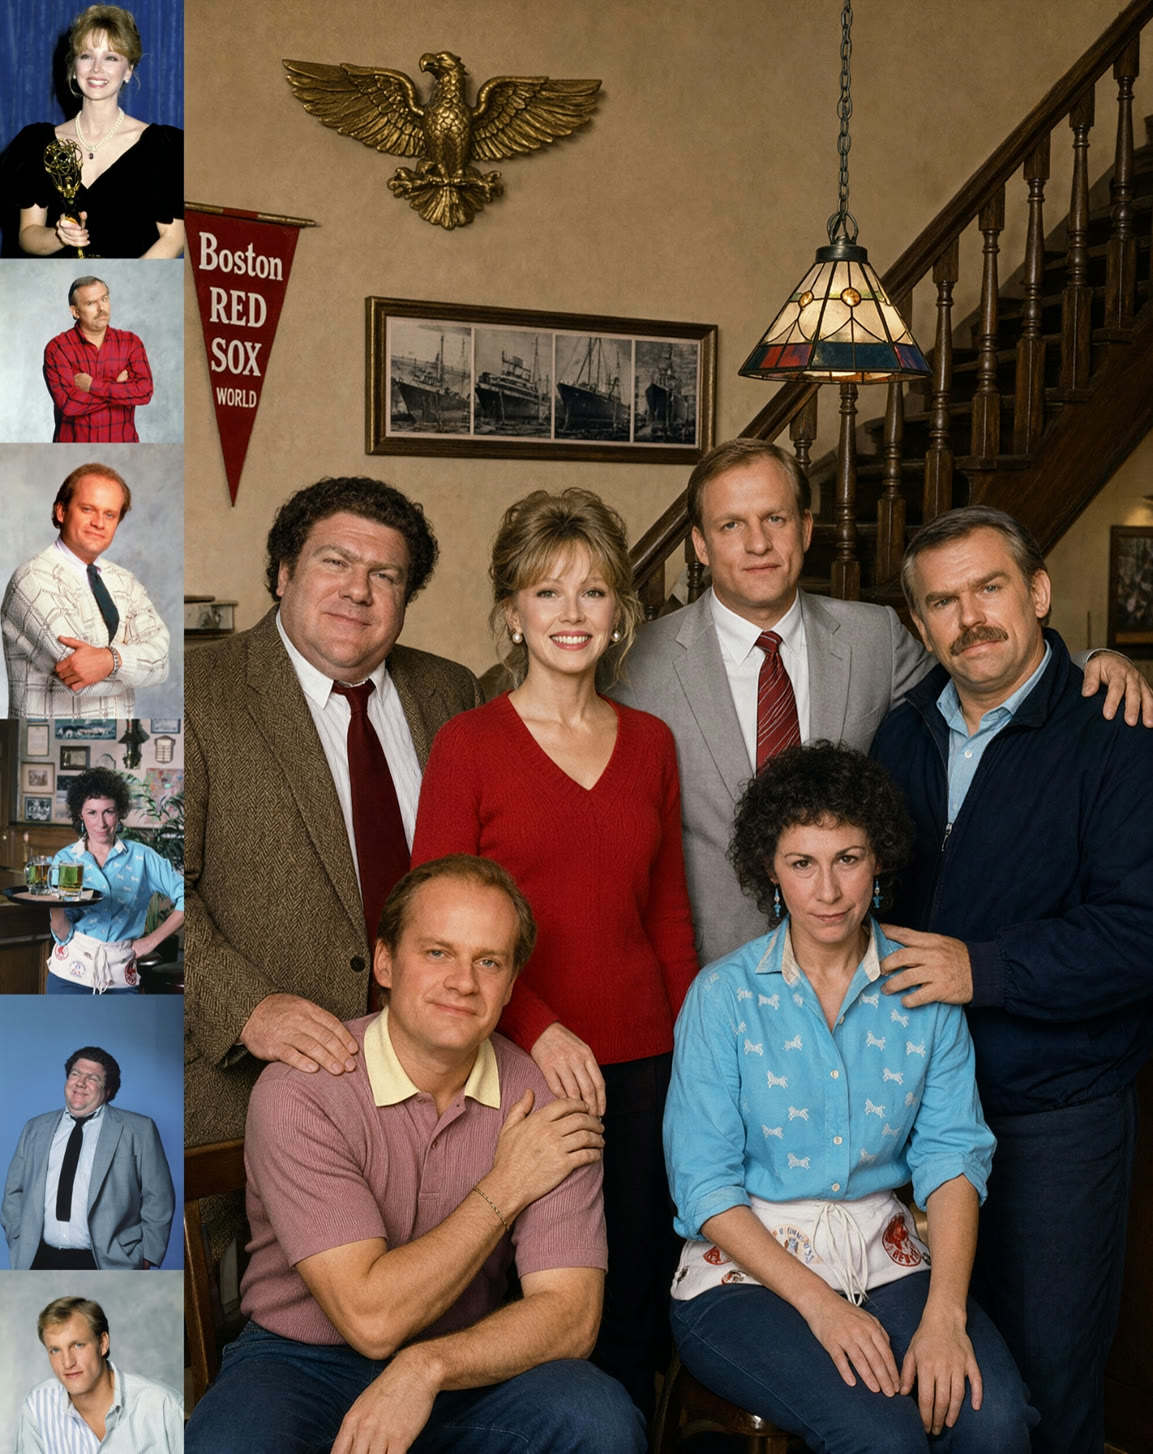
6枚のポートレート参照画像から生成された1枚の集合写真。
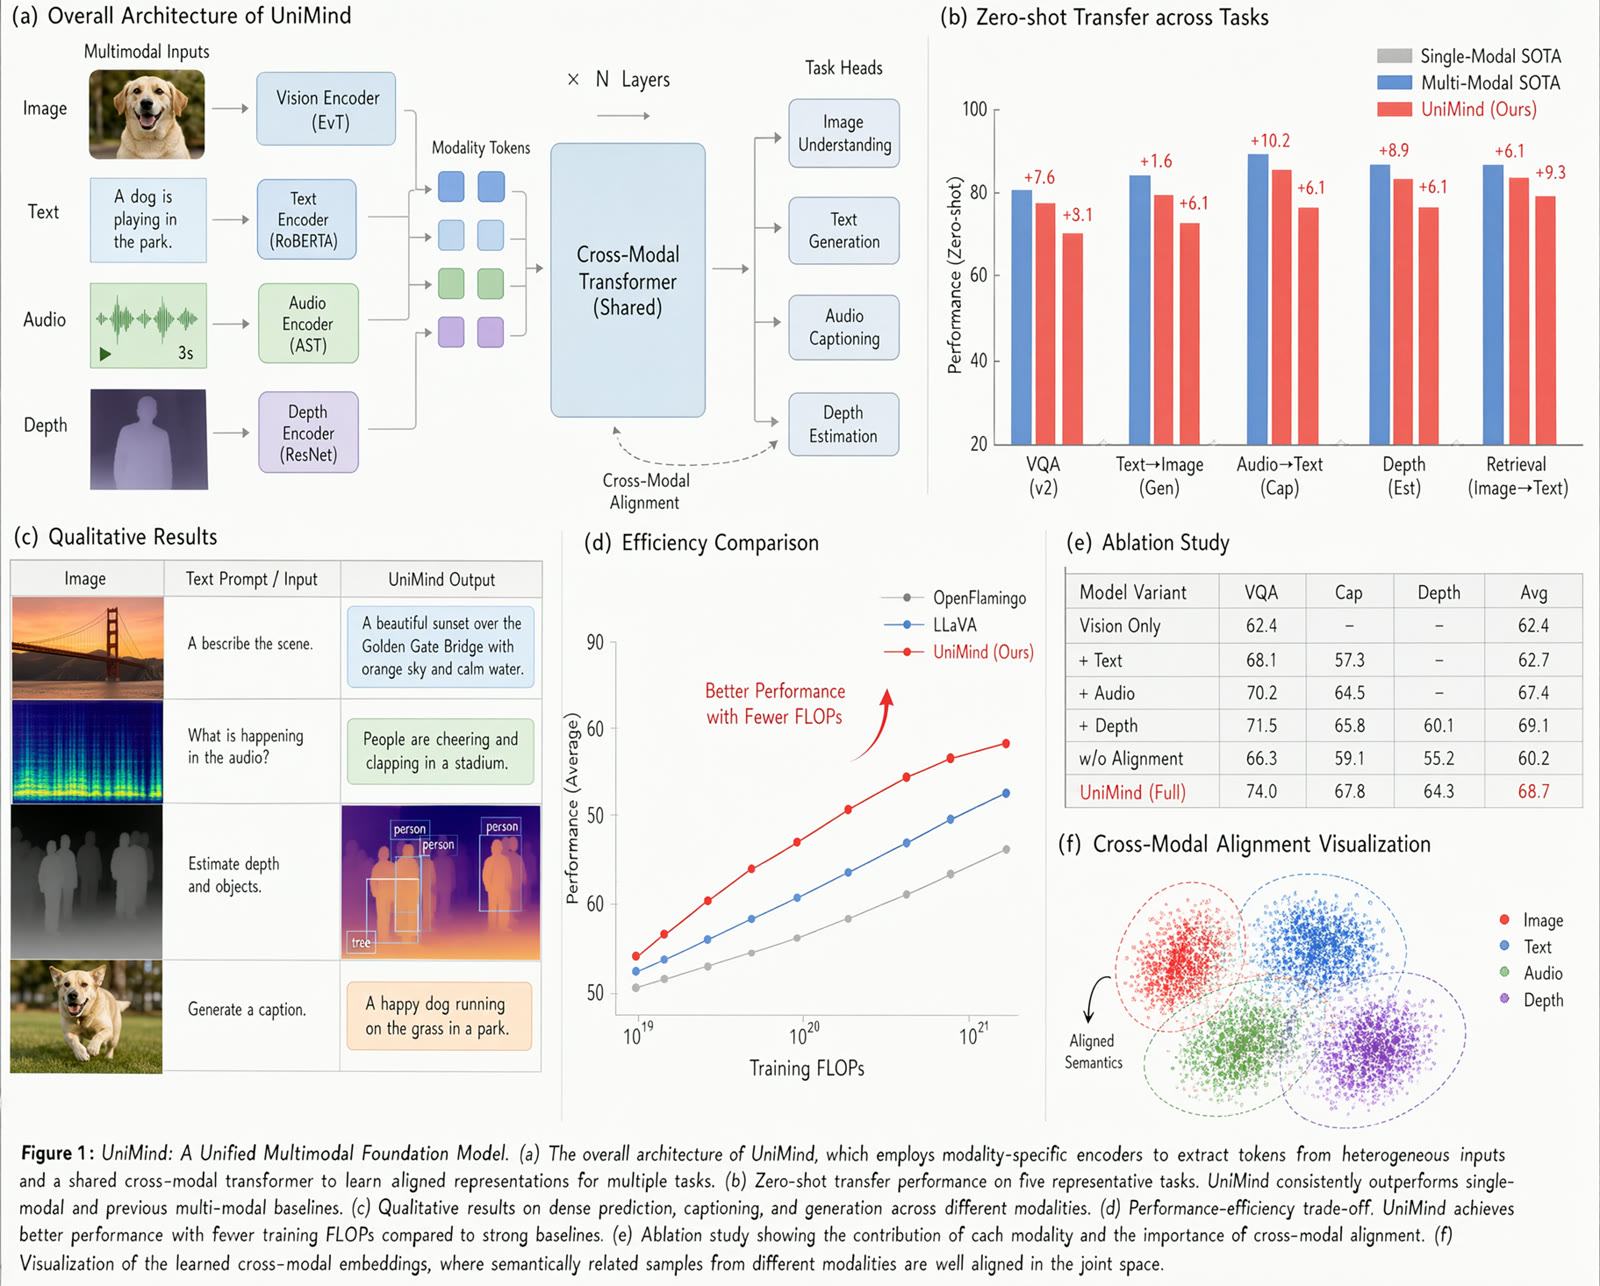
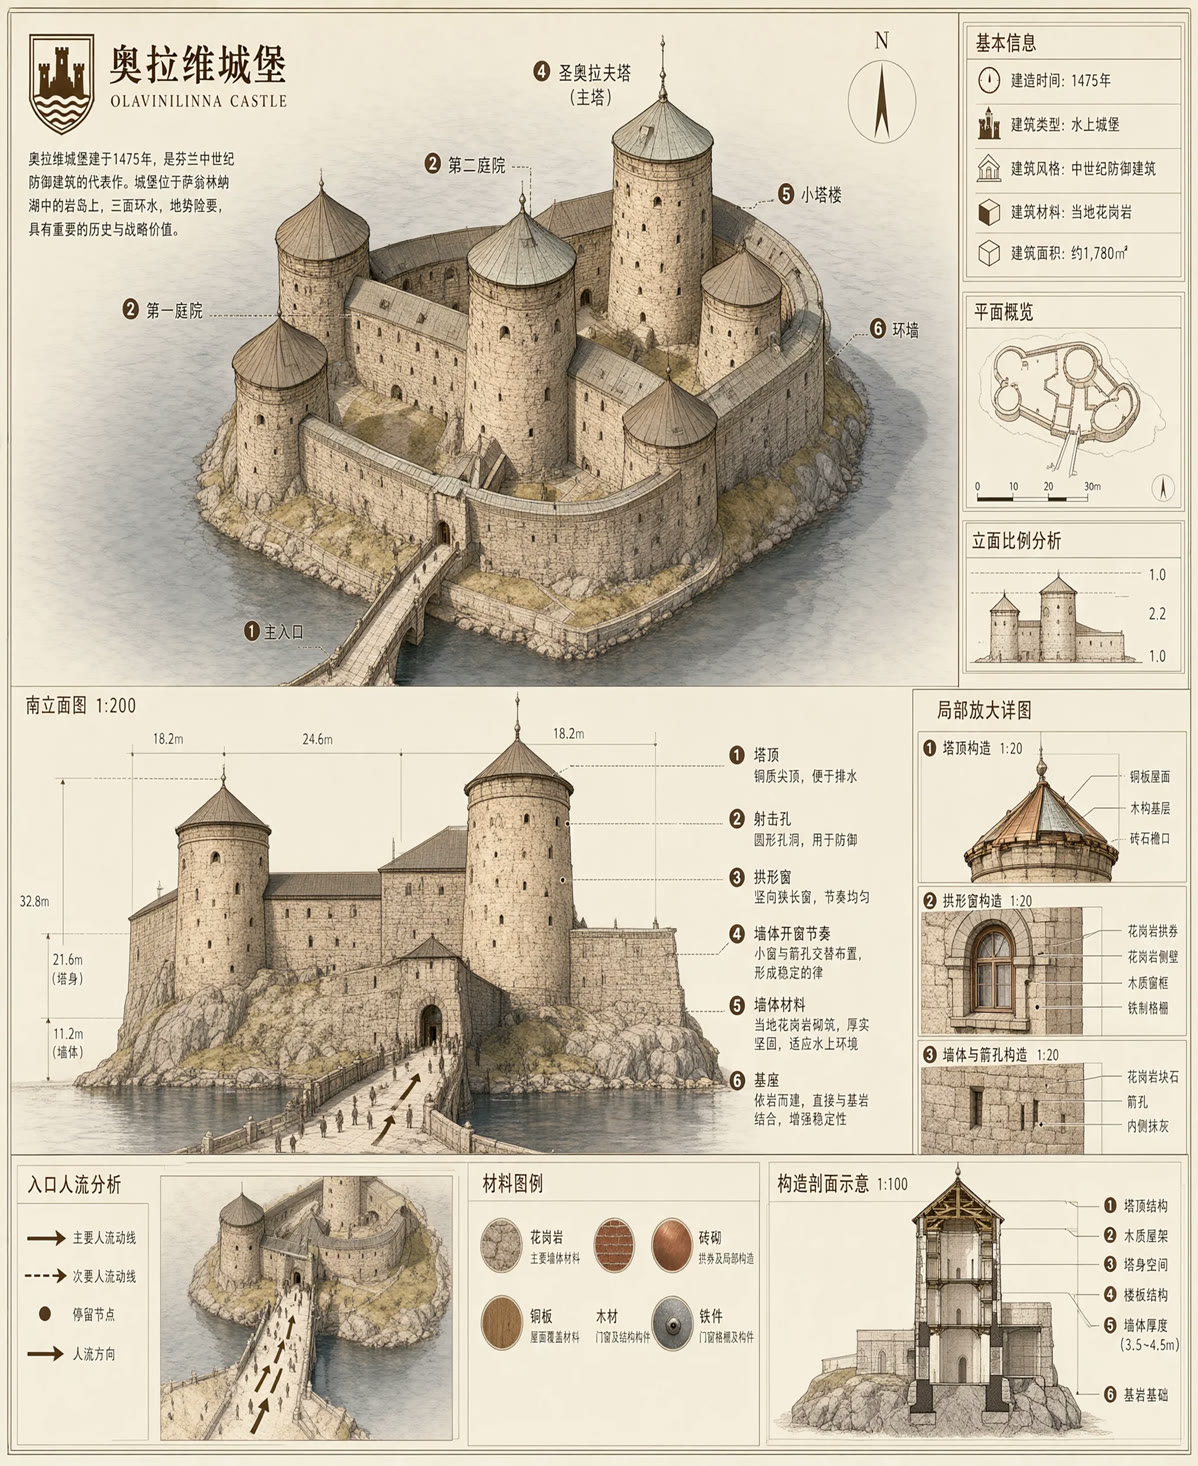
モデルカードからのタイポグラフィとレイアウトの例。
Day-0のComfyUIサポート
ComfyUIはComfy-Org/ComfyUI #16400(CORE-423、Kijaiによる)でQwen-Image 2.1のサポートをマージしており、以下の3つの公式テンプレートにはComfyUI 0.37.0以降が必要です。その後のコミットで、transformerブロックのコンパイルと、このモデル向けのKVキャッシュ配置の改善が追加されました。
再パッケージされた単一ファイルのウェイトはComfy-Org/Qwen-Image-2.1にあり、テンプレートは組み込みのワークフローギャラリーの一部であるため、JSONをドラッグする代わりにテンプレートブラウザから開くこともできます。
| テンプレート | 内容 |
|---|---|
| テキストから画像へ | 25サンプリングステップで1024x1024の画像を1枚生成。ネイティブ2K出力、タイポグラフィとアルファに対応 |
| 画像編集 | 生成と編集を兼ねる単一のcheckpointに2枚の参照画像を渡す構成。キャラクターの一貫性を保った編集や製品の切り抜きに有用 |
| 背景を除去 | 入力画像1枚から透過結果1つを出力。モデルのネイティブRGBA出力を使用 |
モデルファイル
Comfy-Orgの再パッケージは、通常のフォルダー構成に分かれています。
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
└── qwen_image_2.1_vae_bf16.safetensorsこれらに加えて、再パッケージにはプロンプトエンハンサーのテキストエンコーダーも含まれています。INT8 convrot形式のqwen3.5_9b_qwen_image_2.1_pe_t2iとqwen3.5_9b_qwen_image_2.1_pe_i2iです。これらは、短いリクエストを画像モデルが好むテンプレート形式に展開するためにQwenがファインチューニングしたLLMで、オプションです。同じプロンプトテンプレートは有能なLLMならどれでも埋められますし、画像モデル自体はこれらなしでも動作します。
初期ユーザーの報告
このモデルはリリース当日からユーザーの手に渡っており、同じいくつかの実用的な指摘が繰り返し挙がっています。
- ネイティブサイズが重要。 2048クラスのトレーニング解像度を大きく超えると露出が不安定になる一方、大きすぎる参照画像を入力すると生成が急激に遅くなります。参照画像は読み込む前にリサイズするほうが、サンプラーに処理させるより安上がりです。
- CFGが1未満では実用的に使えません。 ガイダンスが1前後だと以前のQwen-Image系と同じ挙動になり、画像内のテキストをよりシャープにしたいときに選ばれるのは、小さめのCFGと品質重視のネガティブプロンプトです。
- スタイル転送は依然として当たり外れがあります。 テキスト指示によるスタイル変更は安定して効きますが、参照画像で与えるスタイルは信頼性が低く、以前のQwen-Image Editingモデルでユーザーが遭遇した状況と同じです。
入手方法
ウェイトはHugging FaceとModelScopeで公開されており、リリース記事はQwen blogにあります。ComfyUI以外のday-0統合には、QwenImage21Pipeline経由のDiffusers、vLLM-Omni、SGLang、LightX2Vがあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。