ComfyUI で使う Pruna の 5 ステップ・8 ステップ Qwen-Image 2.1 LoRA
PrunaAI の Pruna-Qwen-Image-2.1 LoRA は、Qwen-Image 2.1 の生成と編集を CFG なしの 5 または 8 ステップに短縮します。コミュニティによる ComfyUI 変換版とステップごとのシグマスケジュールも紹介します。
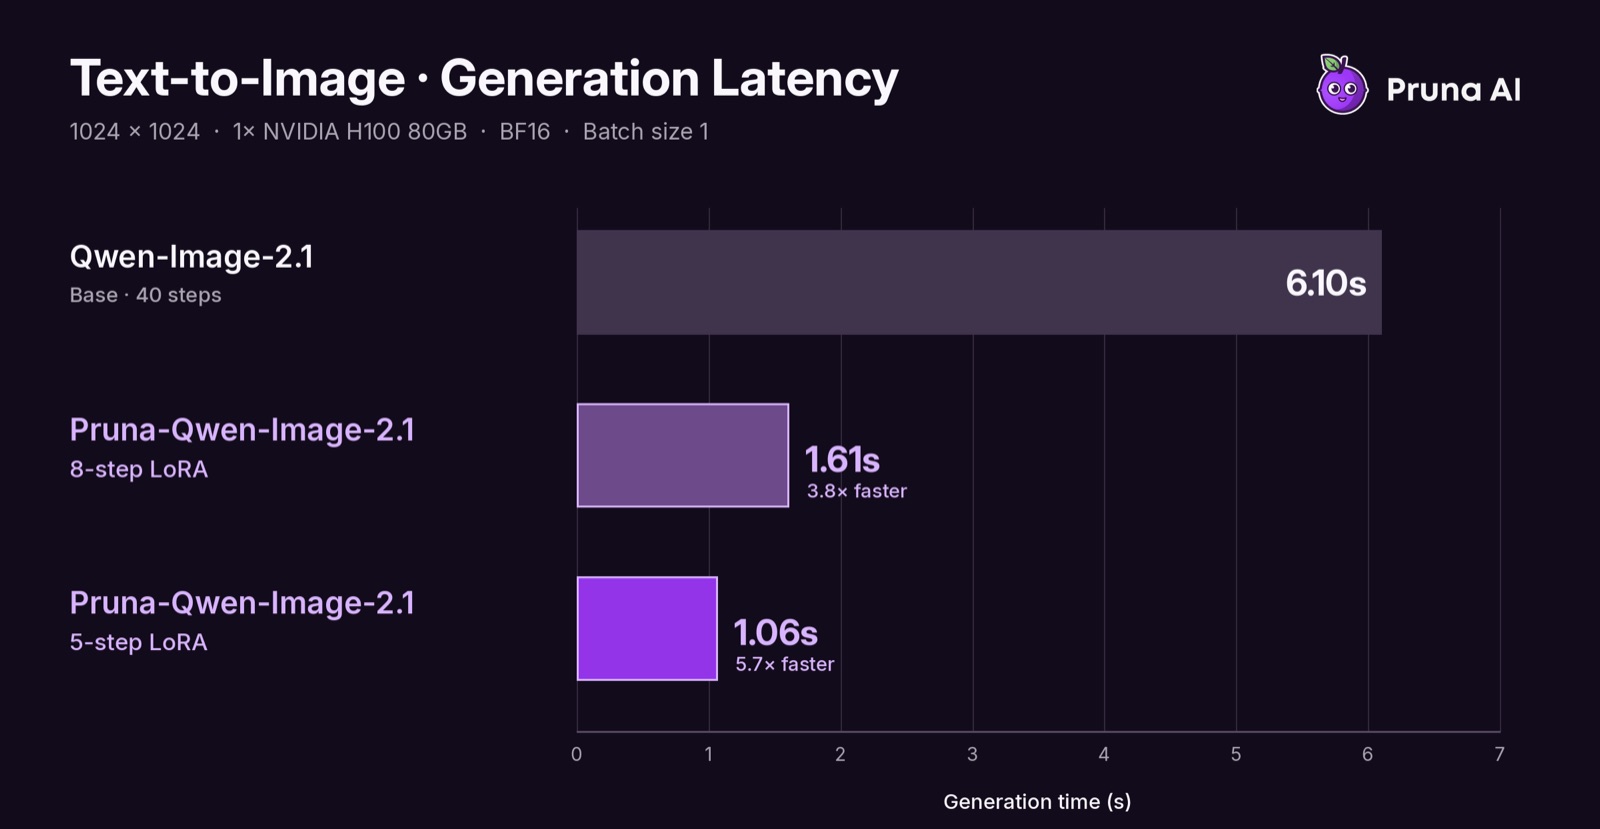
公式モデルカードのテキストから画像への比較。
2 つのアダプター、2 つのスケジュール
このリリースは 1 つの蒸留モデルではなく、別々にトレーニングされた 2 つの生徒モデルです。PrunaAI は、品質を取るか速度を取るかに応じてどちらか一方を選ぶことを想定しています:
| アダプター | ステップ数 | トレードオフ |
|---|---|---|
p_qwen_image_2.1_8step_v0.1.safetensors | 8 | 品質が高く、推奨のデフォルト |
p_qwen_image_2.1_5step_v0.1.safetensors | 5 | 高速だが、画像は明らかに劣る |
各アダプターはそれぞれ独自のシグマスケジュールでトレーニングされており、モデルカードは一度に 1 つだけ読み込むよう求めています。スケジュールは正確にコピーしなければならない部分です。というのも、これらの生徒モデルは、サンプラーが自前で導き出すステップ数ではトレーニングされていないからです:
| ステップ数 | シグマ |
|---|---|
| 5 | 1.0, 0.94, 0.857142857, 0.666666667, 0.4 |
| 8 | 1.0, 0.933333333, 0.857142857, 0.769230769, 0.666666667, 0.545454545, 0.4, 0.222222222 |
どちらも DMD でトレーニングされており、空のネガティブプロンプトを使い CFG 1.0 で実行されます。末尾の 0 はスケジュールに書き込まれているのではなく、スケジューラーによって追加されます。その他のステップ数、スケジュール、CFG 値は、アダプターがトレーニングされた範囲外です。
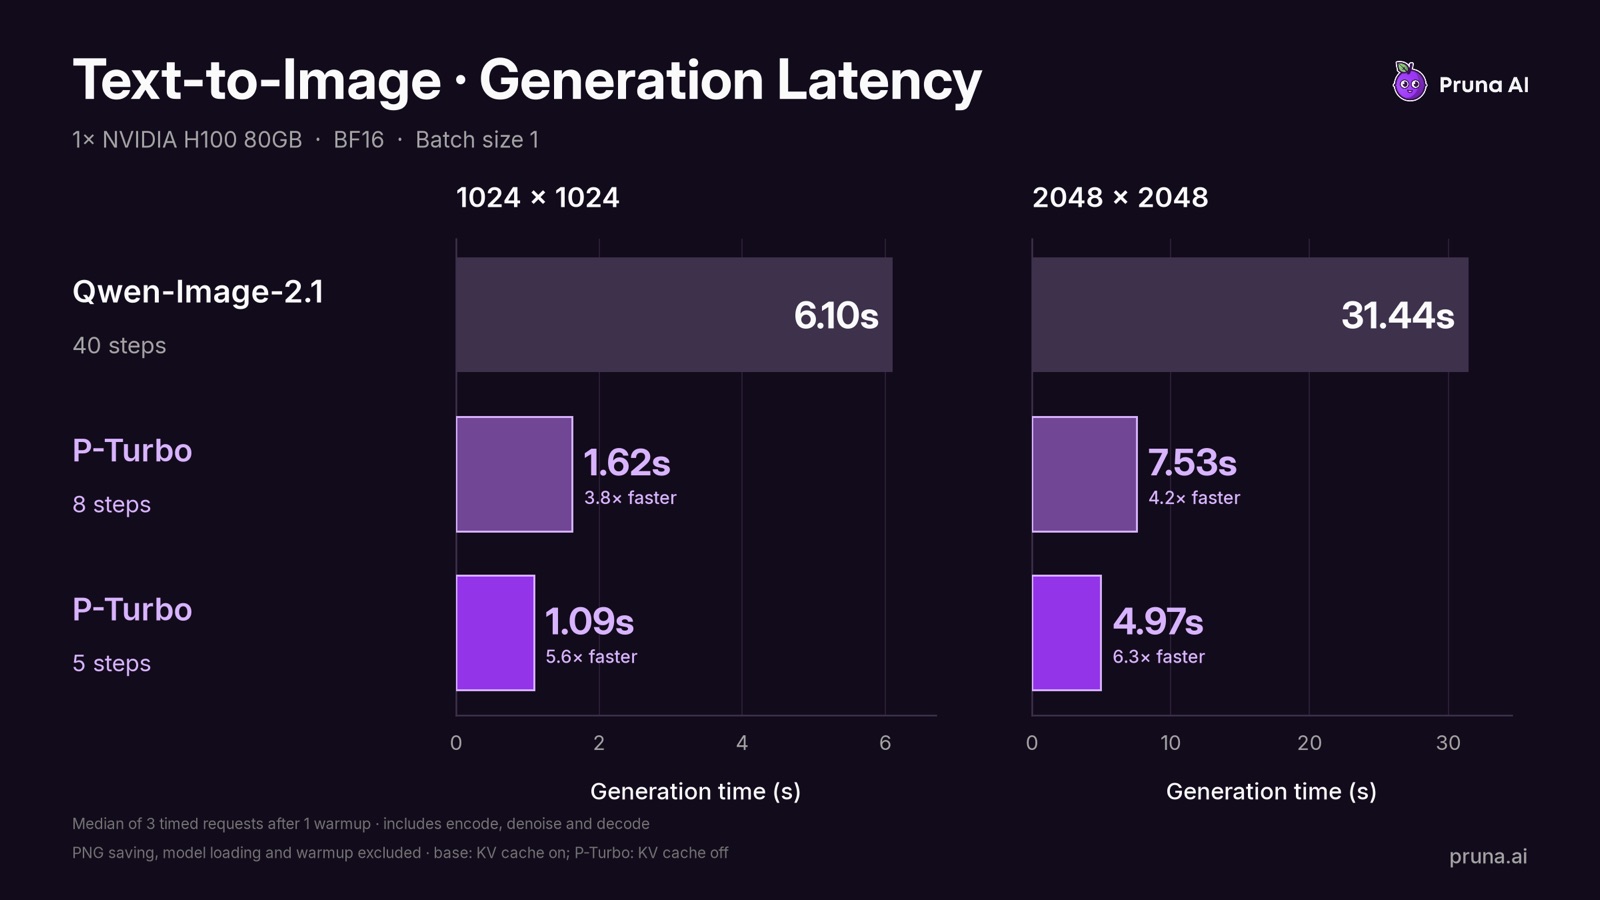
カードのテキストから画像のレイテンシチャート。単一の H100 80GB で測定: 1 回のウォームアップ後の 3 リクエストの中央値で、プロンプトのエンコード、デノイズ、デコードを含みます。ベースモデルは KV キャッシュありの 40 ステップ、アダプターは KV キャッシュなしの 5 または 8 ステップです。
PrunaAI が掲げる目玉の数字は 最大 6.3 倍高速 です。カードは主張しない点にも注意を払っています。タイミングは同等の画質を意味するものではなく、ベンチマークでは LoRA はマージされないままにされ、サンプル画像では KV キャッシュが有効になっていますが、チャートはその設定で再測定されていません。
トレーニングの対象範囲と限界
アダプターは 1K 解像度のみ で、通常のプロンプトとアップサンプリングされたプロンプトを混ぜてトレーニングされており、テキストから画像への生成と、最大 3 枚の参照画像 を使う単一・複数画像の編集をカバーしています。PrunaAI は 1024x1024 から始めることを推奨しており、2K 出力、より多くの参照画像、短く曖昧なプロンプトは対象範囲外として扱い、品質が変動する可能性があるとしています。
このリリースは明示的に v0.1、進行中 と位置づけられています:
- 品質は 40 ステップのベースモデルを下回り、蒸留の改善に合わせてリポジトリが更新されます。
- 5 ステップのアダプターは高速な方で、その画像は 8 ステップのアダプターよりも明らかに劣ります。
- 単体で動作するモデルではありません。
Qwen/Qwen-Image-2.1のベース重みが引き続き必須です。
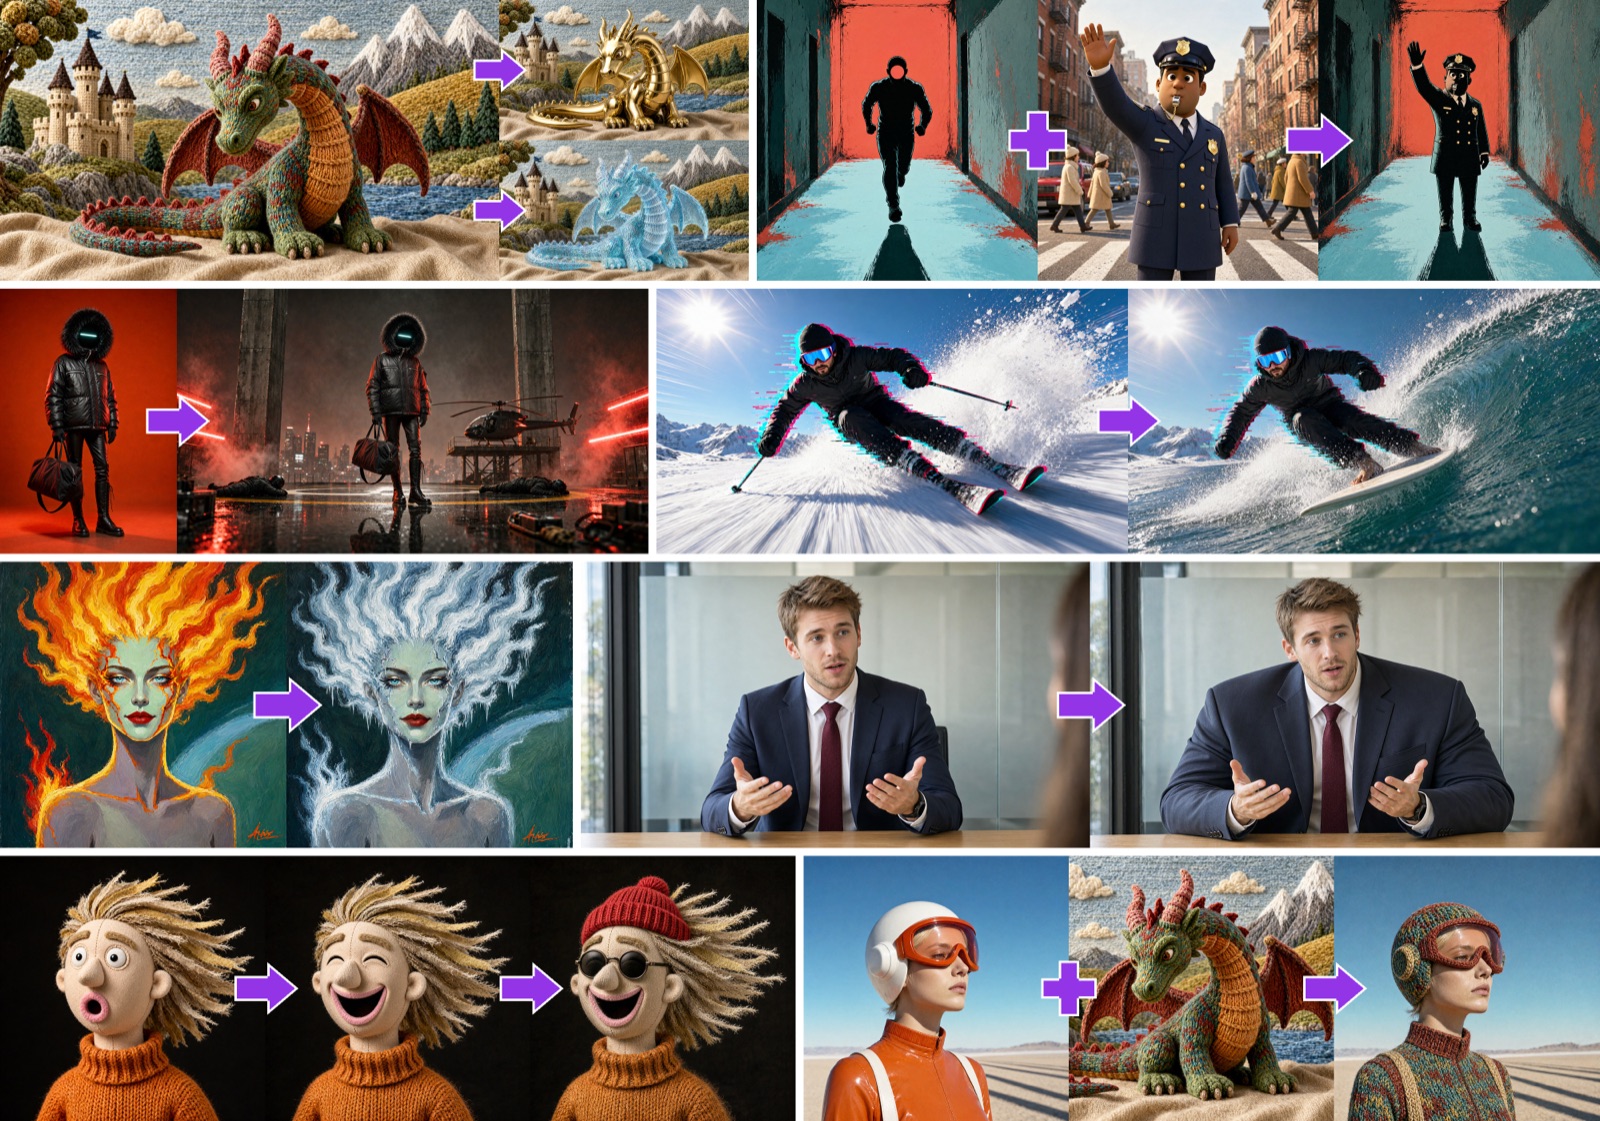
公式モデルカードの編集グリッド。
ComfyUI での利用可否
これらのアダプター向けの公式 ComfyUI パッケージはまだありません。diffusers/PEFT ファイルとして rank 64、PEFT alpha 128 で配布されており、alpha は ComfyUI の LoRA ローダーが読み取るテンソルではなく safetensors のメタデータに保存されています。そのため、そのままドロップインすると誤ったスケールで実行されます。コミュニティはリリースから 1 日以内にこのギャップを埋めました:
NidAll/pruna-image-2.1-comfyui-lorasは非公式の変換版で、224 個の LoRA ターゲットそれぞれにスカラーの.alphaテンソルを追加し、A と B の重みはそのままに、LoRA 強度 1.0 でアダプターが意図したスケールで動作するようにします。独自の 5 ステップと 8 ステップのワークフロー JSON も同梱されています。- これらのワークフローは ComfyUI ネイティブのノードのみを使用します:
ManualSigmas、SamplerCustom、Euler、CFG 1.0、LoRA 強度 1.0、ネガティブプロンプトなし、そして 1024x1024 のテキストから画像です。ベースファイルはComfy-Org/Qwen-Image-2.1から取得するため、コンシューマー向け VRAM を使う人にとってint8_convrottransformer が現実的なターゲットになります。
ComfyUI は Day-0 リリース 以来 Qwen-Image 2.1 をネイティブでサポートしているため、追加でインストールする必要はありません。ManualSigmas と SamplerCustom を備えた最新の ComfyUI があれば、同梱された両方のワークフローをカバーできます。
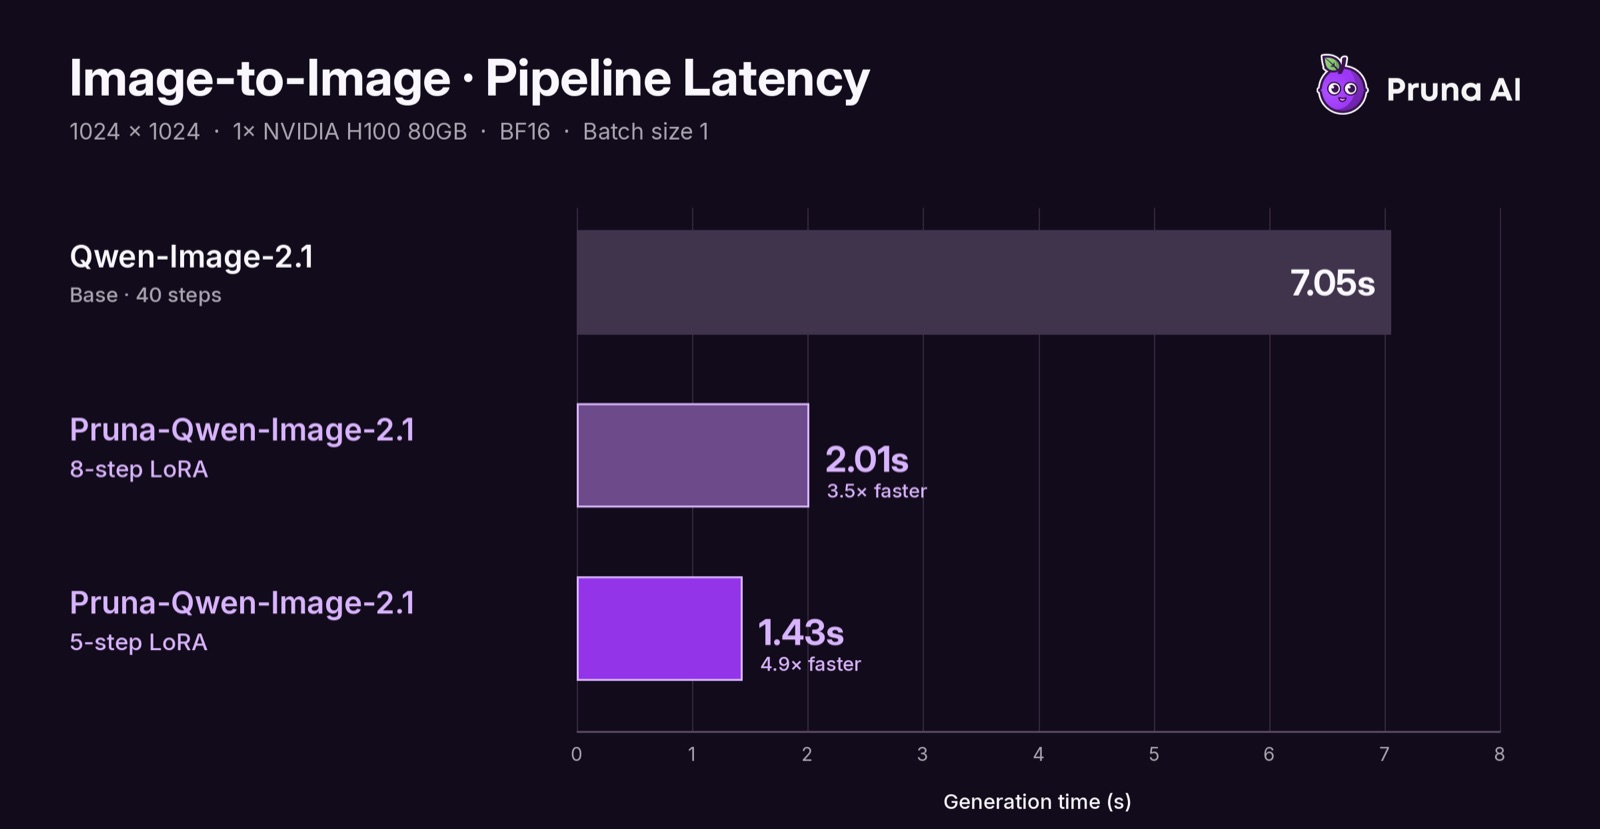
モデルカードの編集サンプルで、少数ステップのアダプターで実行したもの。
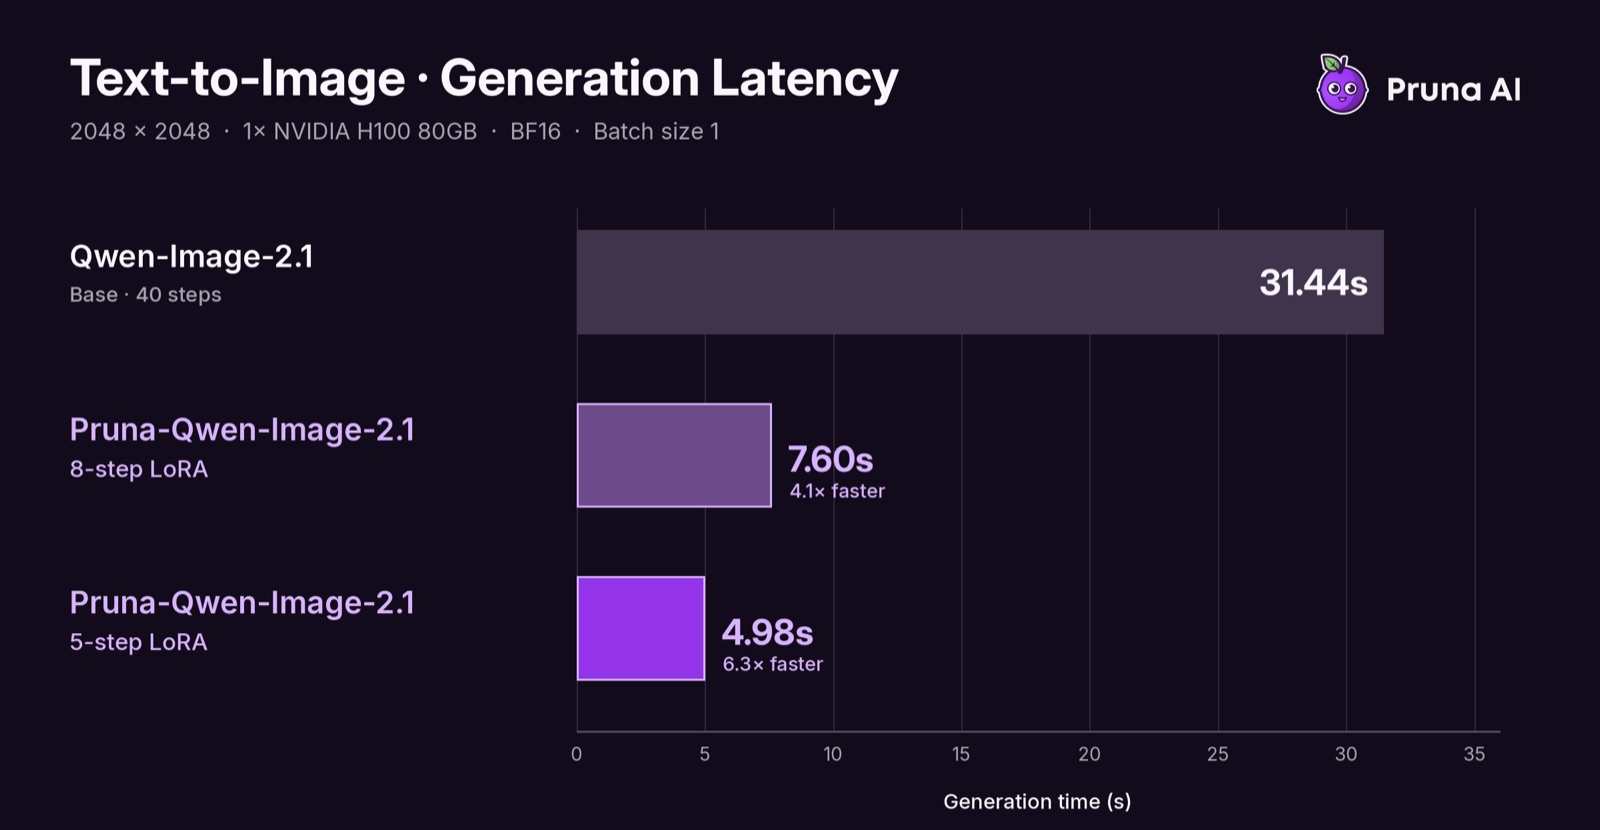
2048 でのテキストから画像。1K のトレーニング対象範囲外ですが、公開されたレイテンシ測定の一部です。
初期のテストは、リリース自体よりも主に ComfyUI コミュニティから出ています。アダプターは Banodoco の #qwen-image チャンネルで Viggle の turbo や公式の Qwen Acc LoRA と比較され、テスターは 8 ステップのアダプターを特に注目しました。また、重みが公開された直後に r/StableDiffusion や X にも投稿されました。
コメント
GitHubでサインインしてディスカッションに参加しましょう。