Qwen-Image 2.1 Fun ControlNet Union: 8つの制御を1ファイルに集約
Alibaba PAIのQwen-Image 2.1向けControlNet Unionは、8種類の構造制御とインペイントを1つの7.5 GBブランチにまとめ、ComfyUIサポートも登場します。
Qwen-Image 2.1 は2026年9月20日に、同じ重みで生成と編集を行い、実際のRGBAアルファを書き出す7BのシングルストリームDiTとして登場しました。ControlNet-Unionブランチは、Alibaba PAIがMiniMax H3でたどったのと同じ道を進みます。すべての条件をカバーする単一の制御checkpointなので、条件ごとに重みを切り替える必要はありません。
1つのブランチ、8つの条件
公開されたファイルには制御ブランチのみが含まれます(control_img_in と16個の control_blocks、モデルカードによれば約7.0 GB、ディスク上では7.55 GB)。これはベースのQwen-Image 2.1 transformerの上に strict=False で読み込まれ、ベースは凍結されたままなので、ベースの重みはそのまま再利用されます。
| 制御条件 | Canny、Depth、Grayscale、HED、Lineart、MLSD、Pose、Scribble |
| 制御ブランチの深さ | 16ブロック、32個のtransformerブロックのうち2つごとに1つのskip(control_layers = [0, 2, 4, ..., 30]) |
| 制御入力の幅 | control_in_dim = 129: 制御latent(64)+ マスク(1)+ マスク画像latent(64) |
| 注入 | 各制御ブロックのzero-gatedな before_proj / after_proj をメインブランチに加算 |
| サンプリング | CFG蒸留済み。サンプルスクリプトは guidance_scale = 1.0 で実行(ステップごとに1回のforward pass) |
| テキストエンコーダー / VAE | プロンプトと条件画像にはQwen3-VL processor、VAEはRGBAをデコードするためプレビューはPNGとして保存 |
control_context_scale は、メインブランチに加算される前のすべての制御skipをスケーリングします。1.0 は公開されているすべての結果で使われた最も強い設定で、値を下げるとガイダンスが弱まり、0.0 で制御ブランチがオフになります。
制御条件
| 条件 | 制御信号 |
|---|---|
| Canny | Cannyエッジマップ |
| Depth | 単眼深度マップ |
| Grayscale | グレースケール(輝度)画像 |
| HED | HEDエッジ検出マップ |
| Lineart | 線画抽出 |
| MLSD | 線分検出マップ |
| Pose | DWPoseスケルトン |
| Scribble | フリーハンドまたはスケッチ線 |
ターゲットキャンバスに合う通常のRGB制御画像であればどれでも機能します。モデルカードによれば、線の太さやしきい値、クロップの違いを許容します。以下のサンプルはすべてモデルカードのもので、40推論ステップ、control_context_scale = 1.0、seed 43で生成され、左が制御信号、右が生成結果です。
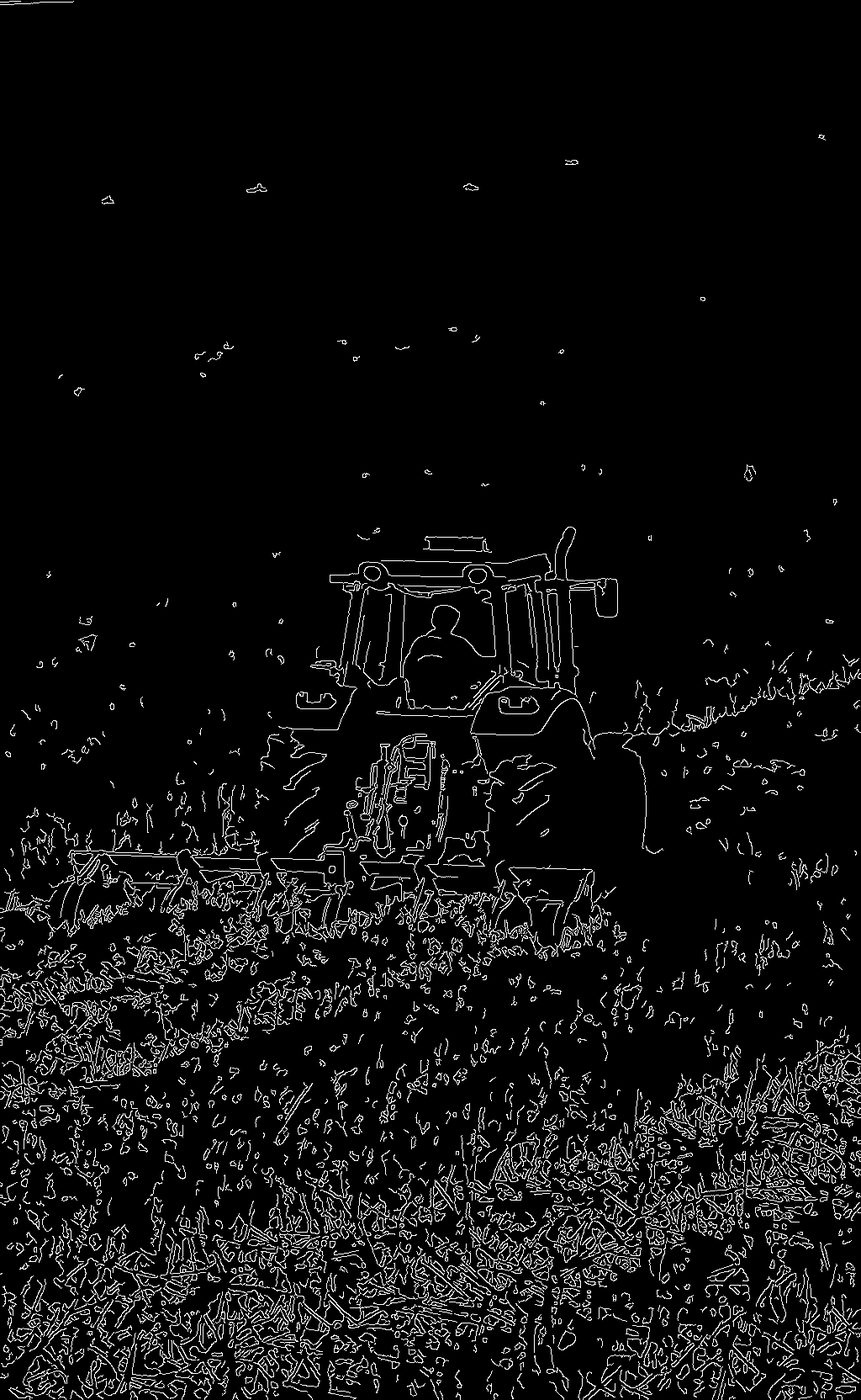 | 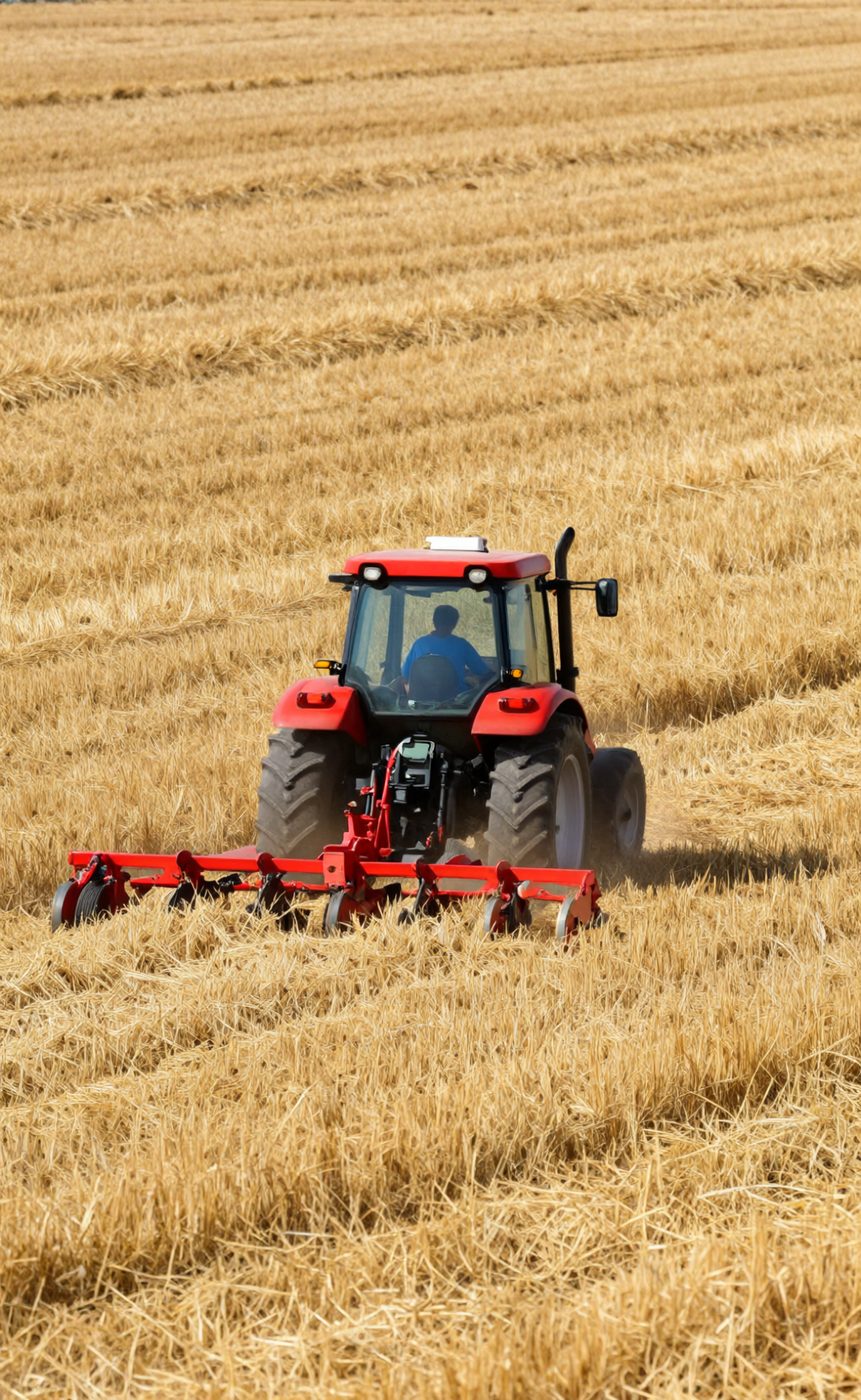 |
|---|---|
| Cannyエッジマップ | 生成出力 |
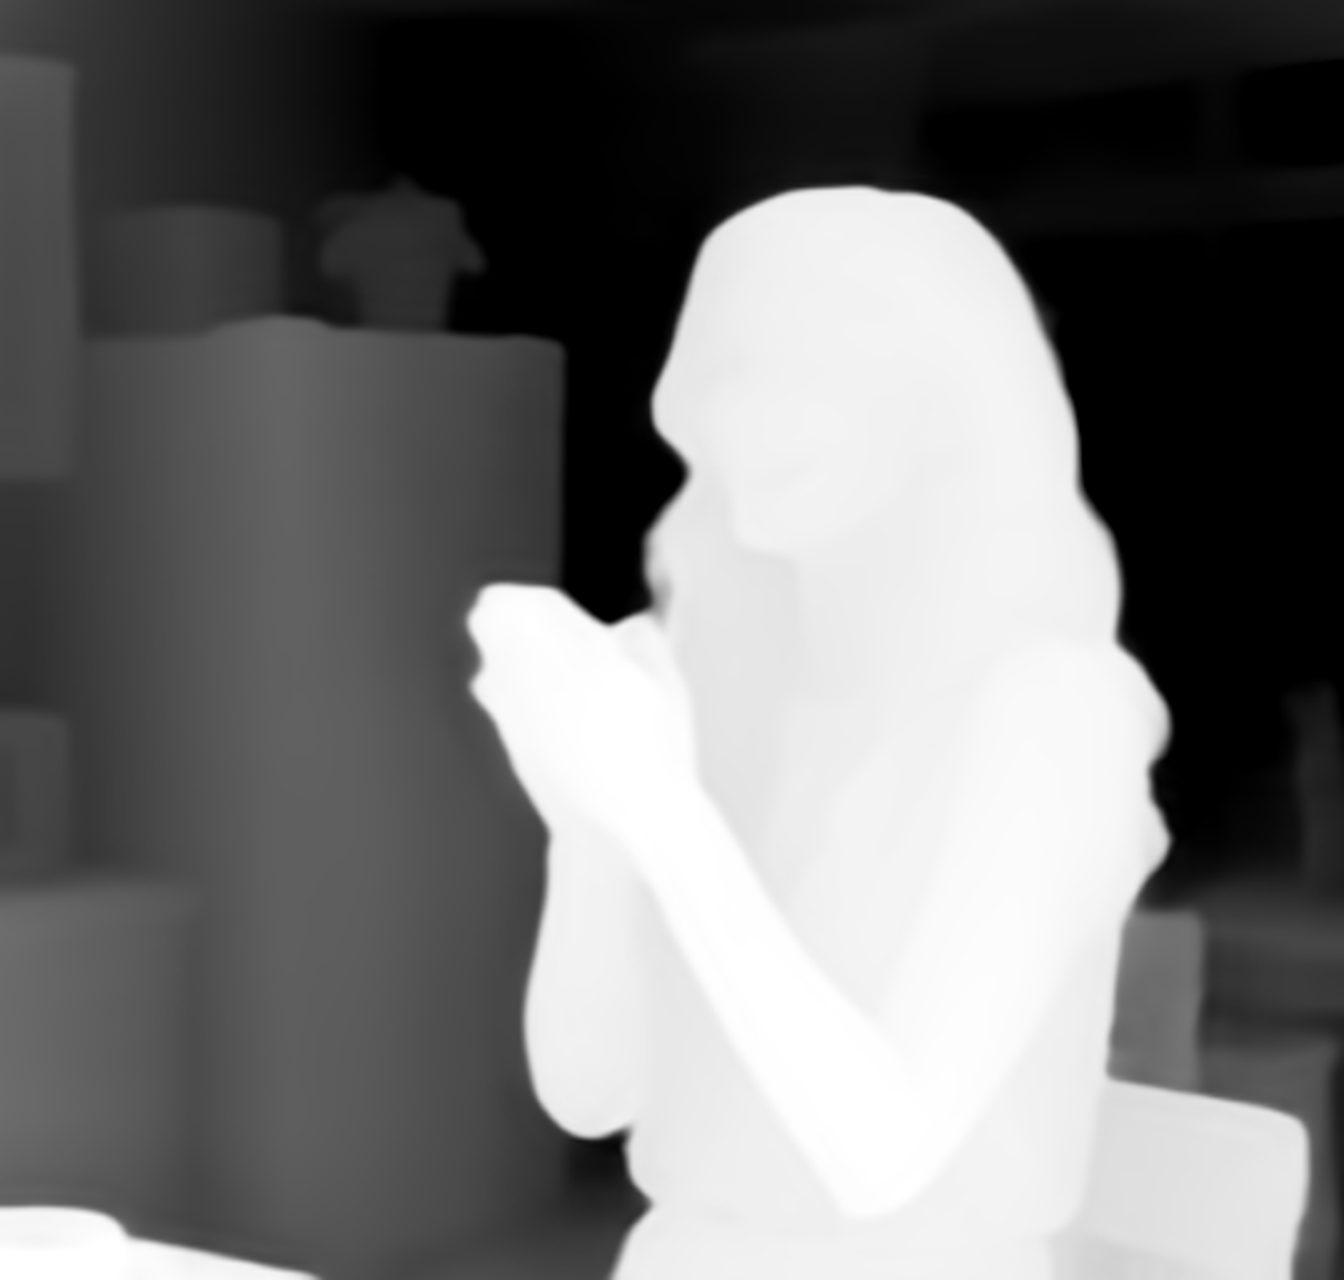 | 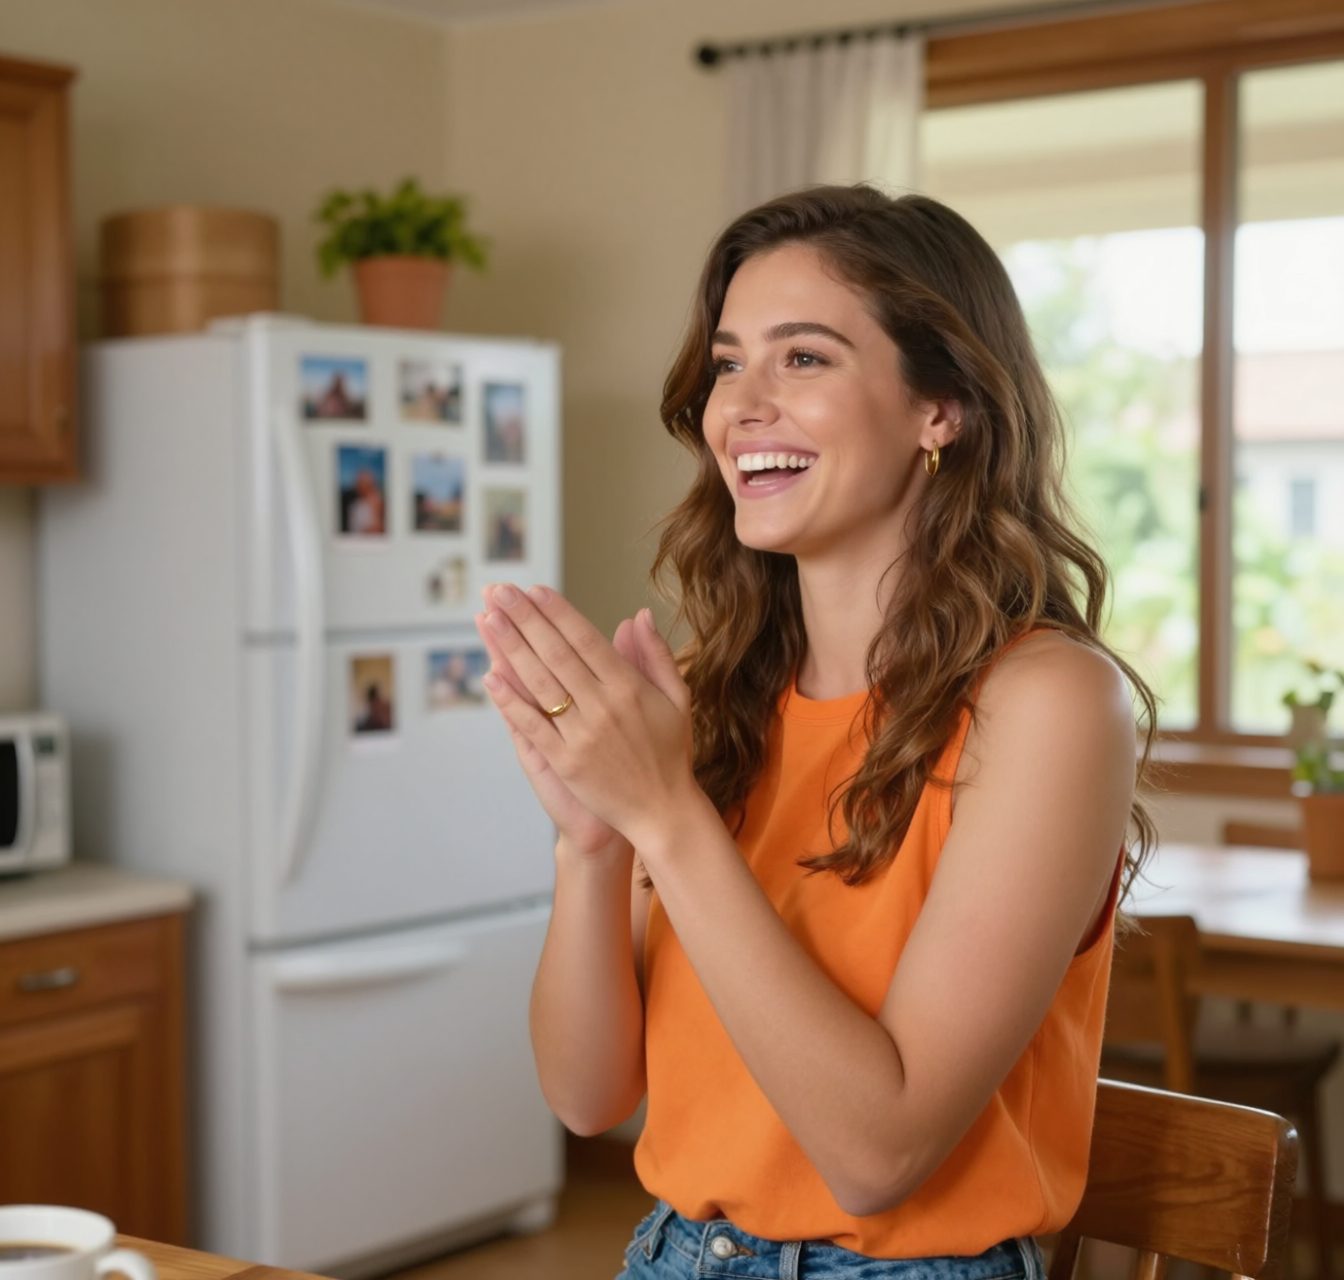 |
|---|---|
| 深度マップ | 生成出力 |
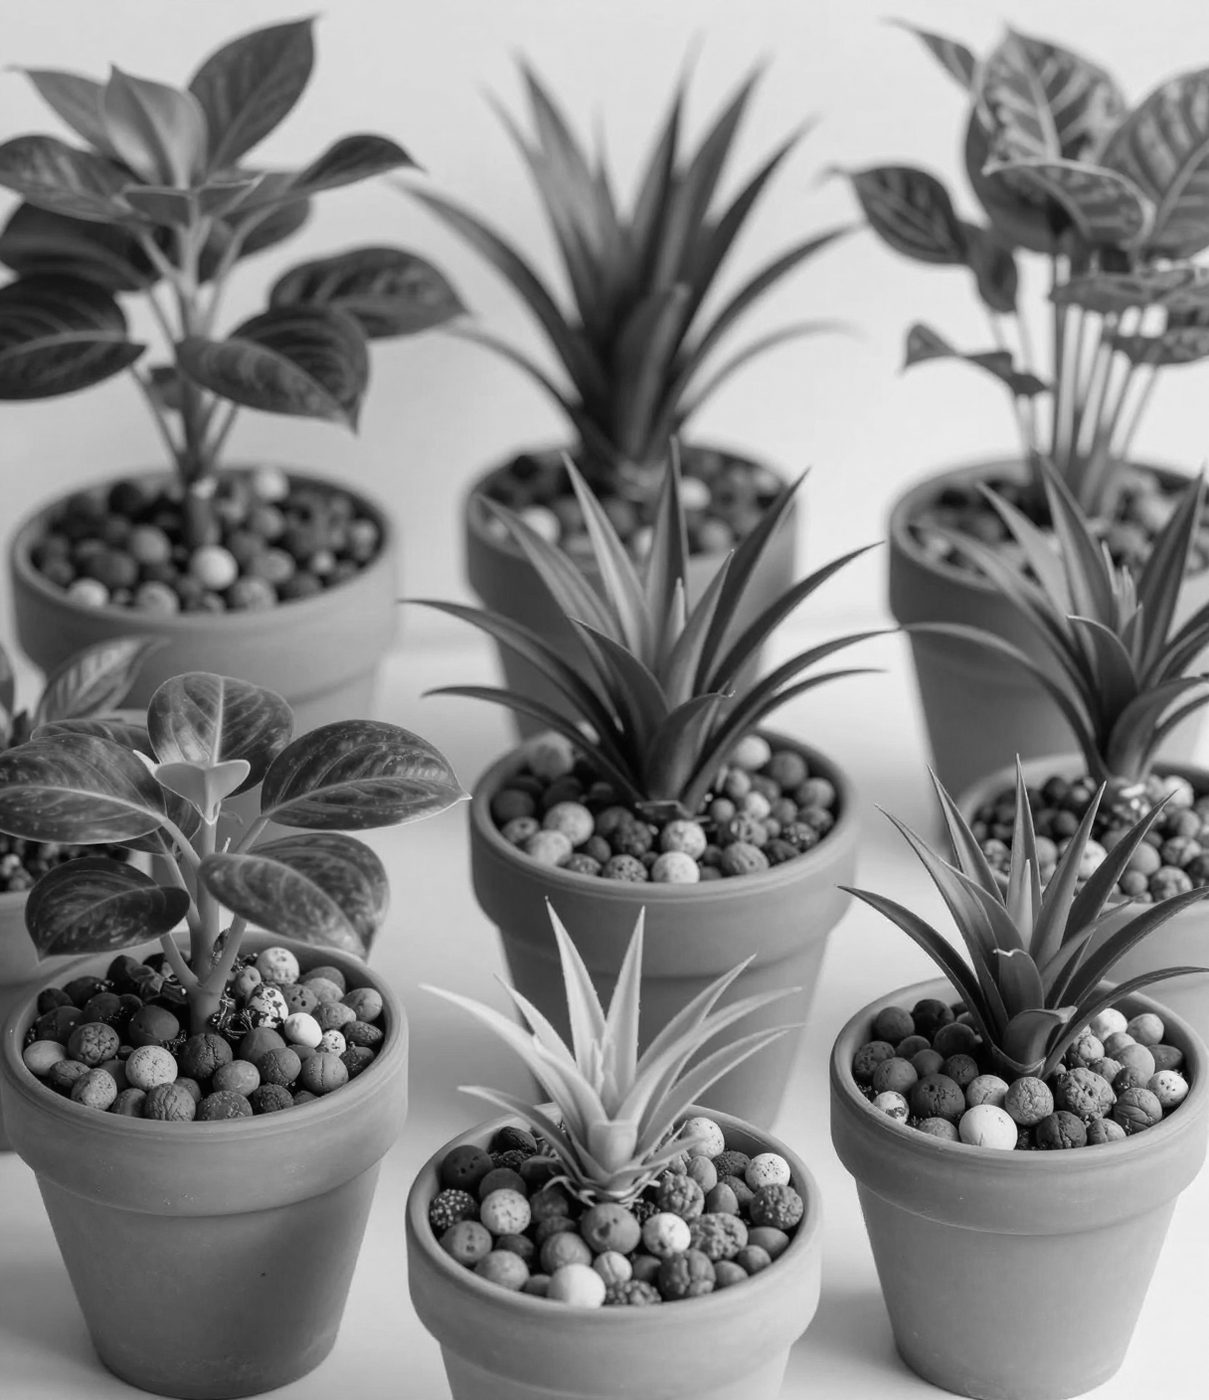 | 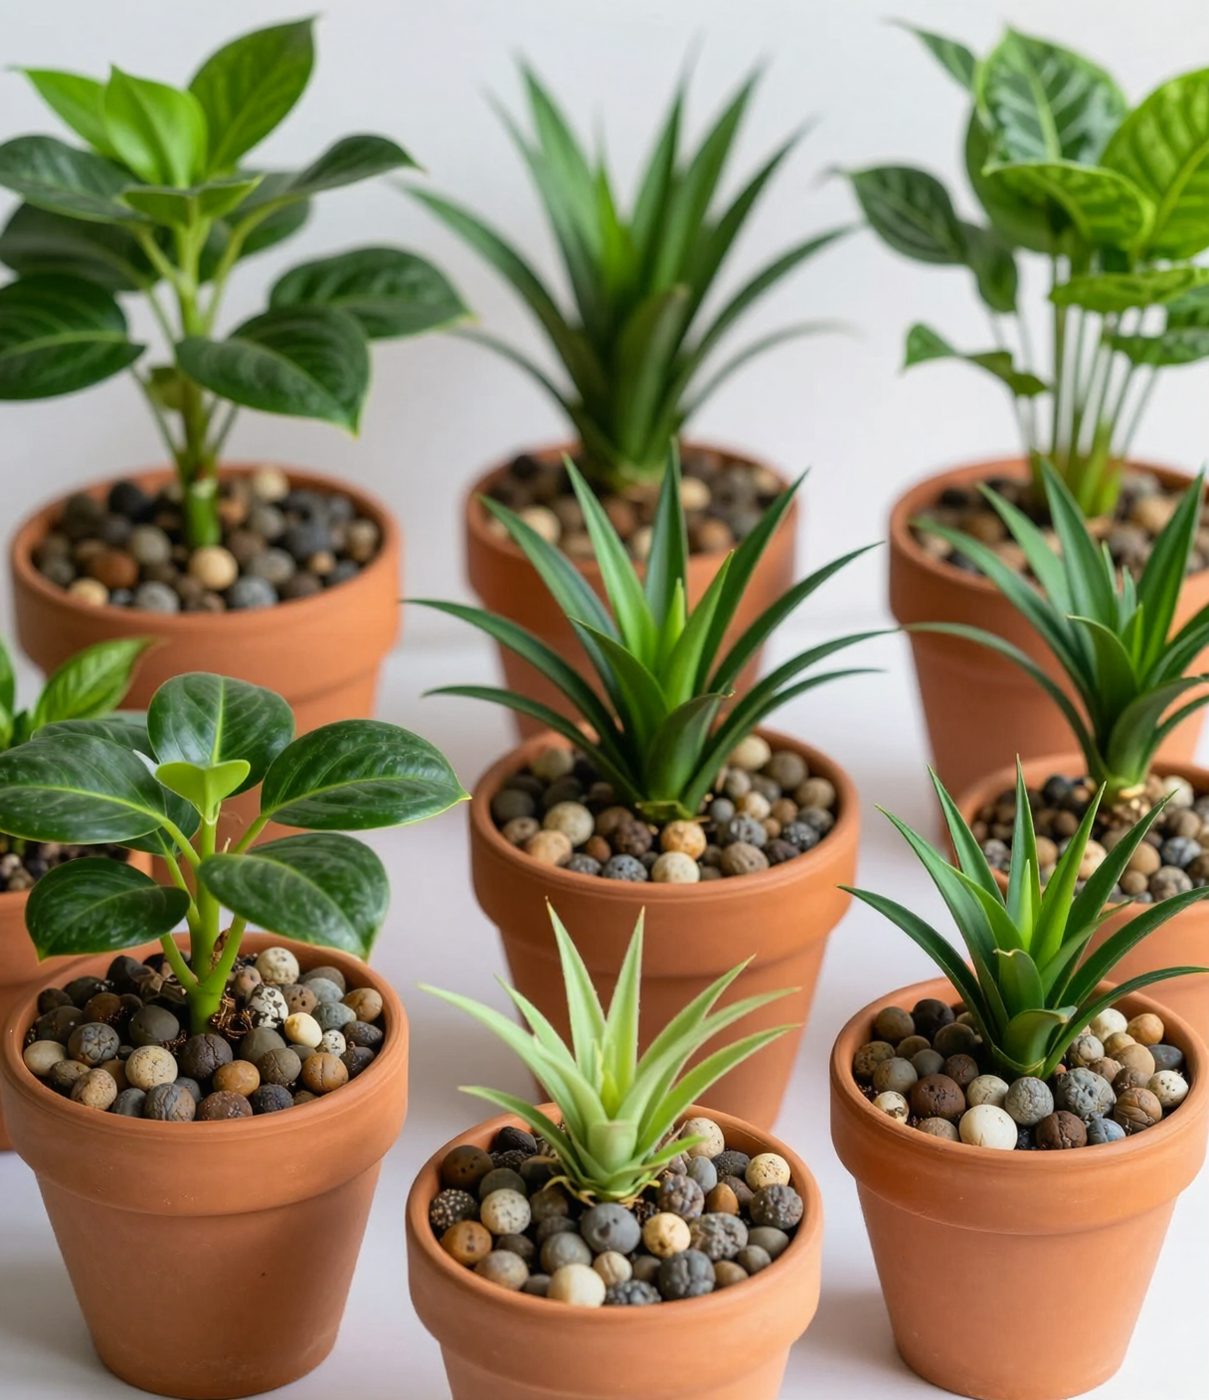 |
|---|---|
| グレースケール画像 | 生成出力 |
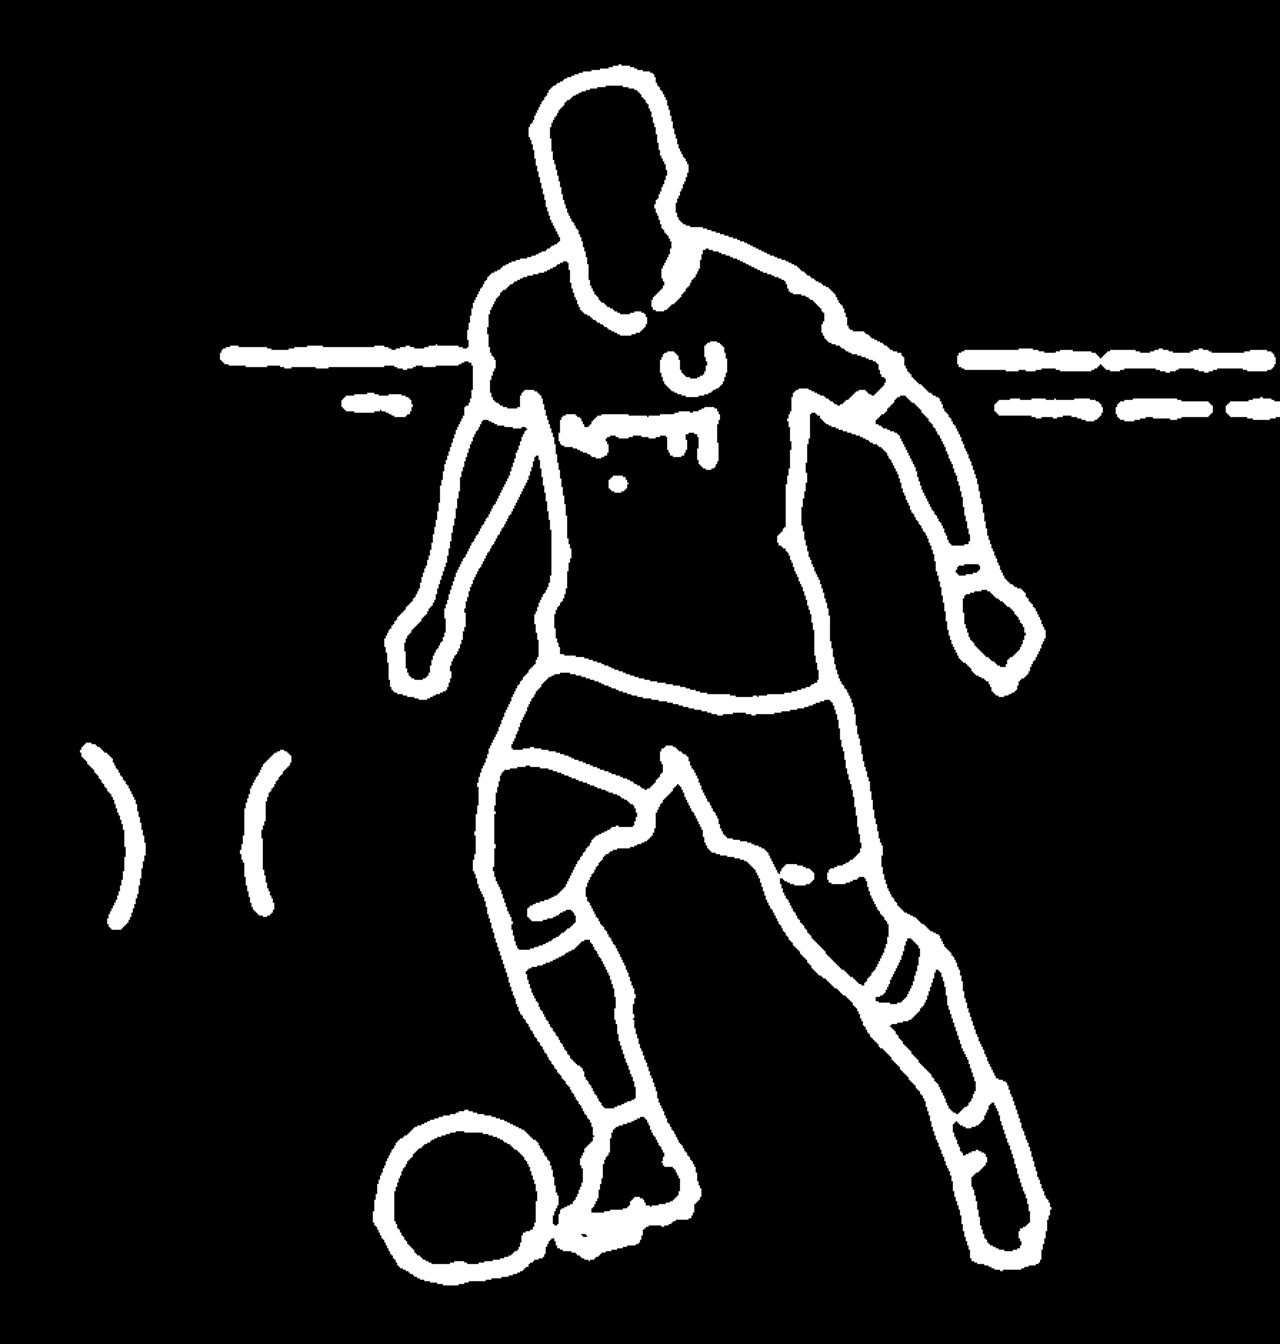 | 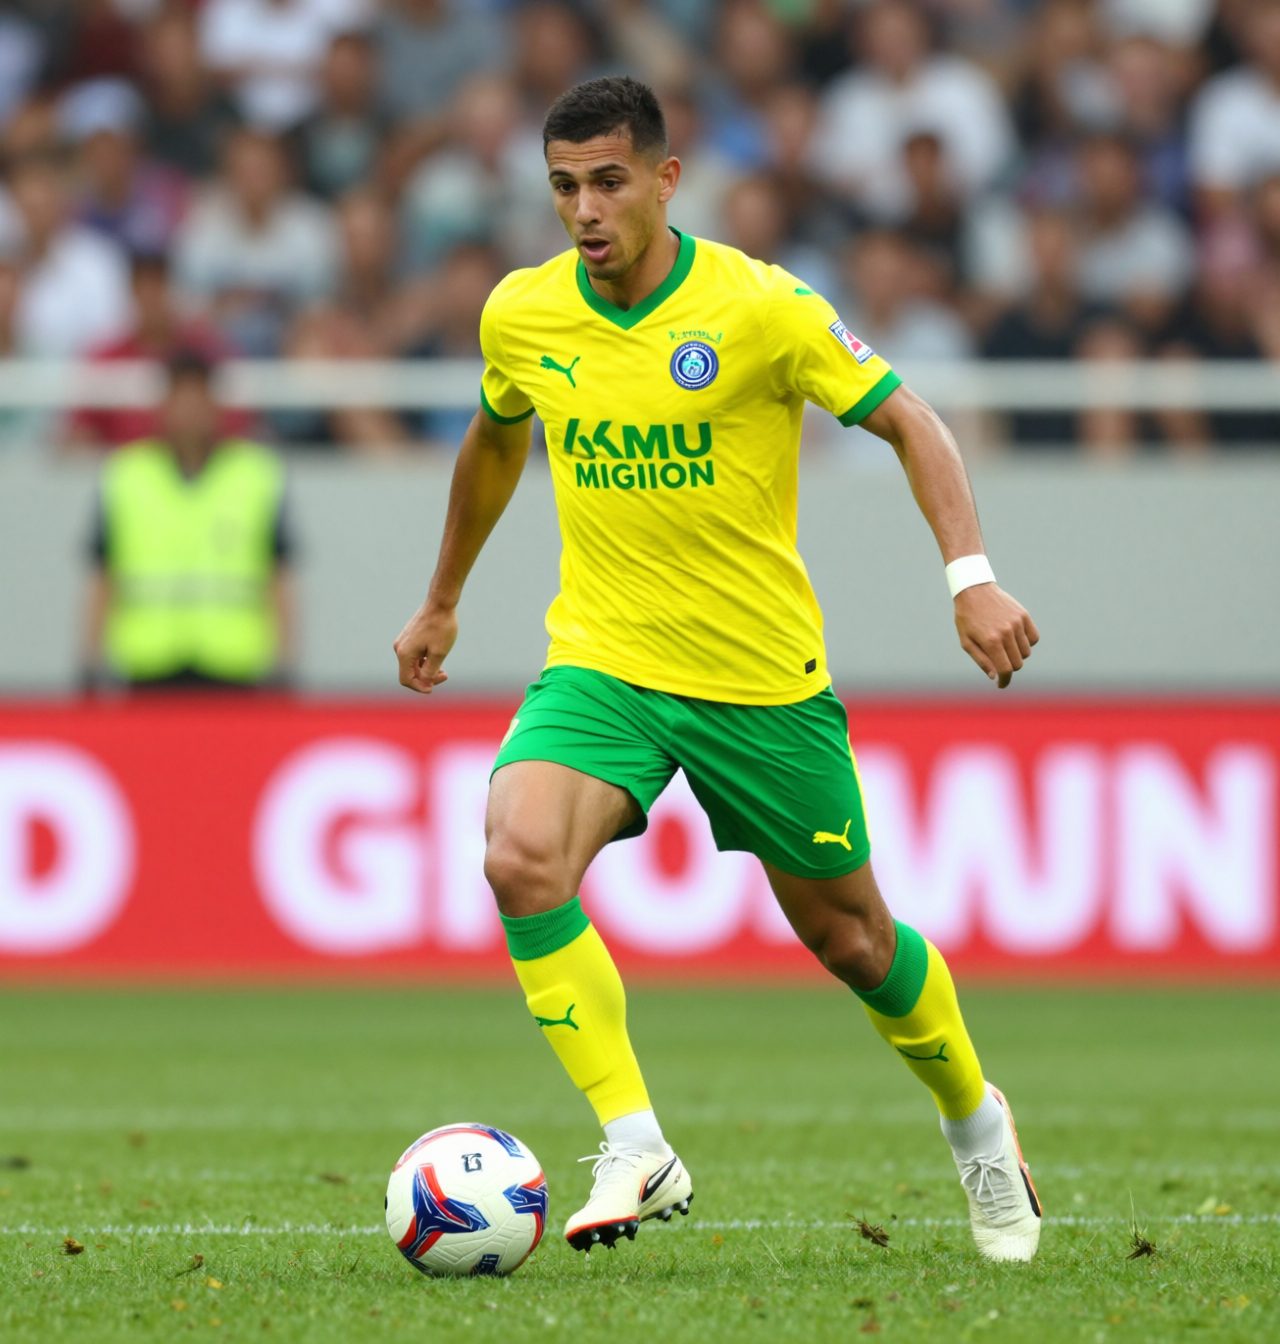 |
|---|---|
| スクリブルスケッチ | 生成出力 |
残りの条件(HED、Lineart、MLSD、Pose)も同じパターンでモデルページに掲載されています。
インペイントも同じブランチを共有
制御入力を129チャンネルに広げているのは、まさに1つのブランチで両方の役割をこなすためです。制御latent、保持マスク、マスク画像latentがブランチに入る前に連結されます。純粋な制御ではマスクとマスク画像のチャンネルがゼロパディングされるので、同じcheckpointで通常のCannyやDepthも実行できます。インペイントではマスク領域がプロンプトから描き直され、フレームの残りの部分は保持されます。両者は組み合わせることもでき、制御画像とマスクを一緒に入力すると、描き直された領域はプロンプトと指定された構造の両方に従います。
マスクはコンテンツを再生成する場所が白、保持する場所が黒です。再生成されたピクセルはミッドグレー、つまりVAEの [-1, 1] 入力範囲のゼロでエンコードされるため、手を付けていない領域は往復を経ても維持されます。
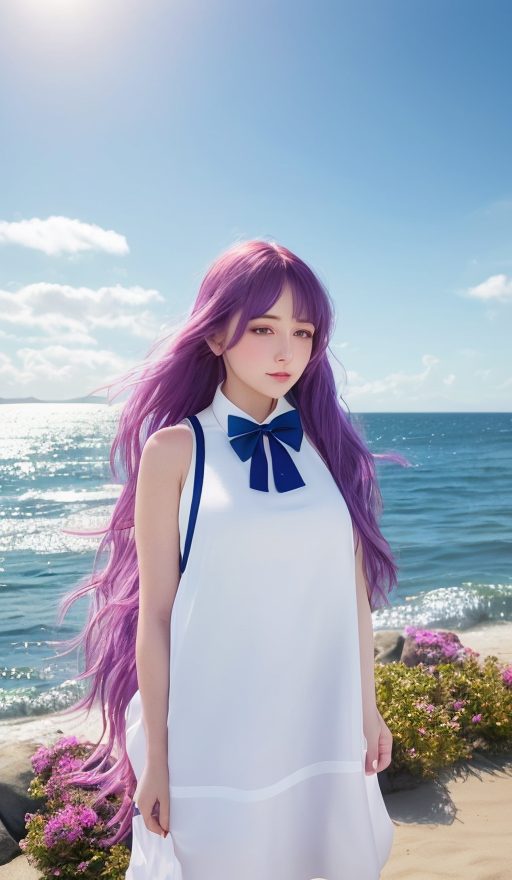 | 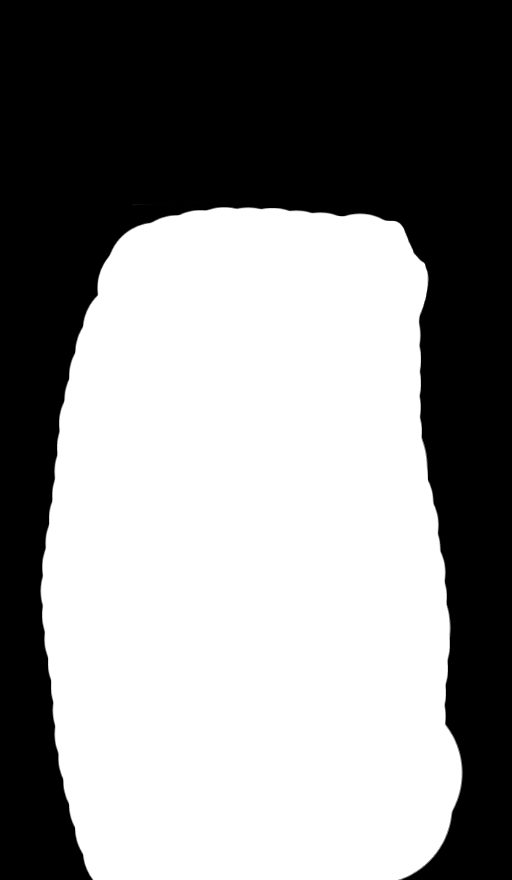 | 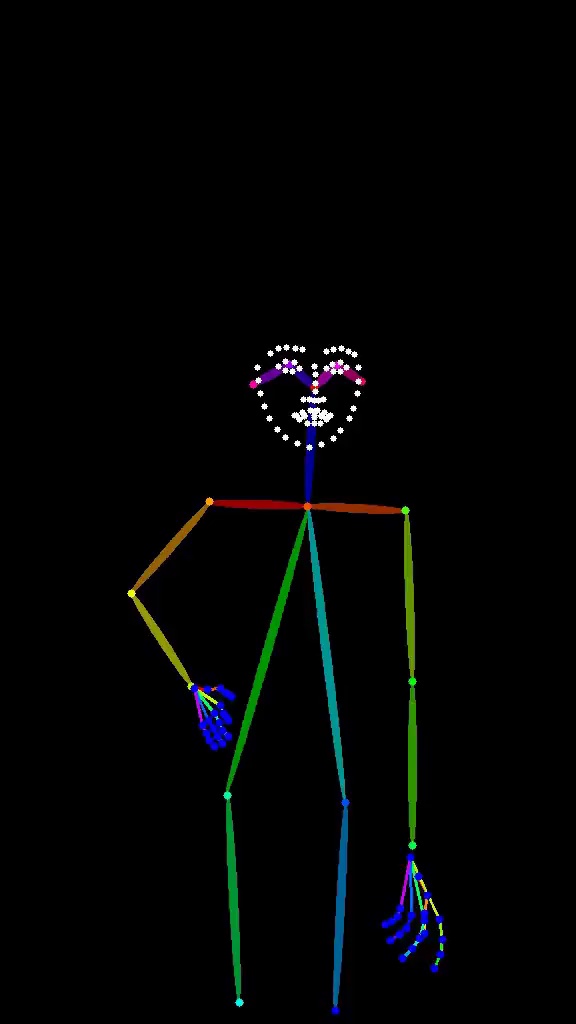 | 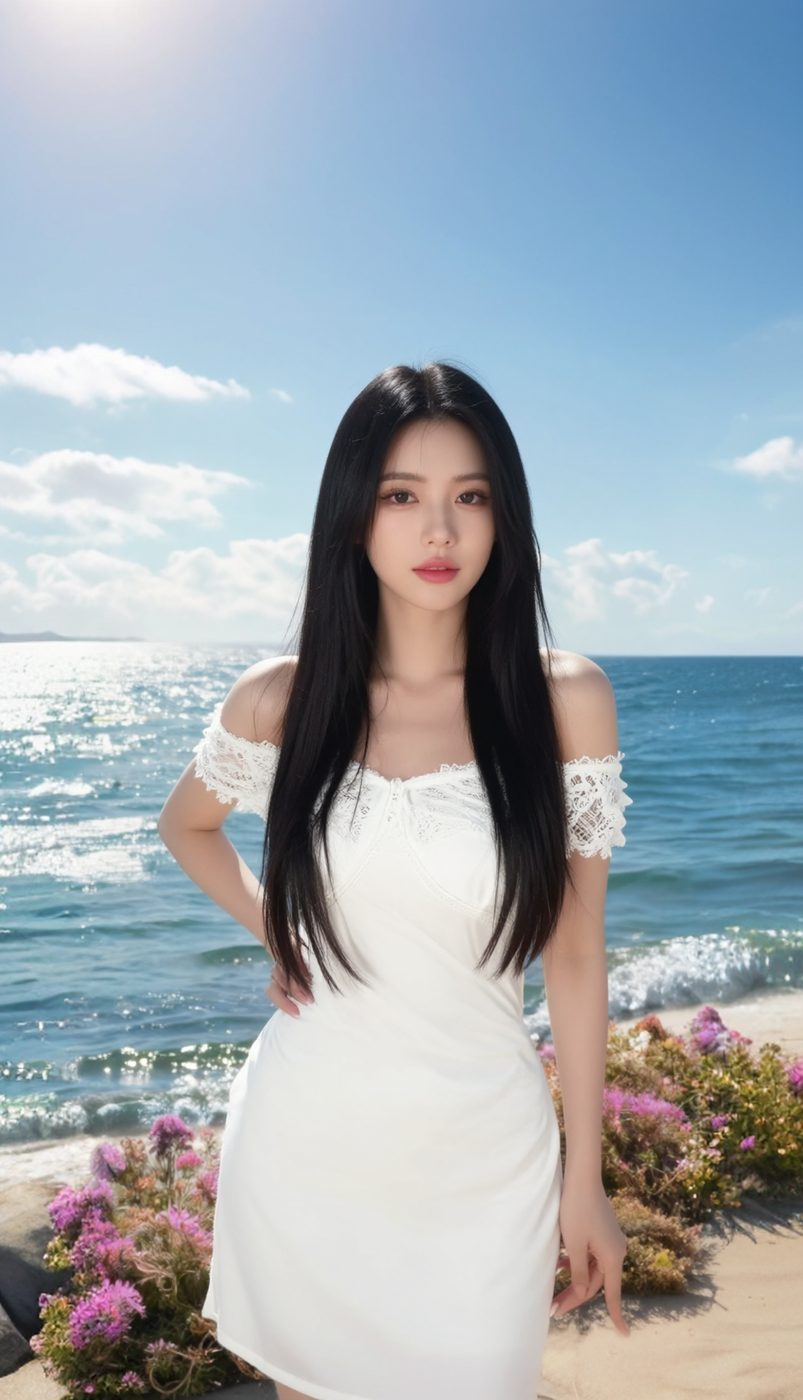 |
|---|---|---|---|
| ソース画像 | マスク | Pose制御 | インペイント出力 |
ComfyUIサポート
ComfyUIのサポートはリリース済みではなくレビュー中です。Kijai氏は2026年9月24日にPR #16519(「Support Qwen-Image 2.1 union fun controlnet」)を開き、4つのファイルを変更しています。
comfy/ldm/qwen_image21/model.pyにQwenImage21FunControlとQwenImage21FunControlBlockを追加します。VACEスタイルのブランチで、制御latentをターゲット行にシードし、1つのベースブロックの後に各ブロックのafter_projskipを加算し直します。comfy_extras/nodes_model_patch.pyは ModelPatchLoader にレイアウトを教えます。checkpointをcontrol_img_inとcontrol_blocks.0.img_mlp.out.weightで検出し、ブロック数、control_in_dim、head dim、MLP比率をstate dictから導出するので、1つのローダーでこのcheckpointファミリーに対応します。量子化ファイルは混合精度演算で読み込まれ、レイヤーは量子化されたままbf16で計算されます。comfy_extras/nodes_qwen.pyは QwenImage21FunControlNetApply(「Apply Qwen Image 2.1 Fun ControlNet」)を追加します。入力はmodelとmodel_patch、strength(デフォルト1.0)、start_percent/end_percent、そして任意のcontrol_image、inpaint_image、mask(「1が再生成する領域を示す」)です。comfy/controlnet.pyはQwen Funローダーの検出を厳密にし、新しいcheckpointが古いControlNetレイアウトと誤認されないようにします。
PRがレビュー中の間に、Kijai氏はすでに変換済みのComfyUIパッチを公開しています。
- qwen_image_2.1_fun_controlnet_union_bf16.safetensors
- qwen_image_2.1_fun_controlnet_union_int8_convrot.safetensors
Comfy-Org/workflow_templates にはこれ用の公式ワークフローテンプレートがまだないため、以前のQwen-Imageテンプレート(image_qwen_image_controlnet_patch、image_qwen_image_instantx_inpainting_controlnet)は古いモデル向けであり、ここでは使えません。
入手方法
ComfyUI以外では、checkpointは VideoX-Fun 経由で実行します。VideoX-Fun をクローンし、ベースのQwen-Image 2.1モデルと制御checkpointを models/Diffusion_Transformer/ に置き、examples/qwenimage21_fun/predict_t2i_control.py(インペイントなら predict_i2i_inpaint.py)を実行します。このブランチはコミット「Update Qwen Image 2.1 Control and Flex Forcing」で追加されました。
モデルカードの4つの注意点は覚えておく価値があります。
config_pathは 必ずconfig/qwenimage21/qwenimage21_control.yamlでなければなりません。これはcheckpointが想定する通りの制御ブランチ(control_layers: [0, 2, 4, ..., 30]、control_in_dim: 129)を構築します。他のconfigを使うと制御重みが黙って欠落したり位置ずれしたりして、誤った出力になります。sample_sizeは出力キャンバスを設定します。制御マップが歪まないよう、両辺を16の倍数に保ってください。use_kv_cache = Trueは最初のdenoiseステップの後にテキストと条件画像のキーをキャッシュし、固定解像度での生成を高速化します。- メモリ: transformerとQwen3-VLテキストエンコーダーを合わせると、コンシューマー向けGPU 1基に完全に読み込むことはできません。モデルカードは最速の選択肢として
model_group_offload、またはハイメモリのGPU 1基ではmodel_cpu_offload_and_qfloat8を推奨しています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。