Qwen-Image 2.1プロンプトエンハンサーモデルがComfyUIで動作
QwenのPE-T2IとPE-I2Iプロンプト書き換えモデルは短いリクエストや編集指示を展開し、コミュニティのノードパックがCLIPを読み込むことで両方をComfyUIで実行します。
2つのリライター、それぞれのタスクに1つ
PEチェックポイントはQwen3.5-VL 9Bをファインチューニングしたモデルで、ベースモデルとともに2026-09-20に公開されました。公式のQwen-Image 2.1 READMEでは、プロンプトを準備する既定の方法としてこれらを推奨しています。「最良の結果を得るには、公式のプロンプト書き換えモデルを使用して、短いプロンプトを詳細で高品質な記述に展開することをお勧めします。」
- PE-T2Iは、任意の言語の簡潔なリクエストを、長い英語プロンプトと推奨アスペクト比に変換します。応答は
thinkブロックの後にJSONとして返されます:{"rewritten_prompt": ..., "wh_ratio": "16:9"}。 - PE-I2Iは、編集指示と最大10枚の参照画像を受け取り(
<image1>、<image2>などとして指定)、正確な編集プロンプトを返します。そのJSON応答にはratio_followが追加され、出力が引き継ぐべきアスペクト比を持つ入力画像を指定します。
どちらもthinkingを有効にしてサンプリングすることを想定しています。公式の例ではtemperature 1.0、top_p 0.95、top_k 20を使用し、テキストから画像へのチェックポイントではmax_new_tokens 16256、編集用では24000を使用します。
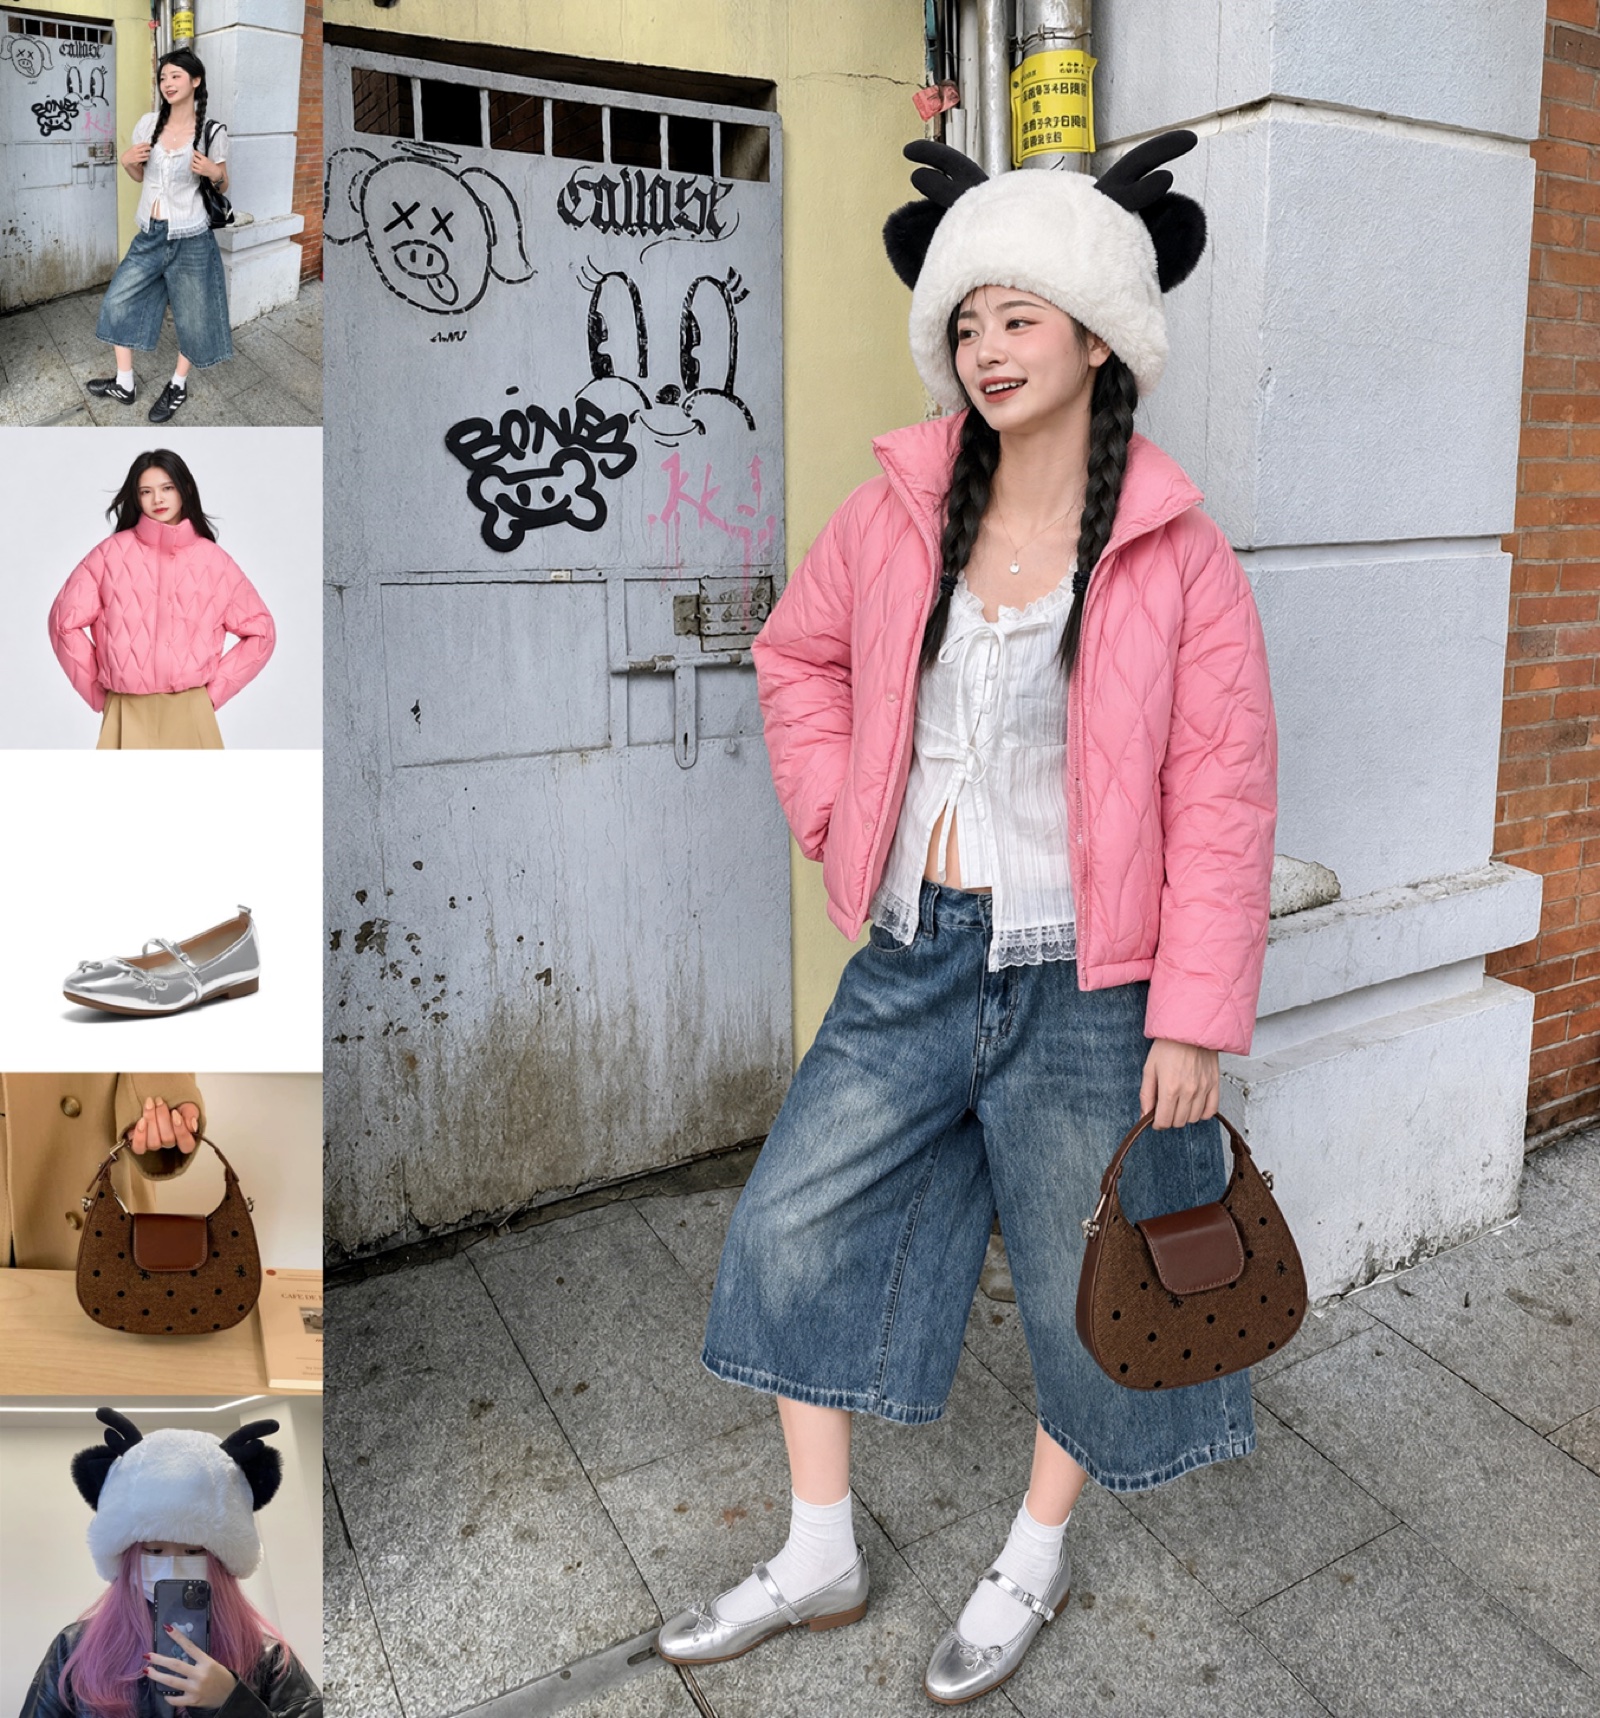
Qwen-Image 2.1の公式例: 5枚の参照画像から組み立てた衣装。PE-I2Iリライターが明示的なプロンプトに変換するよう学習している、まさにこの種の複数画像指示です。
ComfyUI内で実行する
ComfyUIの3つの公式Qwen-Image 2.1テンプレートはテキストから画像へ、画像編集、背景除去をカバーしていますが、いずれもリライターを呼び出しません。Comfy-Orgは2つのPE重みをComfy-Org/Qwen-Image-2.1内でint8 convrotファイルとして再パッケージ化しました(text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensorsと..._pe_i2i...)。しかし、読み込むだけでは半分に過ぎません。チャットプロンプトを構築し、JSONを読み戻し、その結果をサンプラーに渡す処理が依然として必要です。
このノードパックは、Qwen Imageカテゴリに登録された2つのノードでまさにそれを行います。
| ノード | 入力 | 出力 |
|---|---|---|
QwenImage21_T2IPromptRewrite | CLIP、プロンプト、サンプリング設定 | positive_prompt、negative_prompt、wh_ratio、thinking、parse_ok |
QwenImage21_EditPromptRewrite | CLIP、プロンプト、image_1 … image_10 | 同上、加えてratio_follow |
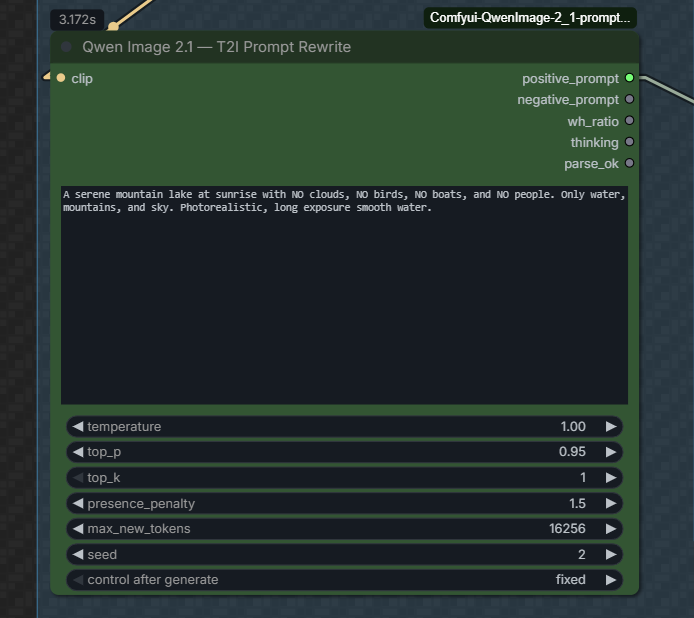
T2I書き換えノード: 短いプロンプトを入力すると、展開されたプロンプト、アスペクト比、推論トレースが出力されます。
PEファイルは通常のLoad CLIPノードでtype = qwen_imageとして読み込まれ、生成はComfyUI独自のclip.tokenize() → clip.generate() → clip.decode()の経路で実行されます。これは組み込みのTextGenerateノードの背後にあるのと同じ仕組みです。外部サーバーも、別個のtransformersパイプラインも不要です。
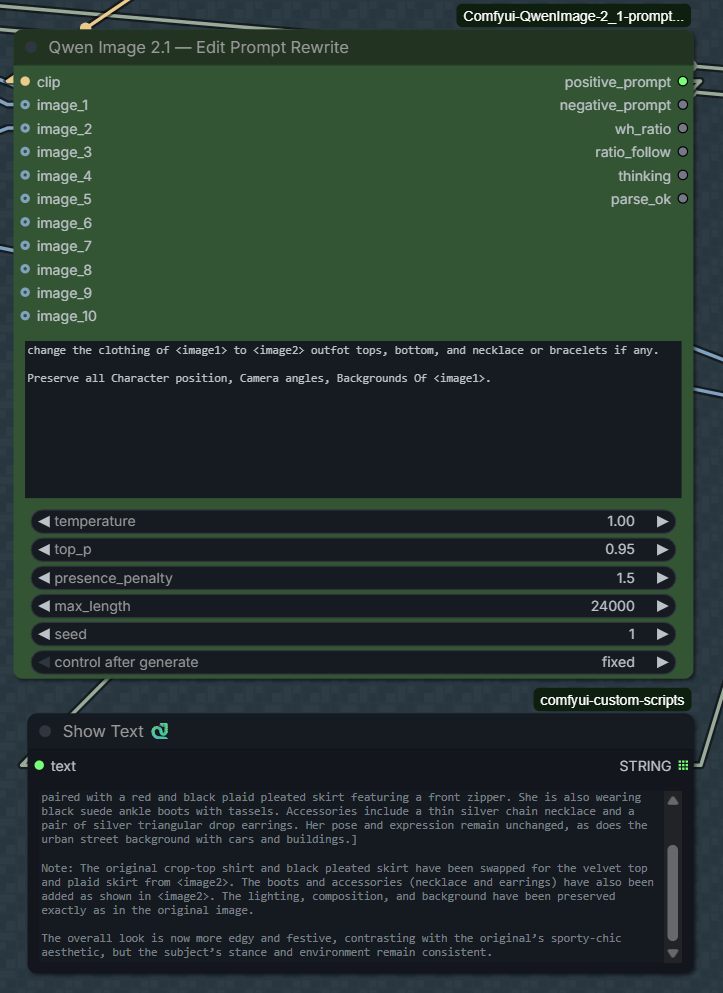
編集ノードは10個の画像スロットを公開し、書き換えられた指示と継承すべき比率を返します。
いくつかの設定はREADMEからコピーする価値があります。2つのチェックポイントで共通していないためです。
| パラメータ | T2I | Edit |
|---|---|---|
presence_penalty | 1.5 | 0 |
max length | 16256 | 24000 |
thinking | on | on |
高いペナルティはテキストから画像へのリライターが同じことを繰り返すのを防ぎますが、編集リライターはそれなしで実行することを想定しています。両モデルともthinkブロック付きで学習されているため、このパックはJSONを解析する前に推論トレースと回答を分離し、回答が正しく解析されたときにparse_okを報告します。オプションのjson_repairパッケージをインストールすると、失敗する代わりにわずかに不正な形式の回答を修復できます。
グラフへの組み込み
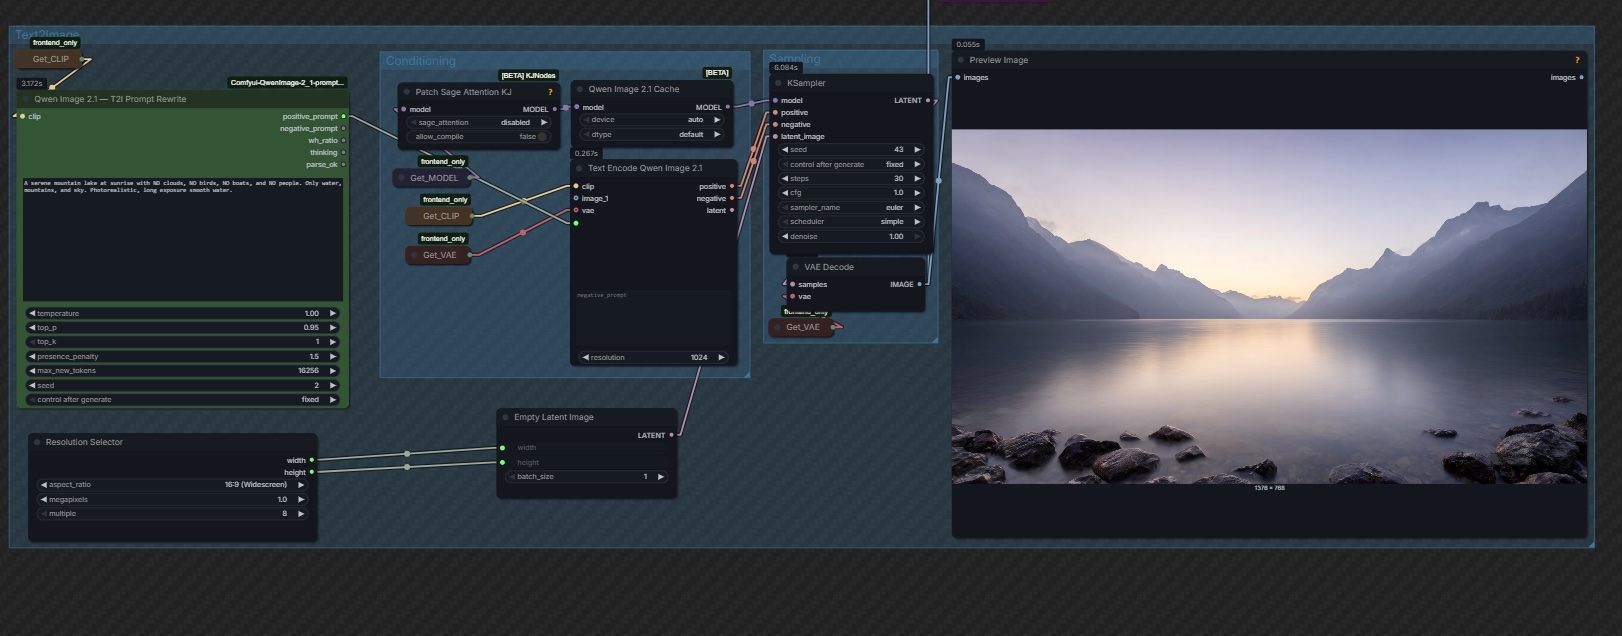
READMEのグラフ: PEチェックポイントを読み込むLoad CLIPが書き換えノードに供給され、そのpositive_promptがText Encode Qwen Image 2.1へと続きます。
テキストから画像への実行では、書き換えられた文字列がテキストエンコードノードに入力するはずだった内容を置き換え、wh_ratioは手動で選んだ幅と高さの代わりに解像度セレクターを駆動できます。編集実行では、参照画像がノードの画像スロットに入り、指示がそれらを<image1>や<image2>として参照し、ratio_followが出力キャンバスをどの入力に合わせるかを決定します。
入手方法
- PE-T2I: Hugging FaceのQwen/Qwen-Image-2.1-PE-T2I
- PE-I2I: Hugging FaceのQwen/Qwen-Image-2.1-PE-I2I
- ComfyUI向けコピー:
text_encoders/配下のComfy-Org/Qwen-Image-2.1、int8 convrot - ノードパック: benjiyaya/ComfyUI-Qwen-Image-2.1-Prompt-Enhancer、
ComfyUI/custom_nodes/にクローン - 公式書き換えコード: Qwen-Image 2.1リポジトリの
prompt_rewrite/、transformers、vLLM、vLLMサーバーのエントリーポイント付き
コメント
GitHubでサインインしてディスカッションに参加しましょう。