 이미지 편집
도구
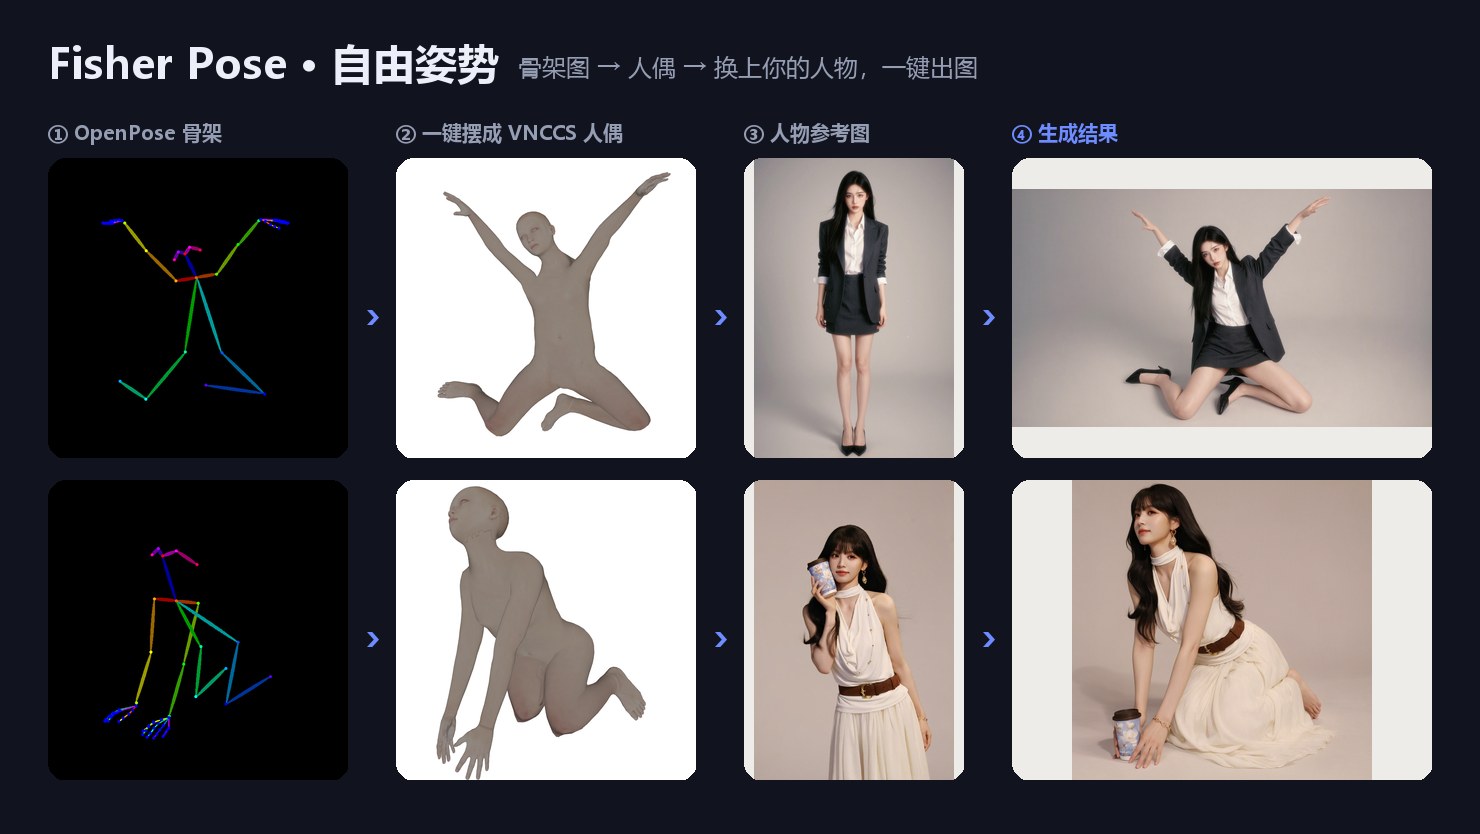
Fisher Pose: Qwen-Image 2.1용 포즈 및 카메라 편집기Fisher Pose는 3D 마네킹, 209개의 OpenPose 스켈레톤, 전용 LoRA를 사용해 Qwen-Image 2.1에서 캐릭터를 새로운 포즈나 카메라 앵글로 다시 그리는 ComfyUI 노드입니다.
ComfyUI 생태계 소식 — 오픈소스 모델 릴리스, 커스텀 노드, 워크플로, 이미지·비디오·오디오 생성 도구 업데이트.
이미지 편집Fisher Pose는 3D 마네킹, 209개의 OpenPose 스켈레톤, 전용 LoRA를 사용해 Qwen-Image 2.1에서 캐릭터를 새로운 포즈나 카메라 앵글로 다시 그리는 ComfyUI 노드입니다.
 텍스트→이미지
madebyollin의 Texture-Fix-VAE는 체커보드 텍스처 아티팩트를 제거하도록 Qwen-Image 2.1 VAE 디코더를 재학습한 모델입니다. 파일을 ComfyUI/models/vae에 넣고 평소처럼 로드하면 됩니다.
qwen-research
 텍스트→이미지
Alibaba PAI가 346MB PDD LoRA로 Qwen-Image 2.1을 4스텝으로 증류했습니다. 텍스트 기반 이미지 생성과 명령 기반 편집을 모두 지원하며 자체 시그마 스케줄을 사용합니다.
qwen-research
 텍스트→이미지
ByteDance의 Seedream 5.0 Flash가 ComfyUI ByteDance 이미지 노드에 속도 중심 티어를 추가하며, 최대 2K 해상도의 텍스트 기반 이미지 생성 및 이미지 편집 템플릿을 제공합니다.
API-Only
 텍스트→이미지
Alibaba PAI의 Qwen-Image 2.1용 ControlNet Union은 8가지 구조 제어와 인페인팅을 7.5 GB 브랜치 하나에 담았으며, ComfyUI 지원도 코어에 병합되었습니다.
qwen-research
 텍스트→이미지
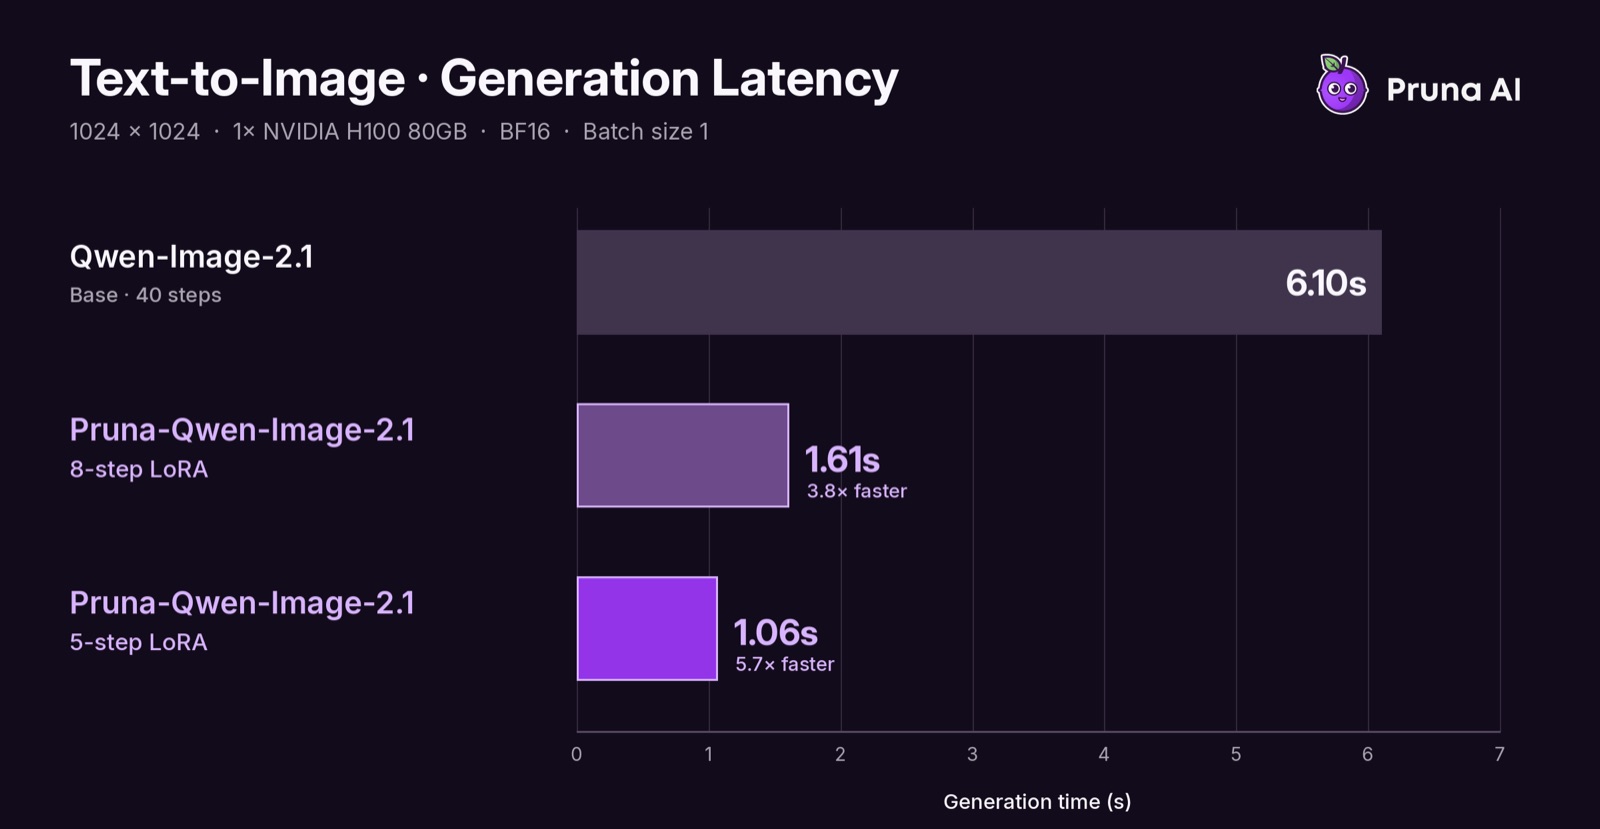
PrunaAI의 Pruna-Qwen-Image-2.1 LoRA는 CFG 없이 Qwen-Image 2.1 생성과 편집을 5단계 또는 8단계로 줄여 줍니다. 커뮤니티 ComfyUI 변환본과 단계별 시그마 스케줄도 함께 제공됩니다.
Qwen Research License
 텍스트→이미지
Viggle의 Qwen-Image 2.1 DMD 증류 버전 v0.2는 CFG 없이 생성 단계를 5스텝으로 줄였으며, 커뮤니티 ComfyUI 변환본과 함께 rank-256 LoRA로 제공됩니다.
Qwen Research License
 텍스트→이미지
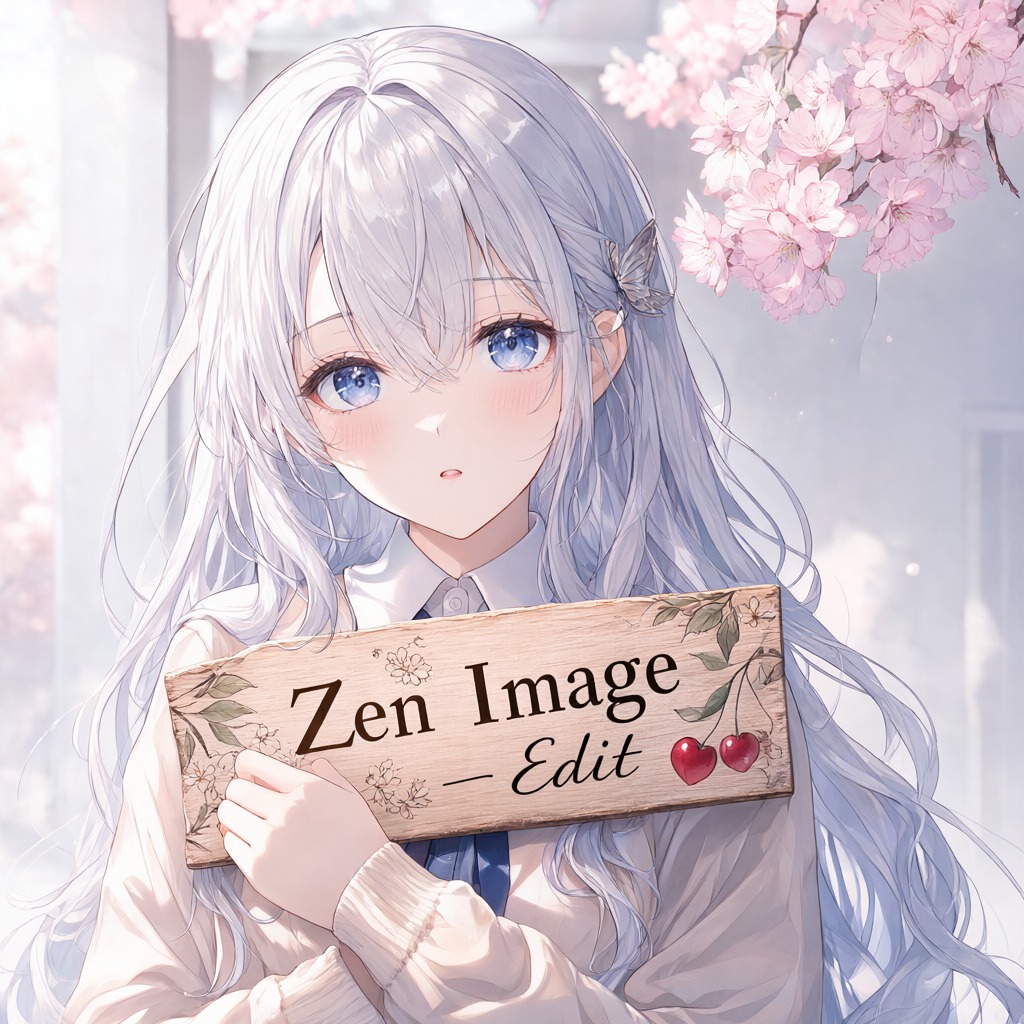
Zen Image Edit은 Qwen3.5-0.8B 텍스트 인코더와 158M fusion 어댑터로 Qwen-Image 2.1을 실행하며, 인코더 용량을 17.5 GB에서 1.7 GB로 줄이고 두 가지 ComfyUI 경로를 제공합니다.
 이미지→이미지
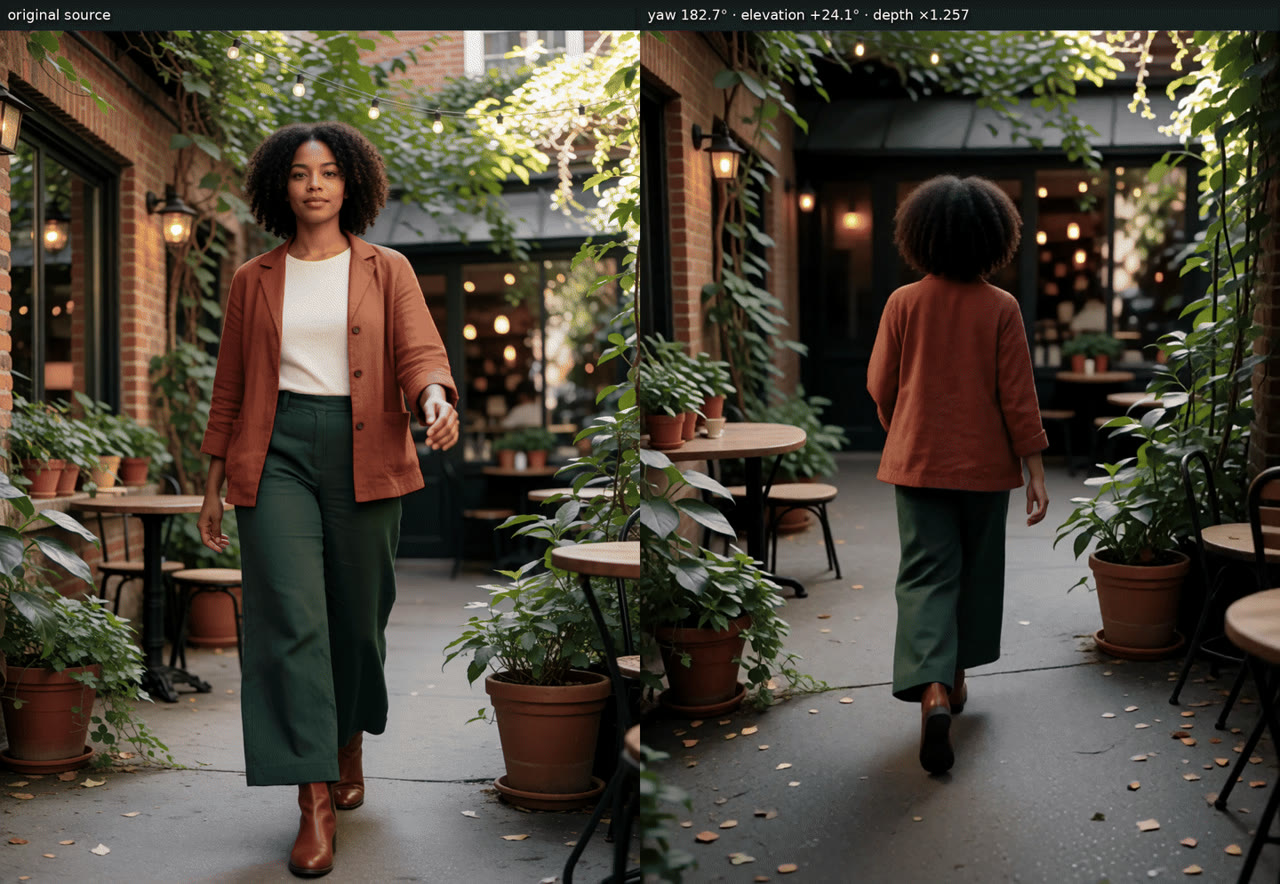
Krea 2 Anygles는 사람 사진 한 장과 3D 인간 노멀 LoRA로 새로운 카메라 보기를 만들어 냅니다. 궤도, 고도, 거리 제어를 위한 ComfyUI 노드와 워크플로도 함께 제공됩니다.
 텍스트→이미지
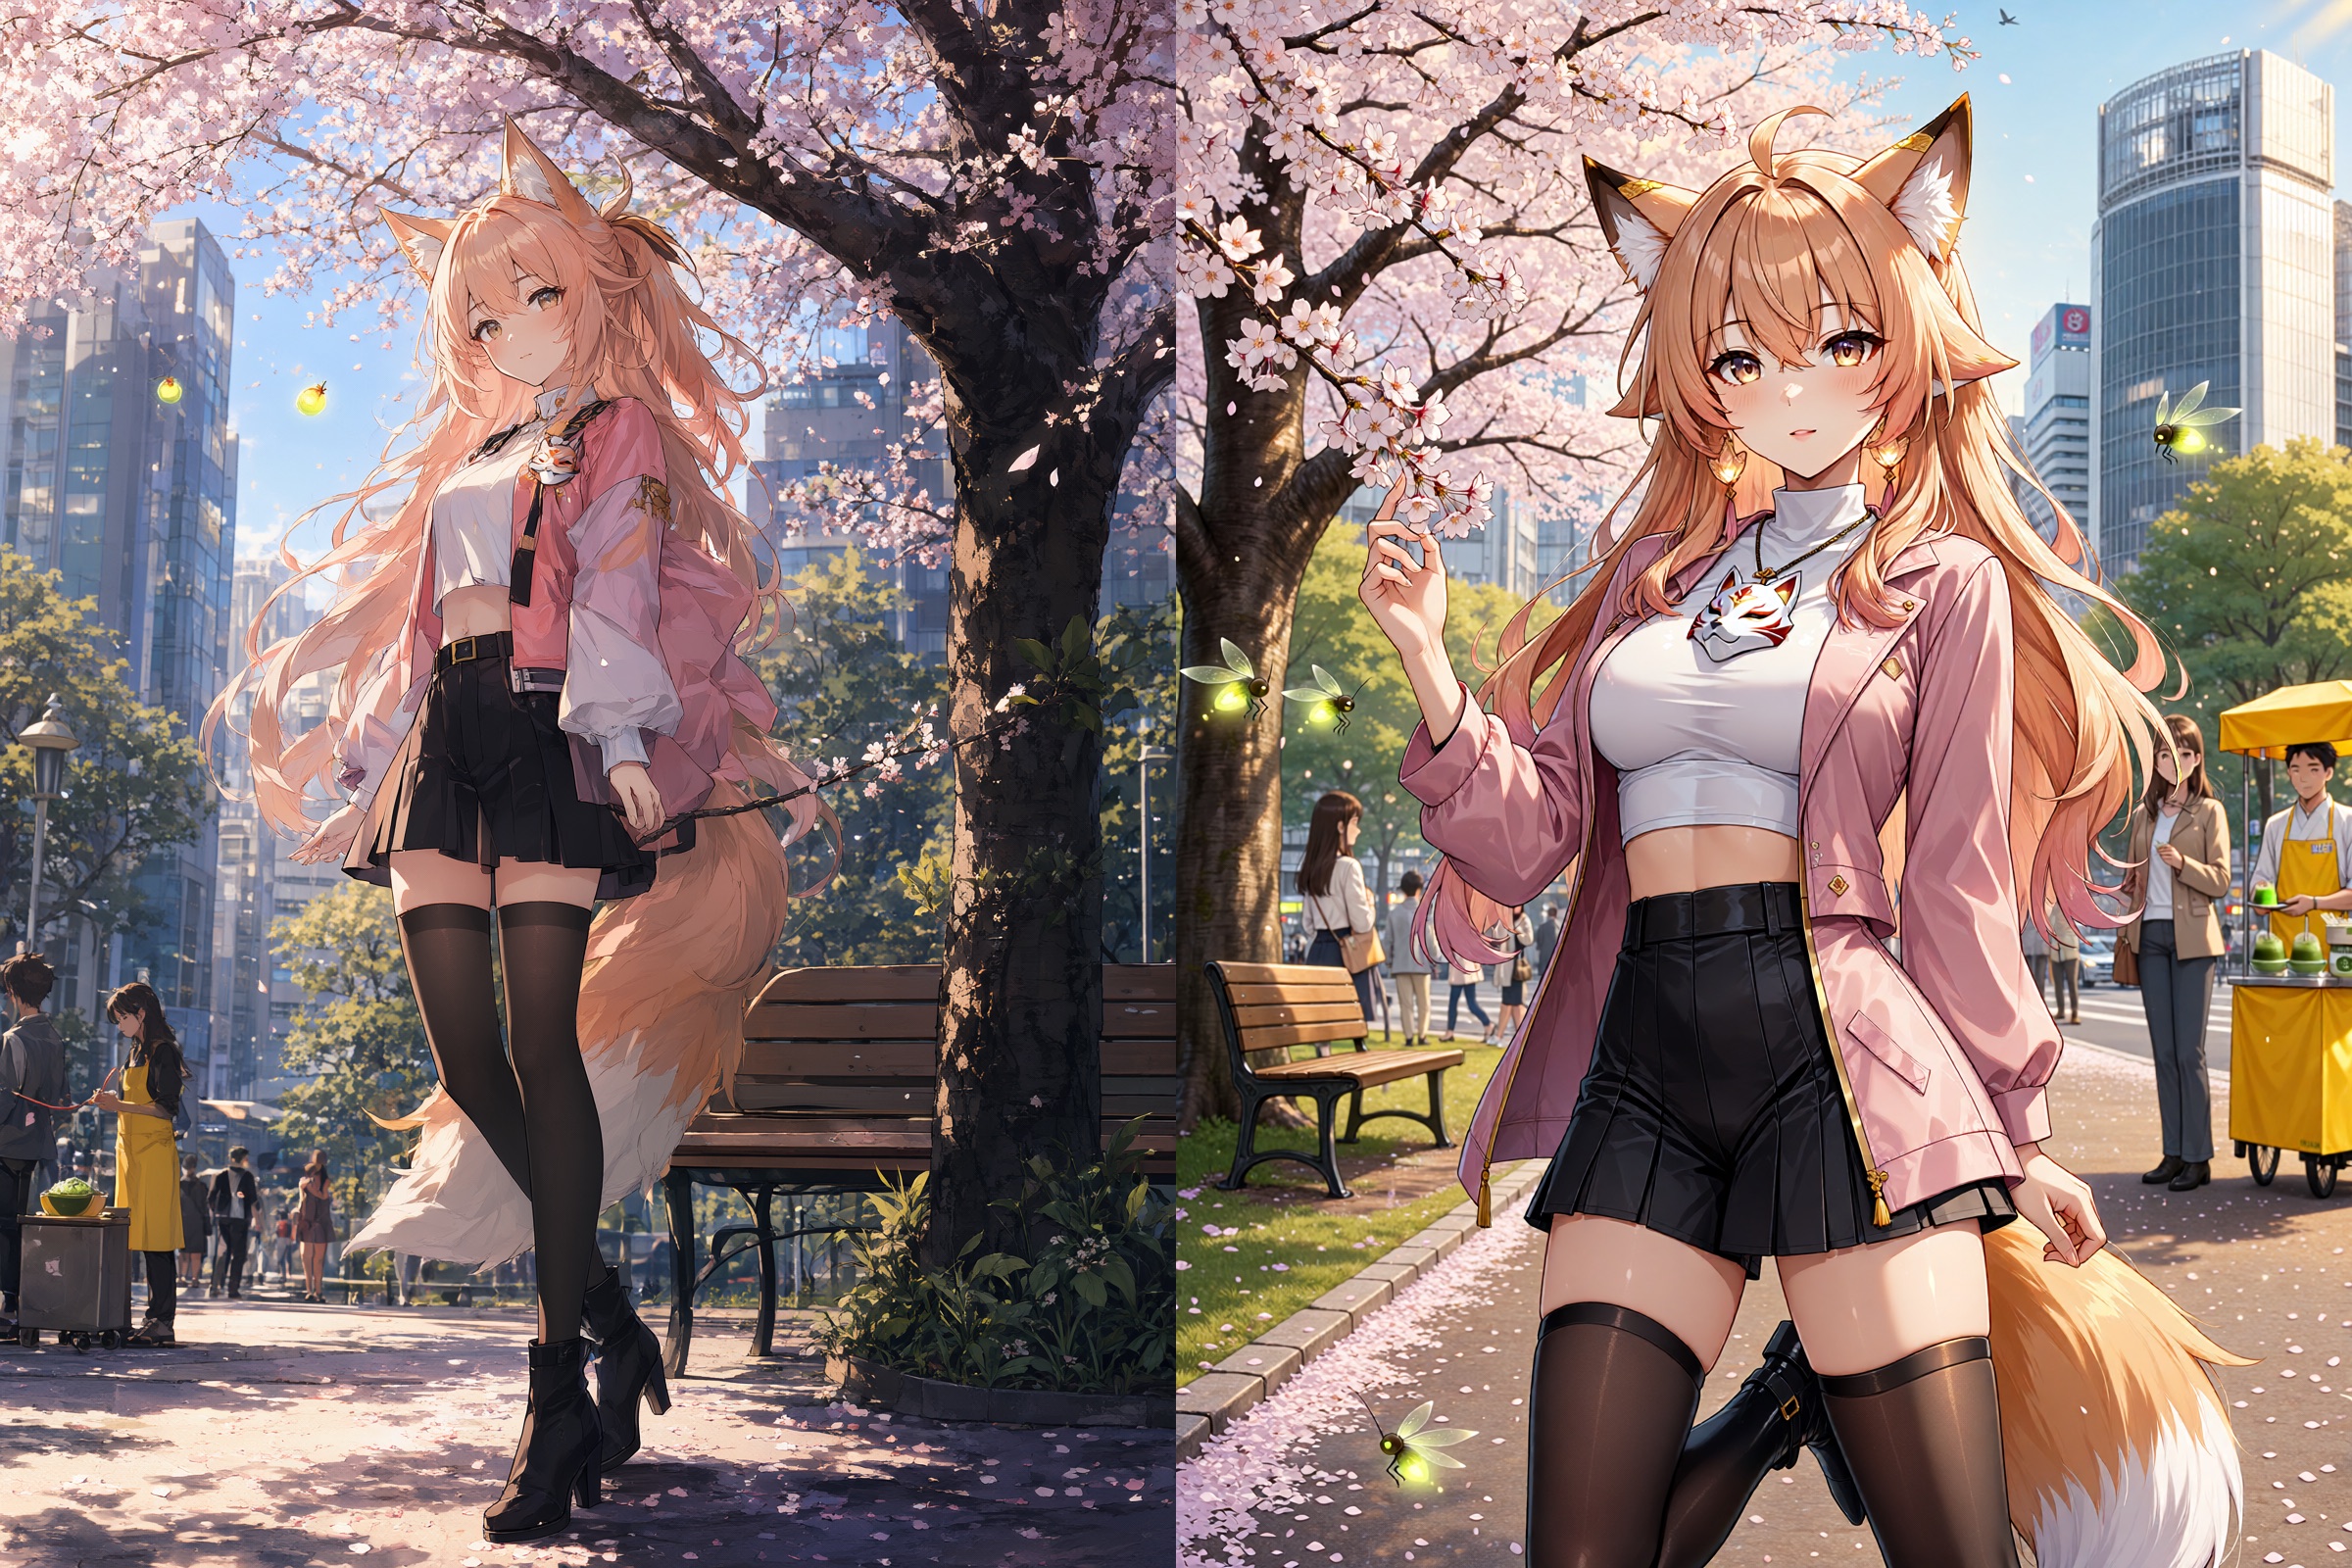
Qwen-Image 2.1 Fix는 20스텝 ComfyUI 워크플로가 함께 제공되는 커뮤니티 LoRA로, 모델의 색 빠짐 현상과 깨진 미세 텍스처를 겨냥합니다.
Qwen Research License
 텍스트→이미지
Tencent의 HY Image 3.5 Preview가 Hunyuan 이미지 API에 텍스트 기반 이미지 생성, 참조 이미지, 멀티턴 편집 기능을 추가했으며, ComfyUI에 전용 텍스트 기반 이미지 생성 및 편집 노드가 추가되었습니다.
API-Only
 비디오 편집
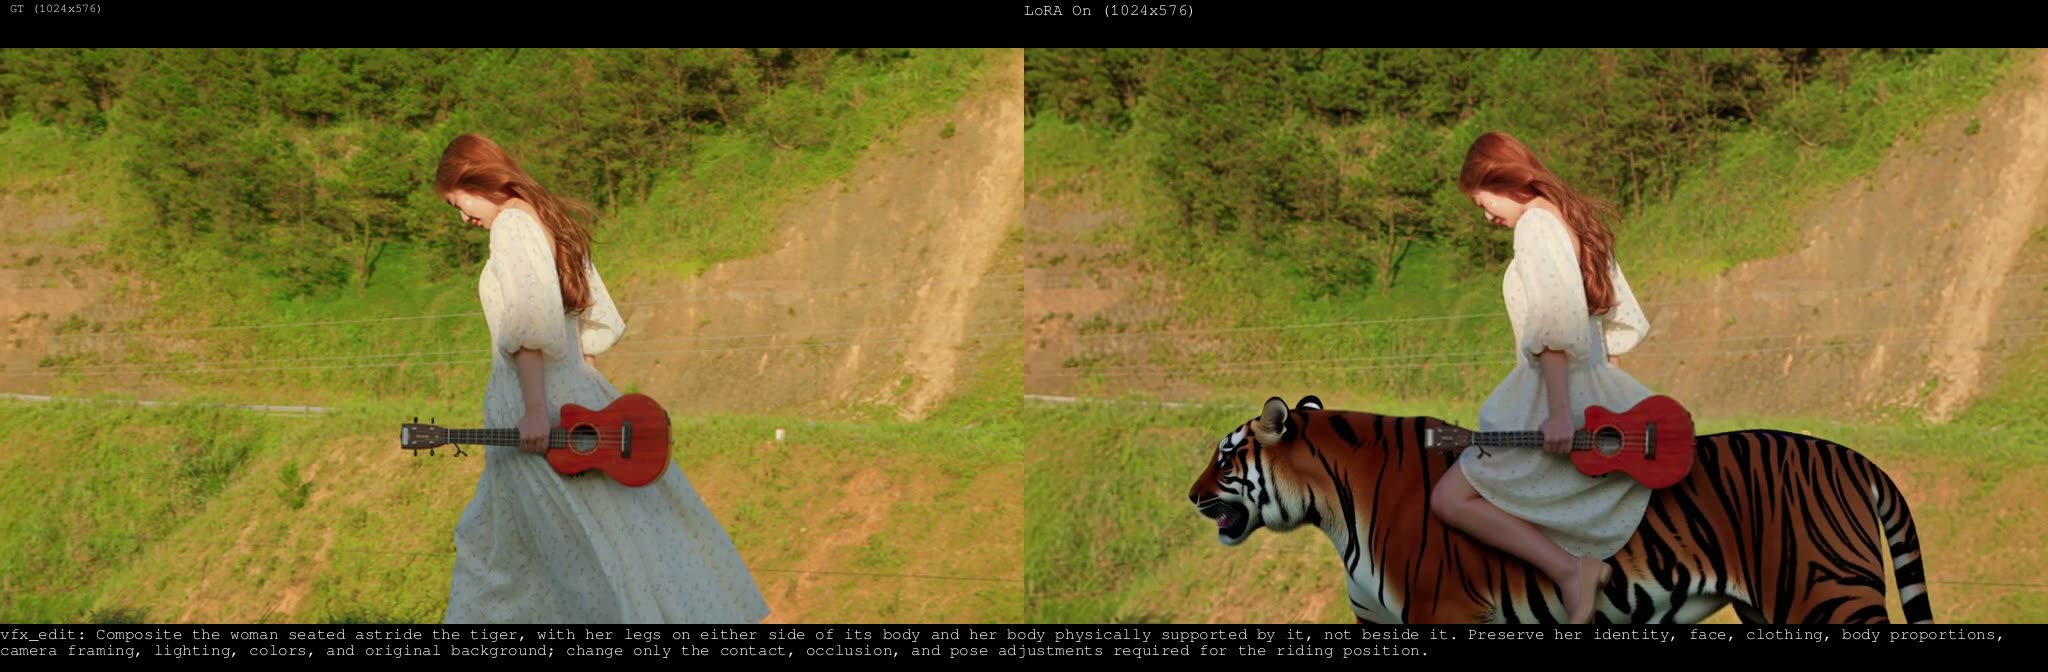
Alissonerdx의 MiniMax H3 LoRA 팩이 프롬프트 지시형 VFX Edit과 문서화된 Style Transfer, Head Swap 어댑터를 추가했습니다. ComfyUI 워크플로와 예제 클립도 함께 제공됩니다.
Apache-2.0
 인페인팅
Alibaba PAI의 MiniMax H3용 ControlNet Union 2.0은 Scribble, Layout, Gray 컨트롤을 추가하고 주입 블록 수를 두 배로 늘렸으며, 출시 당일 ComfyUI에서 지원됩니다.
minimax-h3-community-license-agreement
 비디오 편집
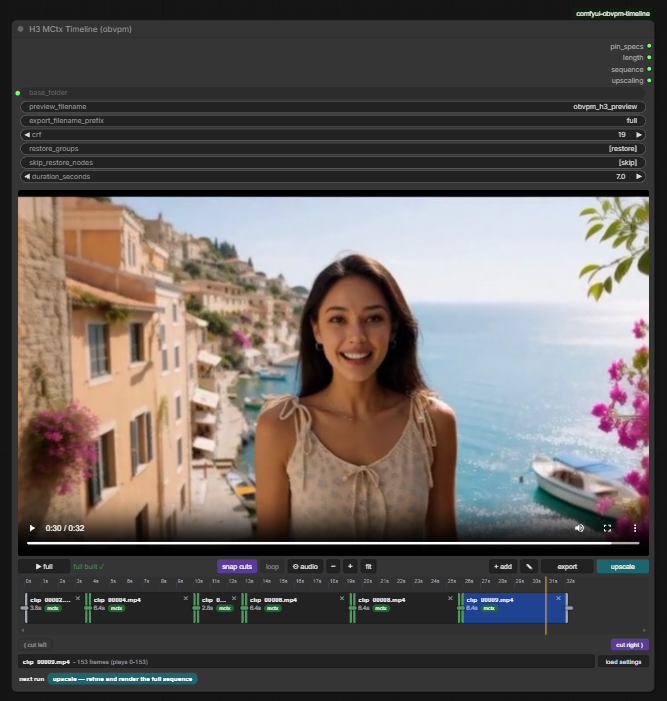
comfyui-obvpm-timeline은 ComfyUI에 MiniMax H3용 미니 영상 편집기를 추가합니다. 잠재 데이터 수준의 연결과 한 번의 업스케일로 클립을 확장, 앞에 추가, 브리지, 반복할 수 있습니다.
GPL-3.0
 텍스트→이미지
SupraLabs가 H100 한 대에서 10시간 만에 처음부터 학습한 105M 파라미터 DiT 텍스트 기반 이미지 생성 모델 Supra2-IMG를 공개했습니다. 샘플 해상도는 256x256입니다.
Apache-2.0
 텍스트→이미지
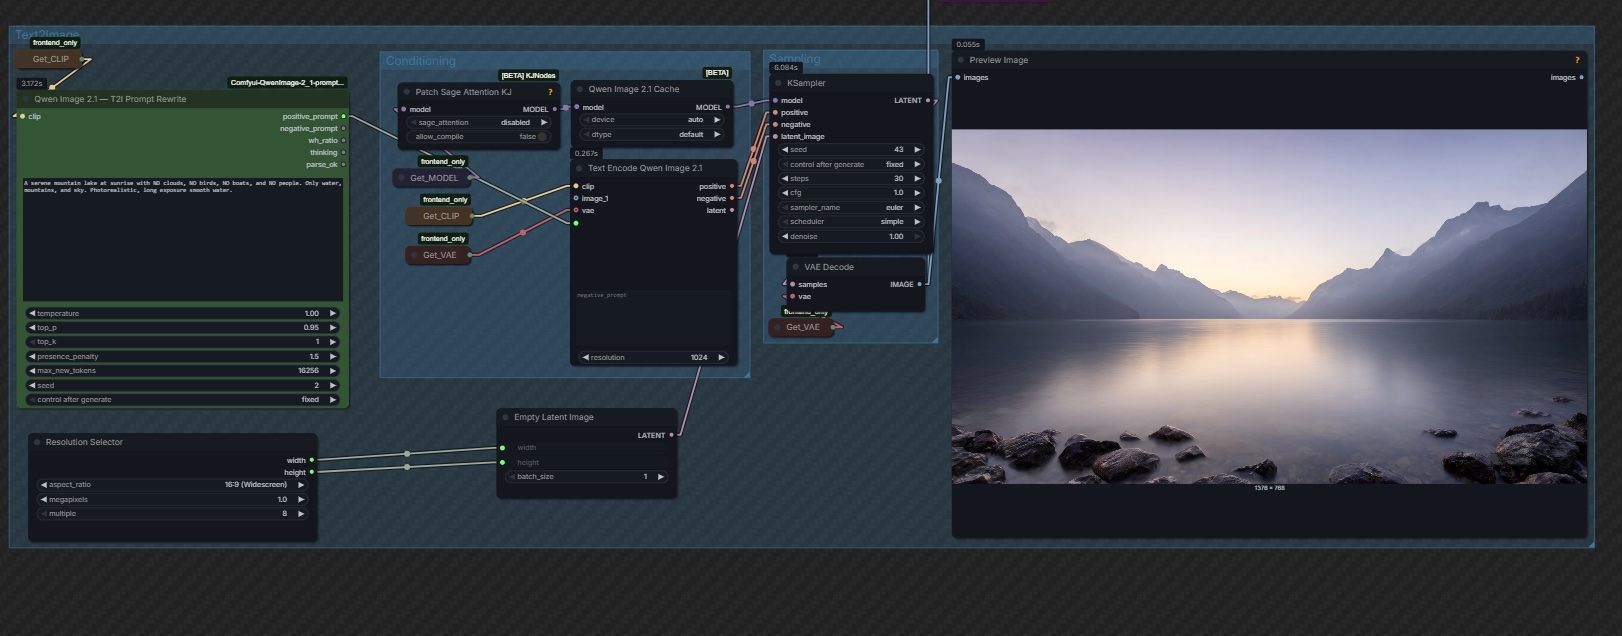
Qwen의 PE-T2I 및 PE-I2I 프롬프트 재작성 모델이 짧은 요청과 편집 지침을 확장하며, 커뮤니티 노드 팩이 CLIP 로드를 통해 두 모델을 ComfyUI에서 실행합니다.
 생태계
Cseti가 CrossView-Warp를 MiniMax H3로 포팅했습니다. MoGe depth warp를 사용해 기존 영상을 새로운 카메라 앵글에서 다시 렌더링하는 Ref2VA LoRA와 ComfyUI 노드입니다.
MiniMax-H3-Community
 생태계
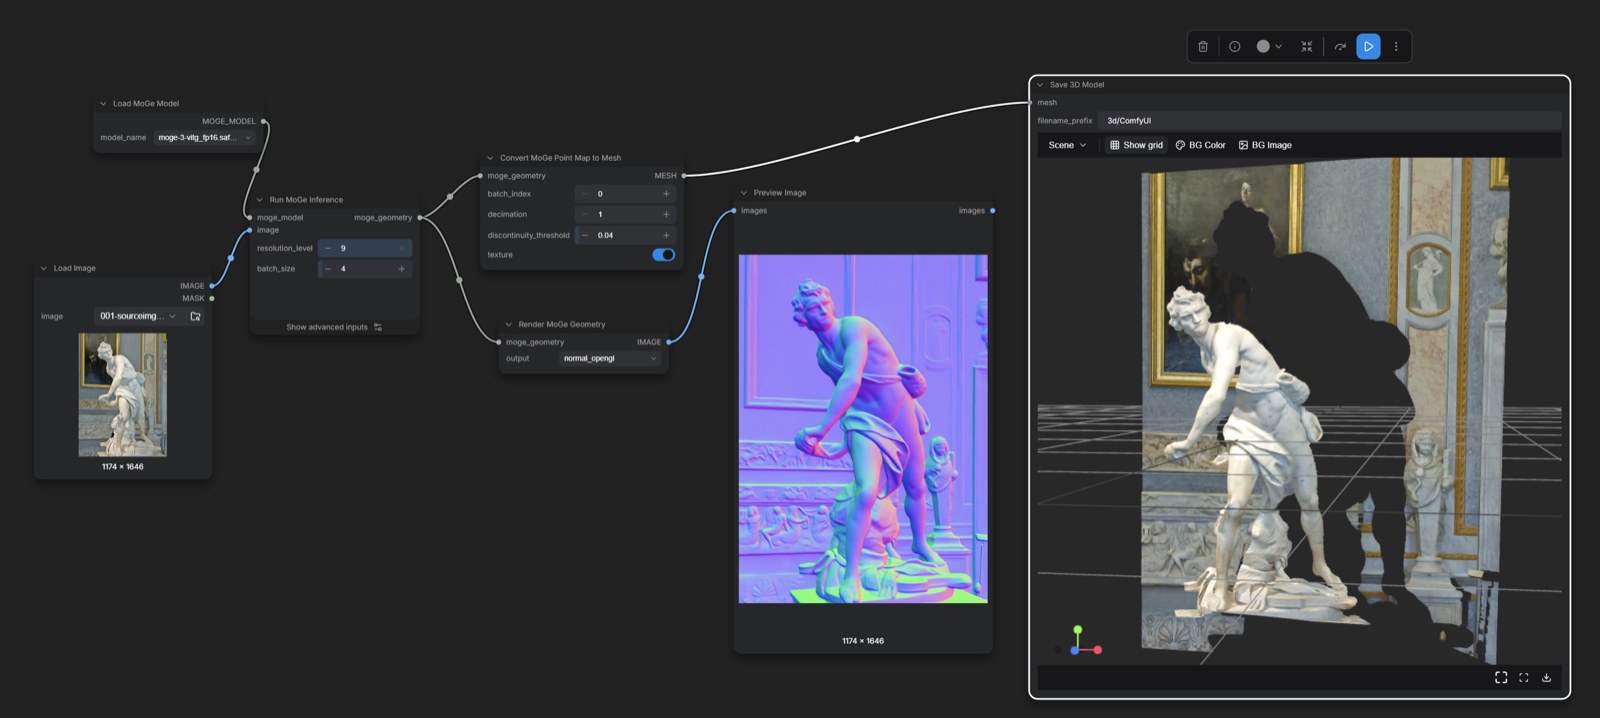
ComfyUI v0.37.0은 세 가지 공식 템플릿과 함께 네이티브 Qwen-Image 2.1 지원을 추가하고, MoGe 3 기하 추정, 더 빨라진 Qwen3.8 텍스트 인코더, 자동 빠른 디스크 로딩을 제공합니다.
 텍스트→비디오
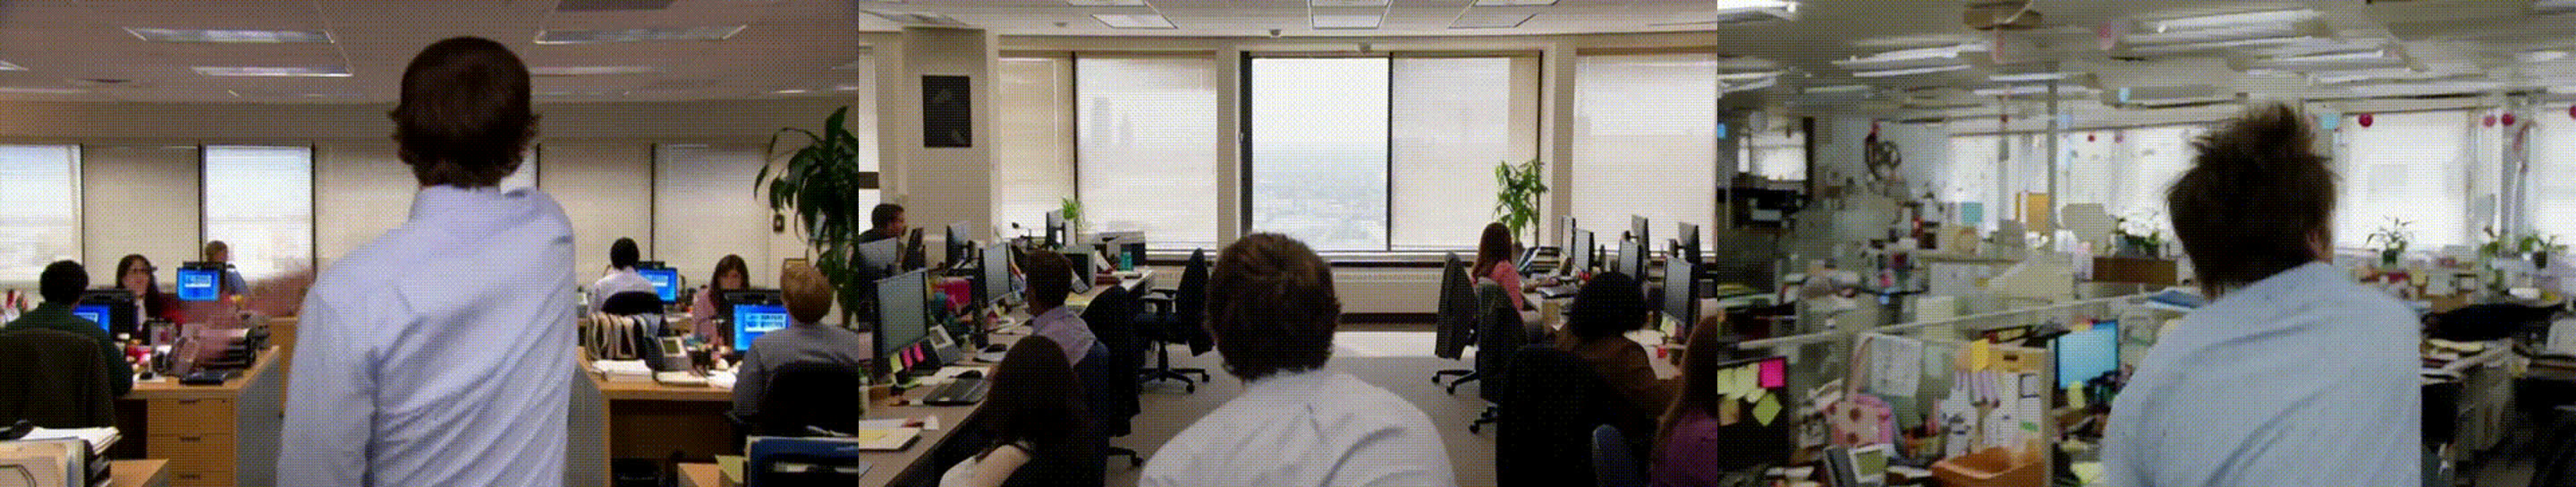
ComfyUI-MiniMax-H3-SPEED V2는 Euler, Heun, DPM2, RES Multistep을 지원하고 샘플러 인식 Sigma Harvest를 추가하며 I2V 키프레임 크기 조정 문제를 수정합니다.
 텍스트→이미지
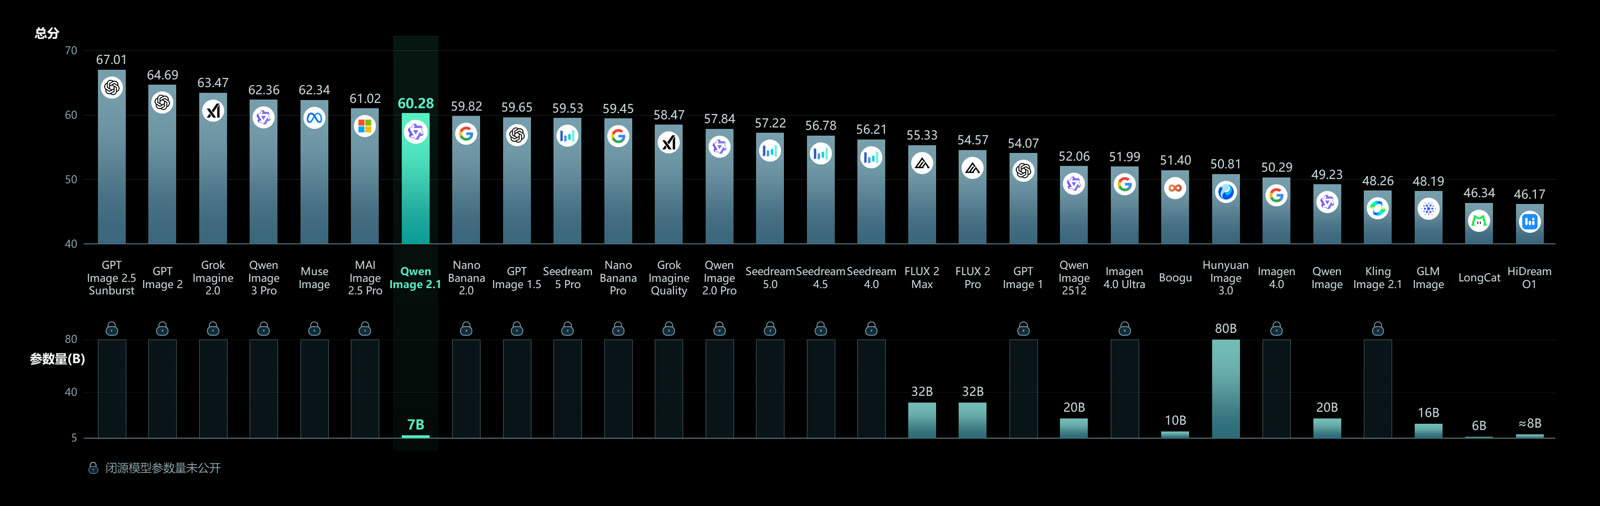
ComfyUI용 Qwen-Image 2.1 다운로드: qwen_image_2.1_bf16 및 int8_convrot safetensors, qwen3vl_8b 텍스트 인코더, 공식 2K 텍스트-이미지, 이미지 편집 및 배경 제거 템플릿.
Qwen Research License