MiniMax H3 VFX Edit LoRA: 프롬프트 지시형 비디오 편집 기능 공개
Alissonerdx의 MiniMax H3 LoRA 팩이 프롬프트 지시형 VFX Edit과 문서화된 Style Transfer, Head Swap 어댑터를 추가했습니다. ComfyUI 워크플로와 예제 클립도 함께 제공됩니다.
이 저장소는 9월 초에 다룬 H3 선명도 LoRA와 같은 곳이며, 가장 많이 사용되는 H3 LoRA 팩 중 하나로 작성 시점 기준 약 239개의 좋아요와 26,600회 다운로드를 기록했습니다. 모든 모델은 H3의 ref2va 가중치를 대상으로 학습되었고, 동일한 조건화 기법을 공유합니다. 즉, 소스 클립이 frame_idx = 0에서 핵심 MiniMaxH3AddGuide 노드를 통해 정렬된 가이드로 주입되어, 모델이 원본 장면을 느슨한 비디오 참조가 아닌 프레임 정렬된 형태로 인식합니다.
팩 구성
| 모델 | 기능 | 트리거 | 워크플로 |
|---|---|---|---|
minimax_h3_vfx_edit_v1.0_r128 | 정렬된 소스 클립에 대한 프롬프트 지시형 VFX 편집 | vfx_edit: | minimax_h3_vfxedit_wokflow.json |
minimax_h3_vfx_edit_v1.0_r128_ffp | 실험적인 첫 프레임 전파를 사용하는 고해상도 VFX Edit | vfx_edit: | 동일한 워크플로 |
minimax_h3_style_transfer_v1.0_r64 | 이미지 또는 텍스트 설명을 바탕으로 클립 전체의 스타일 변경 | style_transfer: | minimax_h3_style_transfer_workflow.json |
minimax_h3_head_swap_v1.0_r32 | 정렬된 클립에 대한 실험적 얼굴 교체 | head_swap: | minimax_h3_head_swap_workflow.json |
minimax_h3_lms_v1.0_r64 | 선명도 및 디테일 복원(최초의 어댑터) | 고정 캡션 | minimax_h3_lms_workflow.json |
LoRA와 함께 별도의 잠재 데이터 업스케일러 실험도 제공되며, VFX Edit 가중치는 2026년 9월 21일에 업로드되었습니다.
VFX Edit
VFX Edit은 이번 팩의 핵심 추가 기능입니다. 클립과 한 문장짜리 지시를 주면, 해당 변경만 적용된 동일한 장면을 반환합니다.
vfx_edit: Add fire effects to the man's hands while preserving his identity, pose, motion, clothing, framing, lighting and background.문서에서 권장하는 방식은 먼저 편집 내용을 말하고, 그다음 반드시 유지해야 할 요소를 나열하는 것입니다. 교체 대상인 영역 자체를 보존하라고 모델에 요청해서는 안 됩니다. 두 가지 버전이 공개되었습니다.
- Standard(
r128)는 384 해상도 버킷에서 73프레임 클립으로 학습되었으며 이미지 참조가 필요하지 않습니다. - FFP(
r128_ffp, first-frame propagate)는 512 버킷에서 124프레임 클립으로 해당 학습을 이어가며, 편집된 첫 프레임을 H3의 네이티브 이미지 참조 채널로 전달하는 실험적 기능을 추가합니다. 이미지를 제공하는 경우 프롬프트에서<Picture 1>을 명시적으로 언급하고 그 역할을 설명해야 하며, 그렇지 않으면 프롬프트에<Picture 1>이나<Subject 1>을 전혀 언급하지 않아야 합니다.
실행하려면 소스 클립 전체를 비디오 참조 슬롯이 아닌 MiniMaxH3AddGuide에 넣고, 소스 비율과 지원되는 프레임 수를 맞춘 뒤 LoRA 강도 1.0에서 시작하세요. 공개된 한계는 이 도구가 무엇이 아닌지 솔직하게 밝히고 있습니다. 정체성 드리프트, 텍스트와 로고의 변형, 약한 미세 디테일, 그리고 긴 클립에서의 저조한 결과입니다. 이는 컴포지터가 아니며 픽셀 단위의 완벽한 보존을 보장하지도 않습니다.
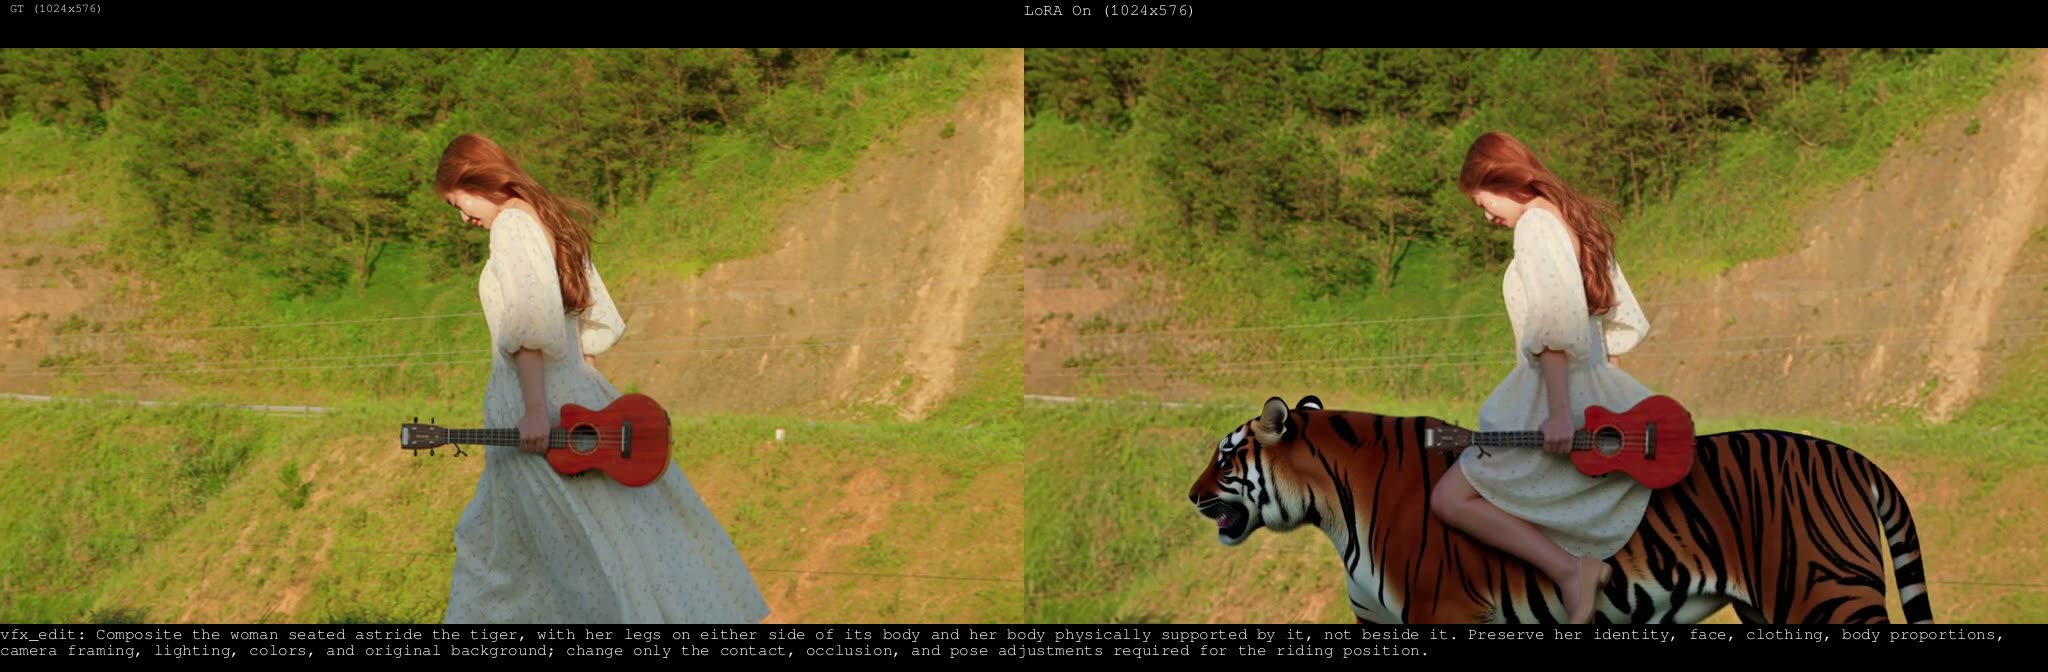 | 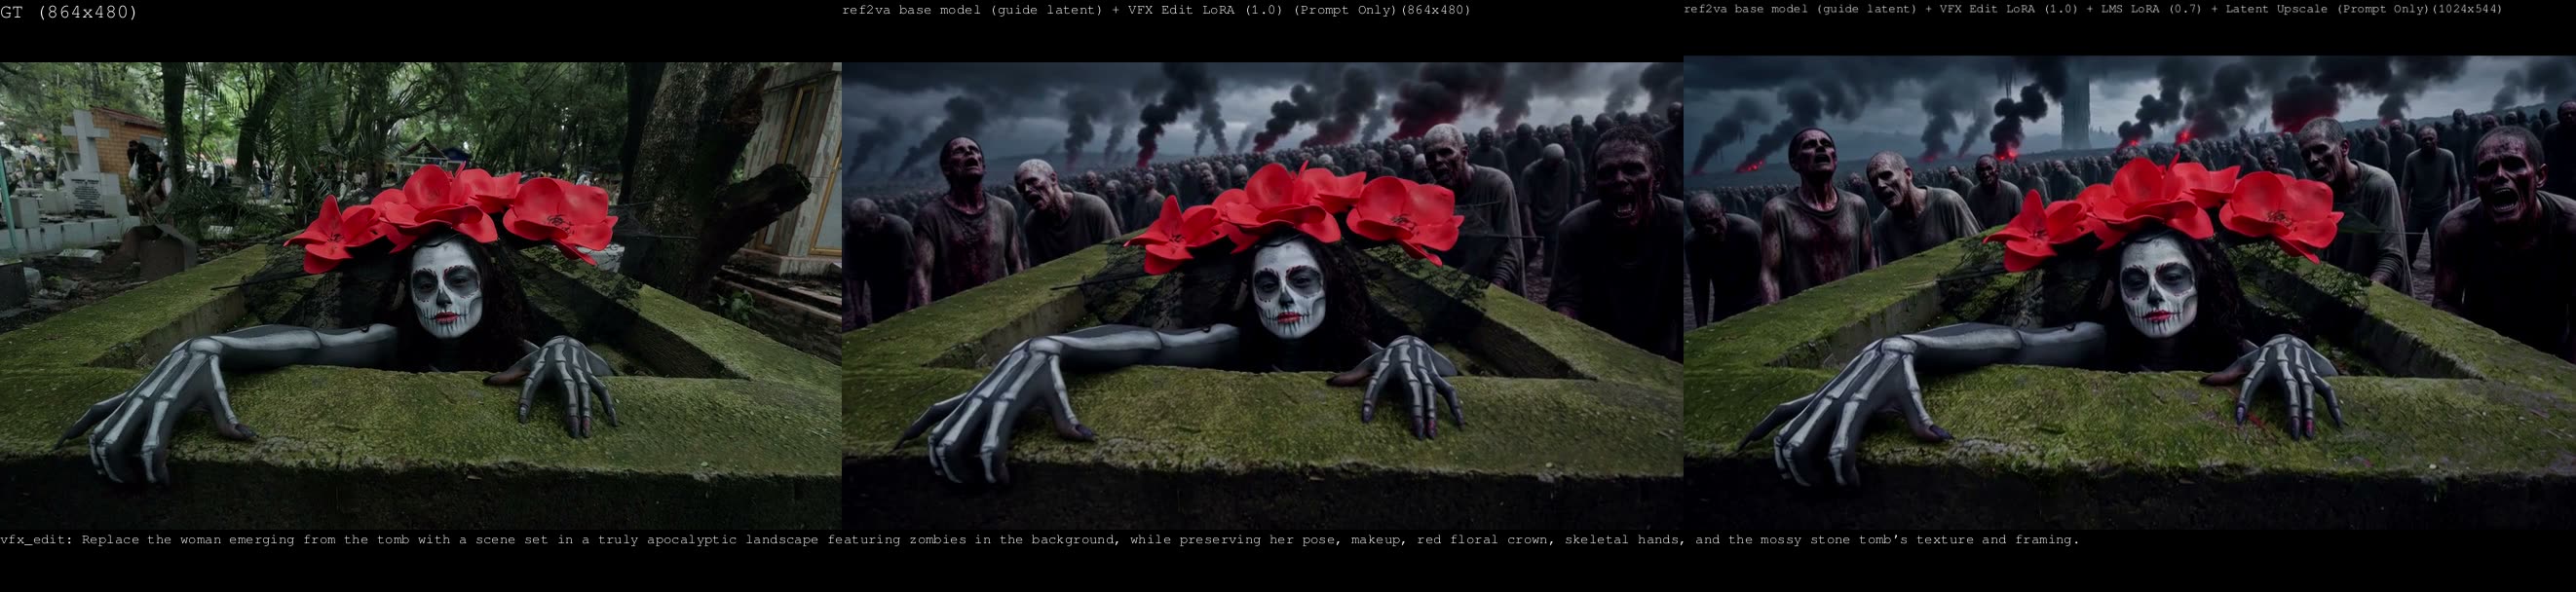 |
|---|---|
| 저장소의 VFX Edit 예제 클립 | 두 번째 VFX Edit 예제 |
Style Transfer와 Head Swap
Style Transfer는 움직임, 구도, 타이밍을 유지하면서 클립 전체의 스타일을 바꿉니다. 소스 비디오는 MiniMaxH3AddGuide에, 스타일 이미지는 네이티브 참조 채널에 <Picture 1>로 넣고 강도 1.0으로 설정하며, 스타일이 원본 움직임을 덮어쓰기 시작하면 약 0.7로 낮춥니다. 텍스트만으로도 베이스 모델이 이미 알고 있는 스타일은 표현할 수 있습니다. 문서에서는 참조 이미지와 함께 아티스트 이름을 지정하지 말 것을 경고합니다. 텍스트가 이미지를 압도할 수 있기 때문입니다.
Head Swap은 실험적 기능으로 표시되어 있으며, 서로 다른 역할로 두 조건화 경로를 모두 사용합니다. 교체할 얼굴은 네이티브 참조 채널을 통해 <Picture 1> / <Subject 1>로 전달되고, 전체 베이스 비디오는 frame_idx = 0에서 MiniMaxH3AddGuide를 통해 <Video 1>로 전달됩니다. 베이스 비디오를 네이티브 비디오 참조 채널로 라우팅해서는 안 됩니다. 문서에는 책임 있는 사용에 대한 명시적 안내도 포함되어 있습니다. 연구 및 창작 목적으로만 사용하고, 사칭이나 사기, 기만 행위에는 사용하지 마십시오.
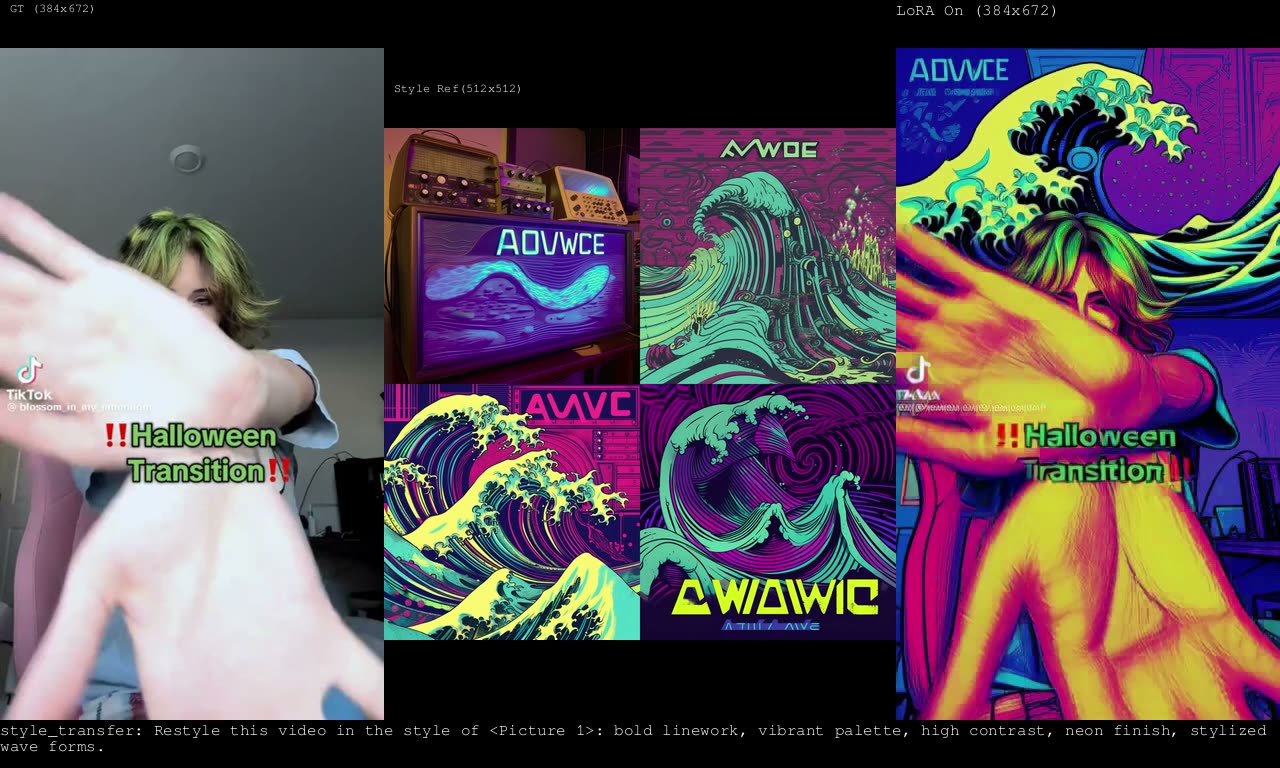
저장소의 Style Transfer 예제
잠재 데이터 업스케일러 실험
이 팩은 실험적인 잠재 데이터 업스케일러 체크포인트 h3_upscaler_lms_v0.1도 문서화하고 있습니다. 이는 LBH-123-AI 잠재 데이터 업스케일러에서 시작해 LMS LoRA에 사용된 것과 동일한 선명도 데이터셋으로 2,000 스텝 동안 파인튜닝되었습니다. 동일한 가중치가 latent_upscaler/와 experiments/ 아래에 두 번 게시되어 있으며, 가이드에서는 이에 대한 전용 예제 비디오나 워크플로가 아직 업로드되지 않았다고 분명히 밝히고 있습니다.
사용 가능 여부
저장소에서 LoRA를 다운로드해 ComfyUI/models/loras/에 넣고, workflows/ 폴더에서 일치하는 워크플로를 불러오세요. 각 워크플로에는 필요한 모델이 나열되어 있습니다. LoRA 조건화 경로 자체는 핵심 MiniMax H3 노드(MiniMaxH3AddGuide 포함)에서 실행되지만, 함께 제공되는 예제 워크플로는 비디오 로딩, 프레임 리사이즈, latent 업스케일러에 서드파티 노드 팩도 사용하므로 각 워크플로에 적힌 대로 누락된 노드를 설치하세요.
댓글
GitHub로 로그인하고 토론에 참여하세요.