 텍스트→비디오
LoRA
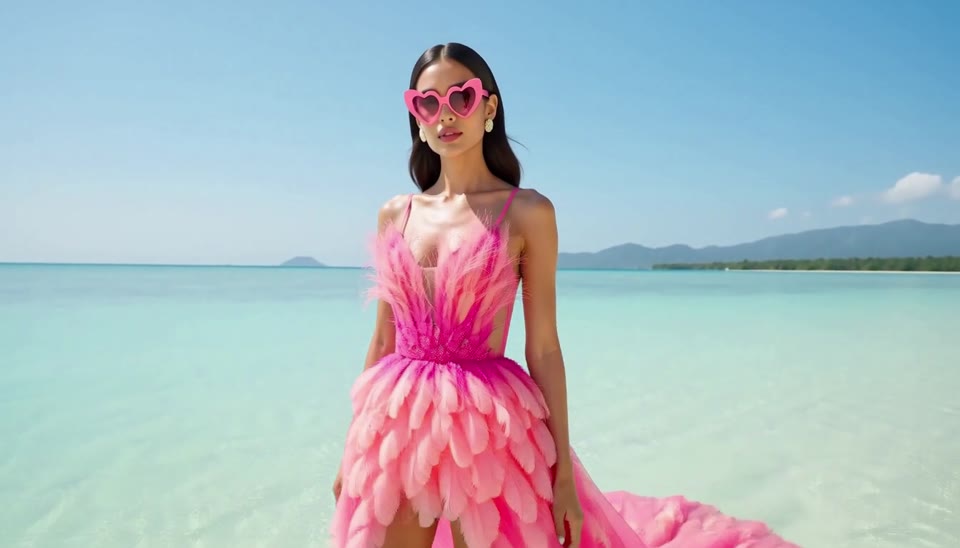
DMAD: ComfyUI용 4스텝 MiniMax H3 오디오-비디오 LoRAByteDance와 Texas A&M이 DMAD를 공개했습니다. rank-128 LoRA로 MiniMax H3를 4스텝으로 줄여 오디오-비디오 동시 생성이 가능하며, Kijai의 ComfyUI 변환본도 제공됩니다.
ComfyUI 생태계 소식 — 오픈소스 모델 릴리스, 커스텀 노드, 워크플로, 이미지·비디오·오디오 생성 도구 업데이트.
텍스트→비디오ByteDance와 Texas A&M이 DMAD를 공개했습니다. rank-128 LoRA로 MiniMax H3를 4스텝으로 줄여 오디오-비디오 동시 생성이 가능하며, Kijai의 ComfyUI 변환본도 제공됩니다.
 생태계
Comfy Agent는 캔버스 자체에서 ComfyUI 워크플로를 계획하고, 만들고, 실행하고, 디버깅합니다. 재사용 가능한 스킬과 최대 5개의 병렬 채팅을 지원하며, 지금 Comfy Cloud에서 사용할 수 있습니다.
 텍스트→비디오
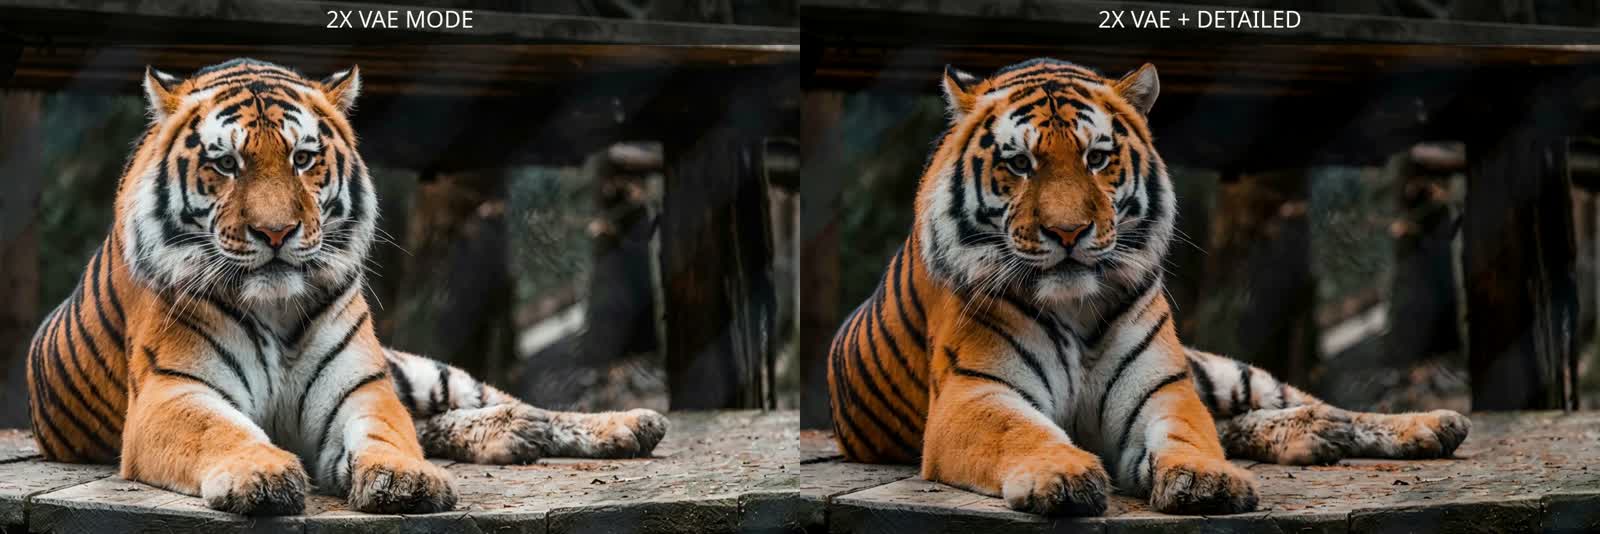
MiniMax H3를 위한 실험적 2-in-1 릴리스입니다. 2X 비디오 VAE와 레퍼런스 디테일 향상 노드를 제공하며, 검증된 ComfyUI 워크플로와 네거티브 결과 분석 글을 함께 담았습니다.
MiniMax-H3-Community
 이미지 편집
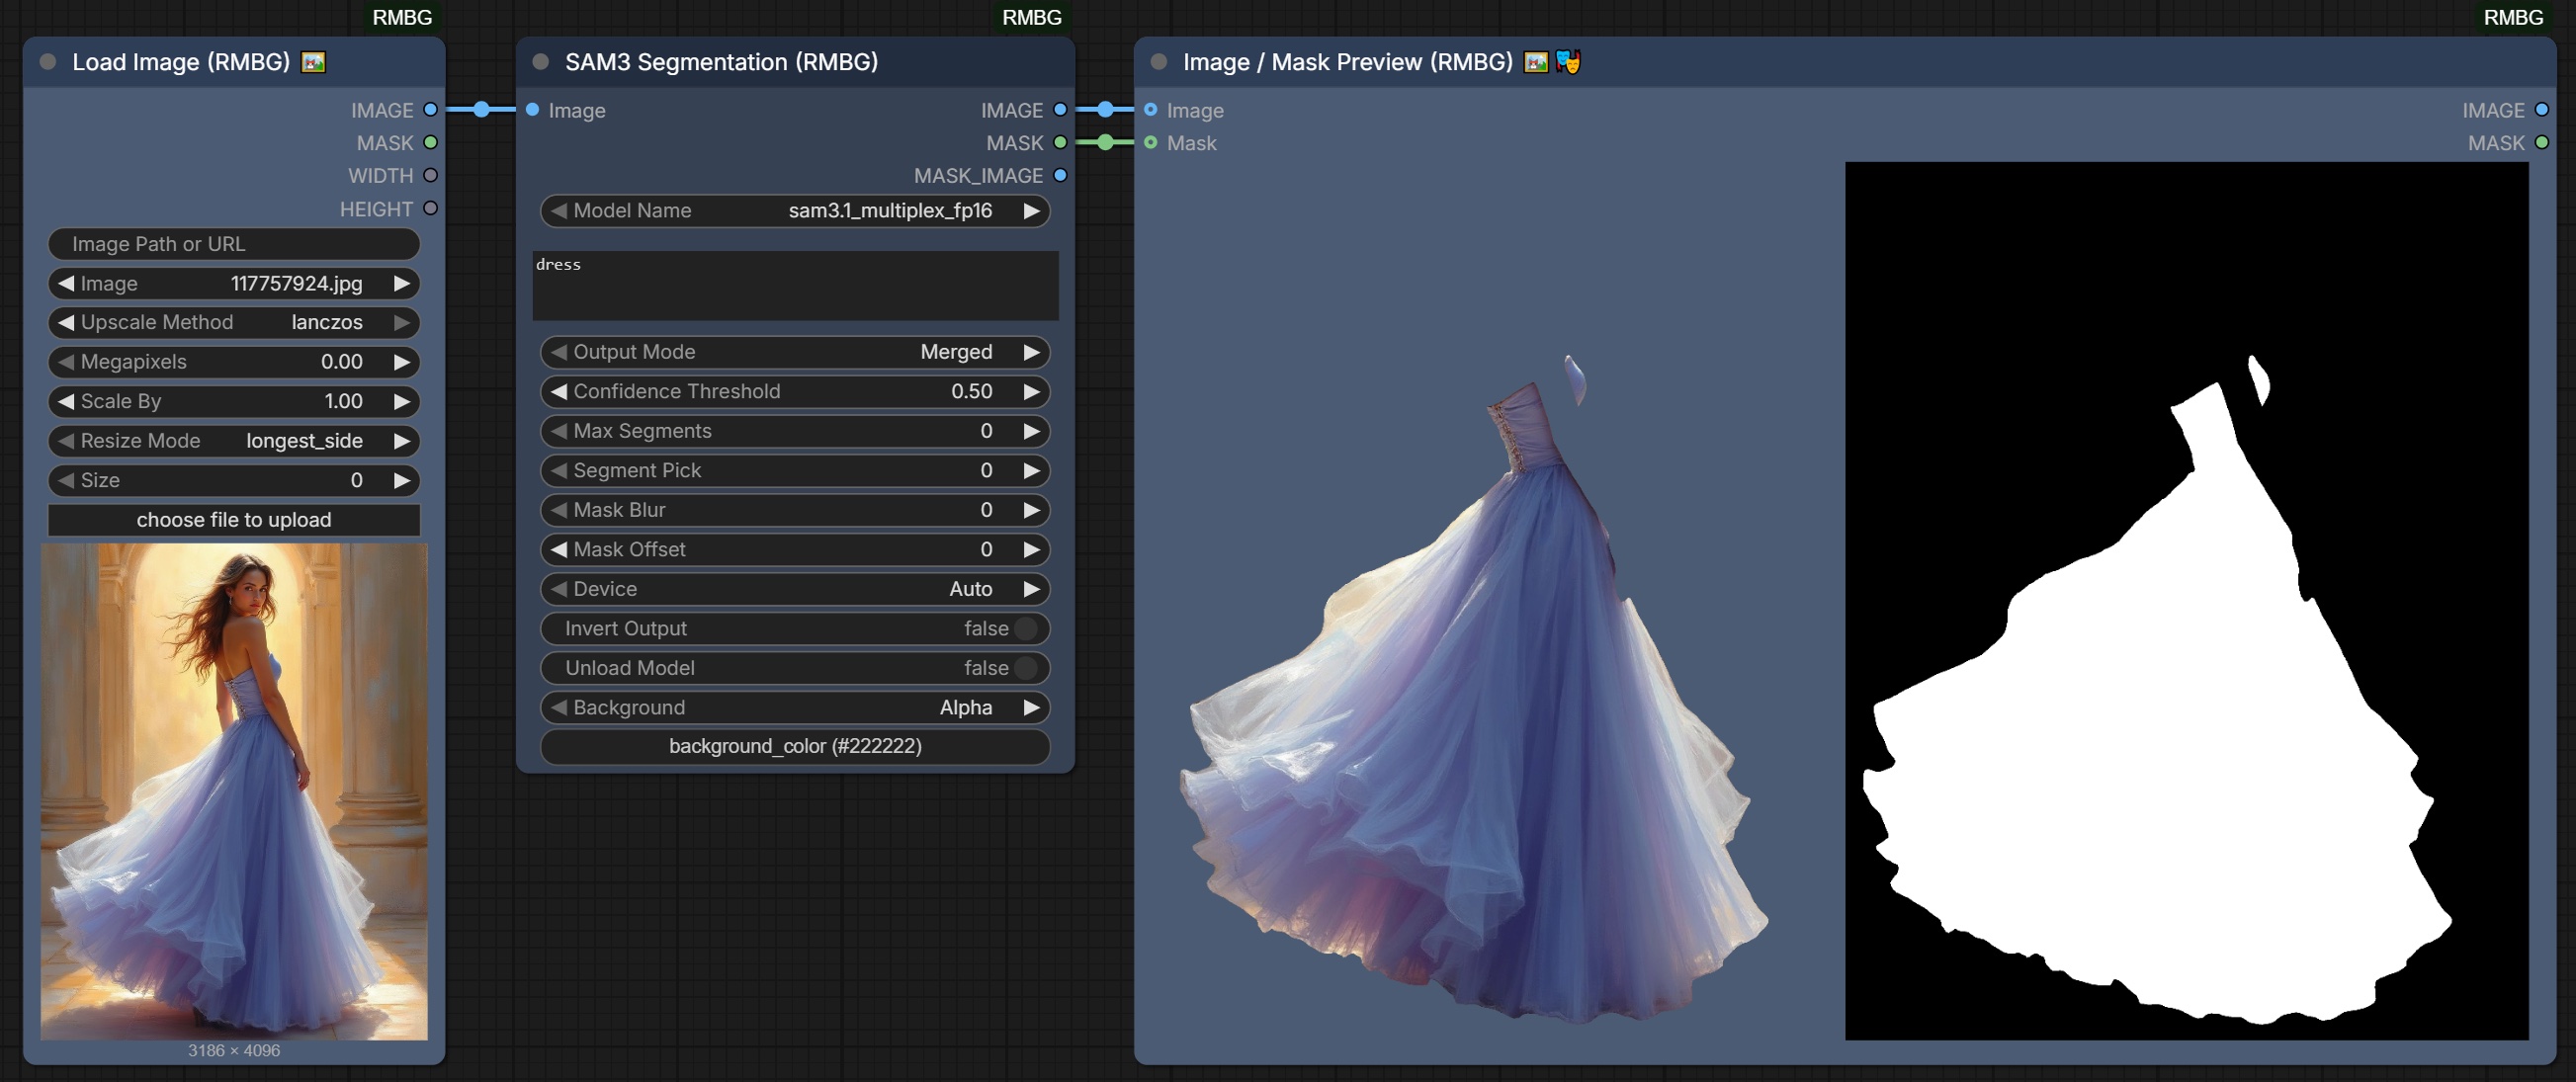
ComfyUI-RMBG v3.2.0에서 SAM 3.1 Multiplex 노드, 즉시 VRAM 언로드 토글, Apple Silicon GPU 지원이 추가되고 시작 시 노드 스캔 시간이 15초에서 0.1초 미만으로 줄어듭니다.
 비디오 편집
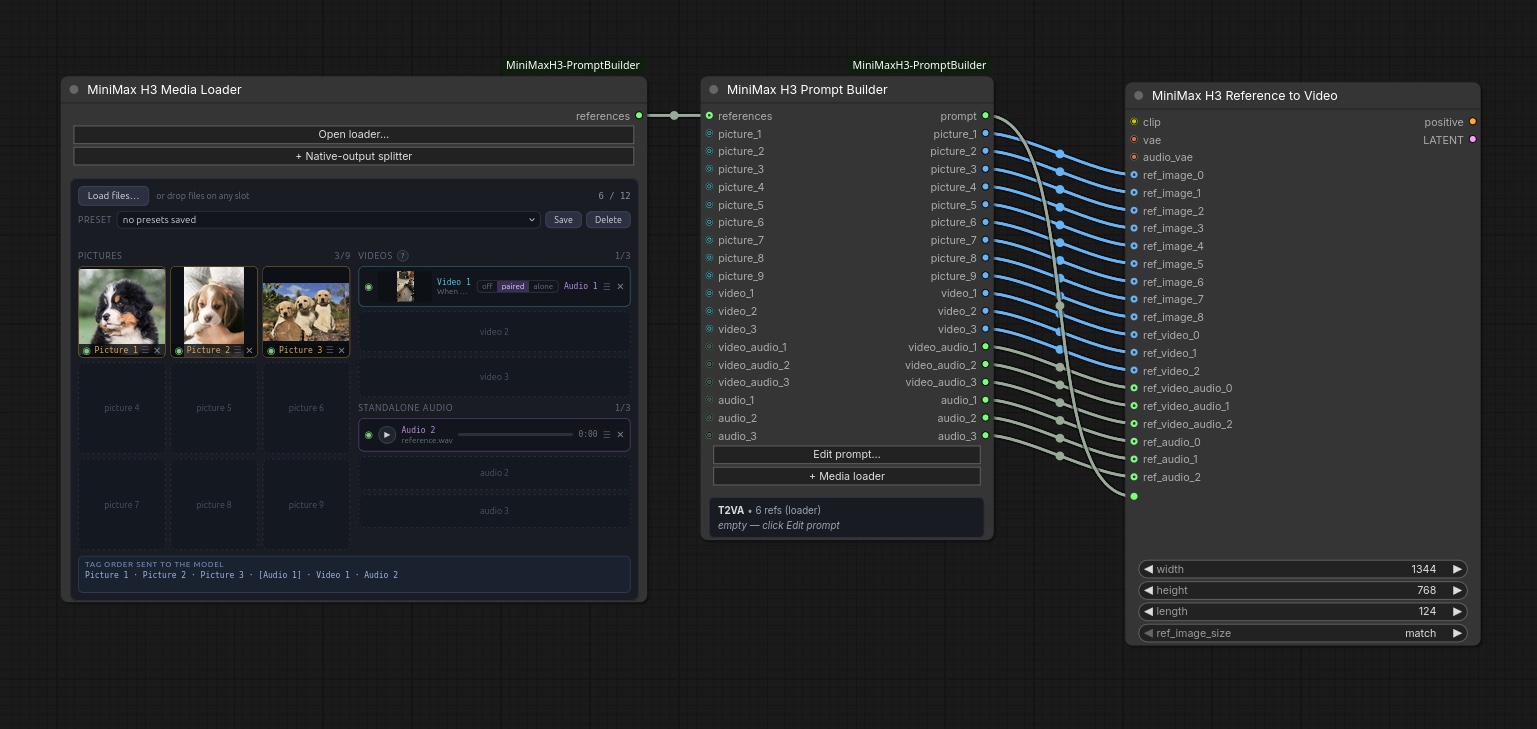
ComfyUI Fantastic H3 Prompt Builder 1.8.0이 SAM 3.1 기반 마스크 클립 편집, 더 빨라진 RefMod 텍스트 인코딩, MiniMax H3 프롬프트를 위한 개편된 트림 편집기를 추가합니다.
 텍스트→이미지
Viggle의 Qwen-Image 2.1 v0.3 증류 모델은 9스텝 모드를 추가하고, 6스텝 생성 및 편집을 위한 공식 ComfyUI 노드와 워크플로, 병합된 단일 파일 가중치를 제공합니다.
Qwen Research License
 텍스트→비디오
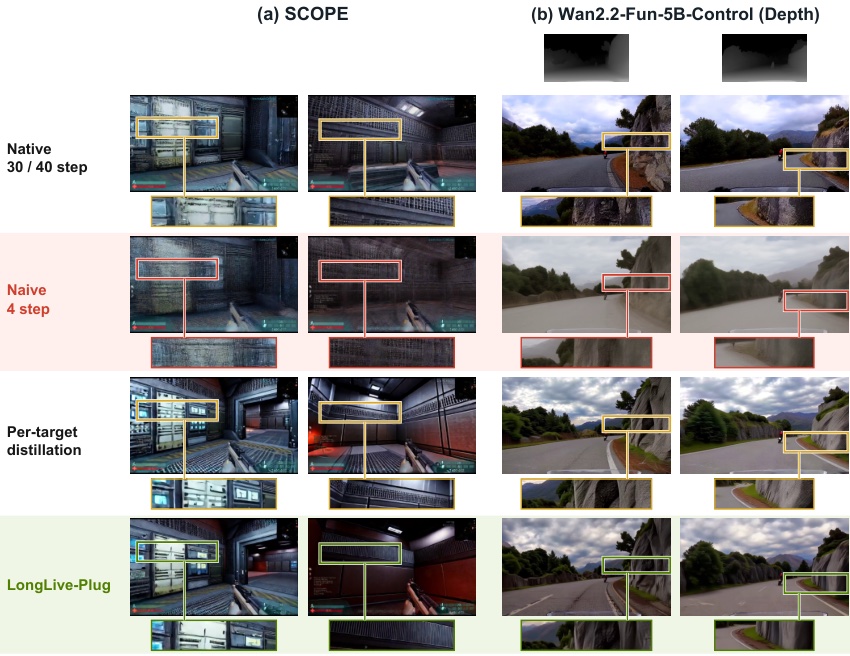
NVIDIA의 LongLive-Plug는 few-step, CFG, long-context LoRA를 백본당 한 번만 증류해 54개 다운스트림 모델에서 재사용하며, MiniMax H3와 Wan용 가중치를 제공합니다.
 생태계
ComfyUI v0.38.0은 공식 템플릿과 함께 네이티브 Ming-Image 지원을 추가하고, Wan ID-V2V, w6a8 양자화, HDR LogC3 및 ACEScct 색상 공간을 도입했으며, SeedVR2와 YuE2의 속도를 개선했습니다.
 비디오 편집
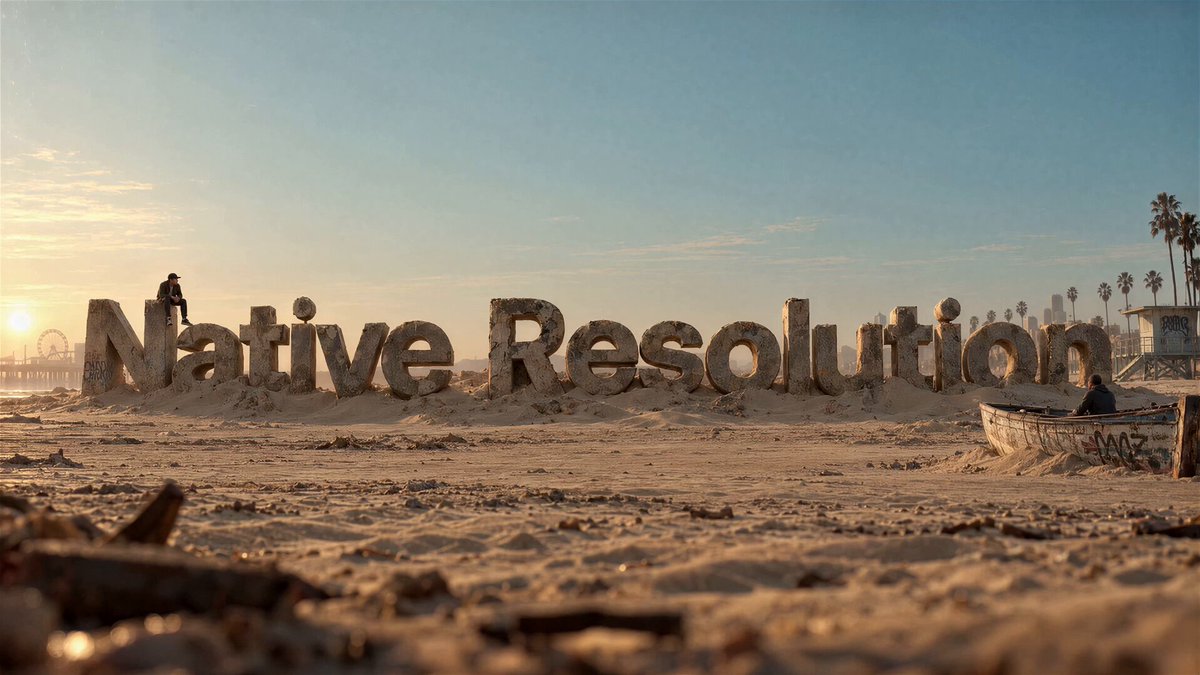
Lightricks의 Native Resolution은 Tiled Fusion을 통해 LTX-2.5 4K 및 8K 비디오 편집을 ComfyUI로 제공하며, 새로운 Refine 및 Restore IC-LoRA를 함께 선보입니다.
LTX-2.x Community License
 이미지 편집
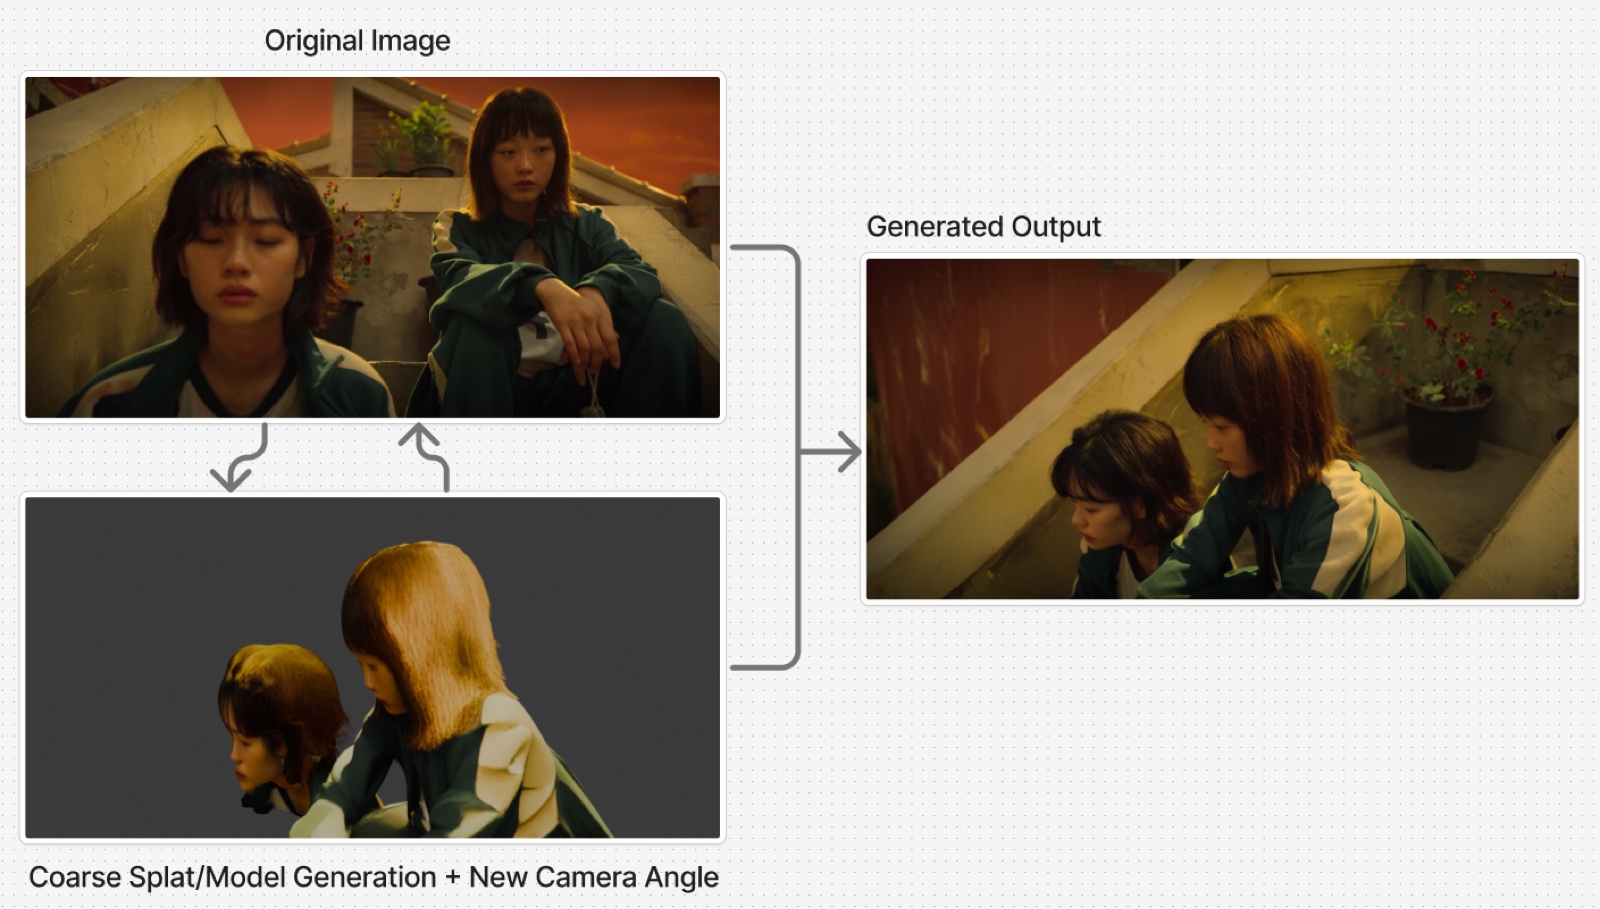
AnyAngle은 사진을 임의의 카메라 앵글로 옮겨주는 Qwen-Image 2.1 LoRA입니다. Gaussian splat 또는 3D 모델에서 장면을 렌더링한 다음, 편집 모델이 그 뷰를 원본 이미지로 옮기도록 합니다.
 이미지 편집
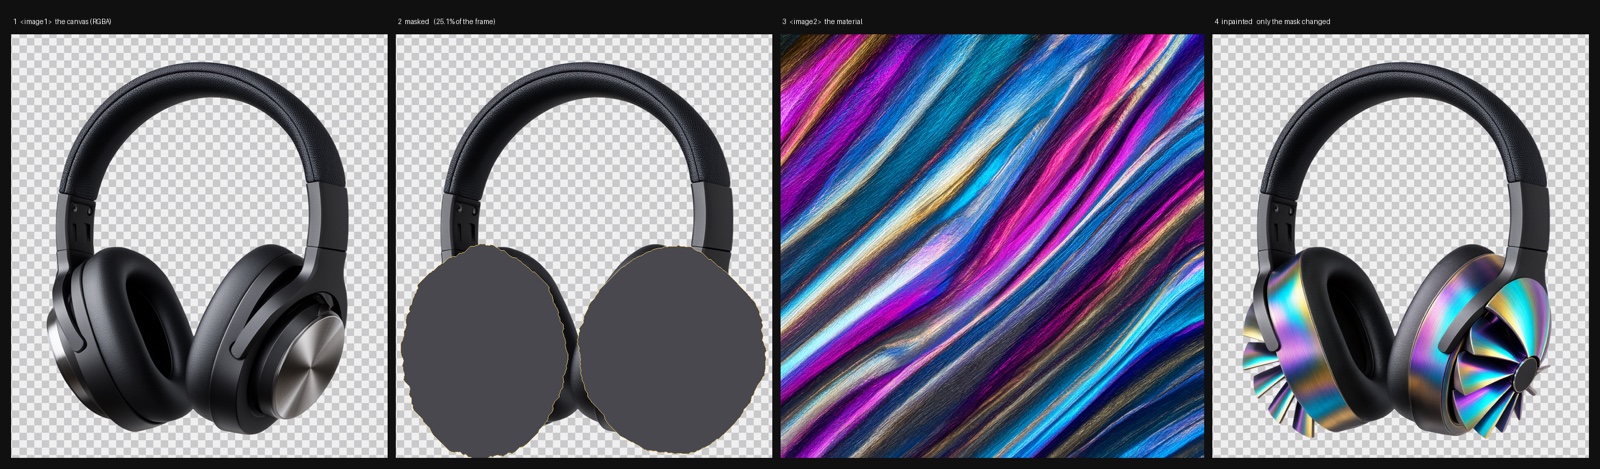
LanPaint 2.2.0은 Qwen-Image 2.1을 자체 마스크 샘플러로 지원합니다. 텍스트 기반 이미지 생성 모델과 편집 모델을 인페인팅하고, 투명도가 픽셀과 함께 형태를 바꾸도록 해보세요.
 비디오 편집
Vlo 0.3은 타임라인에서 ComfyUI를 구동하는 무료 오픈소스 비디오 편집기입니다. MiniMax H3 및 Qwen 워크플로, SAM2 마스킹, 색 보정, 프레임 단위로 정확한 내보내기를 지원합니다.
 텍스트→이미지
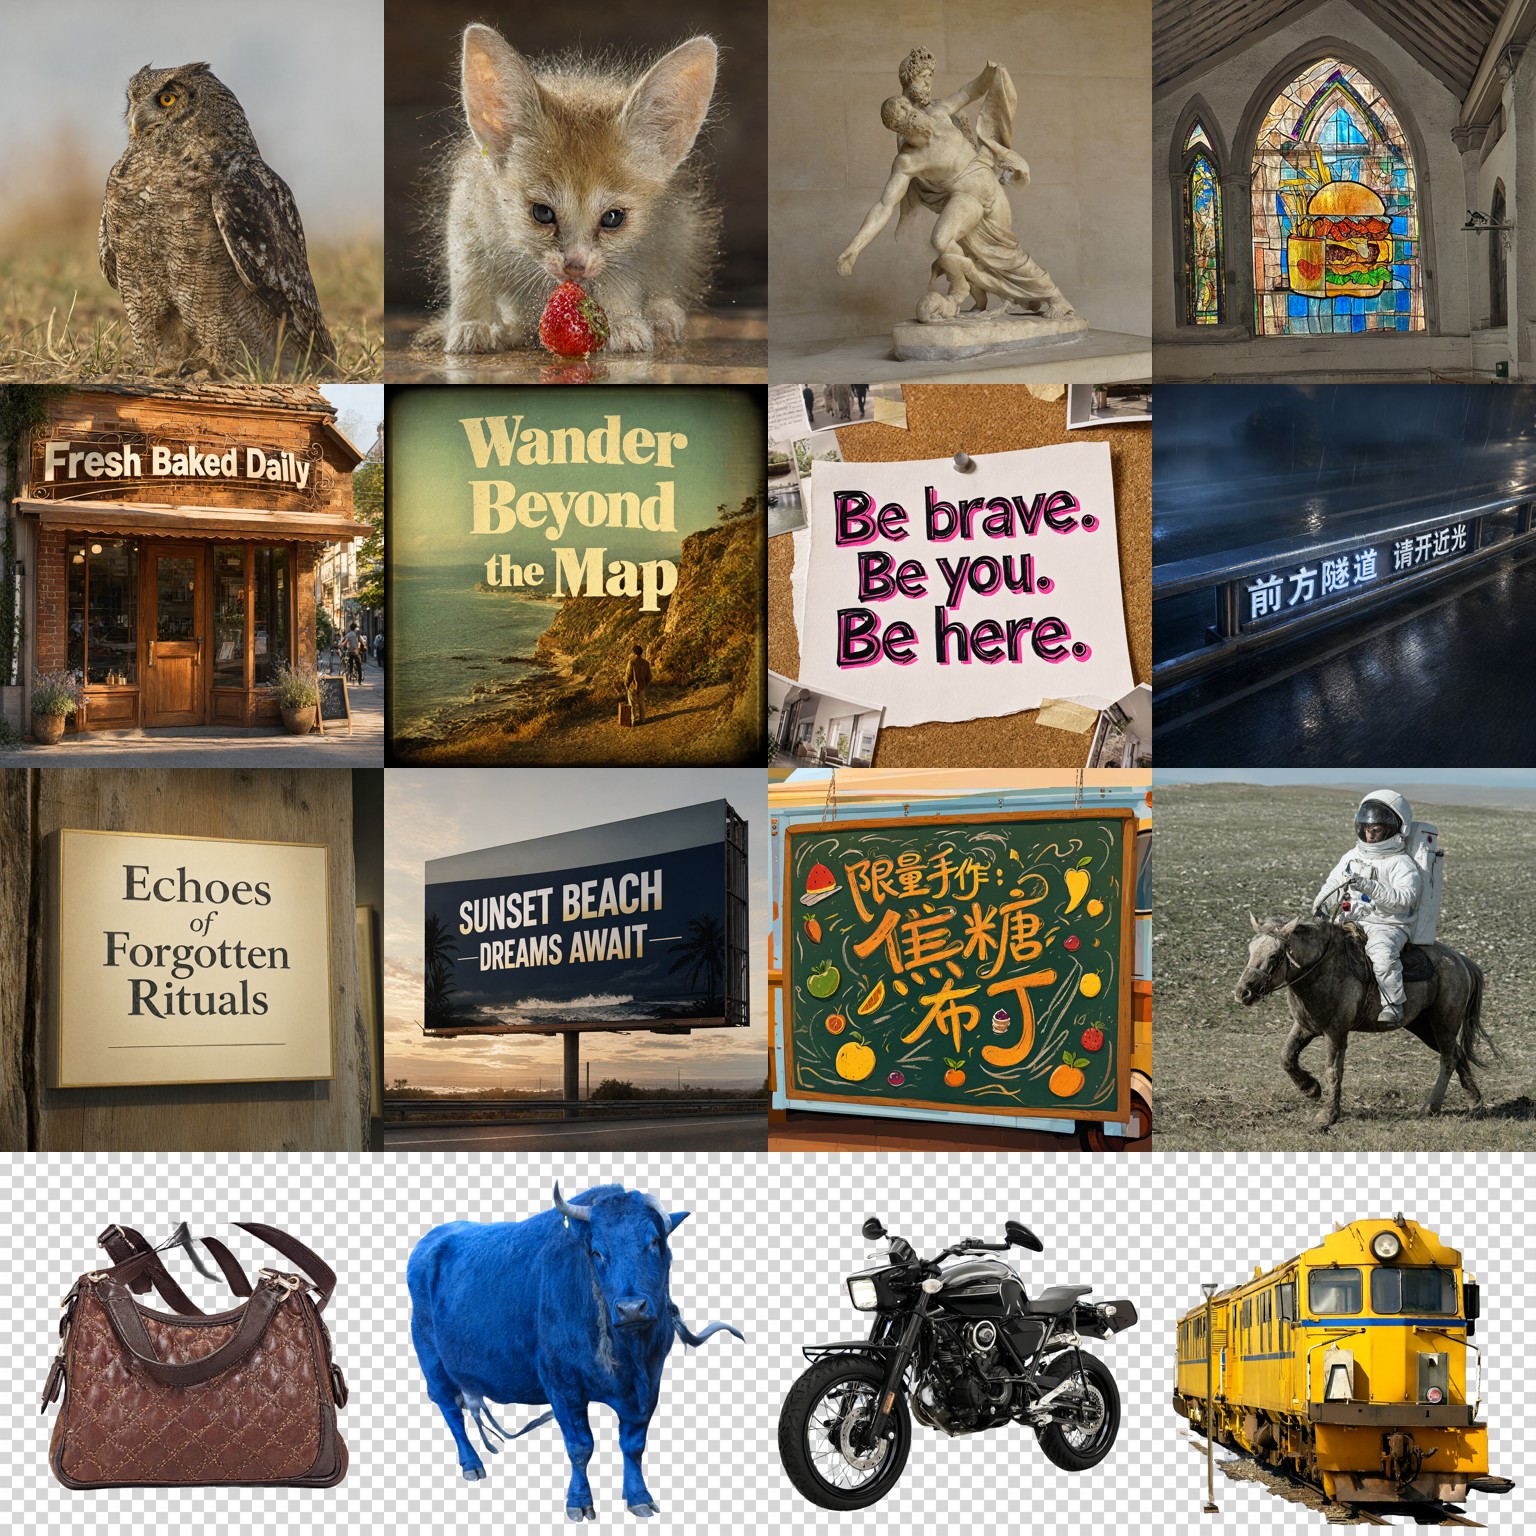
Turbo8은 Qwen-Image 2.1을 CFG 없이 8스텝으로 증류한 LoRA로, 텍스트 기반 이미지 생성, 편집, RGBA 출력과 피사체 추출을 지원하며 두 가지 ComfyUI 워크플로를 제공합니다.
 이미지 편집
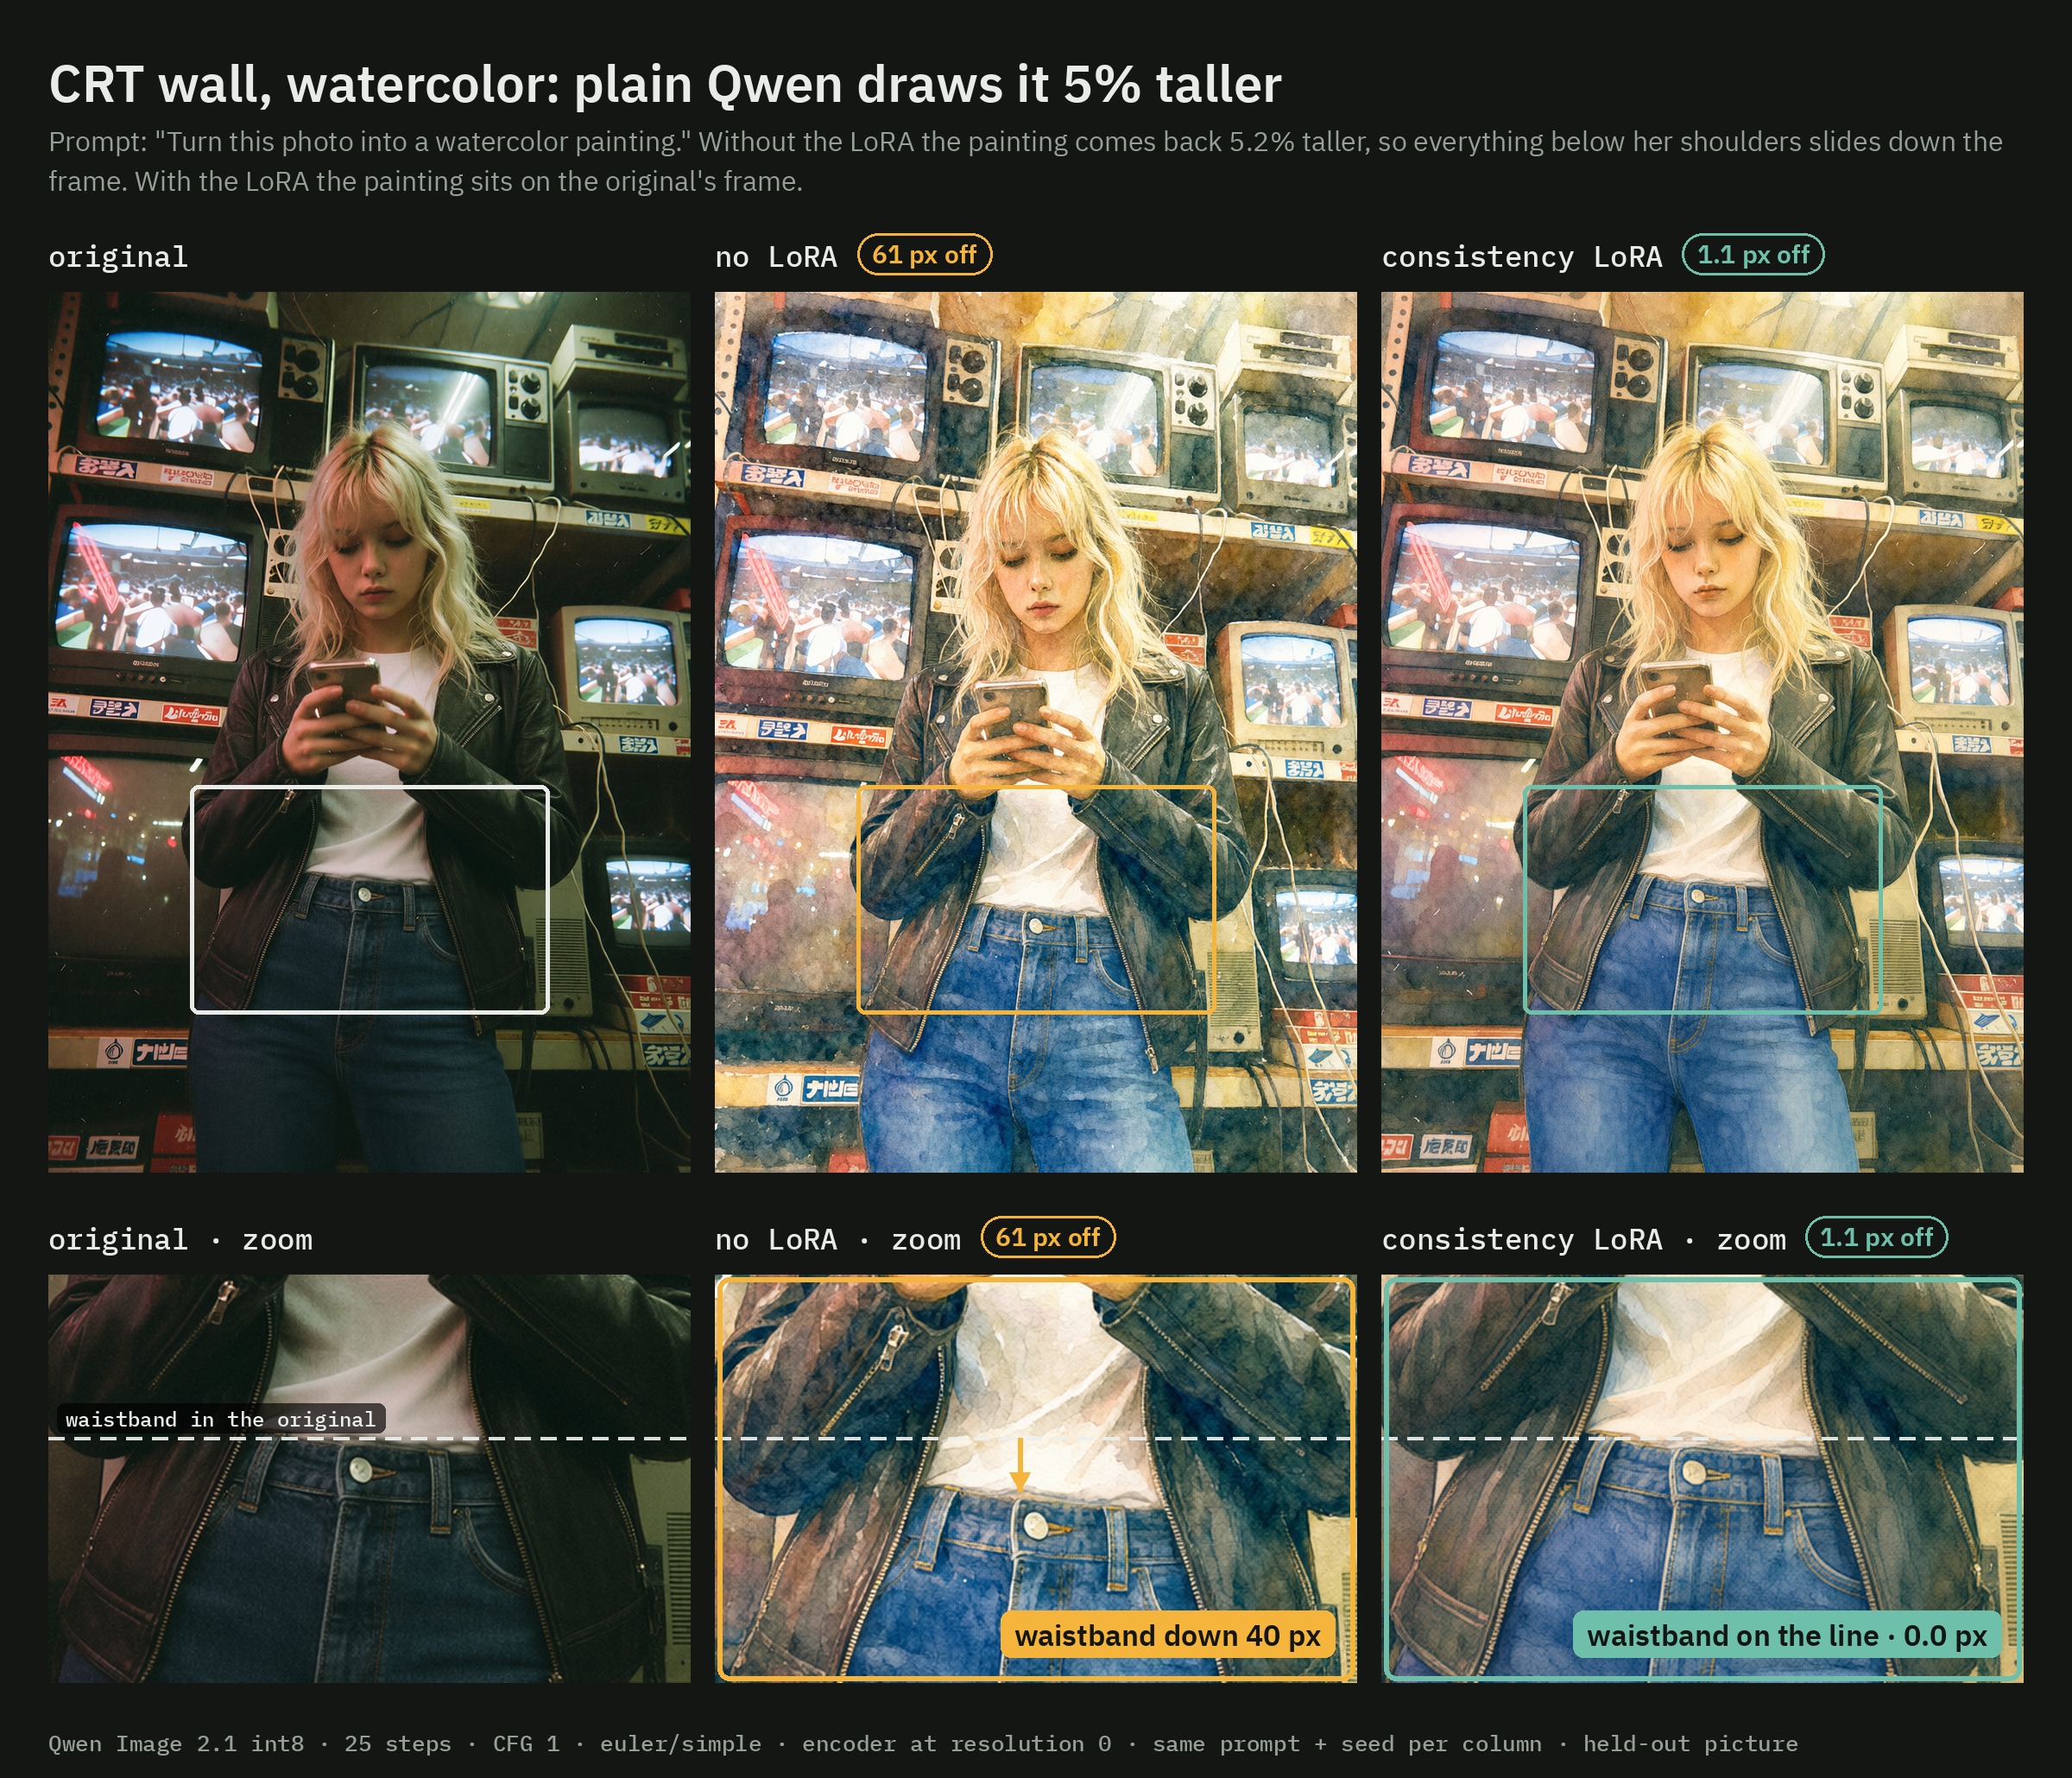
Qwen-Image 2.1용 커뮤니티 LoRA가 편집 결과를 원본 프레임에 고정합니다. 같은 프롬프트와 seed로 드리프트나 원치 않는 재도색 없이 결과를 얻을 수 있으며, 두 가지 ComfyUI 워크플로가 함께 제공됩니다.
 이미지 편집
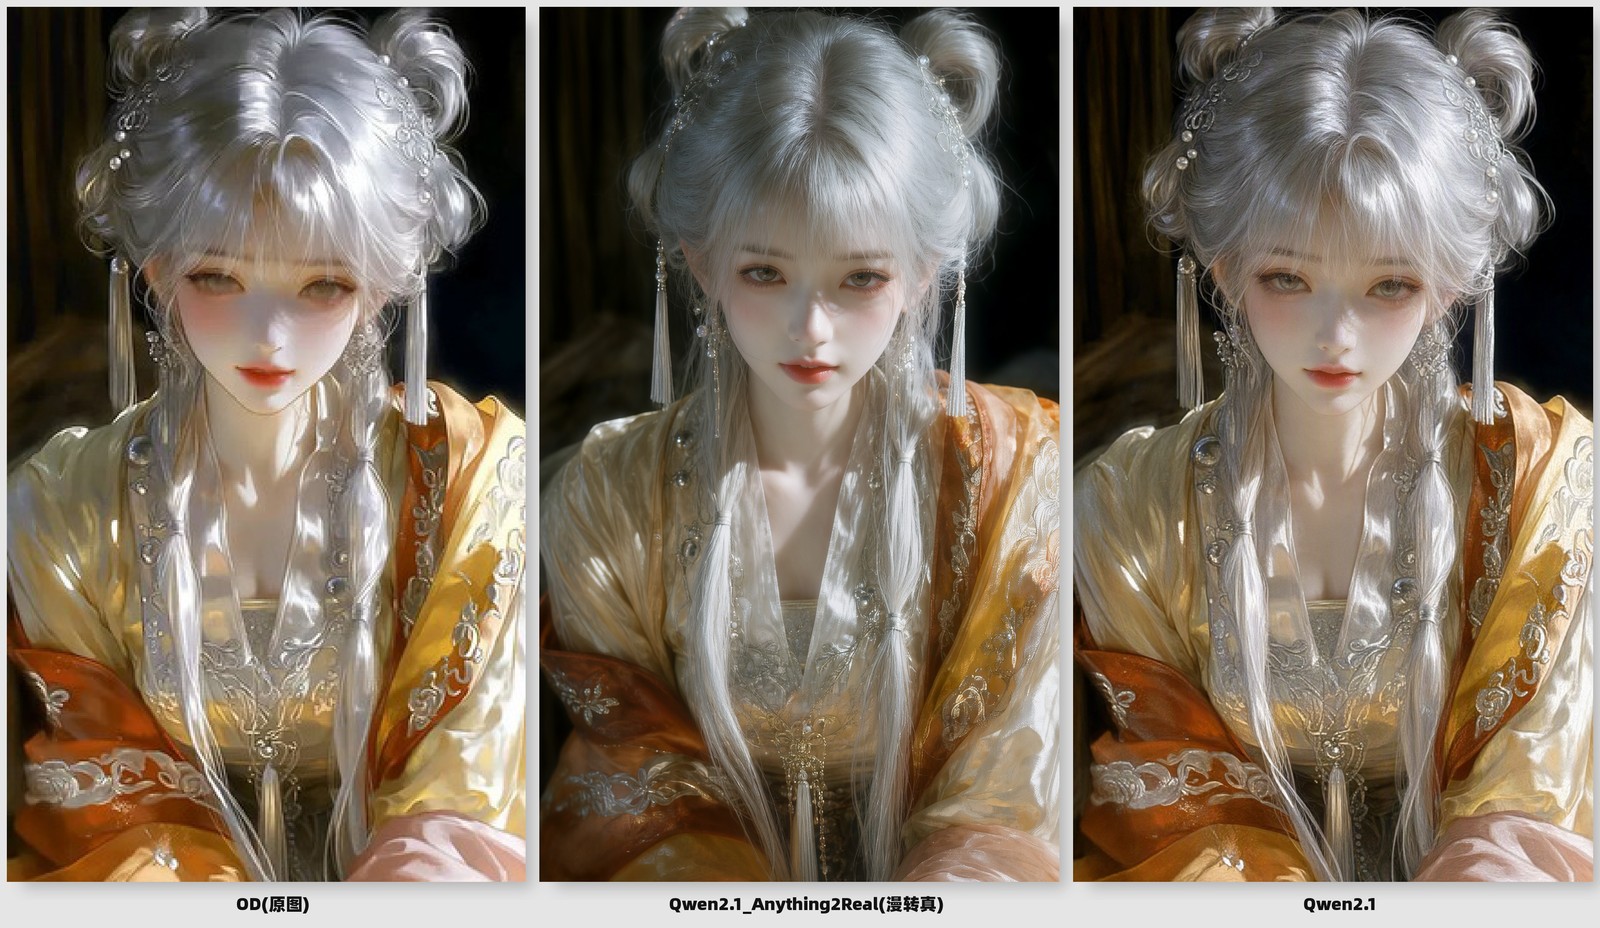
WarmBloodAban의 Qwen-Image 2.1 LoRA 팩은 애니메이션 캐릭터 일관성 어댑터와 일러스트를 실사 인물로 변환하는 어댑터를 함께 제공합니다.
Apache-2.0
 이미지→비디오
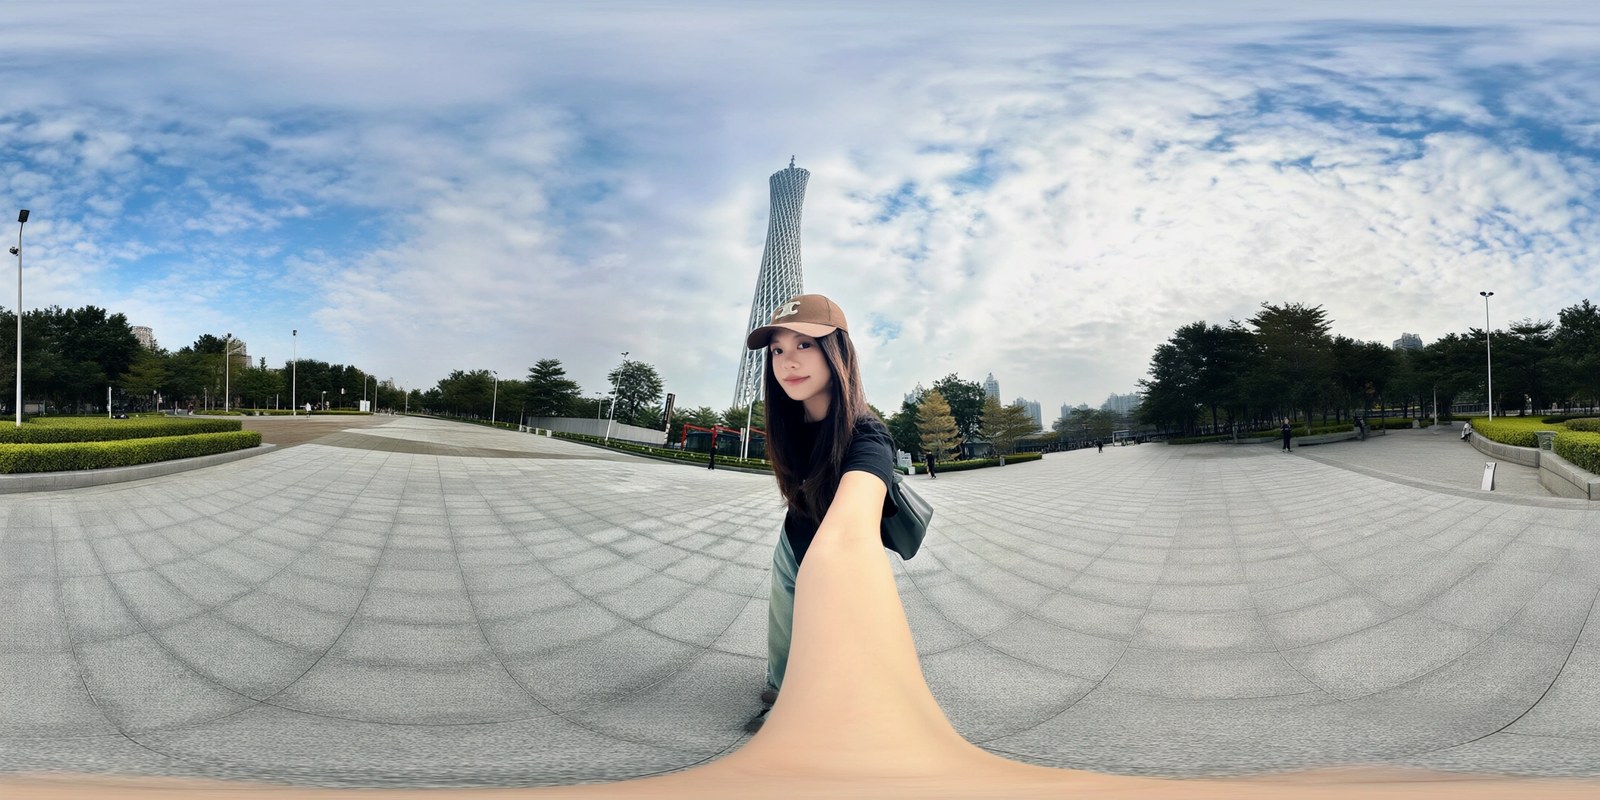
MiniMax H3 FL2VA용 커뮤니티 LoRA로, 사진 한 장을 자기 첫 프레임으로 되돌아오는 완전한 360도 카메라 궤도로 바꿔 줍니다. 최적의 ComfyUI 설정도 함께 정리했습니다.
 텍스트→이미지
Fizgig v6.5는 자체 학습 어댑터를 사용한 Qwen Image 2.1 LoRA 및 LoKR 학습, 터보 프리뷰, 새로운 드라이버 시스템을 추가하며, ComfyUI에서 로드되는 LoRA를 저장합니다.
 이미지→비디오
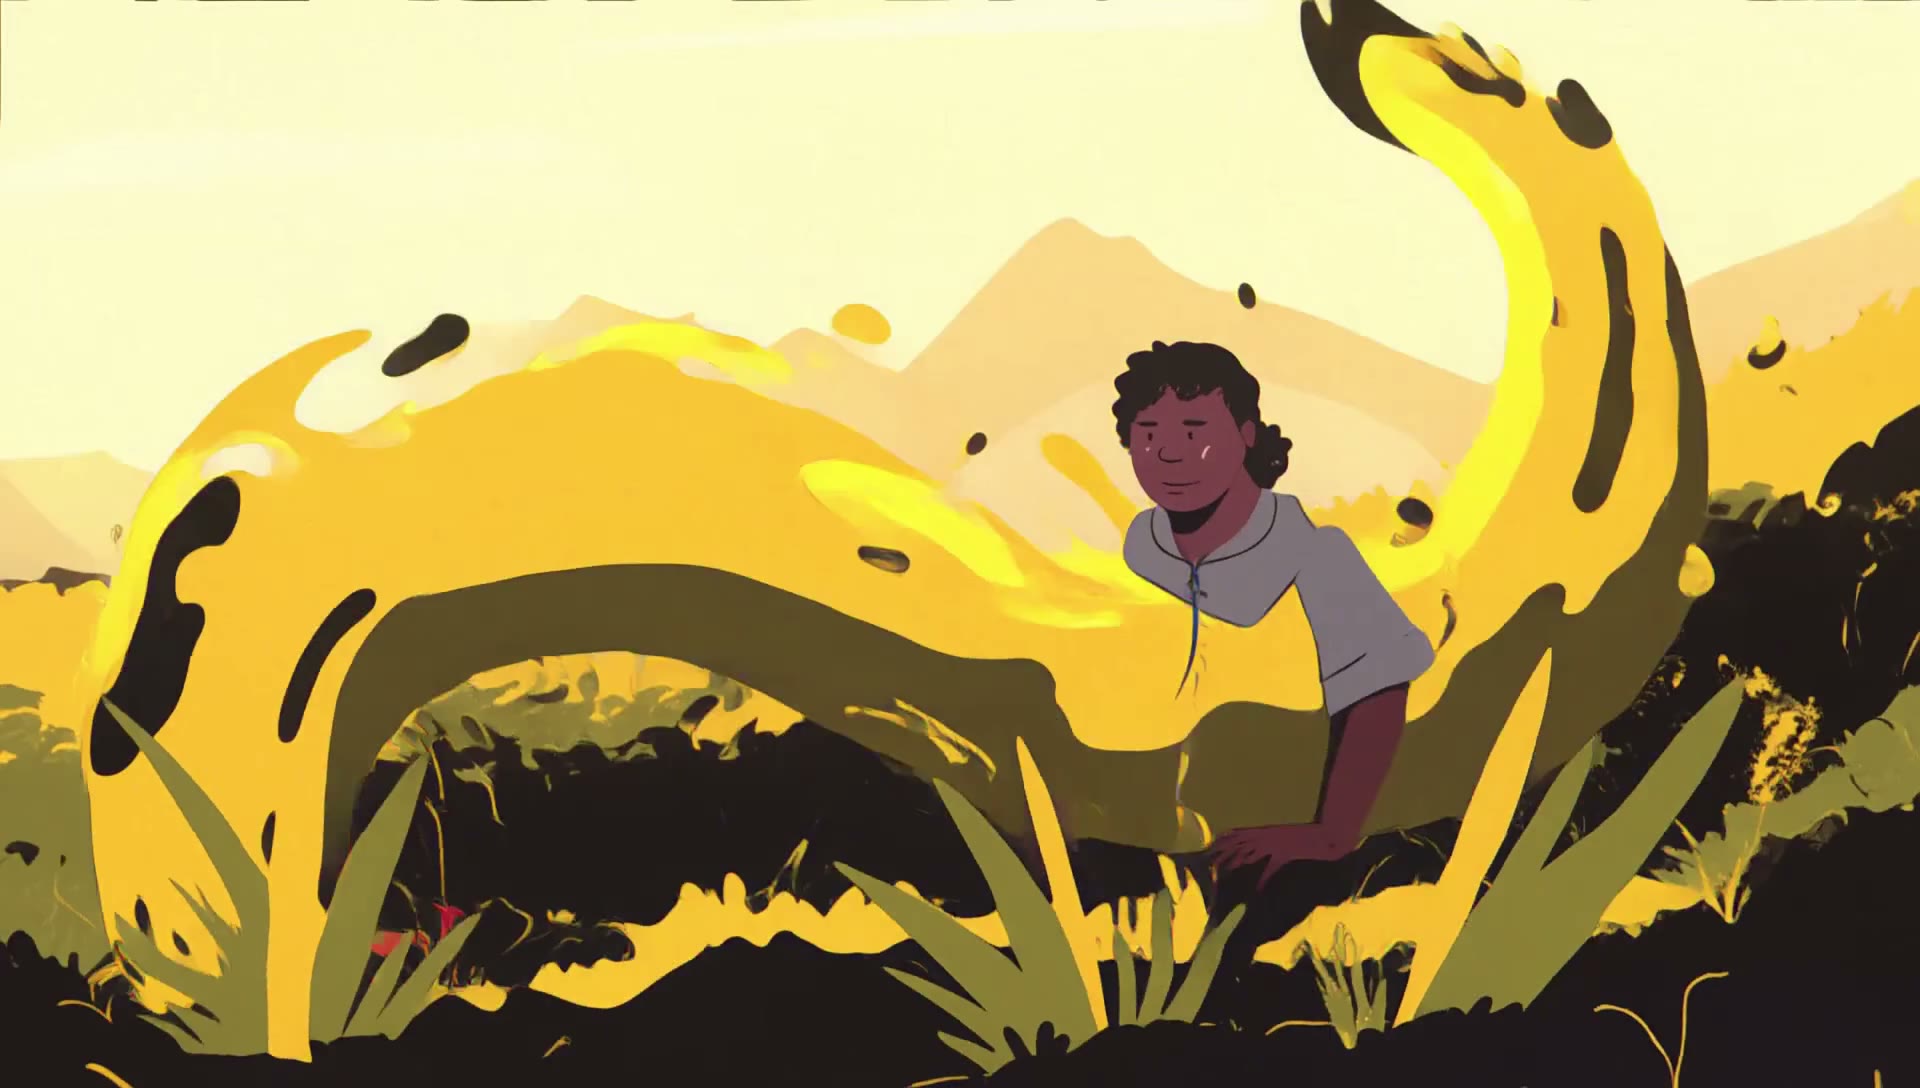
한 이미지를 다른 이미지로 모핑하는 MiniMax H3 LoRA입니다. ComfyUI에서 첫 프레임과 마지막 프레임 전환을 통해 요소, 재질, 피사체가 서로 변환됩니다.
 비디오 편집
Akatz Labs의 MiniMax H3 Ref2VA용 캐릭터 스왑 LoRA는 참조 비디오 속 한 인물을 캐릭터 이미지나 캐릭터 시트로 교체하며, 가중치와 데이터셋을 공개했습니다.
 텍스트→이미지
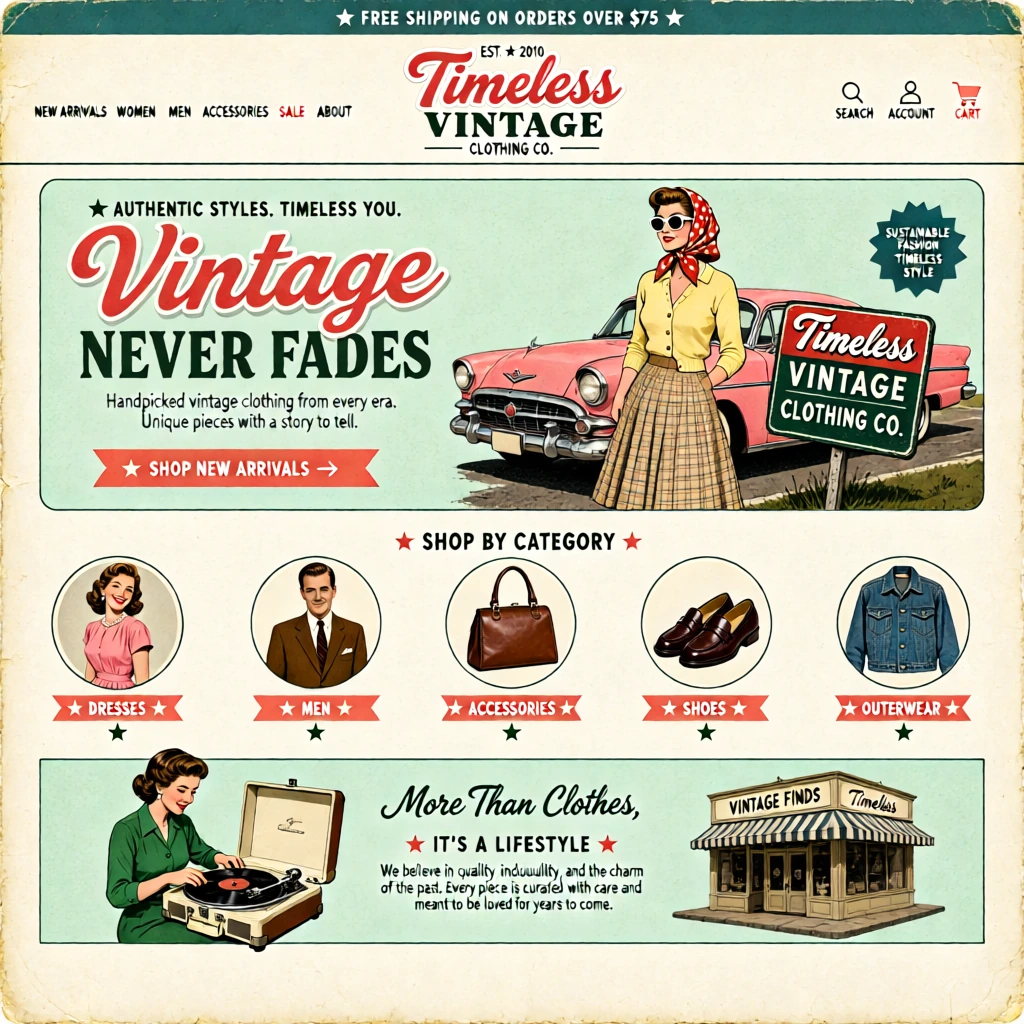
ComfyUI-Fizgig-H3-Still은 진정한 1프레임 MiniMax H3 잠재 데이터를 만들고 밴딩 없이 디코드하는 두 개의 노드를 추가하여 3 MP 이상에서 깔끔한 스틸 이미지를 제공합니다.