ComfyUI용 Pruna 5단계 및 8단계 Qwen-Image 2.1 LoRA
PrunaAI의 Pruna-Qwen-Image-2.1 LoRA는 CFG 없이 Qwen-Image 2.1 생성과 편집을 5단계 또는 8단계로 줄여 줍니다. 커뮤니티 ComfyUI 변환본과 단계별 시그마 스케줄도 함께 제공됩니다.
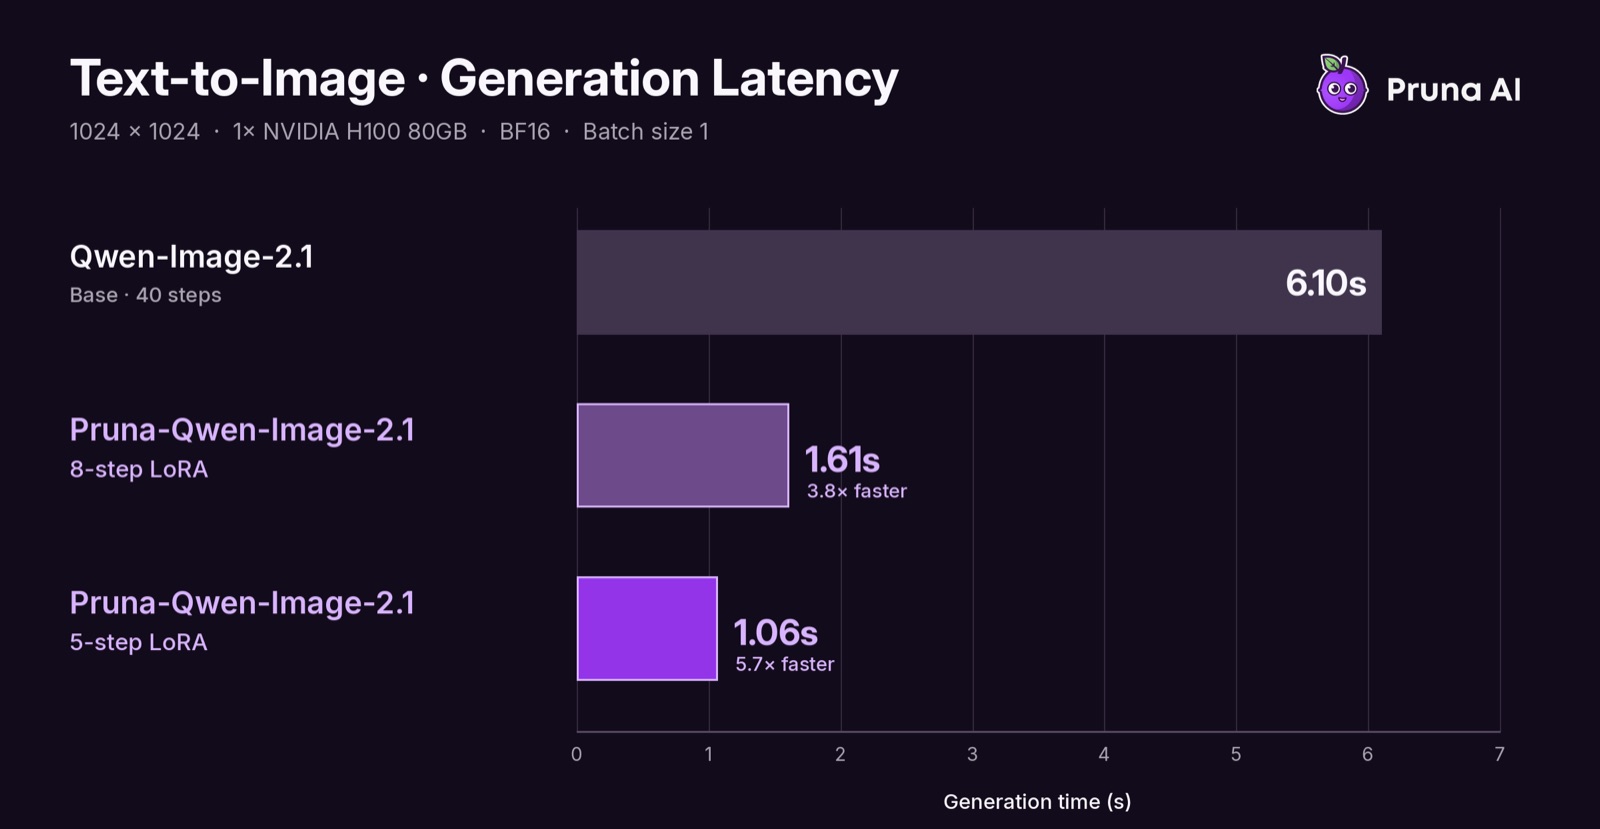
공식 모델 카드의 텍스트 기반 이미지 생성 비교.
두 개의 어댑터, 두 개의 스케줄
이번 릴리스는 하나의 증류 모델이 아니라 각각 따로 학습된 두 개의 모델이며, PrunaAI는 품질과 속도 중 무엇을 우선할지에 따라 하나를 고르면 된다고 설명합니다:
| 어댑터 | 단계 | 트레이드오프 |
|---|---|---|
p_qwen_image_2.1_8step_v0.1.safetensors | 8 | 품질이 더 높음, 권장 기본값 |
p_qwen_image_2.1_5step_v0.1.safetensors | 5 | 더 빠르지만 이미지 품질이 눈에 띄게 떨어짐 |
각 어댑터는 자체 시그마 스케줄에 맞춰 학습되었고, 모델 카드는 한 번에 하나만 로드할 것을 요구합니다. 스케줄은 정확히 복사해야 하는 부분입니다. 학습된 모델은 샘플러가 스스로 계산하는 단계 수에 맞춰 학습되지 않았기 때문입니다:
| 단계 | 시그마 |
|---|---|
| 5 | 1.0, 0.94, 0.857142857, 0.666666667, 0.4 |
| 8 | 1.0, 0.933333333, 0.857142857, 0.769230769, 0.666666667, 0.545454545, 0.4, 0.222222222 |
둘 다 DMD로 학습되었고, 빈 네거티브 프롬프트와 함께 CFG 1.0으로 실행되며, 마지막 0은 스케줄에 적힌 값이 아니라 스케줄러가 덧붙이는 값입니다. 다른 단계 수나 스케줄, CFG 값은 어댑터가 학습된 범위를 벗어납니다.
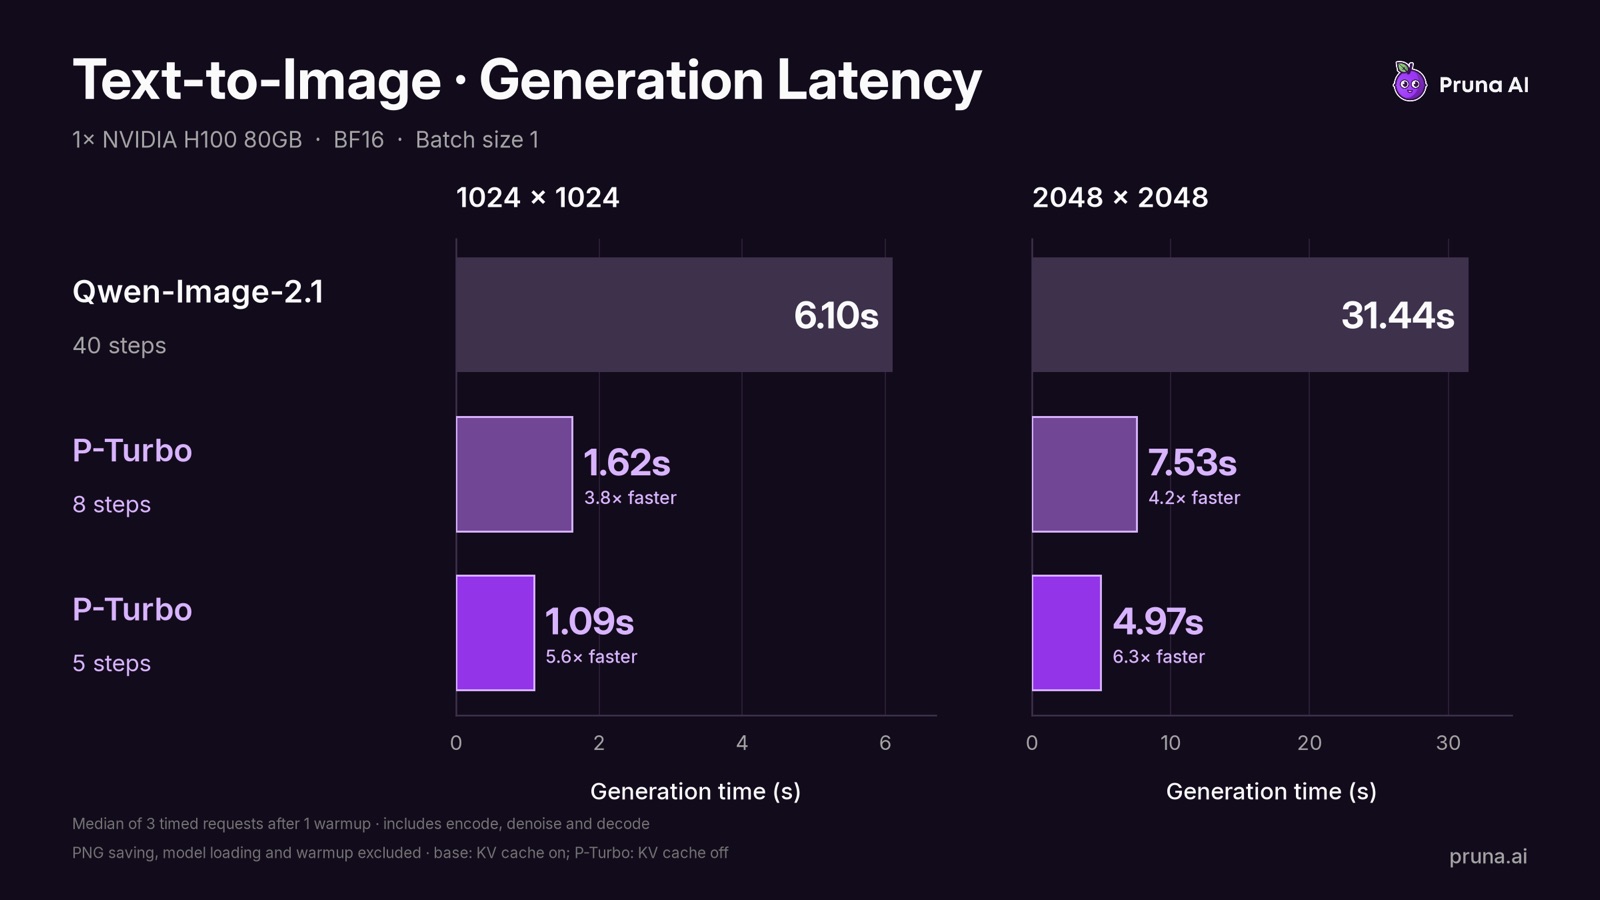
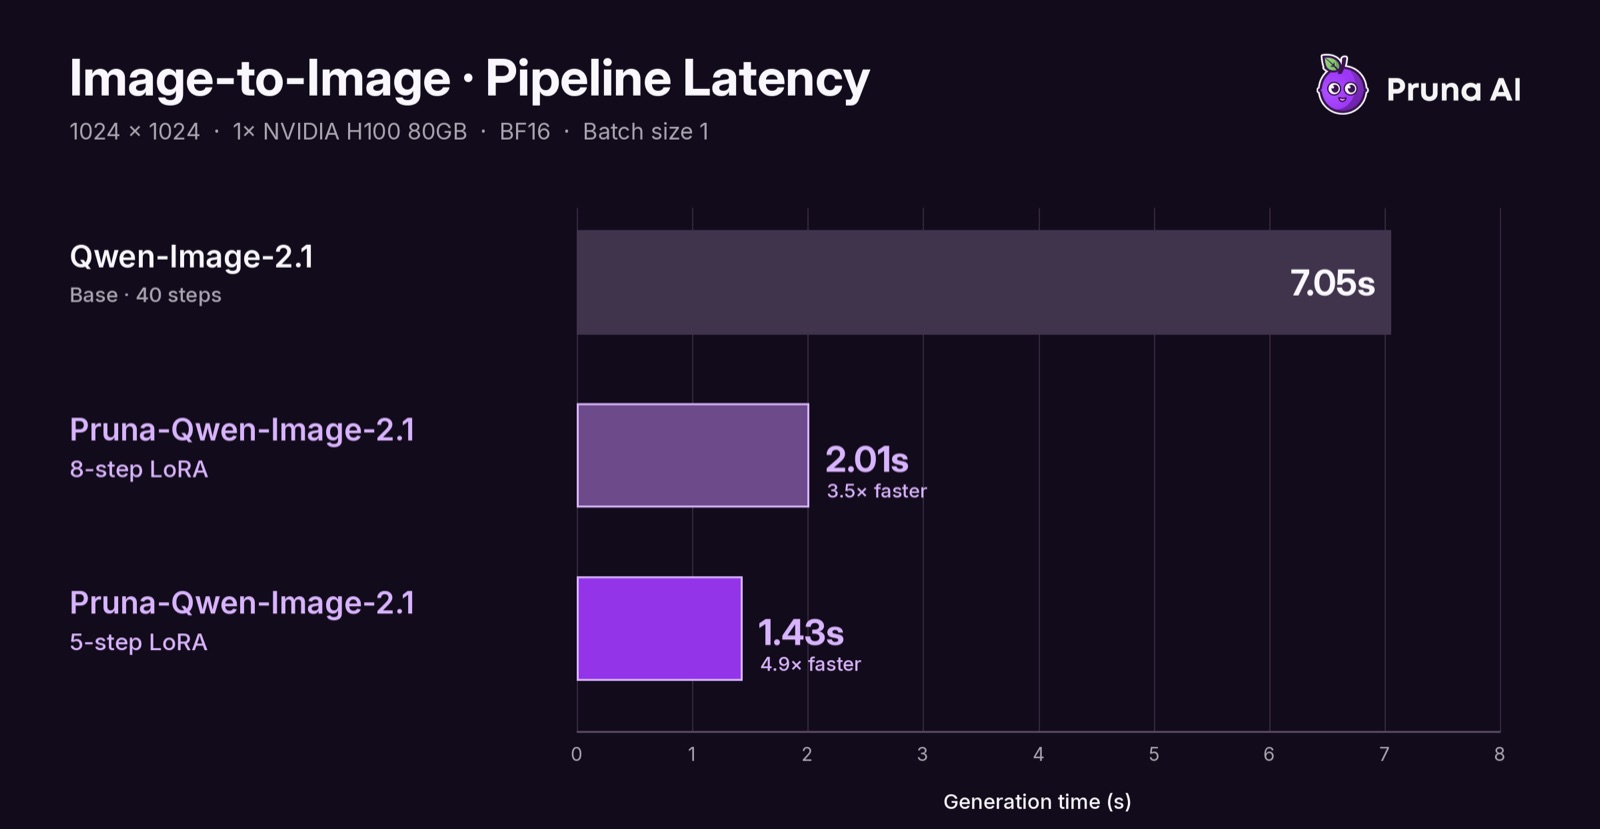
카드에 실린 텍스트 기반 이미지 생성 지연 시간 차트로, 단일 H100 80GB에서 측정했습니다. 워밍업 1회 후 3회 요청의 중앙값이며 프롬프트 인코딩, 디노이징, 디코딩을 포함합니다. 베이스 모델은 KV 캐시와 함께 40단계, 어댑터는 KV 캐시 없이 5단계 또는 8단계로 실행했습니다.
PrunaAI가 내세우는 수치는 최대 6.3배 빠름이며, 카드에서는 주장하지 않는 부분도 분명히 밝힙니다. 측정 시간이 동일한 이미지 품질을 의미하지는 않고, 벤치마크에서는 LoRA를 병합하지 않은 상태로 유지했으며, 예시 이미지는 KV 캐싱을 활성화한 반면 차트는 그 설정으로 다시 측정하지 않았습니다.
학습 범위와 한계
어댑터는 1K 해상도에서만 학습되었으며, 일반 프롬프트와 업샘플된 프롬프트를 섞어 텍스트 기반 이미지 생성과 최대 3장의 참조 이미지를 사용하는 단일 또는 다중 이미지 편집을 다룹니다. PrunaAI는 1024x1024에서 시작할 것을 권장하며, 2K 출력과 더 많은 참조 이미지, 짧고 모호한 프롬프트는 학습 범위를 벗어난 것으로 보아 품질이 달라질 수 있다고 설명합니다.
이 릴리스는 v0.1, 진행 중인 작업으로 명시되어 있습니다:
- 품질은 40단계 베이스 모델보다 낮으며, 증류가 개선되는 대로 저장소가 업데이트될 예정입니다.
- 5단계 어댑터는 빠른 쪽이며, 그 이미지는 8단계 어댑터보다 눈에 띄게 떨어집니다.
- 독립 실행형 모델이 아니므로
Qwen/Qwen-Image-2.1베이스 가중치가 여전히 필수입니다.
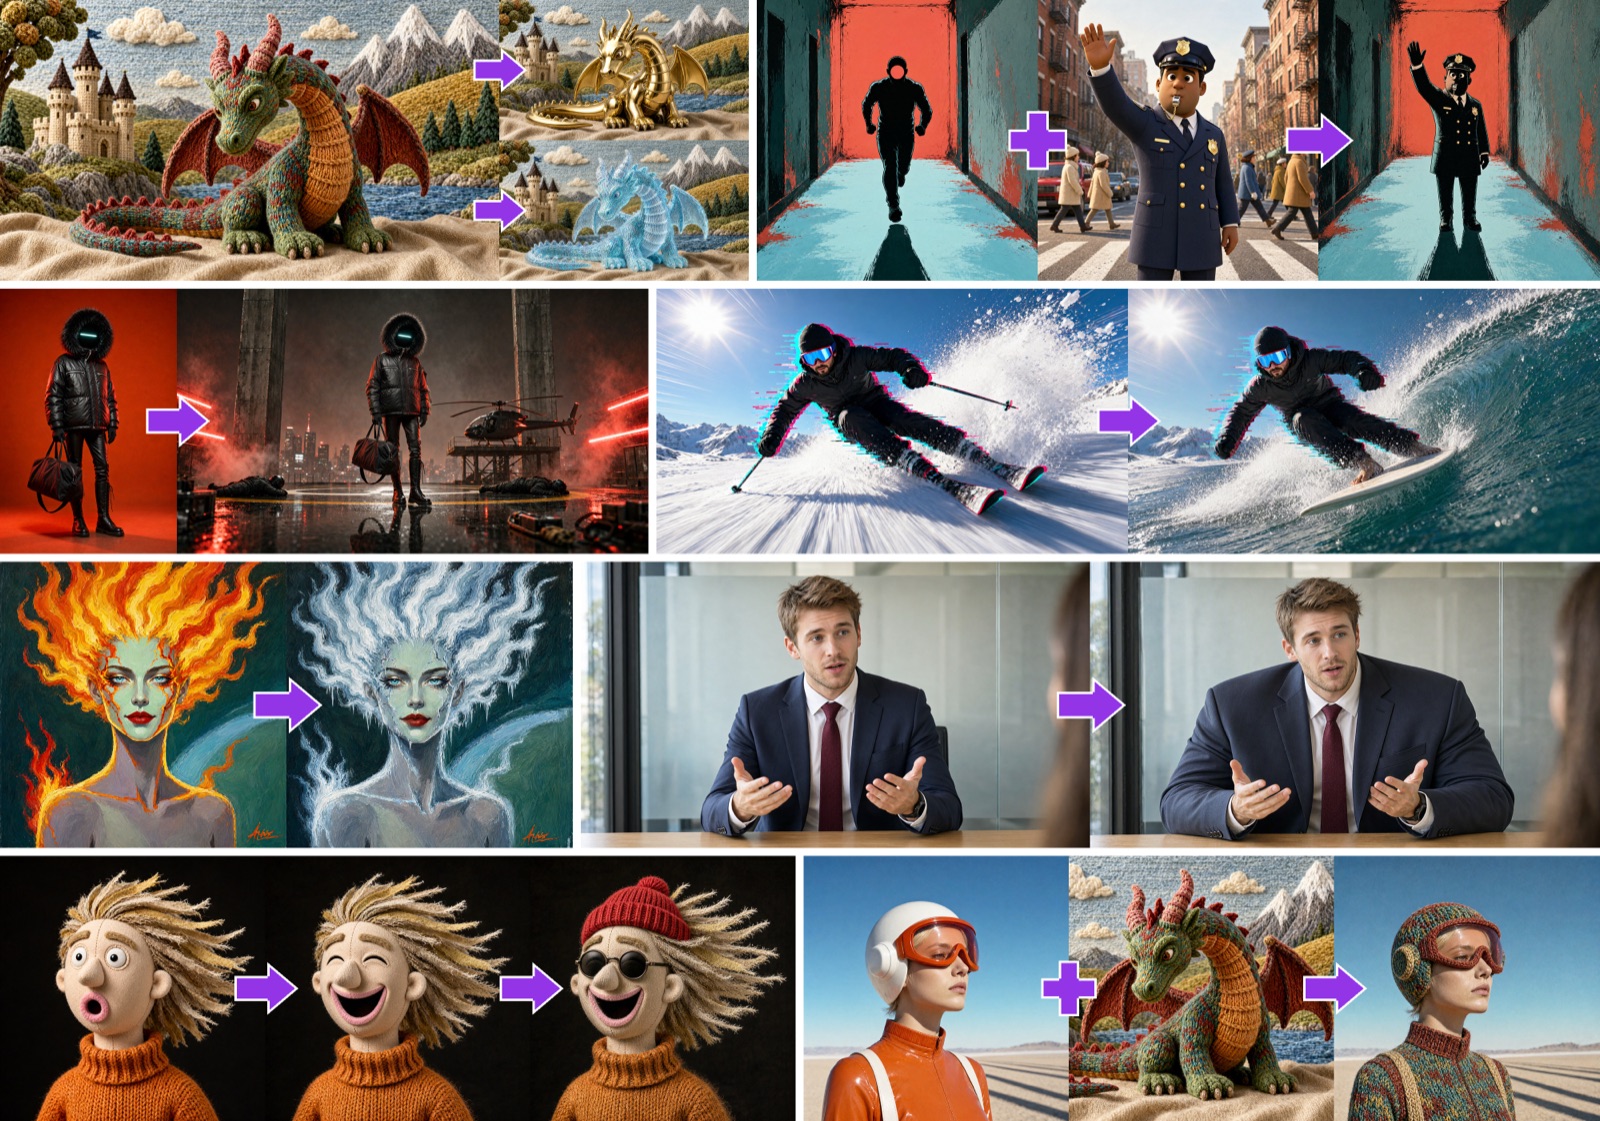
공식 모델 카드의 편집 그리드.
ComfyUI 사용 가능 여부
아직 어댑터용 공식 ComfyUI 패키지는 없습니다. 이들은 rank 64와 PEFT 알파 128을 가진 diffusers/PEFT 파일로 배포되는데, 알파가 ComfyUI의 LoRA 로더가 읽는 tensor가 아니라 safetensors 메타데이터에 저장되어 있어 그대로 넣으면 잘못된 스케일로 실행됩니다. 커뮤니티는 릴리스 하루 만에 이 격차를 메웠습니다:
NidAll/pruna-image-2.1-comfyui-loras는 비공식 변환본으로, 224개 LoRA 대상 각각에 스칼라.alphatensor를 추가해 LoRA 강도 1.0에서 어댑터가 의도된 스케일로 실행되도록 하며, A와 B 가중치는 건드리지 않습니다. 자체 5단계 및 8단계 워크플로 JSON도 함께 제공합니다.- 이 워크플로는 네이티브 ComfyUI 노드만 사용합니다:
ManualSigmas,SamplerCustom, Euler, CFG 1.0, LoRA 강도 1.0, 네거티브 프롬프트 없음, 1024x1024 텍스트 기반 이미지 생성. 베이스 파일은Comfy-Org/Qwen-Image-2.1에서 가져오므로, 소비자용 VRAM 환경에서는int8_convrottransformer가 실질적인 대상입니다.
ComfyUI는 Day-0 릴리스 이후 Qwen-Image 2.1을 네이티브로 지원하므로 추가로 설치할 것은 없습니다. ManualSigmas와 SamplerCustom이 있는 최근 ComfyUI라면 함께 제공되는 두 워크플로를 모두 처리할 수 있습니다.
모델 카드에 실린 편집 샘플로, 소수 단계 어댑터로 실행했습니다.
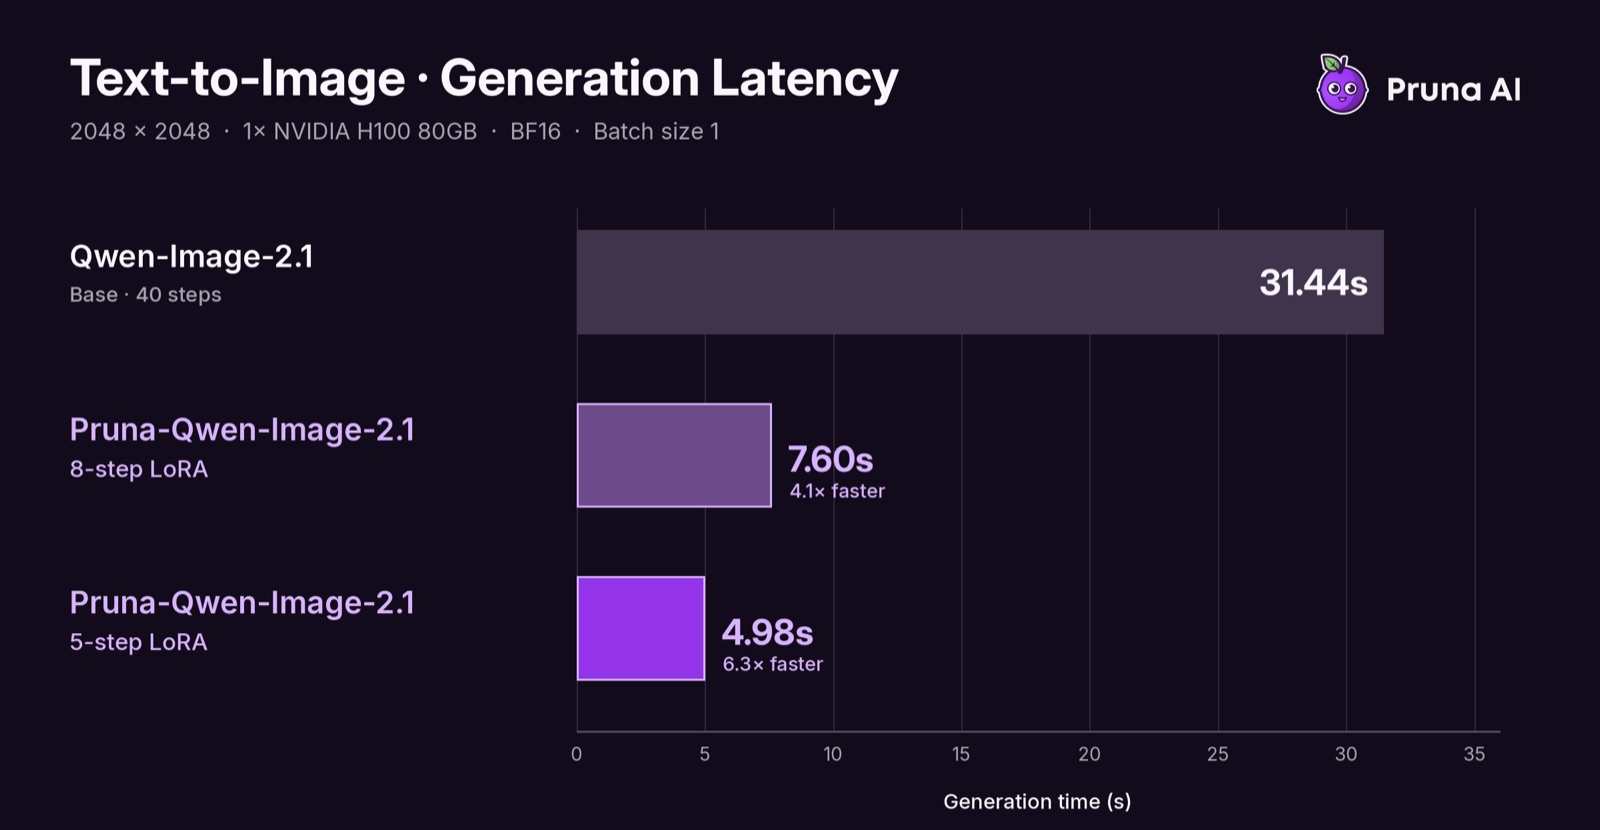
2048 해상도의 텍스트 기반 이미지 생성으로, 1K 학습 범위를 벗어나지만 공개된 지연 시간 측정에는 포함됩니다.
초기 테스트는 릴리스 자체보다 주로 ComfyUI 커뮤니티에서 나오고 있습니다. 어댑터는 Banodoco #qwen-image 채널에서 Viggle의 turbo 및 공식 Qwen Acc LoRA와 비교되었으며, 테스터들은 8단계 어댑터를 특히 주목했습니다. 또한 가중치가 공개된 직후 r/StableDiffusion과 X에 게시되었습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.