Texture-Fix-VAE: Qwen-Image 2.1용 더 깨끗한 VAE 디코더
madebyollin의 Texture-Fix-VAE는 체커보드 텍스처 아티팩트를 제거하도록 Qwen-Image 2.1 VAE 디코더를 재학습한 모델입니다. 파일을 ComfyUI/models/vae에 넣고 평소처럼 로드하면 됩니다.
ComfyUI/models/vae/에 복사한 뒤 Load VAE 노드에서 선택하면 됩니다.
Qwen-Image 2.1은 압축된 잠재 공간에서 denoise하며, VAE 디코더는 그 잠재 데이터를 다시 픽셀로 되돌리는 마지막 단계입니다. 디코더가 깨끗하게 복원하지 못한 부분은 샘플링이 아무리 훌륭했더라도 완성된 이미지에 그대로 남습니다. 사용자들은 출시 이후부터 이 증상을 계속 언급해 왔습니다. 나뭇잎, 머리카락, 직물처럼 복잡한 영역에서 나타나는 희미한 2픽셀 그리드와 약간 디더링된 듯한 느낌입니다.
Texture-Fix-VAE는 바로 그 단계를 겨냥합니다. 인코더는 건드리지 않았으므로 잠재 데이터 형식, 샘플링 스케줄, 모든 LoRA 및 양자화된 checkpoint가 그대로 작동합니다.
이전과 이후
작성자는 아래 비교를 위해 미세한 텍스처가 가득한 사진 스타일 프롬프트로 Qwen-Image 2.1에서 잠재 데이터를 생성했습니다:
한여름 미국 태평양 북서부의 아고산 야생화 초원 풍경 사진: 이끼 낀 바위를 휘돌아 보라색 루피너스와 빨간색 페인트브러시 사이로 흐르는 맑은 산속 시내, 뒤로 펼쳐진 울창한 원시림 더글러스 전나무와 서양측백나무 숲, 멀리 보이는 설산, 황금빛 늦은 오후 햇살, 매우 정교한 디테일
두 열 모두 동일한 잠재 데이터를 디코딩한 것이므로, 차이는 오직 디코더에서만 비롯됩니다.
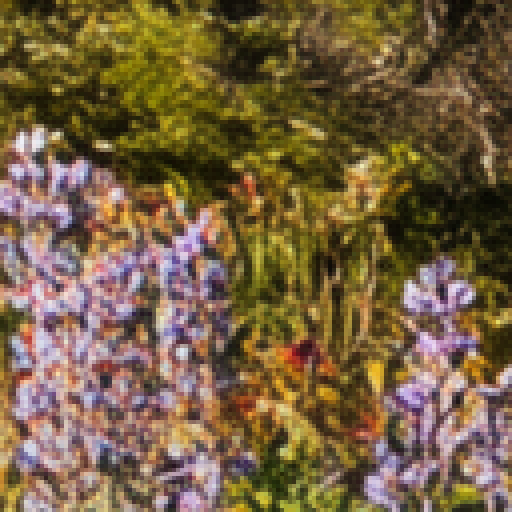 | 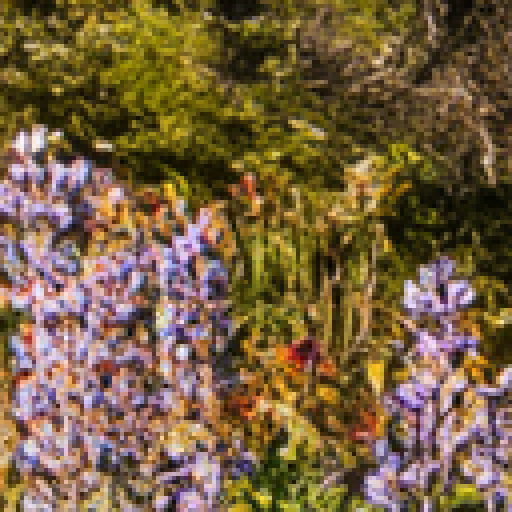 |
|---|---|
| 기본 VAE, 확대한 크롭 | Texture-Fix-VAE, 동일한 크롭 |
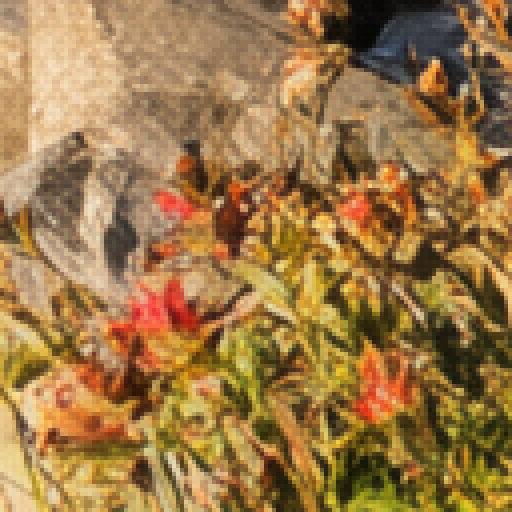 | 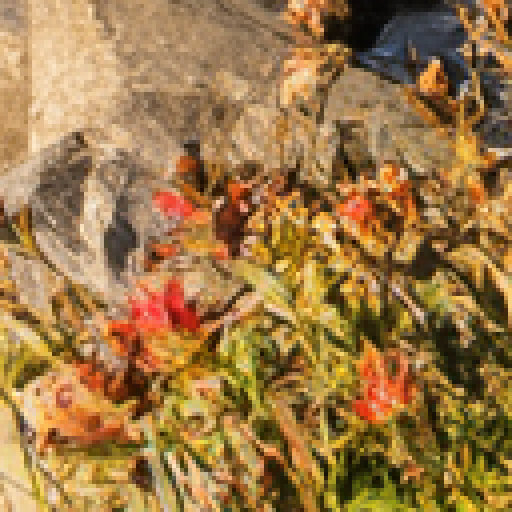 |
|---|---|
| 기본 VAE, 두 번째 확대 크롭 | Texture-Fix-VAE, 동일한 크롭 |
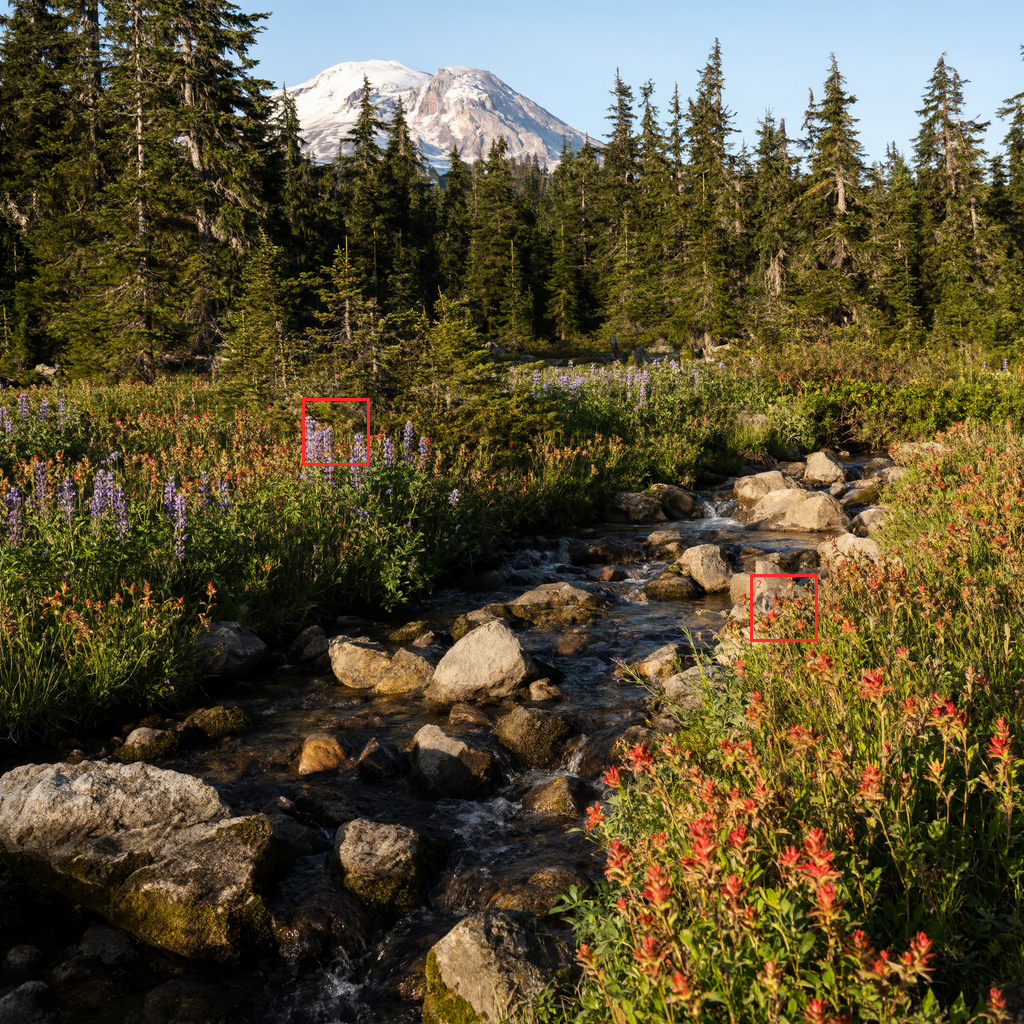 | 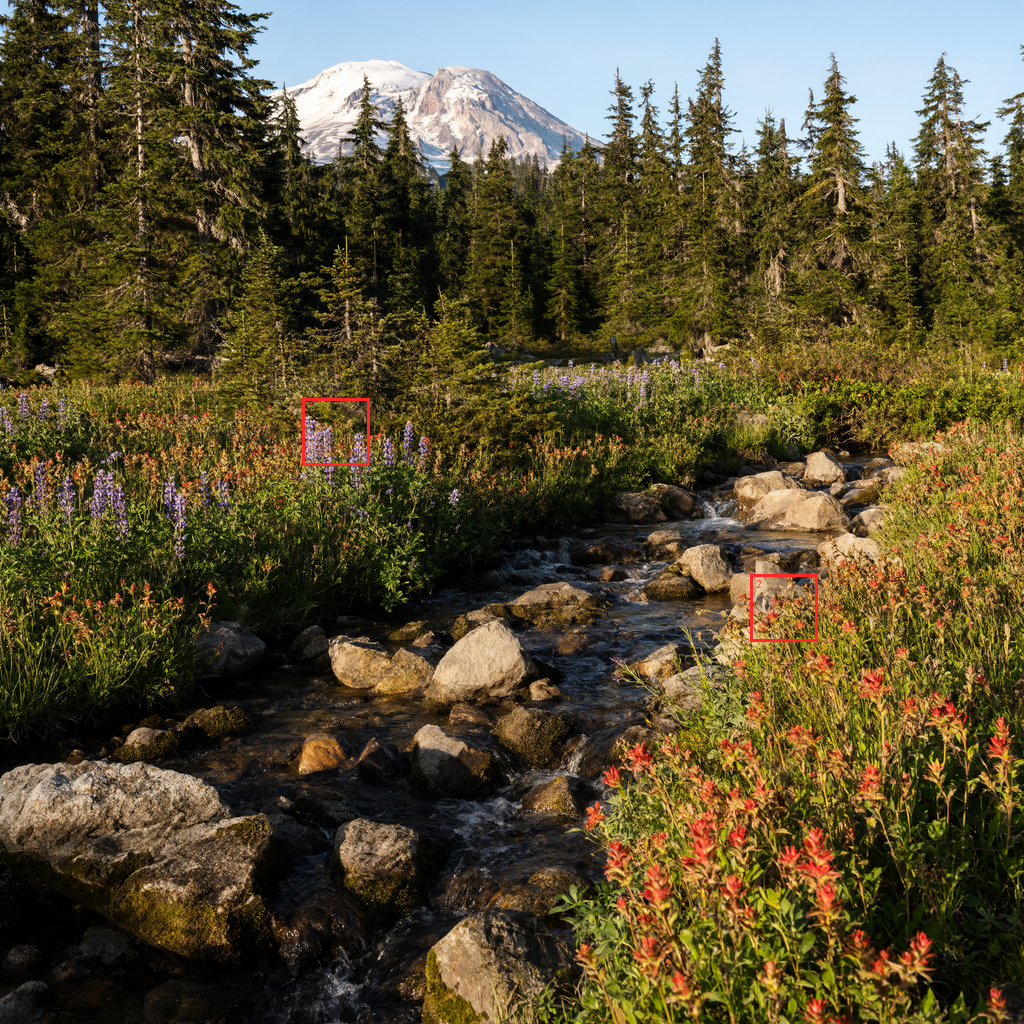 |
|---|---|
| 기본 VAE, 1024 x 1024 전체 디코딩 | Texture-Fix-VAE, 전체 디코딩 |
내부에서 무엇이 바뀌었나
디코더만 파인튜닝했으며, 대략 학습률 3e-5로 5,000 스텝 진행했습니다. 해상도가 가장 높은 두 개의 디코더 스테이지와 출력 헤드는 동결하지 않았고, 이는 약 750만 개의 학습 가능한 파라미터에 해당합니다. 학습에는 작성자가 TAESD를 위해 개발한 레시피를 사용했습니다.
이 레시피는 세 가지 loss 계열을 섞으며, 각각은 복원을 서로 다른 방향으로 밀어붙입니다:
| Loss | 보상하는 것 |
|---|---|
| MSE / MAE (PSNR 중심) | 안전한 평균화. 배치할 수 없는 디테일을 흐리게 만듦 |
| LPIPS | 지각적 그럴듯함. 미세한 텍스처에서는 블러와 체커보드 무늬로 나타남 |
| 적대적 (GAN) | 뚜렷하고 그럴듯한 디테일. 명백히 합성된 모습 대신 실제처럼 보이게 함 |
여기서 차이를 만드는 것은 적대적 항입니다. 작성자의 해석에 따르면 원본 Qwen-Image 2.1 VAE는 작동하는 적대적 loss 항 없이 학습되었으며, 이는 그리드를 설명해 줍니다. 명백히 가짜인 구조를 벌하는 항이 없었기 때문에 지각적 항이 체커보드 무늬 쪽으로 자유롭게 밀어붙일 수 있었던 것입니다.
지표
| 지표 | Qwen-Image 2.1 VAE | Texture-Fix-VAE |
|---|---|---|
| rFID, 낮을수록 좋음 (COCO val2017, 256² 기준 5000개 이미지) | 3.37 | 2.08 |
| PSNR, 높을수록 좋음 (COCO val2017, 256²) | 33.30 | 32.86 |
| LPIPS, 낮을수록 좋음 (COCO val2017, 256²) | 0.0357 | 0.0373 |
| PSNR, 높을수록 좋음 (DIV2K valid, 네이티브 1024² 크롭) | 32.86 | 32.46 |
| LPIPS, 낮을수록 좋음 (DIV2K valid, 네이티브 1024² 크롭) | 0.0460 | 0.0480 |
이는 GAN 스타일 디코더의 전형적인 트레이드오프입니다. 지각적 품질(rFID)은 약 3분의 1 개선되는 반면, 복원 정확도(PSNR과 LPIPS)는 아주 약간 떨어집니다. 작성자는 개선 효과가 평면적인 일러스트보다 디테일이 많은 사진 스타일 이미지에서 가장 두드러진다고 언급합니다.
ComfyUI에서 사용하기
texture_fix_vae_for_qwen_image_2.1_bf16.safetensors를 ComfyUI/models/vae/에 다운로드한 다음, Load VAE 노드에서 qwen_image_2.1_vae_bf16.safetensors 대신 선택하세요. 노드, 워크플로, 샘플러를 변경할 필요가 없으며 언제든 원래 파일로 되돌릴 수 있습니다.
ComfyUI 외부에서는 동일한 가중치를 일반 diffusers VAE로 로드할 수 있습니다:
import torch
from diffusers import QwenImage21Pipeline, AutoencoderKLQwenImage21

vae = AutoencoderKLQwenImage21.from_pretrained(
    "madebyollin/texture-fix-vae-for-qwen-image-2.1", torch_dtype=torch.bfloat16
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", vae=vae, torch_dtype=torch.bfloat16
).to("cuda")
제공 정보
가중치: madebyollin/texture-fix-vae-for-qwen-image-2.1
ComfyUI 파일: texture_fix_vae_for_qwen_image_2.1_bf16.safetensors
베이스 모델: Qwen/Qwen-Image-2.1
작성자의 이전 작업: TAESD, sdxl-vae-fp16-fix
댓글
GitHub로 로그인하고 토론에 참여하세요.