ComfyUI에서 실행되는 Qwen-Image 2.1 프롬프트 향상 모델
Qwen의 PE-T2I 및 PE-I2I 프롬프트 재작성 모델이 짧은 요청과 편집 지침을 확장하며, 커뮤니티 노드 팩이 CLIP 로드를 통해 두 모델을 ComfyUI에서 실행합니다.
각 작업에 하나씩, 두 개의 재작성기
PE 체크포인트는 Qwen3.5-VL 9B를 파인튜닝한 모델로, 2026-09-20에 베이스 모델과 함께 공개되었으며, 공식 Qwen-Image 2.1 README는 이들을 프롬프트를 준비하는 기본 방법으로 권장합니다. "최상의 결과를 얻으려면 공식 프롬프트 재작성 모델을 사용해 짧은 프롬프트를 상세하고 고품질의 설명으로 확장하는 것을 권장합니다."
- PE-T2I는 모든 언어의 짧은 요청을 긴 영어 프롬프트와 권장 화면 비율로 변환합니다. 응답은
think블록 뒤에 JSON으로 반환됩니다:{"rewritten_prompt": ..., "wh_ratio": "16:9"}. - PE-I2I는 편집 지침과 최대 10개의 참조 이미지를 입력으로 받으며, 이미지는
<image1>,<image2>등으로 지칭되고, 정확한 편집 프롬프트를 반환합니다. JSON 응답에는 출력이 상속해야 할 화면 비율을 가진 입력 이미지의 이름을 담은ratio_follow가 추가됩니다.
두 모델 모두 thinking을 활성화한 상태로 샘플링하도록 설계되었습니다. 공식 예시는 temperature 1.0, top_p 0.95, top_k 20을 사용하며, 텍스트 기반 이미지 생성 체크포인트에는 max_new_tokens 16256, 편집용에는 24000을 사용합니다.
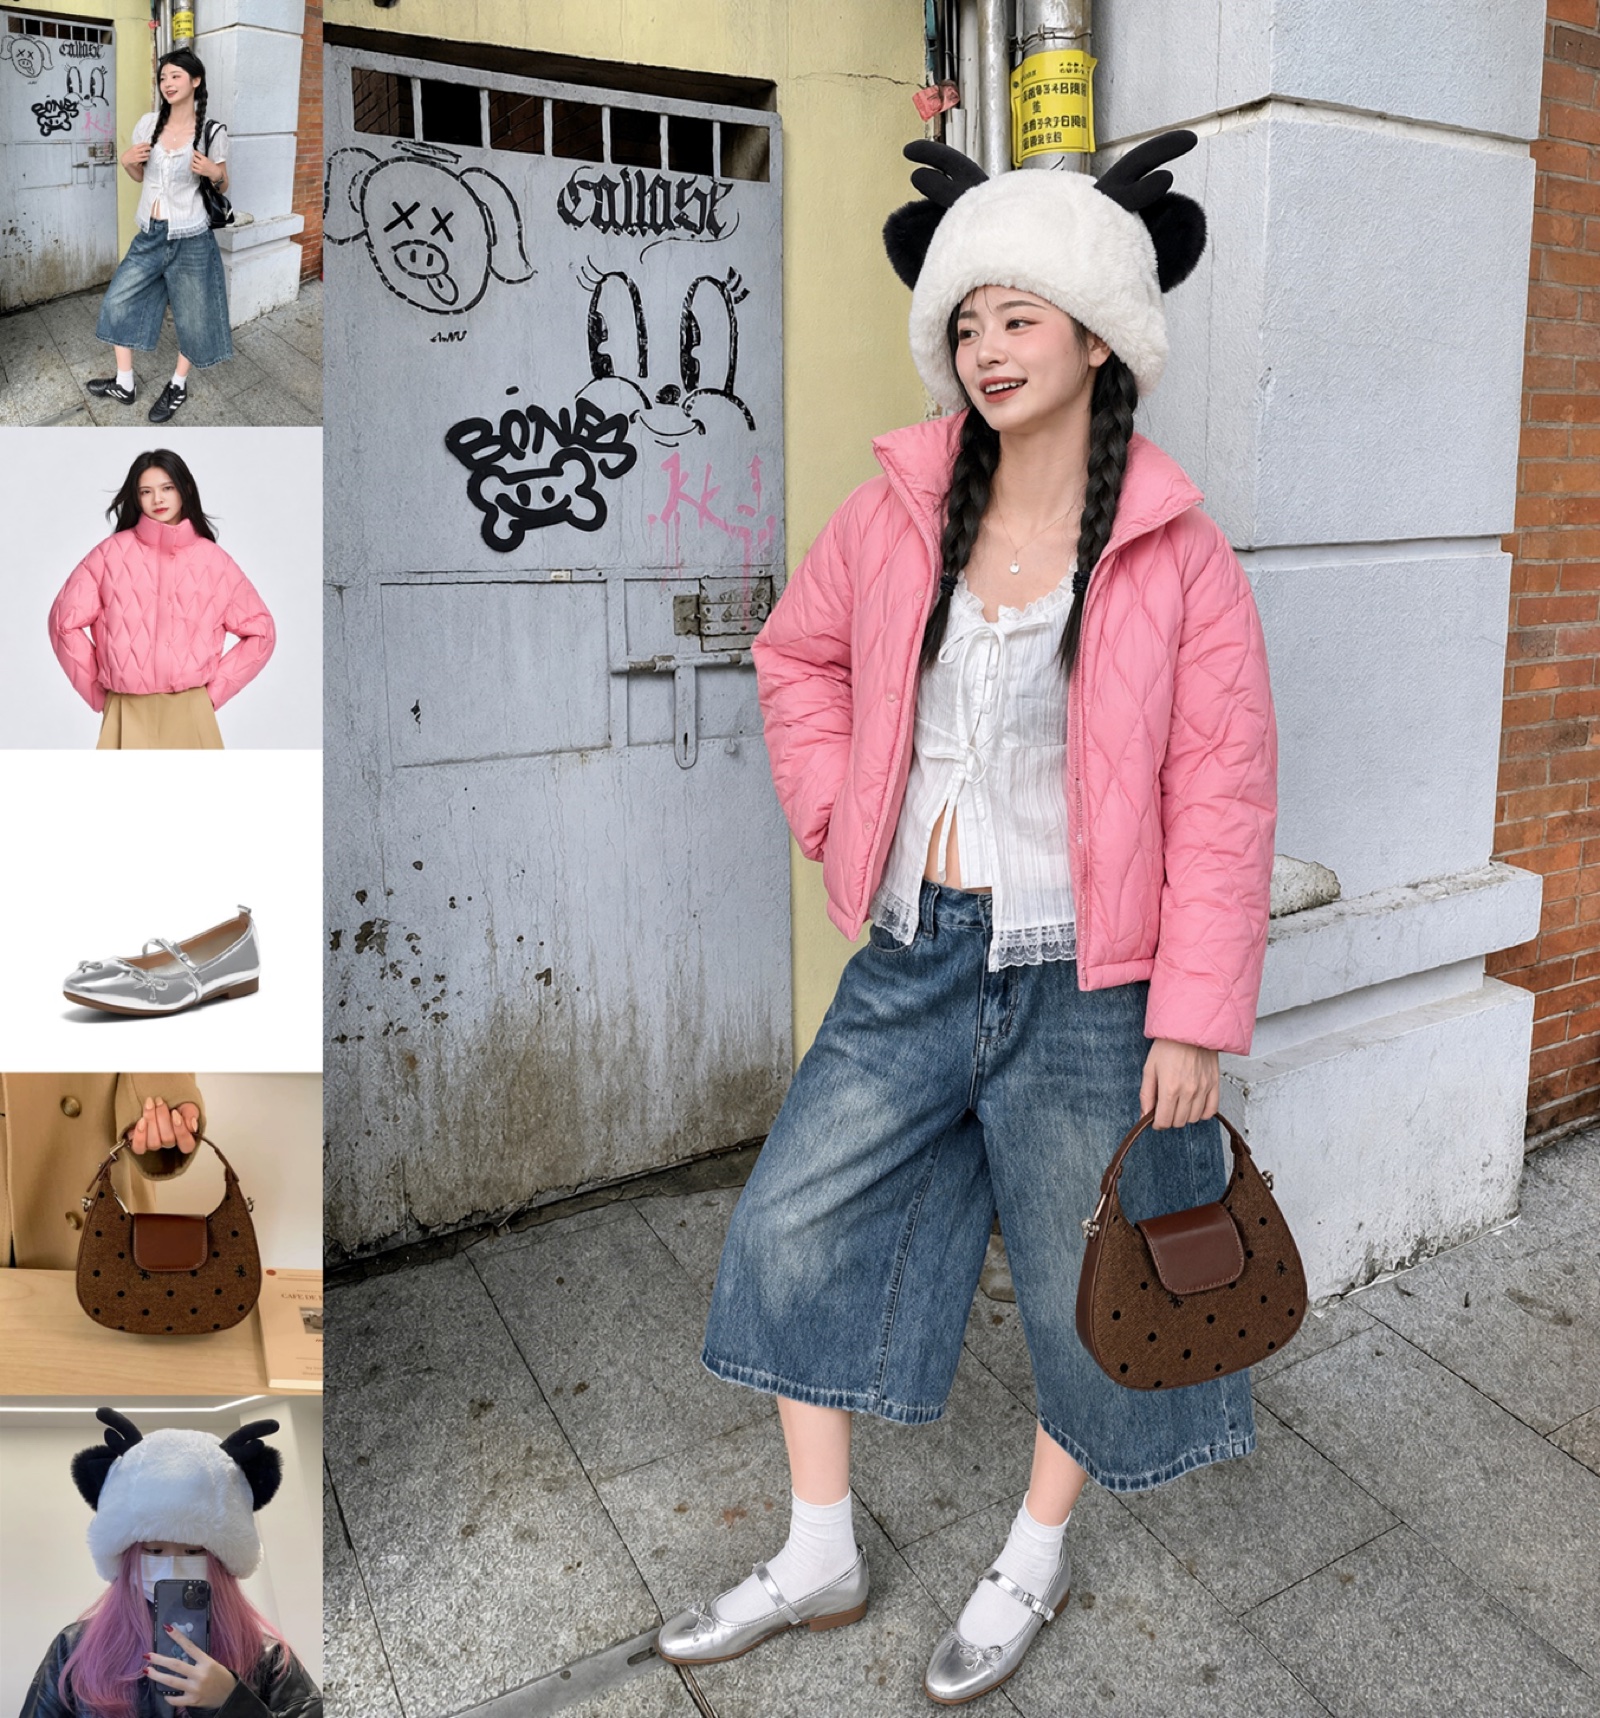
공식 Qwen-Image 2.1 예시: 다섯 개의 참조 이미지로 구성한 의상으로, PE-I2I 재작성기가 명시적 프롬프트로 변환하도록 훈련된 멀티 이미지 지침 유형입니다.
ComfyUI 내부에서 실행하기
ComfyUI의 공식 Qwen-Image 2.1 템플릿 세 개는 텍스트 기반 이미지 생성, 이미지 편집, 배경 제거를 다루며, 그중 어느 것도 재작성기를 호출하지 않습니다. Comfy-Org가 Comfy-Org/Qwen-Image-2.1에 두 PE 가중치를 int8 convrot 파일로 재패키징하기는 했지만(text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors 및 ..._pe_i2i...), 이를 로딩하는 것은 절반에 불과합니다. 채팅 프롬프트를 구성하고, JSON을 다시 읽고, 결과를 샘플러에 노출하는 작업이 여전히 필요합니다.
이 노드 팩은 두 개의 노드로 이를 정확히 수행하며, 둘 다 Qwen Image 카테고리에 등록됩니다.
| 노드 | 입력 | 출력 |
|---|---|---|
QwenImage21_T2IPromptRewrite | CLIP, prompt, 샘플링 제어 | positive_prompt, negative_prompt, wh_ratio, thinking, parse_ok |
QwenImage21_EditPromptRewrite | CLIP, prompt, image_1 … image_10 | 동일, 추가로 ratio_follow |
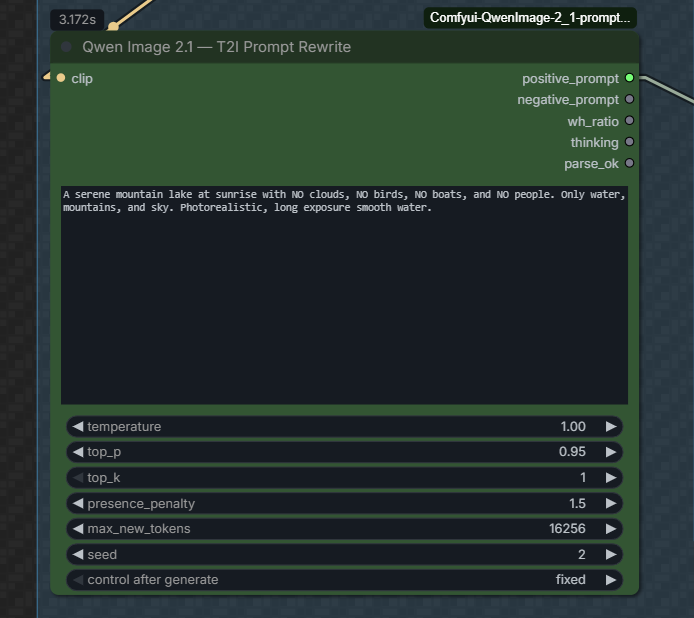
T2I 재작성 노드: 짧은 프롬프트가 입력되면 확장된 프롬프트, 화면 비율, 추론 과정이 출력됩니다.
PE 파일은 일반 Load CLIP 노드에 type = qwen_image를 설정해 로드하며, 생성은 ComfyUI 자체의 clip.tokenize() → clip.generate() → clip.decode() 경로를 통해 실행됩니다. 내장 TextGenerate 노드 뒤에 있는 것과 동일한 메커니즘입니다. 외부 서버도, 별도의 transformers 파이프라인도 필요 없습니다.
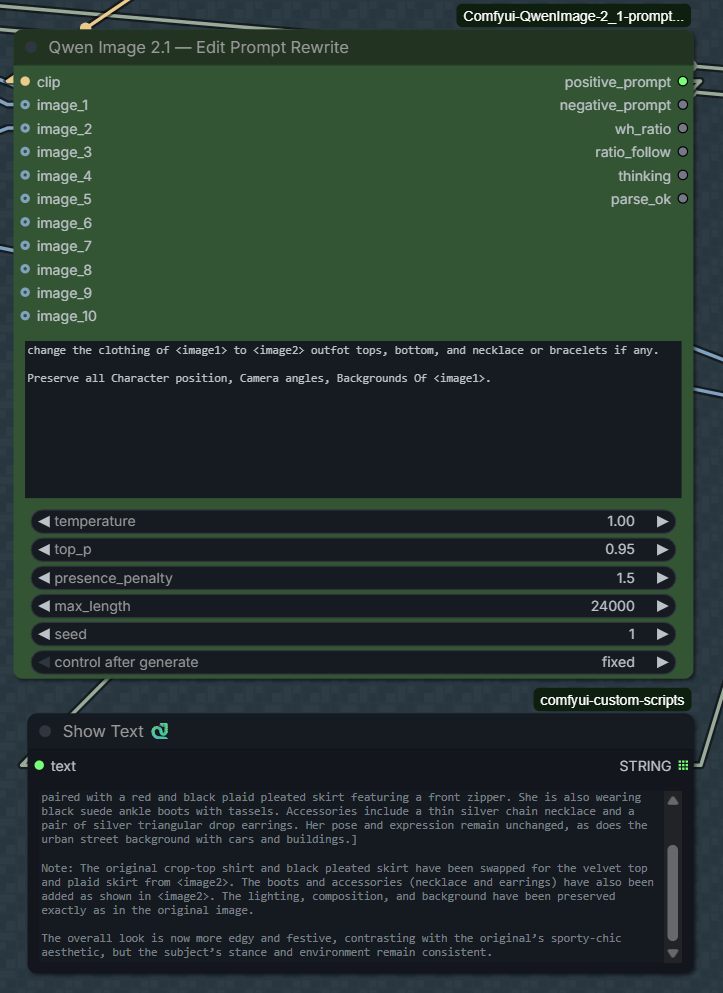
편집 노드는 10개의 이미지 슬롯을 노출하고 재작성된 지침과 상속할 비율을 반환합니다.
몇 가지 설정은 README에서 그대로 가져올 가치가 있습니다. 두 체크포인트가 이를 공유하지 않기 때문입니다.
| 매개변수 | T2I | Edit |
|---|---|---|
presence_penalty | 1.5 | 0 |
max length | 16256 | 24000 |
thinking | 켜짐 | 켜짐 |
높은 페널티는 텍스트 기반 이미지 생성 재작성기가 같은 내용을 반복하지 않도록 막아 주는 반면, 편집 재작성기는 이를 사용하지 않고 실행되도록 설계되었습니다. 두 모델 모두 think 블록으로 훈련되었기 때문에, 이 팩은 JSON을 파싱하기 전에 추론 과정을 답변에서 분리하고, 답변이 깨끗하게 파싱되면 parse_ok를 보고합니다. 선택 사항인 json_repair 패키지를 설치하면 약간 잘못된 형식의 답변도 실패하는 대신 복구할 수 있습니다.
그래프에 연결하기
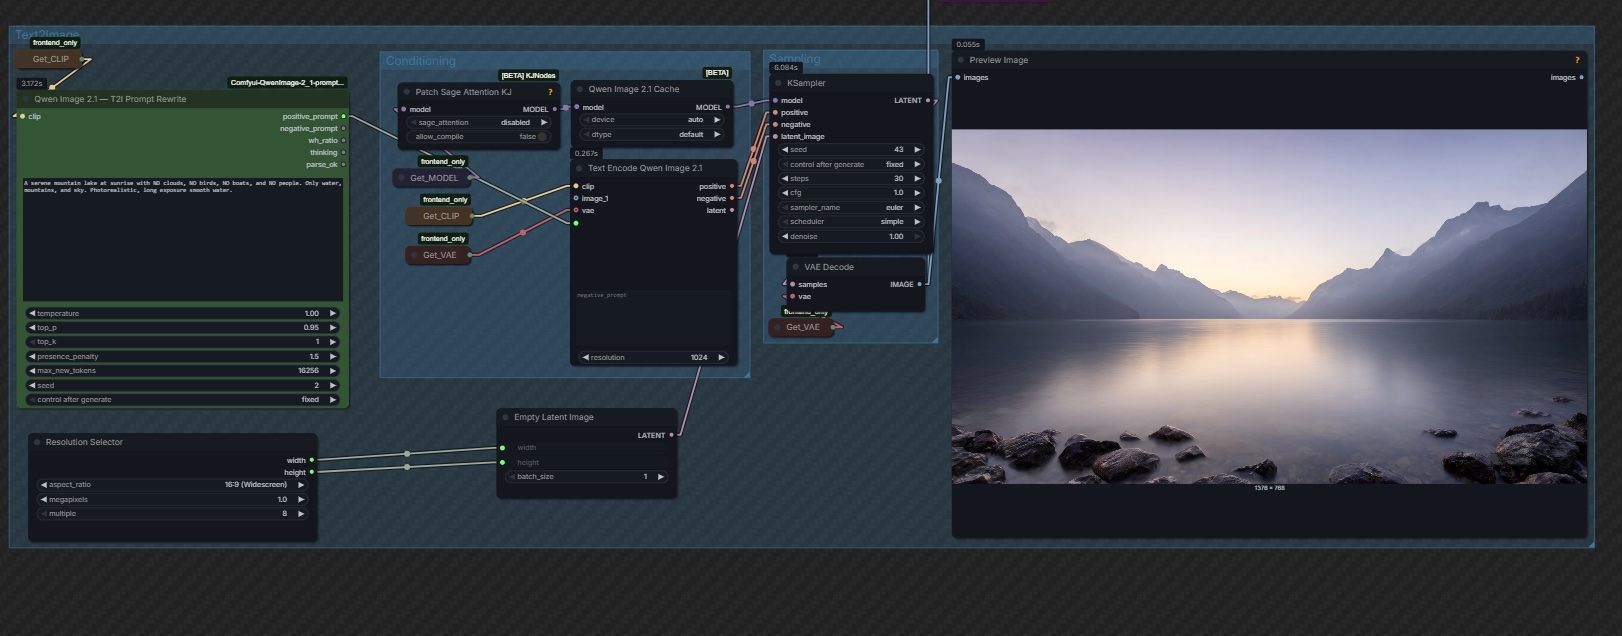
README의 그래프: PE 체크포인트를 로드한 Load CLIP이 재작성 노드에 연결되고, 그 positive_prompt가 Text Encode Qwen Image 2.1로 이어집니다.
텍스트 기반 이미지 생성 실행에서는 재작성된 문자열이 텍스트 인코드 노드에 입력했을 내용을 대체하며, wh_ratio는 직접 고른 너비와 높이 대신 해상도 선택기를 구동할 수 있습니다. 편집 실행에서는 참조 이미지가 노드의 이미지 슬롯에 들어가고, 지침에서 <image1>과 <image2>로 이들을 참조하며, ratio_follow가 출력 캔버스가 어느 입력과 일치해야 하는지 결정합니다.
사용 가능 여부
- PE-T2I: Hugging Face의 Qwen/Qwen-Image-2.1-PE-T2I
- PE-I2I: Hugging Face의 Qwen/Qwen-Image-2.1-PE-I2I
- ComfyUI에서 바로 쓸 수 있는 사본: Comfy-Org/Qwen-Image-2.1의
text_encoders/아래, int8 convrot - 노드 팩: benjiyaya/ComfyUI-Qwen-Image-2.1-Prompt-Enhancer,
ComfyUI/custom_nodes/에 클론 - 공식 재작성 코드: Qwen-Image 2.1 저장소의
prompt_rewrite/, transformers, vLLM 및 vLLM 서버 진입점 포함
댓글
GitHub로 로그인하고 토론에 참여하세요.