Zen Image Edit: ComfyUI에서 0.8B 인코더로 구동하는 Qwen-Image 2.1
Zen Image Edit은 Qwen3.5-0.8B 텍스트 인코더와 158M fusion 어댑터로 Qwen-Image 2.1을 실행하며, 인코더 용량을 17.5 GB에서 1.7 GB로 줄이고 두 가지 ComfyUI 경로를 제공합니다.
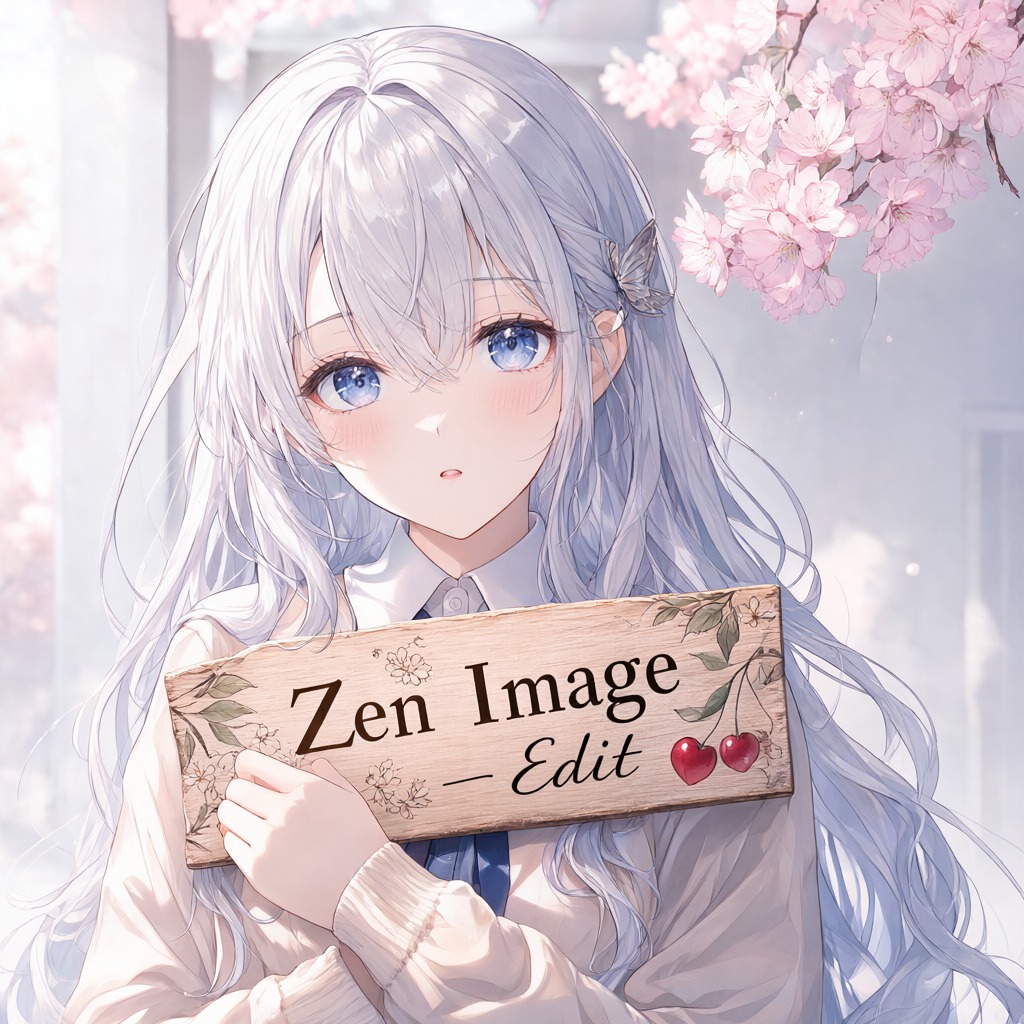
1024 px, 30 스텝의 텍스트 기반 이미지 생성으로, pipeline이 생성했습니다. 출처: AiArtLab/zen-image-edit.
Zen Image Edit이 바꾸는 것
Qwen-Image 2.1의 조건화 스택은 메모리에 상주시키기에 비용이 큰 구조입니다. 베이스 모델의 텍스트 인코더는 fp16 기준 약 17.5 GB의 Qwen3-VL-8B이며, 14.5 GB DiT 옆에 함께 올라가야 합니다. Zen Image Edit은 이를 작은 멀티모달 인코더와, 대형 인코더가 만들어낸 출력을 모방하는 어댑터로 대체합니다. 순수 텍스트에서도, 참조 이미지와 함께 읽은 텍스트에서도 마찬가지입니다.
| 구성 요소 | Zen Image Edit |
|---|---|
| Transformer | Qwen-Image 2.1 DiT, 32 레이어, 14.5 GB fp16, 158M text-fusion 어댑터가 병합됨 |
| 텍스트 인코더 | Qwen3.5-0.8B, 1.7 GB fp16, tokenizer와 processor는 변경 없음 |
| 조건화 충실도 | 네이티브 Qwen3-VL-8B 인코더 대비 텍스트에서 코사인 0.95, 편집 프롬프트의 비전 위치에서 0.97 |
| VAE | 파인튜닝된 Qwen-Image 2.1 디코더, 16x 공간, fp32 |
| scheduler | FlowMatchEulerDiscreteScheduler, 고정 shift 5.0 |
| 최대 VRAM | 약 17.5 GB 상주, enable_model_cpu_offload() 사용 시 더 적음 |
어댑터는 DiT 내부에 text-fusion 블록으로 들어가므로, 전체 모델이 하나의 자체 완결형 Diffusers 폴더가 되고 어디에도 별도의 17.5 GB 인코더가 필요하지 않습니다. 샘플러는 베이스 모델의 동적 shift 대신 단순한 고정 shift 5.0을 사용합니다.
기본 포함된 어댑터는 revision v12입니다. 어텐션 브랜치 위치 테이블이 2,304개 슬롯을 커버하며 실제 1024 px 편집 지오메트리에서 파인튜닝되었기 때문에, 긴 참조 시퀀스가 0으로 패딩된 꼬리로 밀려나지 않고 위치를 유지합니다. 이로써 네이티브 인코더 대비 비전 코사인은 0.93에서 0.97로 올라갔고, 텍스트는 0.95를 유지했습니다.
파인튜닝된 VAE
기본 포함된 디코더는 순정 Qwen-Image 2.1 디코더가 아닙니다. madebyollin/texture-fix-vae-for-qwen-image-2.1을 기반으로 만든 디코더 전용 파인튜닝으로, nearest-exact 업샘플링이 출력 스트라이드에 고정시키는 2 px 격자를 제거하도록 학습되었습니다. 디코더만 5,300 스텝에 걸쳐 학습했으며, 손실 항을 하나 추가했습니다. 재구성과 대상의 2x2 서브래티스 평균 사이의 피크-투-피크 차이입니다. 충실하게 재현된 콘텐츠는 이 항에 0을 기여하므로 추가된 격자만 페널티를 받습니다. 인코더는 원본과 비트 단위로 동일하여 잠재 공간은 변하지 않습니다.
| 디코더 | PSNR | LPIPS | 격자(/255) |
|---|---|---|---|
| 원본 Qwen-Image 2.1 | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| 이 VAE | 33.397 | 0.05291 | 0.000 |
512 px의 홀드아웃 이미지 32장에 대한 재구성. 모델 카드에 따르면 이 격자는 100% 확대에서는 보이지 않으며, 그래서 눈으로 판단하는 대신 수치로 측정했습니다.
예시
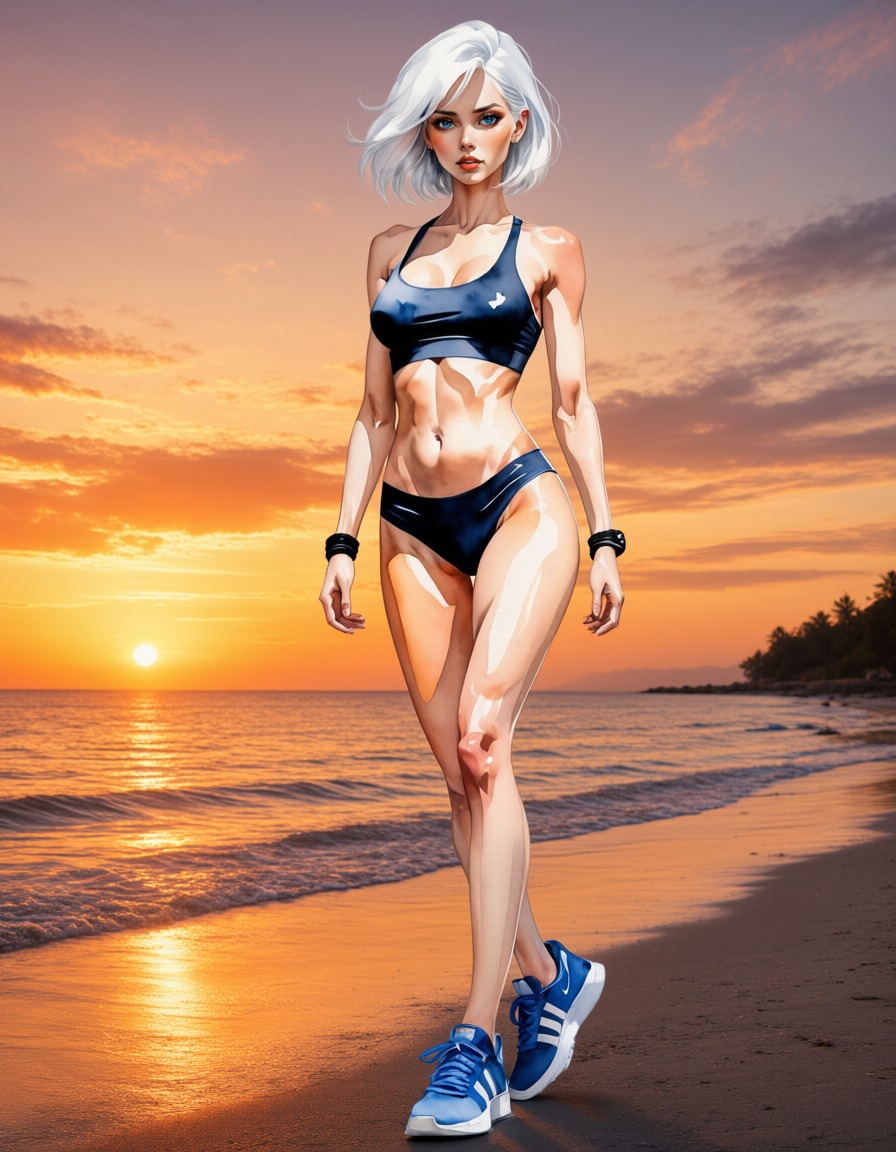
조건 이미지 하나로 편집: 배경은 바뀌고 피사체는 유지됩니다.
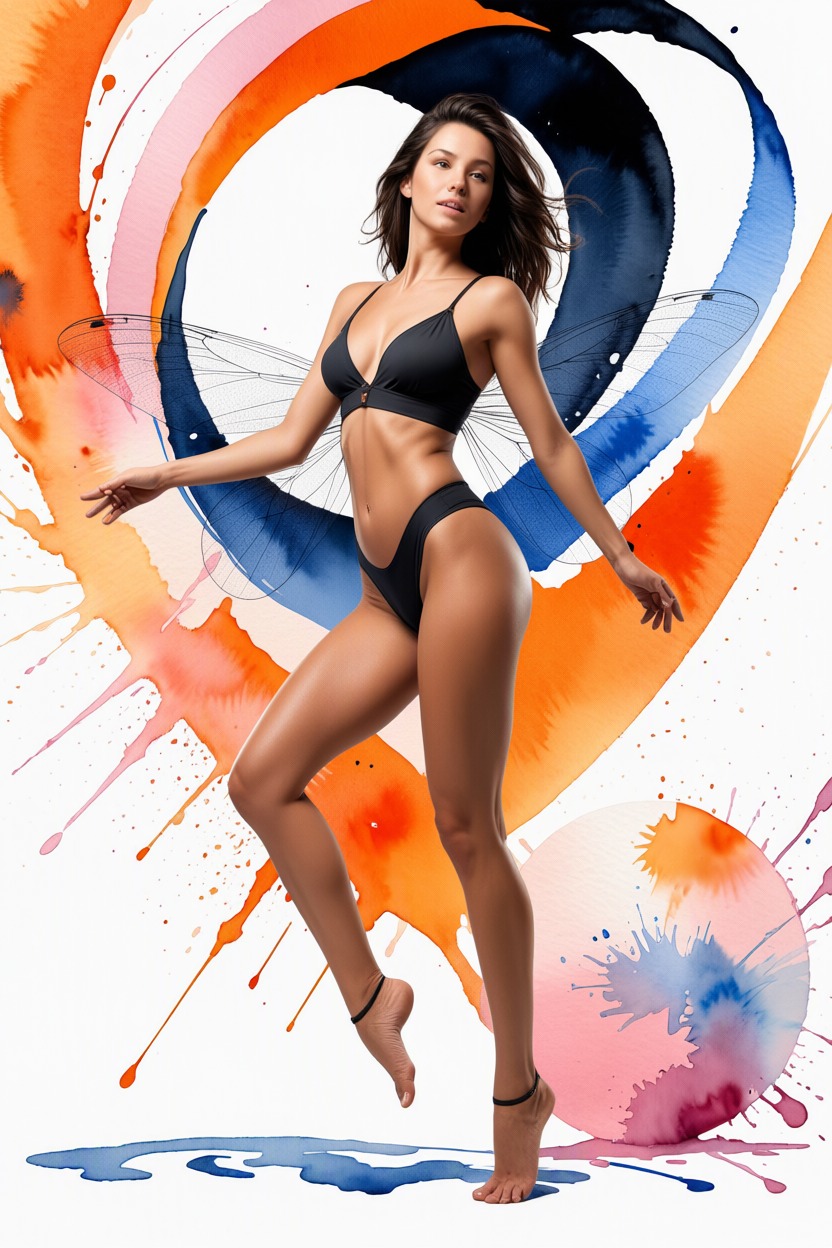 | 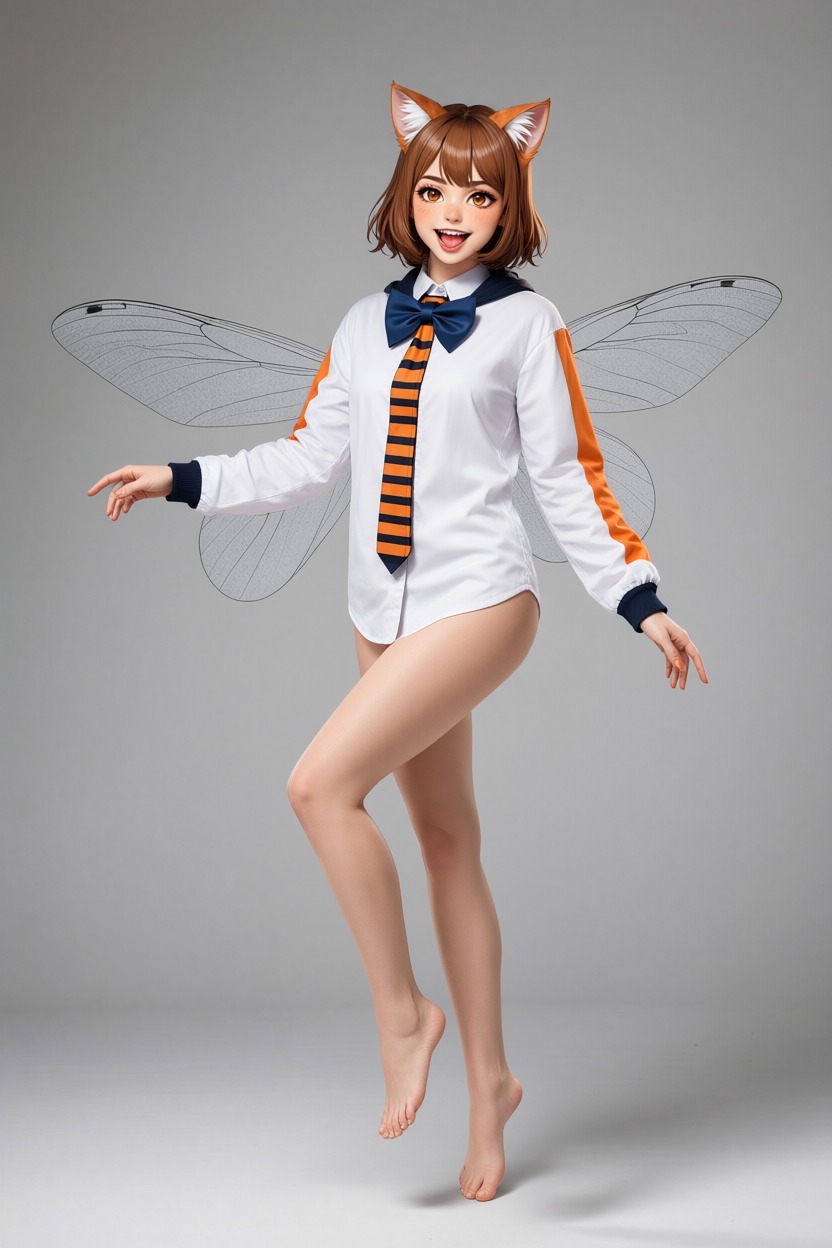 |
|---|---|
조건 이미지 두 장: <image1>은 포즈, 의상, 장면을 유지 | 정체성은 <image2>에서 복사됨 |
편집은 베이스 모델의 관례를 따릅니다. 첫 번째 이미지가 편집 대상(<image1>)이고, 그 뒤에 오는 모든 이미지는 참조입니다. 모델 카드는 참조를 먼저 넣는 것이 스왑이 "일어나지 않는" 흔한 이유라고 지적합니다. 그렇게 하면 모델이 참조 이미지를 대신 편집하기 때문입니다.
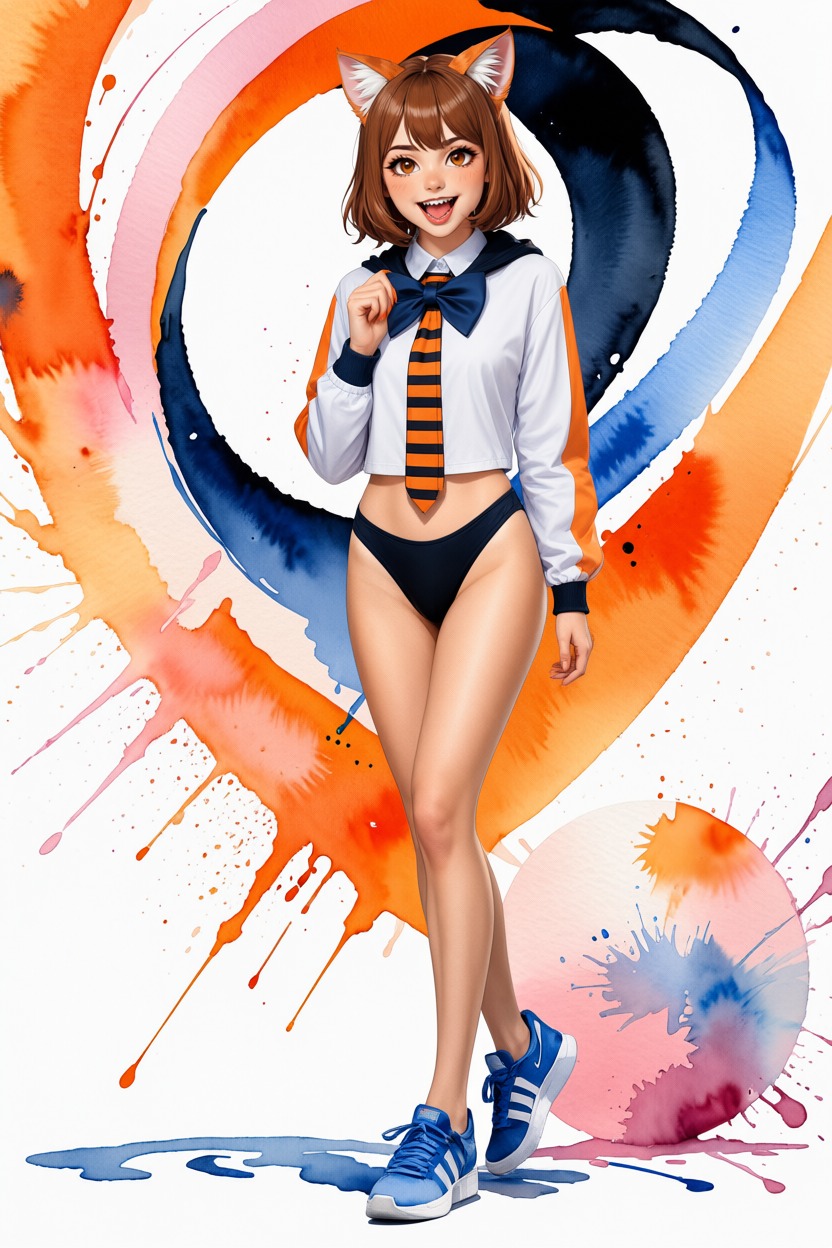
조건 이미지 세 장: 대상과 구도는 <image1>에서, 인물은 <image2>에서, 색상과 조명은 <image3>에서 가져옵니다.
투명(RGBA) 생성도 동일한 pipeline을 통해 실행됩니다.
ComfyUI에서 실행하기
독립적인 ComfyUI 경로가 두 가지 있으며, 어느 쪽도 17.5 GB 인코더가 필요하지 않습니다.
노드 팩: recoilme/zen-image-edit-comfyui. DiT, VAE, 샘플러, prefix KV 캐시는 순정 ComfyUI를 그대로 사용하며(Qwen-Image 2.1을 지원하는 빌드가 필수), 노드는 작은 인코더와 어댑터만 제공합니다:
adapter_v12.safetensors(0.64 GB)를ComfyUI/models/에 다운로드합니다.- Comfy-Org/Qwen-Image-2.1에서 받은
qwen_image_2.1_bf16.safetensors를models/diffusion_models/에,qwen_image_2.1_vae_bf16.safetensors를models/vae/에 넣습니다. - 텍스트 인코더를 내려받습니다:
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b. - ComfyUI를 재시작합니다.
transformers >= 5.17이 필요합니다.
작성자는 동일한 폴더의 Diffusers 빌드와 비교해 코사인 1.0000을 보고했으며, 두 예제 그래프 모두 엔드투엔드로 검증되었습니다.
단일 파일 checkpoint: T8mars/comfyui-Zen-Image-Edit-T8. ComfyUI Manager에서 설치할 수 있는 이 경로는 DiT, VAE, Zen 인코더, fusion 어댑터, tokenizer 에셋을 하나의 zen_image_edit_qwen21_single.safetensors checkpoint로 묶었으며, t8star/Zen-Image-Edit-Comfy로 공개되었습니다. 로더가 MODEL, CLIP, VAE를 반환하므로 별도 다운로드가 필요 없고, CLIP 전용 로더는 네이티브 diffusion 및 VAE 로더와 함께 사용할 수 있습니다. 변환은 24 GB RTX 5090 Laptop에서 ComfyUI 0.37.0으로, 텍스트 기반 이미지 생성과 이미지 편집 그래프 양쪽에서 검증되었습니다. 같은 저장소는 Viggle turbo 어댑터도 ComfyUI 내장 노드에서 로드되는 LoRA로 다시 공개하며, 워크플로도 함께 제공합니다.
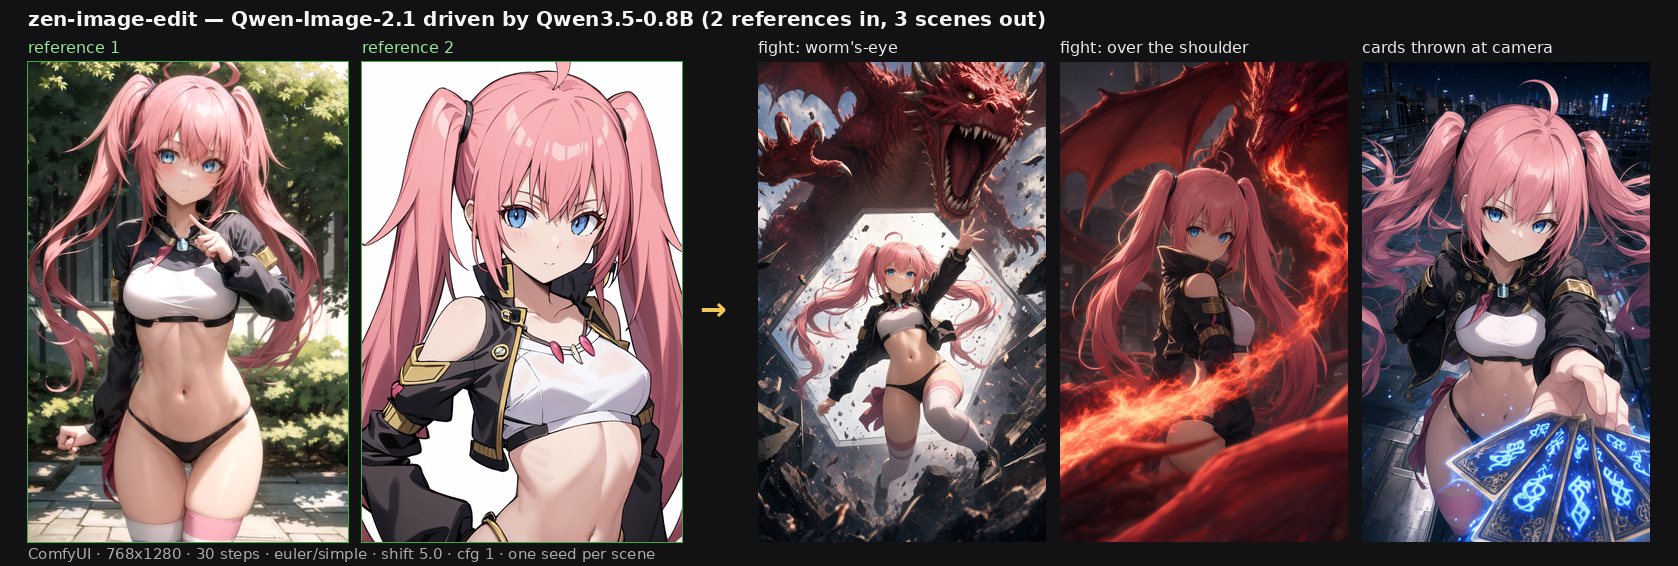
ComfyUI 노드로 768x1280에서 캐릭터 참조 두 장을 입력해 세 장면을 출력했습니다. 출처: recoilme/zen-image-edit-comfyui.
문서화된 한계
모델 카드는 한계를 직접 찾아내야 하는 대신 목록으로 명시합니다:
- 영어만 지원합니다. 어댑터가 학습되고 테스트된 전부이며, 다른 언어는 어긋납니다.
- 간판의 숫자. "OPEN 24 HOURS"는 시도한 모든 시드에서 "OPEN 26 HOURS"로 렌더링됩니다. 단어는 정상입니다.
- 비사진 참조는 사진 참조보다 전사 충실도가 낮습니다. 어댑터가 네이티브 인코더를 모방하며 그 한계를 그대로 물려받기 때문입니다.
- 1024 px에서 배치 크기가 1을 넘으면 최대 약 28 GB에 달하므로, 호출당 프롬프트 하나가 안전한 방식입니다.
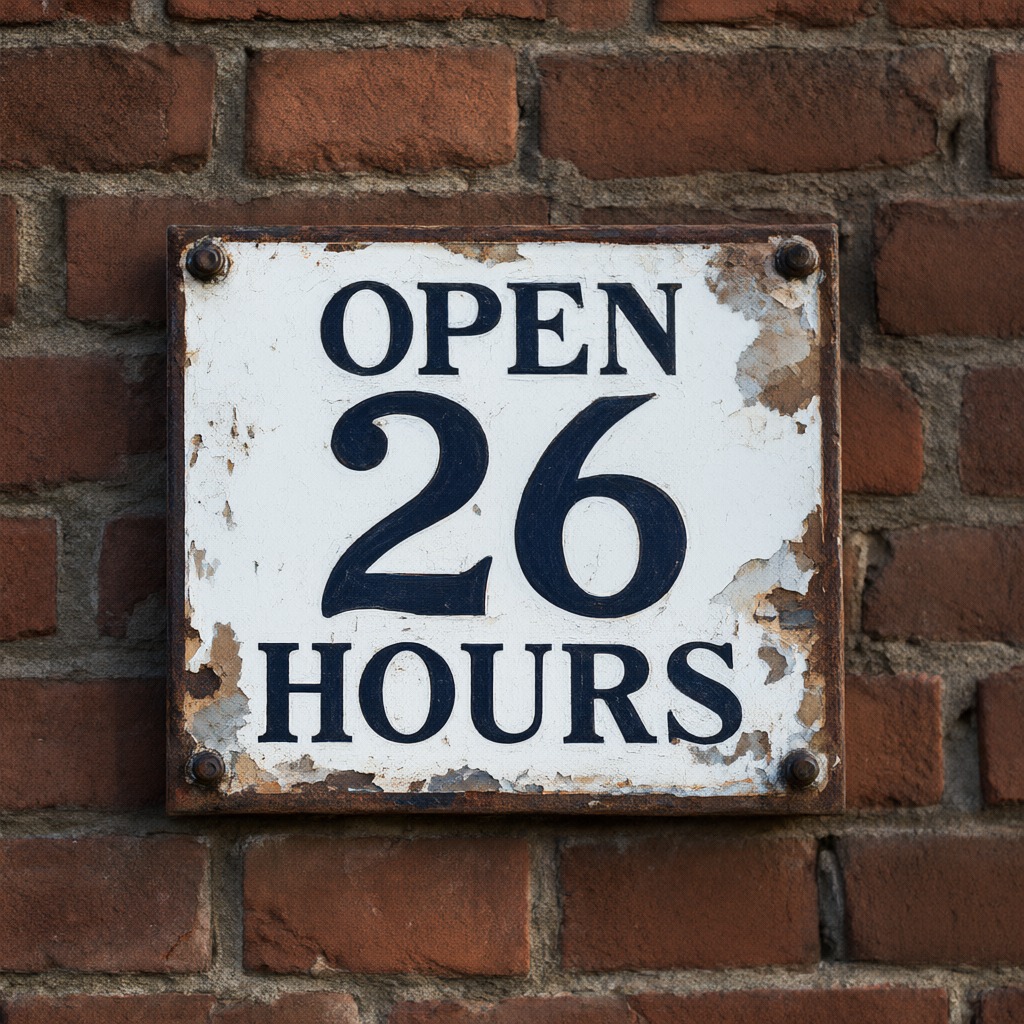
단어는 올바르게 렌더링되지만 간판의 숫자는 그렇지 않습니다. 출처: AiArtLab/zen-image-edit.
다운로드 및 사용 가능 여부
가중치는 AiArtLab/zen-image-edit로 공개되었습니다. 16 GB 카드를 위해서는 recoilme/zen-image-edit-gguf에 GGUF Q5_K 빌드가 있으며, 실행 중 transformer를 13.55 GiB에서 4.52 GiB로 줄입니다. Diffusers pipeline을 실행하려면 Qwen-Image-2.1을 지원하도록 빌드된 diffusers와 trust_remote_code=True가 필요합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.