Qwen-Image 2.1: ComfyUI의 7B 텍스트 기반 이미지 생성 및 편집 모델
Qwen-Image 2.1은 네이티브 RGBA 투명도, 최대 10개의 참조 이미지 편집, 공식 템플릿과 함께 제공되는 Day-0 ComfyUI 지원을 갖춘 Alibaba의 7B 오픈 웨이트 이미지 모델입니다.
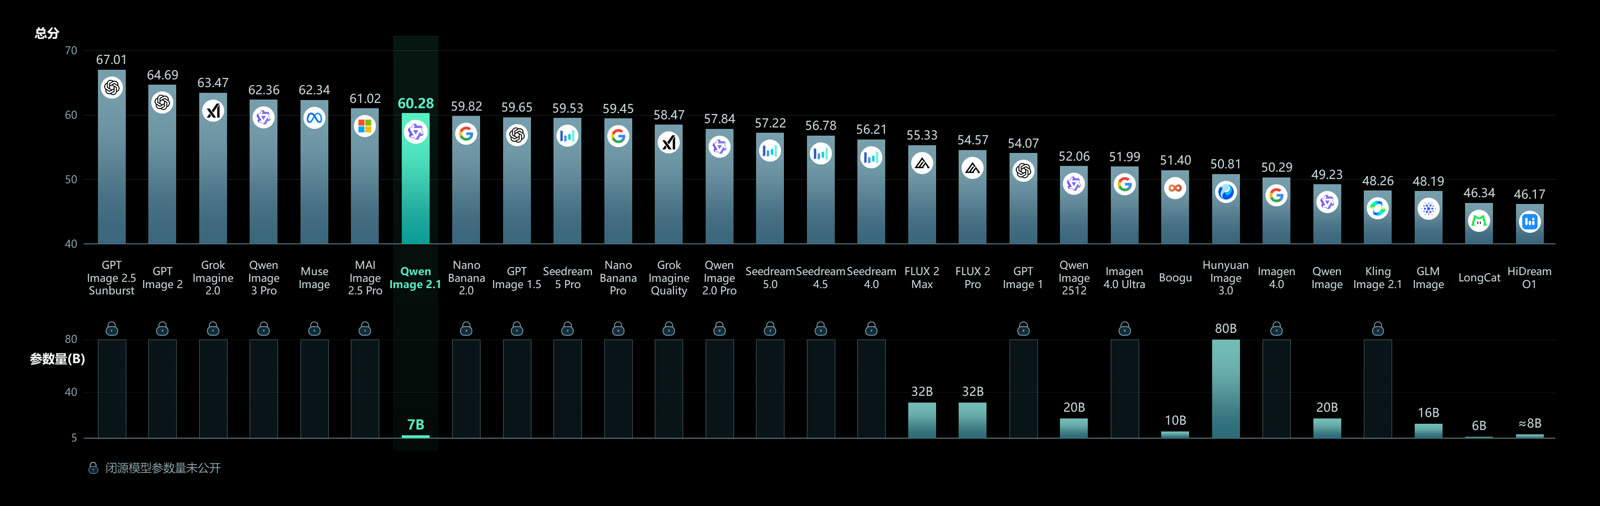
공식 Qwen-Image 2.1 모델 카드의 예시입니다.
Qwen-Image 2.1의 새로운 점
이전 Qwen-Image 생성은 Qwen2.5-VL-7B 텍스트 인코더와 함께 20B MMDiT 백본을 사용했습니다. Qwen-Image 2.1은 시각 생성 부분을 32개의 싱글 스트림 DiT 레이어로 구성된 7B 컴포넌트로 교체했으며, 네 가지 주요 변경 사항은 다음과 같습니다:
- 컴팩트하고 효율적입니다. 혼합 세분성 어텐션과 프리픽스 KV 캐시 재사용 덕분에 20B 라인보다 훨씬 낮은 컴퓨팅 비용으로 높은 품질을 유지합니다.
- 네이티브 투명도, 통합 생성 및 편집. 하나의 모델이 텍스트로 일반 또는 투명(RGBA) 이미지를 작성하고, 투명 레이어를 편집하며, 사진에서 피사체를 추출합니다.
- 다재다능한 편집. 요청당 최대 10개의 참조 이미지, 원, 페인팅 주석 또는 별도 마스크로 지정하는 로컬 편집, 그리고 사람과 제품의 아이덴티티 보존을 지원합니다.
- 사실적인 텍스처와 세련된 미학. 향상된 타이포그래피, 인물 조명 및 세부 묘사.
네이티브 출력 크기는 이전 워크플로에서 사용하던 1024급 정사각형보다 넓습니다: 1:1은 2048x2048, 4:3은 2400x1792, 3:2는 2528x1696, 16:9는 2752x1536이며, 이에 대응하는 세로 비율도 있습니다.
실제 알파 채널을 사용한 투명 이미지
가장 큰 특징은 파일에 그대로 유지되는 알파입니다. 평면 배경에서 생성한 다음 별도의 매팅 모델로 피사체를 잘라내는 대신, Qwen-Image 2.1은 투명도를 직접 작성하므로 스티커, 제품 렌더 또는 UI 에셋이 합성 준비된 상태로 나옵니다. 모델 카드는 이를 트리거하기 위한 명시적인 프롬프트 형식을 권장합니다:
This is an RGBA image with transparency. <your subject description>.
The image has alpha channel and the background is transparent.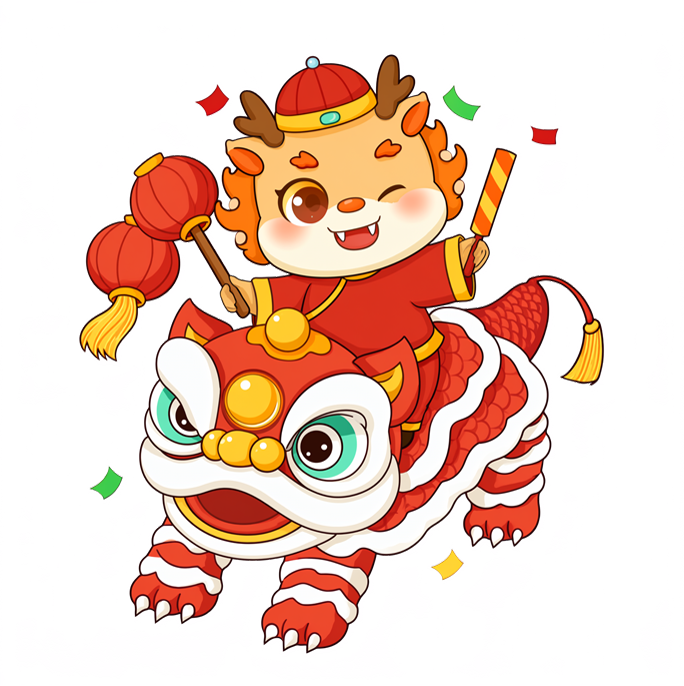
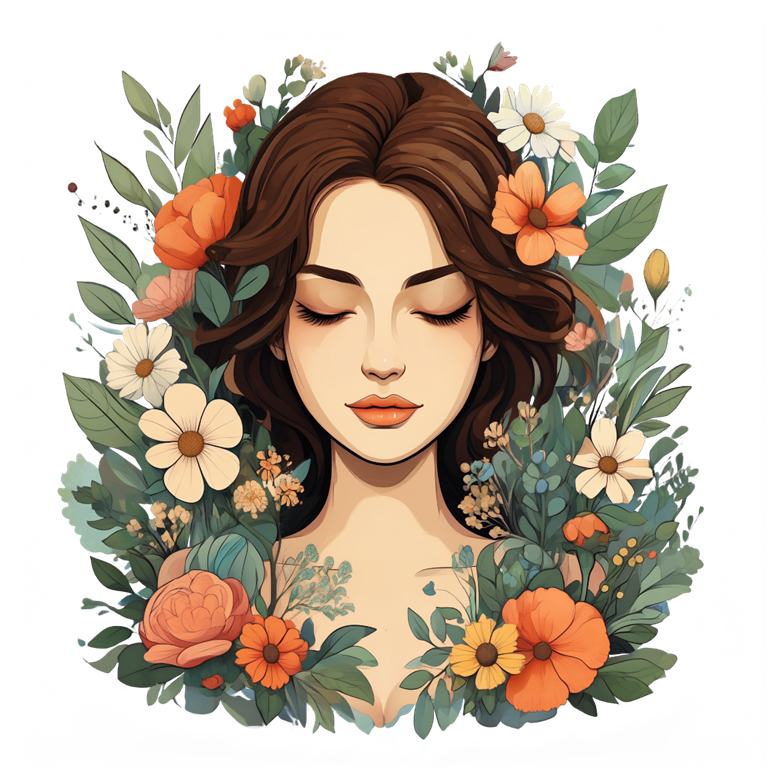
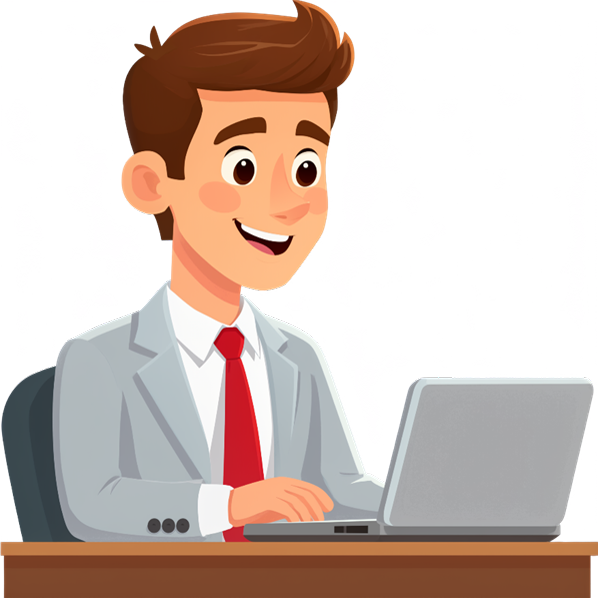
공식 쇼케이스에서 바로 가져온 네이티브 투명 이미지 생성입니다. 파일에는 페인팅된 체커보드가 아닌 알파 채널이 포함됩니다.
최대 10개의 참조로 편집
편집은 참조 예산이 중요한 부분입니다. Qwen-Image 2.1은 한 번에 최대 10개의 이미지를 받아들이므로 별도의 생성을 이어 붙이지 않고도 그룹 구도, 다중 제품 장면 및 캐릭터 시트를 만들 수 있습니다. 로컬 편집은 원, 페인팅 주석 또는 마스크 노드로 지정할 수 있습니다.
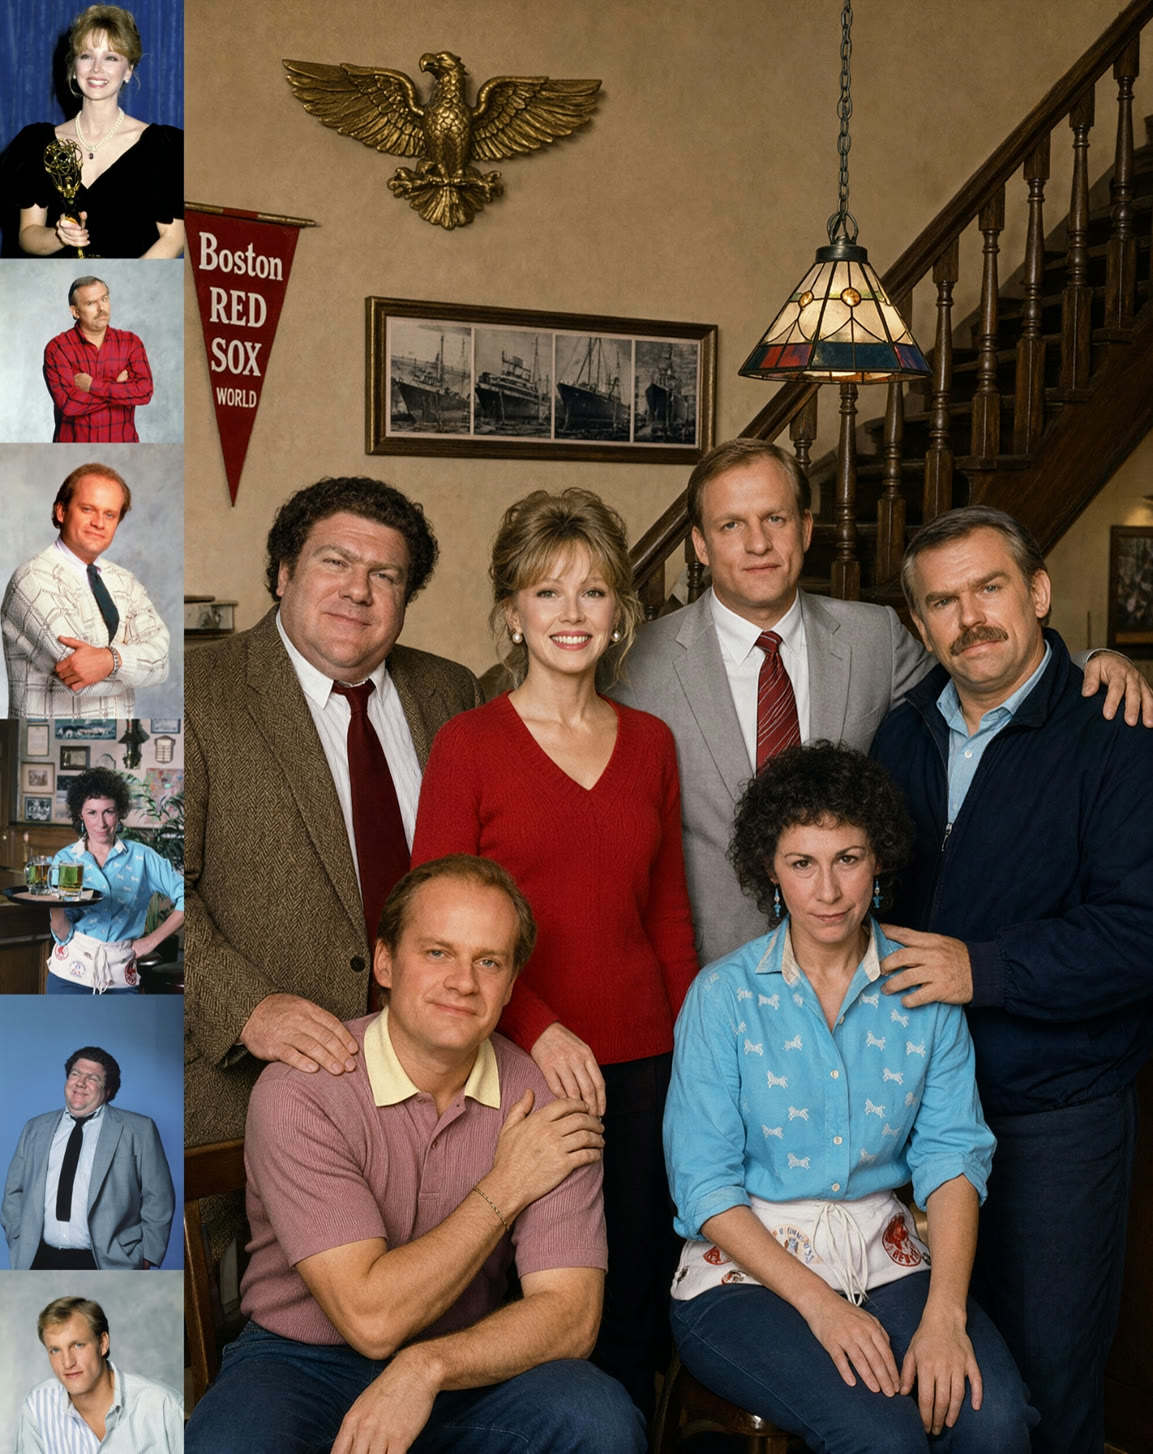
6개의 인물 참조에서 생성된 하나의 그룹 사진입니다.
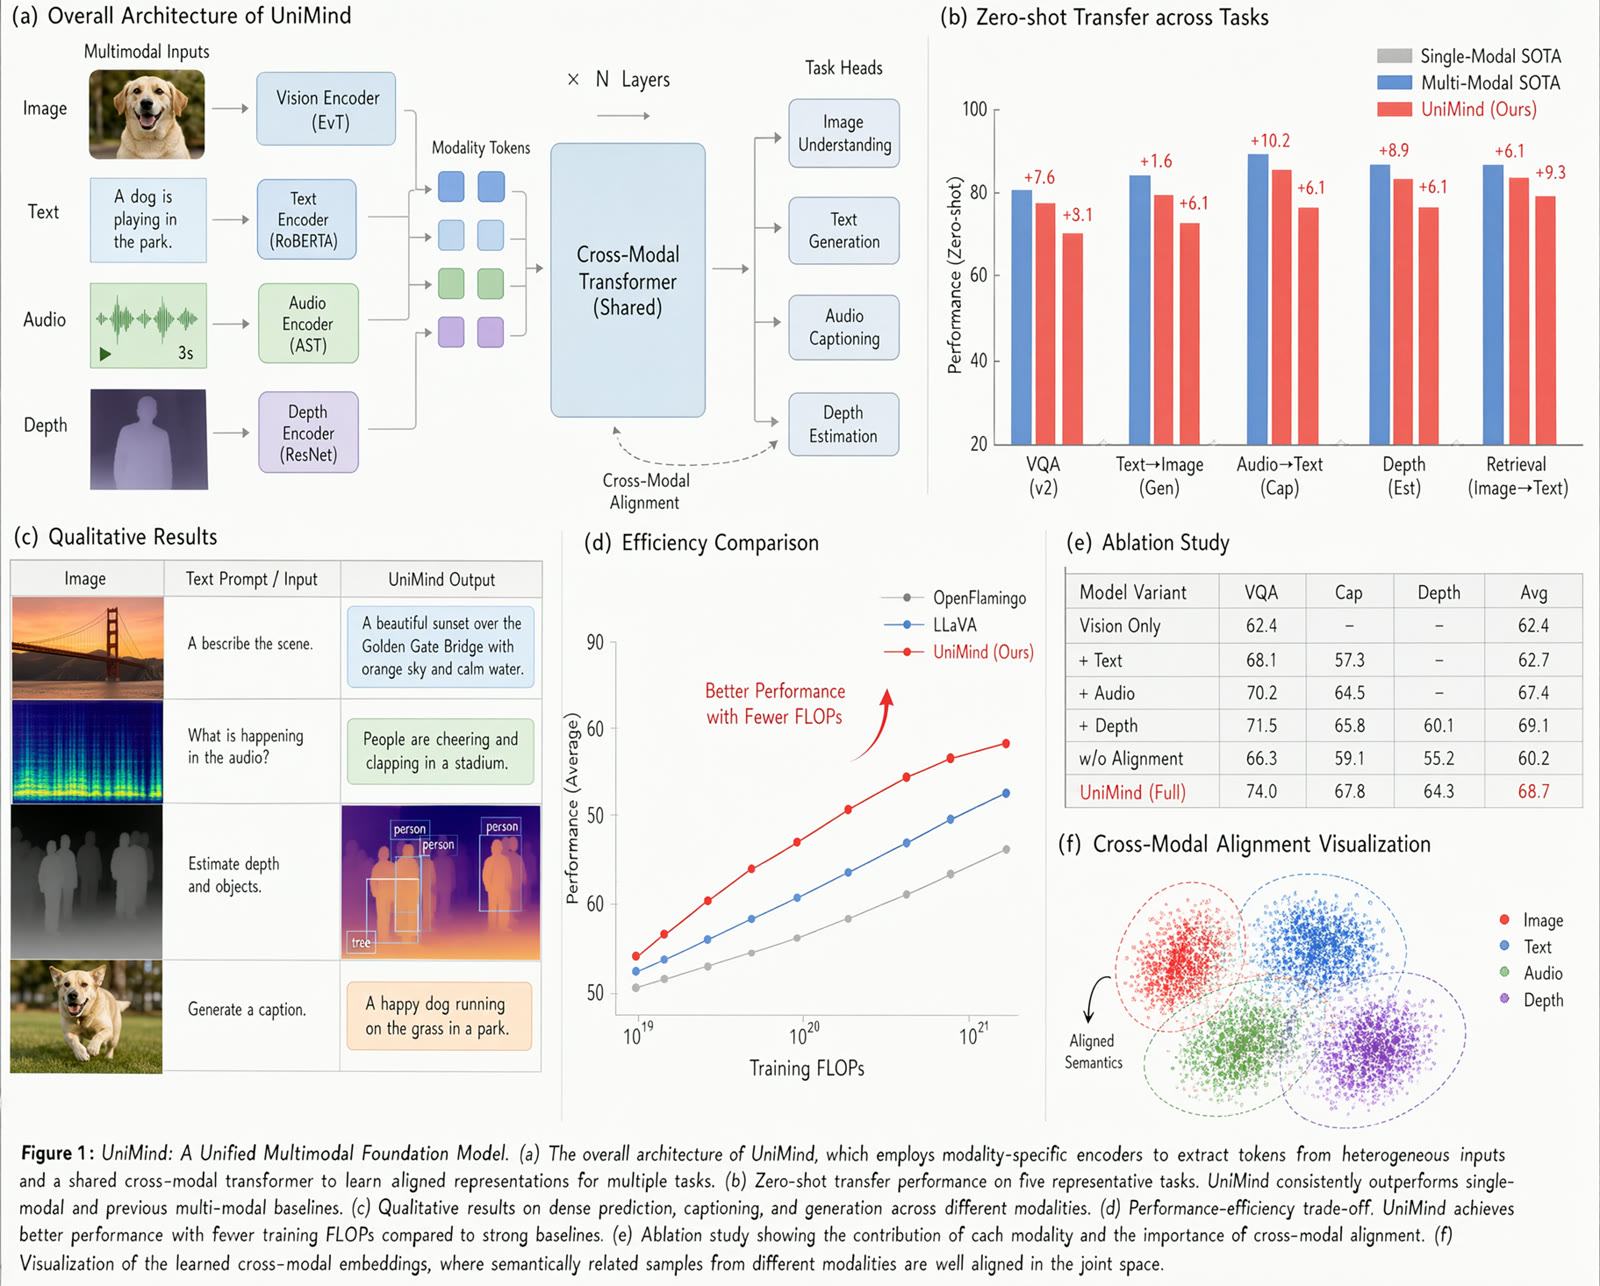
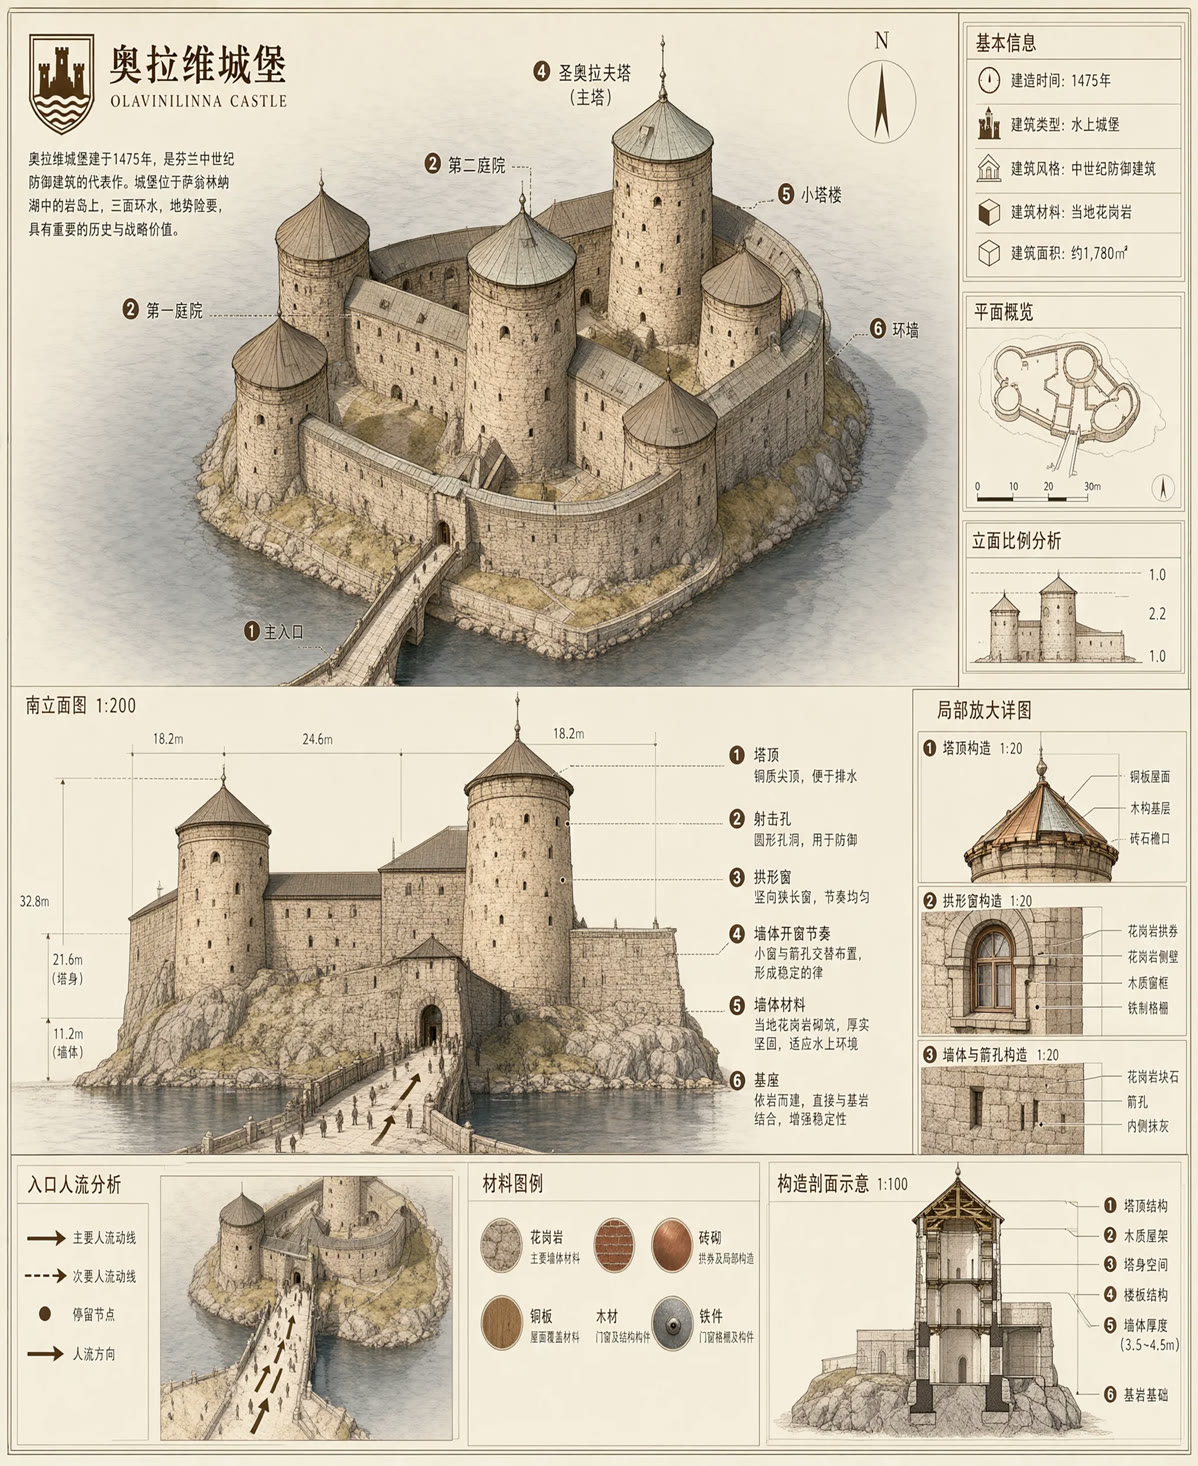
모델 카드의 타이포그래피 및 레이아웃 예시입니다.
Day-0 ComfyUI 지원
ComfyUI는 Comfy-Org/ComfyUI #16400(CORE-423, Kijai 작성)에서 Qwen-Image 2.1 지원을 병합했으며, 아래 세 가지 공식 템플릿은 ComfyUI 0.37.0 이상이 필요합니다. 이후 커밋에서 transformer 블록 컴파일과 모델의 개선된 KV 캐시 배치가 추가되었습니다.
재패키징된 단일 파일 가중치는 Comfy-Org/Qwen-Image-2.1에 있으며, 템플릿은 내장 워크플로 갤러리의 일부이므로 JSON을 드래그하는 대신 템플릿 브라우저에서 열 수도 있습니다.
| 템플릿 | 기능 |
|---|---|
| 텍스트에서 이미지로 | 25 샘플링 단계에 걸쳐 1024x1024 이미지 하나, 네이티브 2K 출력, 타이포그래피 및 알파 지원 |
| 이미지 편집 | 단일 생성 및 편집 체크포인트를 통한 두 개의 참조 이미지, 일관된 캐릭터 편집 및 제품 컷아웃에 유용 |
| 배경 제거 | 모델의 네이티브 RGBA 출력을 사용하여 입력 이미지 하나가 투명한 결과 하나로 출력 |
모델 파일
Comfy-Org 재패키지는 일반적인 폴더로 나뉩니다:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── 📂 text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   └── qwen3vl_8b_w4a8.safetensors
    └── 📂 vae/
        └── qwen_image_2.1_vae_bf16.safetensors
이 외에도 재패키지에는 INT8 convrot 형태의 prompt enhancer 텍스트 인코더인 qwen3.5_9b_qwen_image_2.1_pe_t2i와 qwen3.5_9b_qwen_image_2.1_pe_i2i가 포함됩니다. 이들은 Qwen이 짧은 요청을 이미지 모델이 선호하는 템플릿 형식으로 확장하도록 미세 조정한 LLM이며, 선택 사항입니다: 모든 유능한 LLM이 동일한 프롬프트 템플릿을 채울 수 있고, 이미지 모델 자체는 없이도 실행됩니다.
초기 사용자들의 보고
이 모델은 출시 당일부터 사용자들의 손에 들어갔으며, 동일한 몇 가지 실용적인 의견이 계속 나오고 있습니다:
- 네이티브 크기가 중요합니다. 2048급 학습 해상도를 훨씬 넘어서면 노출이 불안정해지고, 지나치게 큰 입력 참조는 생성 속도를 급격히 저하시킵니다. 참조를 로딩하기 전에 크기를 조정하는 것이 샘플러가 처리하도록 두는 것보다 저렴합니다.
- CFG가 1 미만이면 사용할 수 없습니다. 가이드가 약 1일 때 이전 Qwen-Image 라인처럼 작동하며, 이미지 속 텍스트가 더 선명해야 할 때 사람들은 품질 중심의 네거티브 프롬프트와 함께 작은 CFG를 사용합니다.
- 스타일 전환은 여전히 성공과 실패가 갈립니다. 텍스트 지시는 스타일을 안정적으로 변경하지만, 참조 이미지를 통해 제공된 스타일은 덜 신뢰할 만하며, 이는 사용자들이 이전 Qwen-Image Editing 모델에서 겪었던 것과 같습니다.
사용 가능 여부
가중치는 Hugging Face와 ModelScope에 있으며, 출시 게시물은 Qwen 블로그에 있습니다. ComfyUI 외의 Day-0 통합으로는 QwenImage21Pipeline을 통한 Diffusers, vLLM-Omni, SGLang 및 LightX2V가 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.