Viggle Turbo v0.2: ComfyUI에서 Qwen-Image 2.1을 5스텝으로 증류하기
Viggle의 Qwen-Image 2.1 DMD 증류 버전 v0.2는 CFG 없이 생성 단계를 5스텝으로 줄였으며, 커뮤니티 ComfyUI 변환본과 함께 rank-256 LoRA로 제공됩니다.
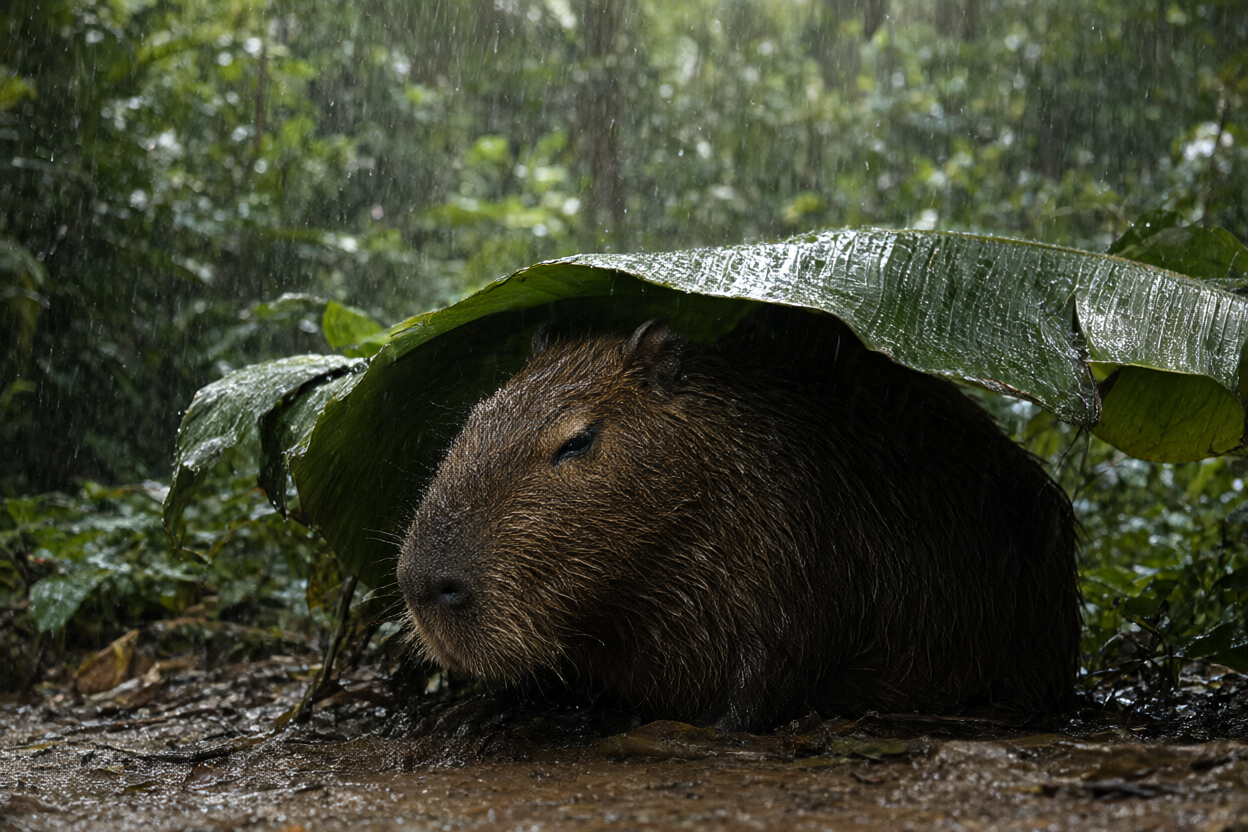
Viggle 자체 데모 Space에서 5스텝으로 생성한 텍스트 기반 이미지 생성 샘플입니다.
v0.2에서 달라진 점
첫 공개 버전인 v0.1은 출력 다양성이 무너지고 구도가 베이스 모델에서 벗어나는 미리보기 버전이었습니다. v0.2는 더 큰 student 모델이며, Viggle은 96개의 사용자 요청으로 구성된 홀드아웃 세트에서 40스텝 베이스 모델과 공식 프롬프트 개선 기능을 조합한 것과 비교해 측정했습니다:
| 지표 | v0.1 LoRA r64 | v0.1 전체 파인튜닝 | v0.2 LoRA r256, 5스텝 |
|---|---|---|---|
| 베이스 모델 대비 샘플 다양성 | 0.75 | 0.72 | 0.93 |
| 베이스 모델 대비 구도 이탈 | -0.019 | -0.033 | +0.000 |
다양성은 8개 시드에 걸친 프롬프트 내 DINOv2 패치 거리의 평균을 베이스 모델 대비 비율로 나타낸 값이고, 이탈은 동일한 프롬프트와 시드에 대해 이미지 중심점이 베이스 모델 출력에서 얼마나 멀어졌는지를 나타냅니다. 실제로 이는 v0.2가 시드 전반에 걸쳐 베이스 모델의 분포를 유지하고 피사체를 베이스 모델이 배치할 위치에 놓는다는 뜻이며, v0.1은 모든 시드를 비슷한 레이아웃으로 몰아넣었습니다. v0.1 결과물은 재현성을 위해 저장소에 남아 있지만, Viggle은 그것들을 선호할 이유가 없다고 밝혔습니다.
실행 방식
증류된 student 모델은 스텝 수가 아니라 고정된 스케줄로 샘플링됩니다: 시그마 노드 [1.0, 0.875, 0.75, 0.5, 0.25]를 사용하는 5스텝, true_cfg_scale=1.0, 네거티브 프롬프트 없음. 이는 4스텝 학습 노드에서 노이즈가 가장 많은 구간을 둘로 나눈 것으로, Viggle은 이 방식이 일반적인 4스텝 롤아웃의 디테일 손실과 고스팅을 대부분 제거한다는 것을 확인했습니다. 다른 스텝 수나 CFG 값은 도움이 되지 않습니다.
연결해서 사용할 때 중요한 세부 정보가 두 가지 더 있습니다:
- 제공된 scheduler config를 사용하거나
shift_terminal=None으로 설정하세요. 베이스 모델의shift_terminal: 0.02는 마지막 스텝을 망가뜨립니다. - 제공된 어댑터에서 알파가 rank와 같으므로 LoRA 크기 조절은 1.0으로 유지하세요.
텍스트 기반 이미지 생성은 1024와 2048 영역에서, 편집은 1024와 1536 영역에서 학습되었으며, 편집은 최대 3개의 참조 이미지를 받을 수 있고 그 순서에 따라 프롬프트 내에서 <image1>, <image2>, <image3>가 가리키는 이미지가 결정됩니다.
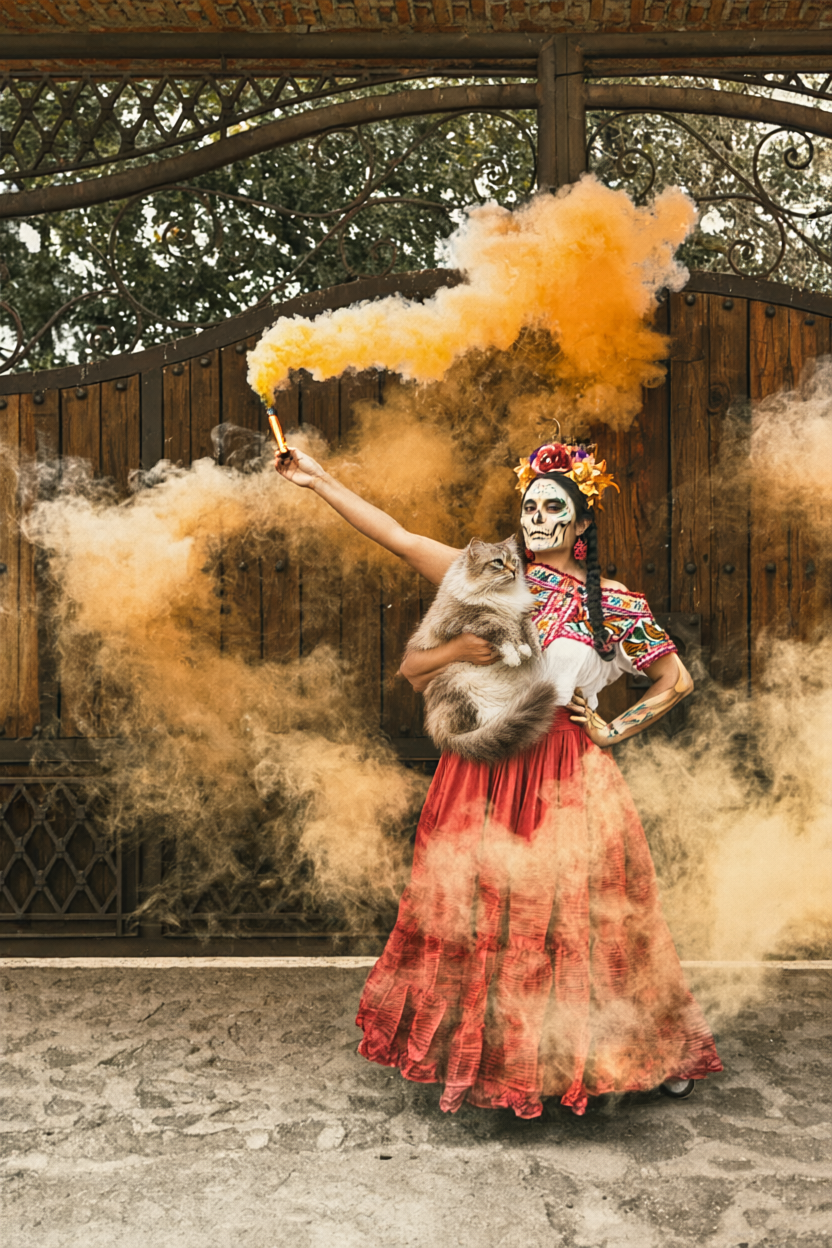
5스텝으로 수행한 832x1248 크기의 참조 이미지 2장 편집입니다. 프롬프트: "The woman from image 1 is holding the cat from image 2 in her arms, keep the background of image 1".
ComfyUI 사용 가능 여부
공식 릴리스는 diffusers 키 형식과 별도의 peft_v0.2 어댑터로 제공되며, ComfyUI가 직접 로드하는 단일 파일 kohya 형식이 아니므로 아직 공식 ComfyUI 워크플로가 없습니다. 커뮤니티는 v0.1이 나온 지 하루 만에 그 공백을 메웠습니다:
t8star/Qwen-Image-2.1-viggle-turbo-4step-r64-comfy는 v0.1 r64 어댑터를 ComfyUI에서 로드할 수 있는 LoRA로 변환합니다.- 4스텝 계열의 양자화 빌드도 GGUF 저장소로 존재하며(Abiray, realrebelai), 다른 Qwen-Image 2.1 양자화와 마찬가지로 저 VRAM 환경을 대상으로 합니다.
베이스 Qwen-Image-2.1 transformer, text encoder, VAE, processor는 증류 모델과 함께 재배포되지 않으므로, 이들은 여전히 베이스 모델에서 가져와야 하며 ComfyUI는 이미 이를 기본 지원합니다.
아직 하지 못하는 것
Viggle은 v0.2가 여전히 미리보기라는 점을 분명히 밝혔습니다. 텍스트 기반 이미지 생성은 베이스 모델에 근접하지만, 복잡한 편집은 여전히 뒤처집니다: 다중 참조 구도, 얼굴 교체, 신분증 편집은 인물이 중복되거나 고스팅될 수 있고, "모든 것을 그대로 유지" 요청은 정체성이 달라질 수 있으며, 작거나 긴 렌더링 텍스트는 40스텝 때보다 더 자주 깨집니다. 2K 출력은 teacher 모델과 검증되지 않았고, RGBA 출력, 3개 초과 참조, 마스크 기반 국소 편집은 테스트되지 않았습니다.
이 모델은 이미 ComfyUI 커뮤니티에서 주목받고 있으며, 이번 릴리스는 Banodoco #qwen-image 채널과 r/StableDiffusion에서 회자되고 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.