Supra2-IMG: 10시간 만에 학습된 100M 텍스트 기반 이미지 생성 모델
SupraLabs가 H100 한 대에서 10시간 만에 처음부터 학습한 105M 파라미터 DiT 텍스트 기반 이미지 생성 모델 Supra2-IMG를 공개했습니다. 샘플 해상도는 256x256입니다.
모델 저장소에 공개된 공식 Supra2-IMG 배너.
무엇인가
Supra2-IMG는 아주 작은 DiT입니다. 104.1M 파라미터로 128개 토큰의 Flan-T5 조건화로부터 256x256 이미지를 생성합니다. 텍스트 조건화는 동결된 Flan-T5-Base 인코더에서 나오고, 잠재 데이터는 SD-VAE-FT-MSE로 디코딩됩니다. 따라서 이 두 구성 요소는 checkpoint에 포함되지 않고 각자의 저장소에서 가져옵니다.
| 구성 요소 | 값 |
|---|---|
| 파라미터 | 104.1M (D_MODEL 576, depth 14, 9 heads, head dim 64, MLP 비율 4.0) |
| 해상도 | 256x256 (32x32 잠재 데이터, patch size 2) |
| 텍스트 인코더 | Flan-T5-Base, 동결, 128 토큰 컨텍스트 |
| VAE | SD-VAE-FT-MSE |
| Checkpoint | model_final_ema.pt |
SupraLabs는 100M 파라미터 Supra2 언어 모델을 만든 독립 연구소이며, Supra2-IMG는 이미지 생성에 "작게, 처음부터 학습"이라는 같은 접근을 적용한 결과물입니다. 이 모델은 순수 PyTorch 코드와 가중치, 즉 inference.py, config.json, model_final_ema.pt로 공개되었습니다.
학습
학습 규모는 의도적으로 소박하며, 바로 그 점이 이번 공개의 핵심입니다.
- 데이터셋: 전체 LucasFang/FLUX-Reason-6M 데이터셋을 10 에폭 학습했고, 준비 과정을 거쳐 5.6M 이미지를 사용했습니다.
- 캡션 선택: 각 이미지는
caption_composition,caption_entity,caption_text,caption_style,caption_imaginative순서로 가장 먼저 사용 가능한 캡션을 채택하여, 샘플마다 가장 품질이 높은 어노테이션을 유지합니다. - 하드웨어: RunPod의 Nvidia H100 SXM 80GB 한 대, 2.5TB 디스크에서 데이터 준비를 포함해 9시간이 걸렸습니다.
모델 전체가 수백 메가바이트에 들어가기 때문에, 소규모 사전 학습을 연구하거나 8B 규모에서는 비용이 너무 커질 파인튜닝 실험을 할 때 실용적인 기반이 됩니다.
샘플
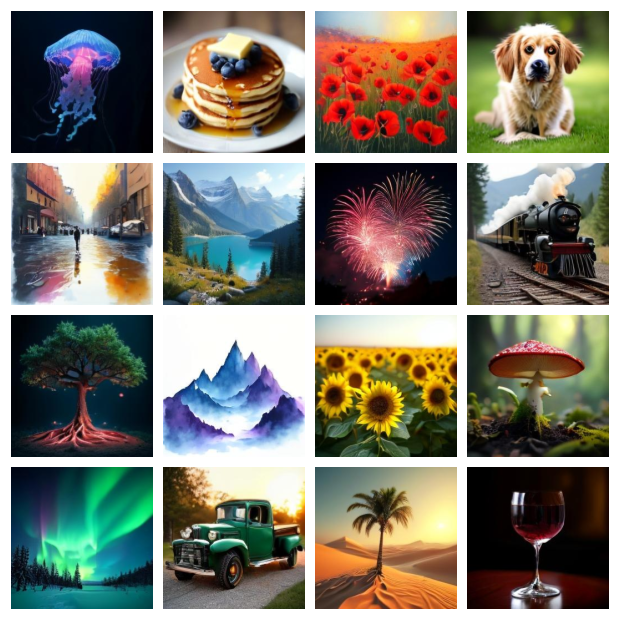
모델 저장소의 공식 샘플로, 선별된 결과가 아니라 모두 권장 설정으로 생성되었습니다.
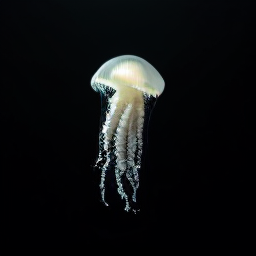
제공된 추론 스크립트로 생성한 256x256 예시 출력.
사용 가능 여부
ComfyUI 지원은 없습니다. Supra2-IMG는 자체 SupraDiT 아키텍처를 사용하는 순수 PyTorch 배포판이라 diffusers pipeline이 아니며, 공개된 ComfyUI 템플릿이나 노드도 없습니다. 실행하려면 함께 제공되는 스크립트와 두 가지 외부 구성 요소가 필요합니다.
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" \
  --seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png
권장 샘플링 설정은 시드 0, CFG 3.0, 50 스텝입니다.
- 가중치와 코드: SupraLabs/Supra2-IMG
- 텍스트 인코더: google/flan-t5-base
- VAE: stabilityai/sd-vae-ft-mse
- 연구소: supra-labs.com
댓글
GitHub로 로그인하고 토론에 참여하세요.