 텍스트→이미지
파인튜닝
Anima-Light-Lavender: 긴 자연어 프롬프트를 위한 Anima 포스트 트레인Anima-Light-Lavender는 512 토큰 자연어 캡션을 읽는 Anima-Base v1.0의 포스트 트레인으로, BF16과 MXFP8 가중치를 제공하며 ComfyUI에 그대로 적용됩니다.
ComfyUI 생태계 소식 — 오픈소스 모델 릴리스, 커스텀 노드, 워크플로, 이미지·비디오·오디오 생성 도구 업데이트.
텍스트→이미지Anima-Light-Lavender는 512 토큰 자연어 캡션을 읽는 Anima-Base v1.0의 포스트 트레인으로, BF16과 MXFP8 가중치를 제공하며 ComfyUI에 그대로 적용됩니다.
 텍스트→이미지
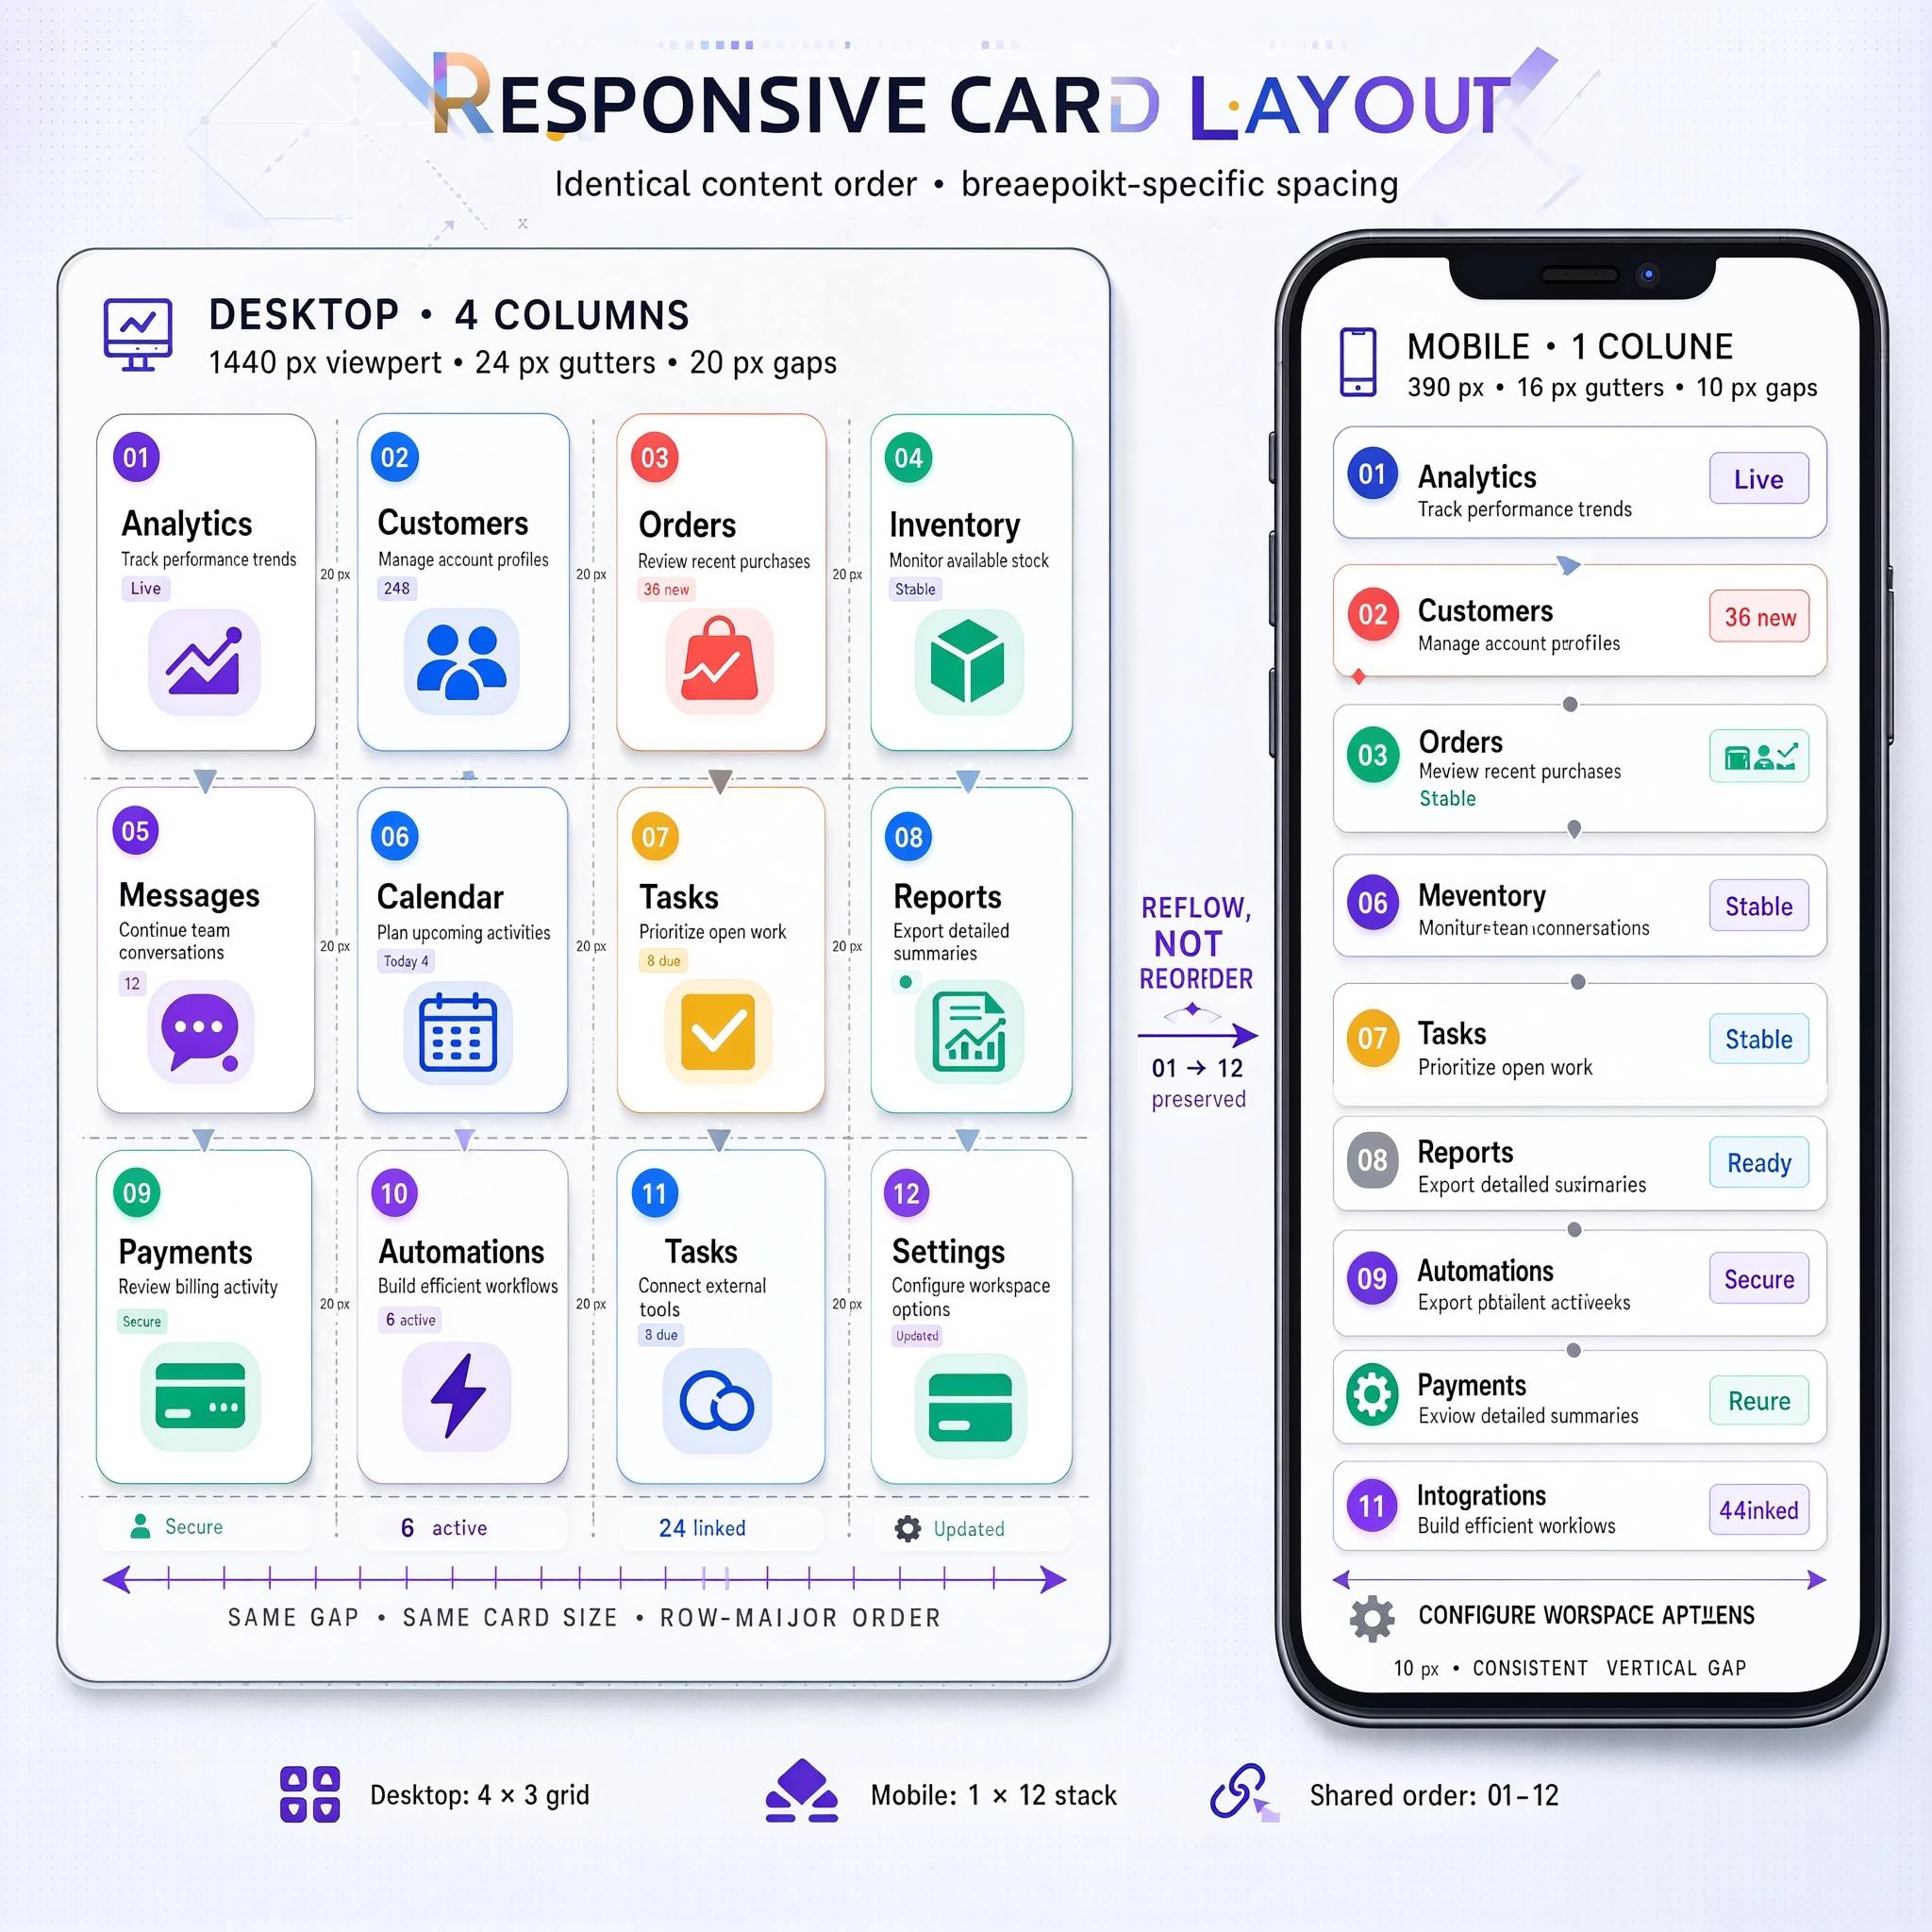
Ming-Image 0.1 Design은 UI, 인포그래픽, 텍스트가 많은 포스터를 위한 inclusionAI의 6B 텍스트 기반 이미지 생성 모델로, RGBA 투명도와 공식 ComfyUI 지원을 제공합니다.
MIT
 텍스트→비디오
Video Rebirth의 HyperFlow는 데이터 프리 자기 증류 LoRA로 MiniMax H3 샘플링을 49회 트랜스포머 포워드에서 8회로 줄입니다. 출시 직후 두 개의 ComfyUI 포팅이 이어졌습니다.
minimax-h3-community-license-agreement
 이미지→비디오
XGEN Labs의 JING-Flash-v1은 MiniMax H3 기반으로 1인칭 비디오와 오디오를 생성합니다: 키보드 카메라 제어, 텍스트 기반 상호작용, 대화, 4단계 추론.
minimax-h3-community-license-agreement
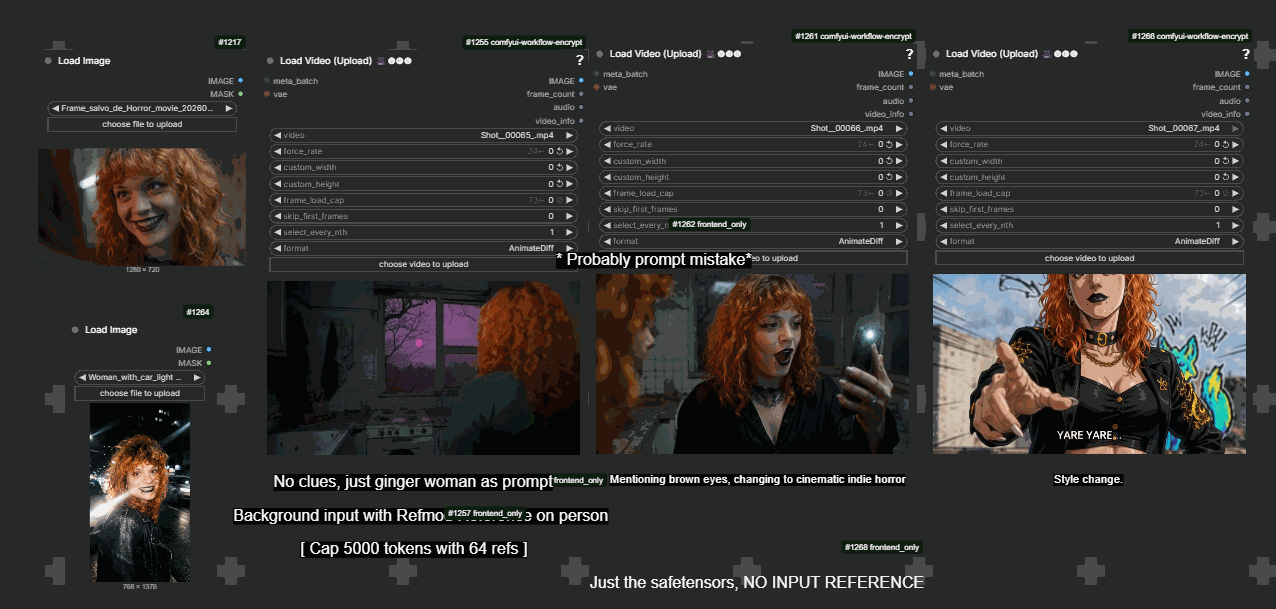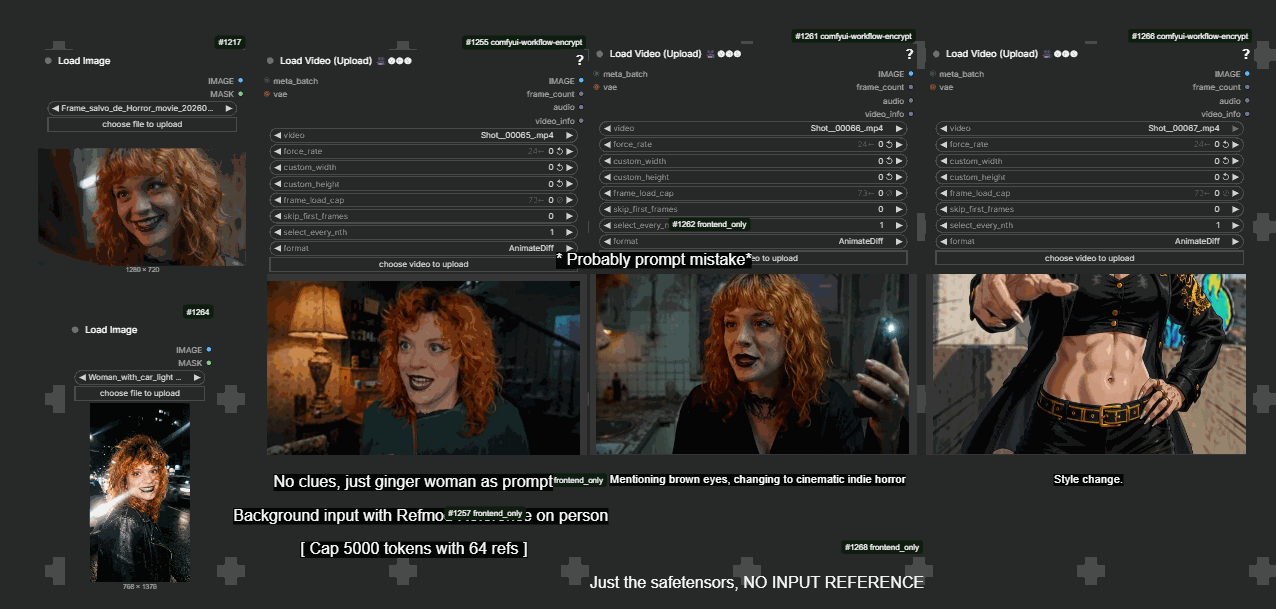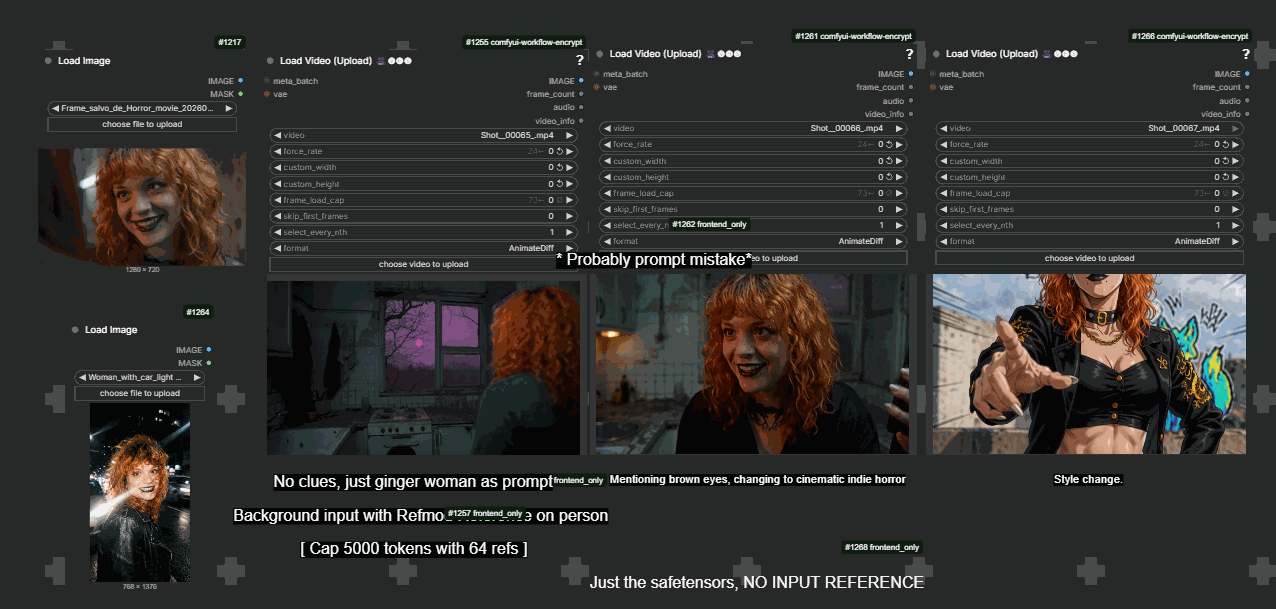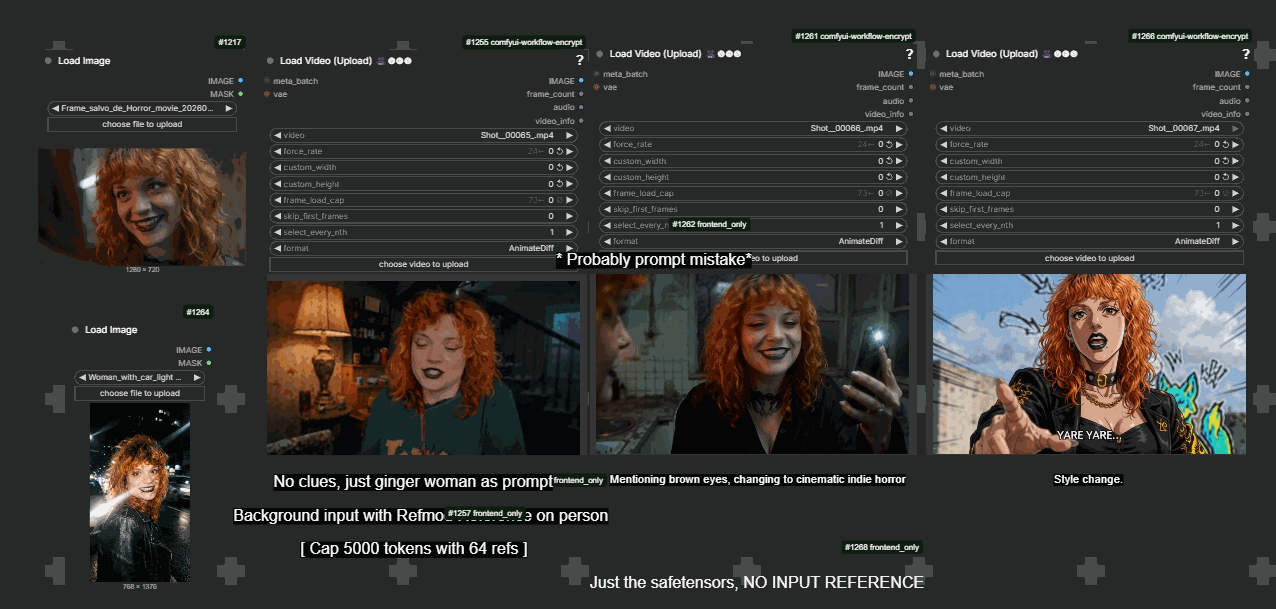 이미지→비디오
Fizgig v6.0은 MiniMax H3용 RefMod를 만듭니다. 참조 사진을 작은 파일 하나로 묶고, 모델 자체에 맞춰 튜닝하며, ComfyUI를 열기 전에 RefMod Studio에서 미리 확인할 수 있습니다.
 생태계
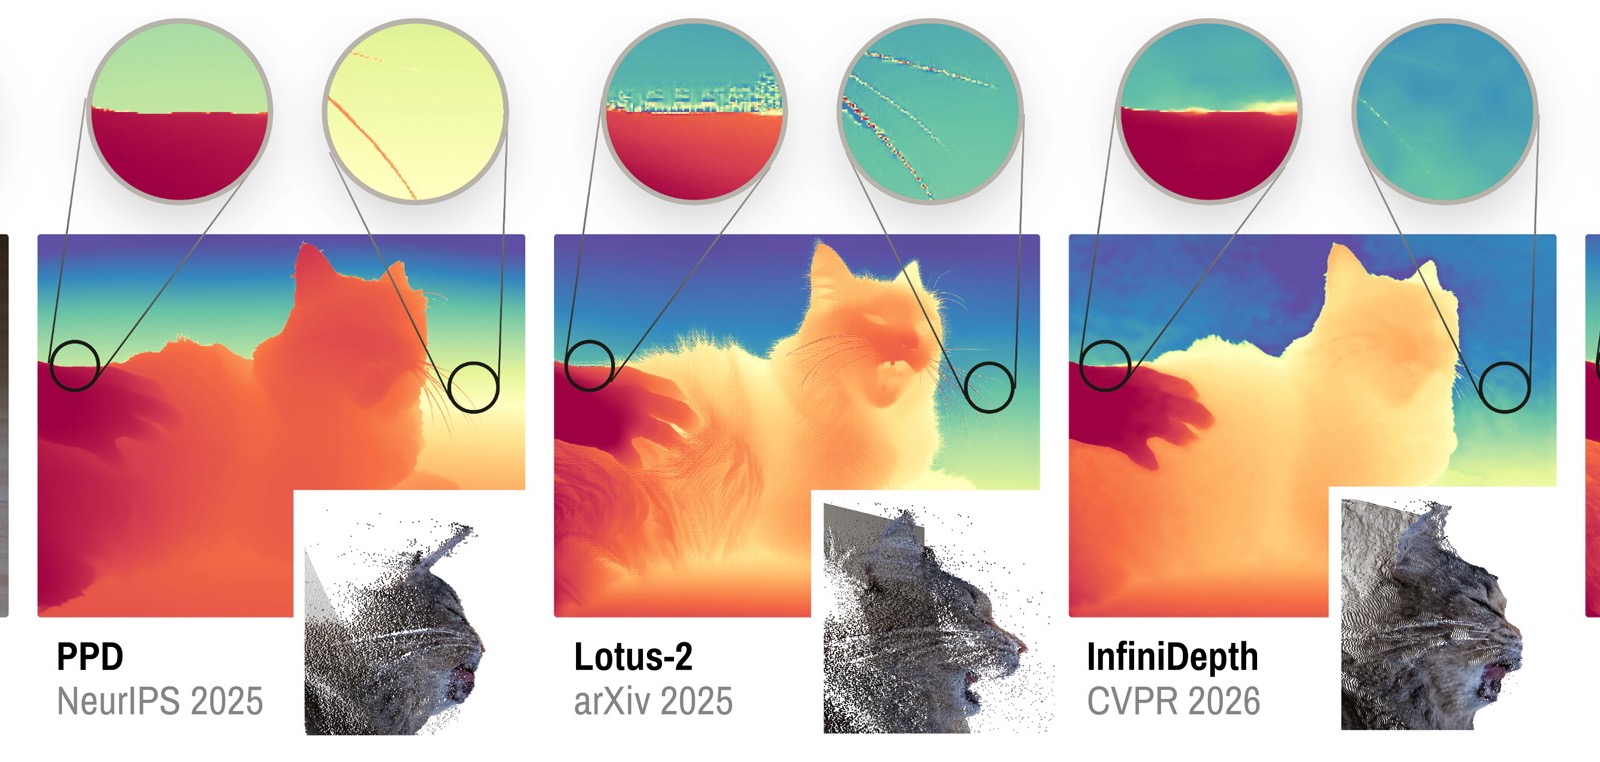
ComfyUI v0.36.0은 세 가지 공식 워크플로와 함께 네이티브 Marigold V2 깊이, 노멀, 알베도 추정을 추가하고, 비디오 연결 노드, FastH3, YuE2 및 새로운 파트너 노드를 제공합니다.
 생태계
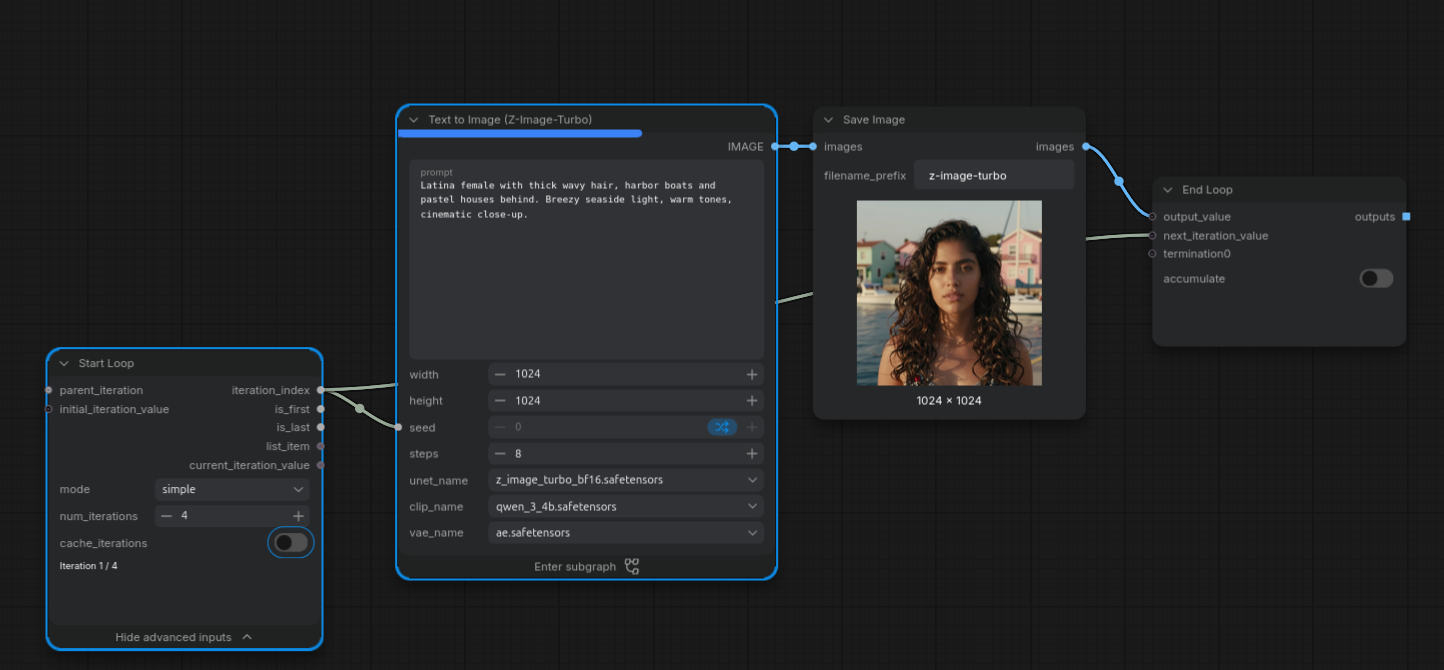
이제 ComfyUI 코어에서 워크플로를 네이티브로 반복할 수 있습니다. Start Loop와 End Loop를 함께 쓰면 그래프를 횟수, 인덱스 범위, 목록 단위로 반복할 수 있습니다.
 이미지→비디오
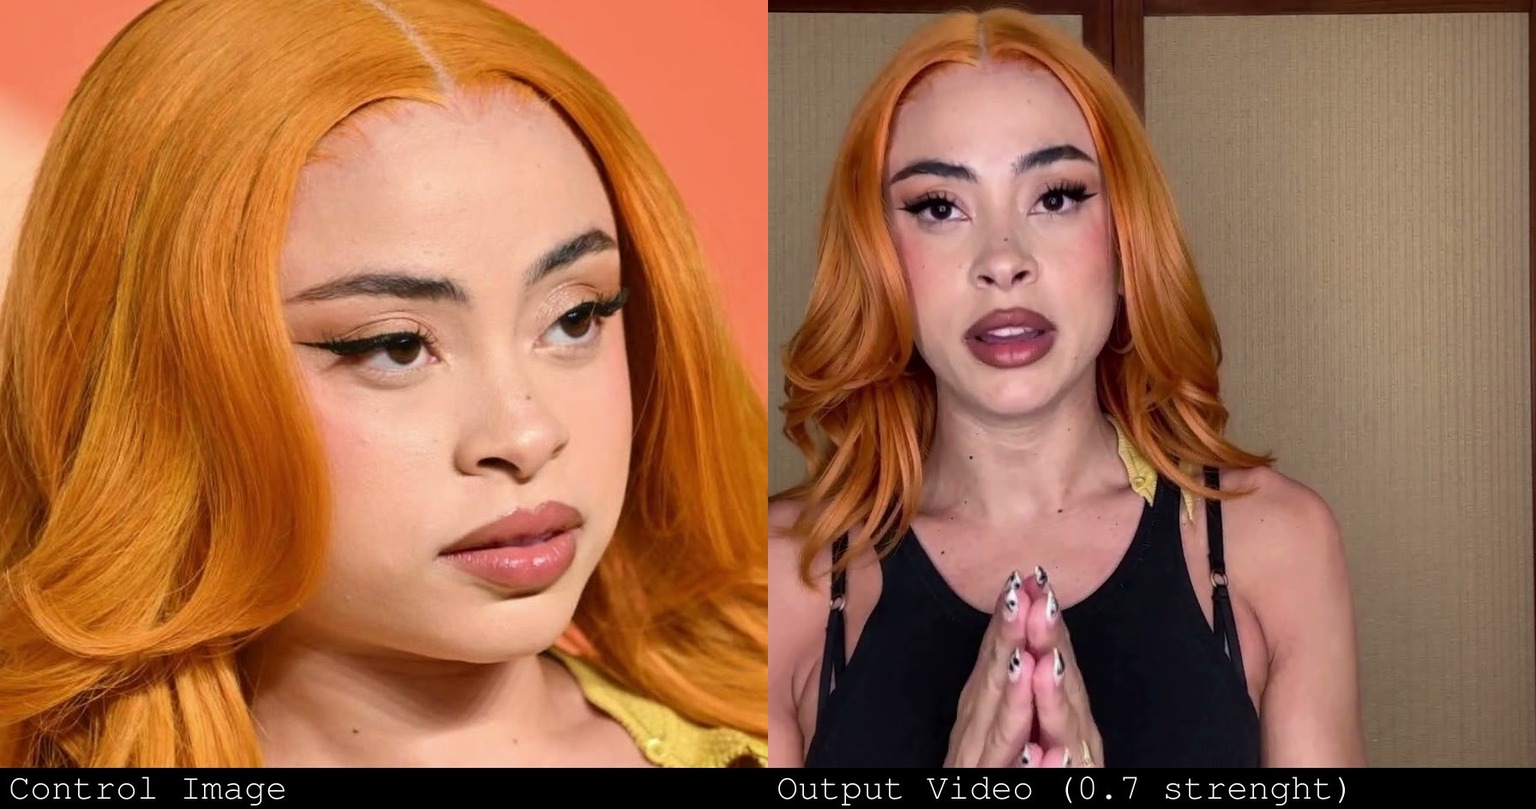
MiniMax H3 Ref2VA용 UntMods의 FaceSwap LoRA는 레퍼런스 비디오의 인물을 참조 이미지의 얼굴로 교체하며, 바로 사용할 수 있는 ComfyUI 워크플로를 함께 제공합니다.
Apache-2.0
 텍스트→비디오
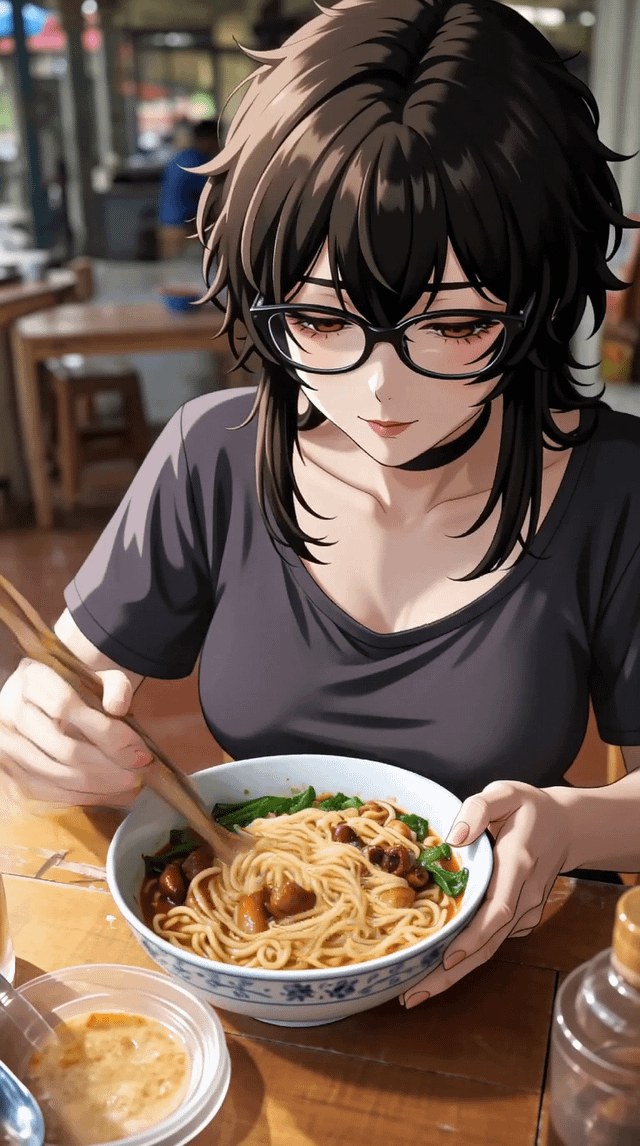
ComfyUI 0.36.0은 comfy-kitchen 커널로 MiniMax H3 비디오 VAE를 가속하며, 공식 Comfy-Org 저장소는 이제 컴팩트한 int8 convrot VAE를 제공합니다.
 텍스트→비디오
FastVideo FastH3 8-Step V2가 공식 t2v 및 첫/마지막 프레임 템플릿, BlockSparseAttention VSA 설정, Comfy-Org가 재패키징한 checkpoint와 함께 ComfyUI에서 네이티브로 실행됩니다.
 비디오 편집
Viggle Meridian은 기하학 렌더를 바탕으로 MiniMax H3 비디오를 리카메라합니다. 기존 클립과 카메라 경로를 입력하면 새로운 시점을 얻습니다. LoRA 2개, 노드 2개, 바로 쓸 수 있는 그래프.
minimax-h3-community-license
 텍스트→이미지
커뮤니티 DMD2 증류 LoRA로 Krea 2 Turbo를 cfg 1.0에서 두 단계로 실행해 빠른 미리보기와 초안을 만들 수 있습니다. 기본 노드만으로 구성된 ComfyUI 워크플로도 제공됩니다.
 이미지→이미지
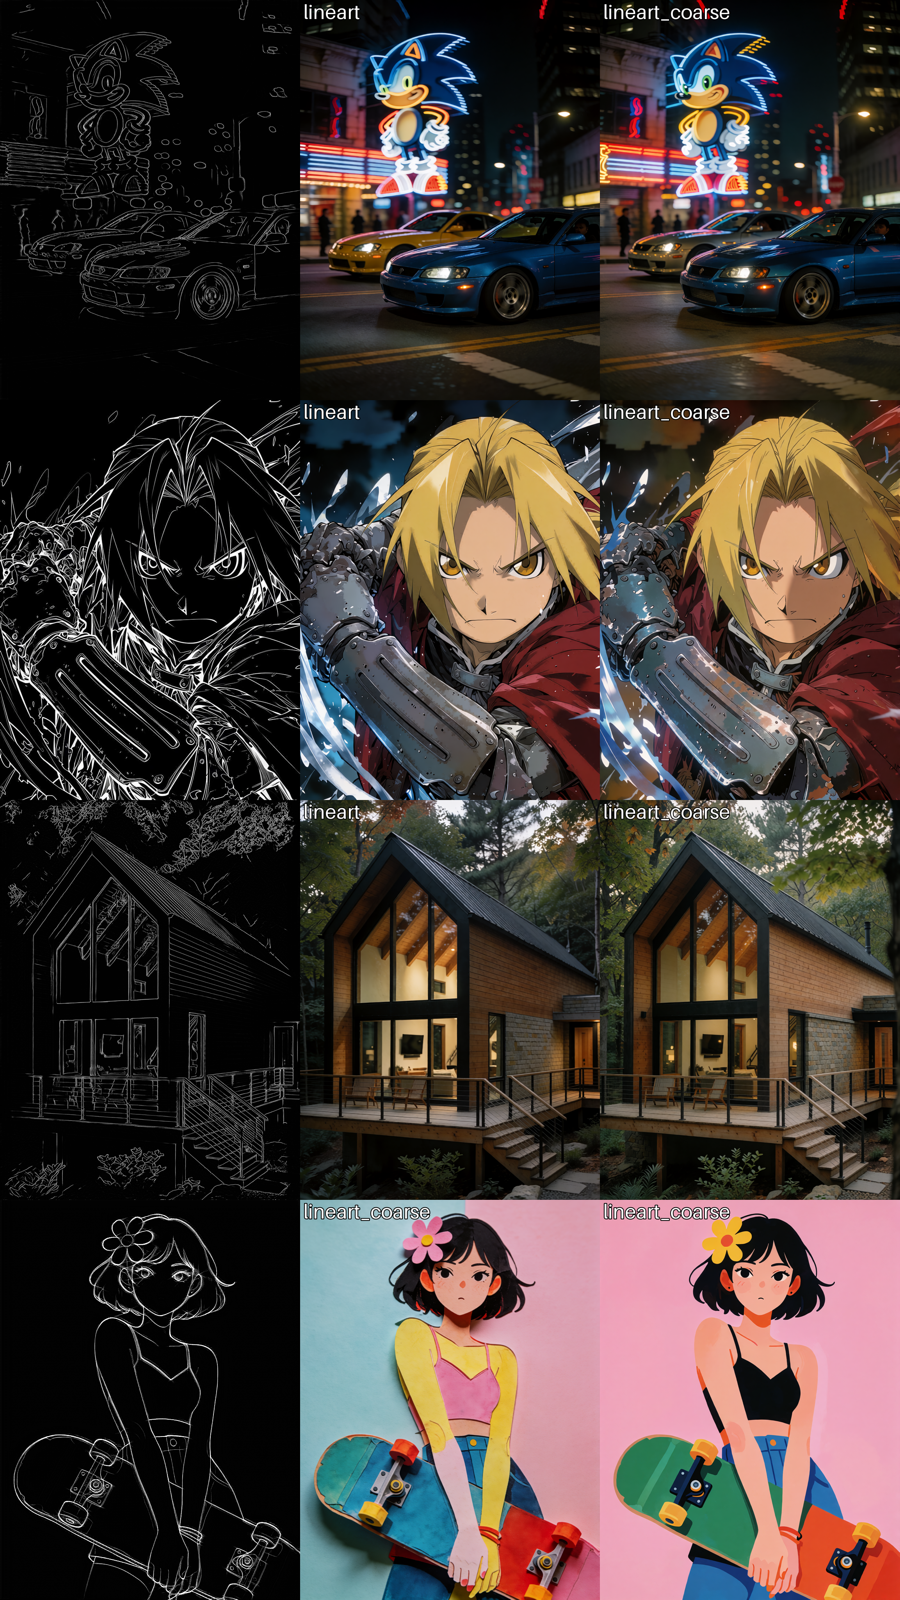
Krea-2-Raw용 커뮤니티 LoRA 2종이 라인아트를 따라가며 완성된 이미지를 그려냅니다. ComfyUI에서 Ostris edit 노드와 Realistic Lineart 전처리기를 사용합니다.
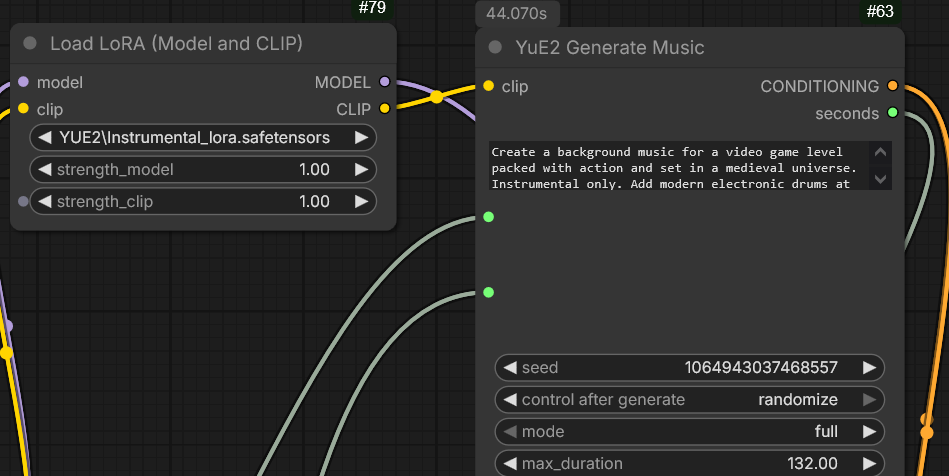 음성 합성
커뮤니티가 만든 YuE2-3B용 누락된 오디오 인코더로, 자신의 녹음을 LoRA 학습용 시맨틱 토큰으로 변환합니다. 섹션 프롬프트를 지원하는 인스트루멘탈 LoRA도 함께 제공됩니다.
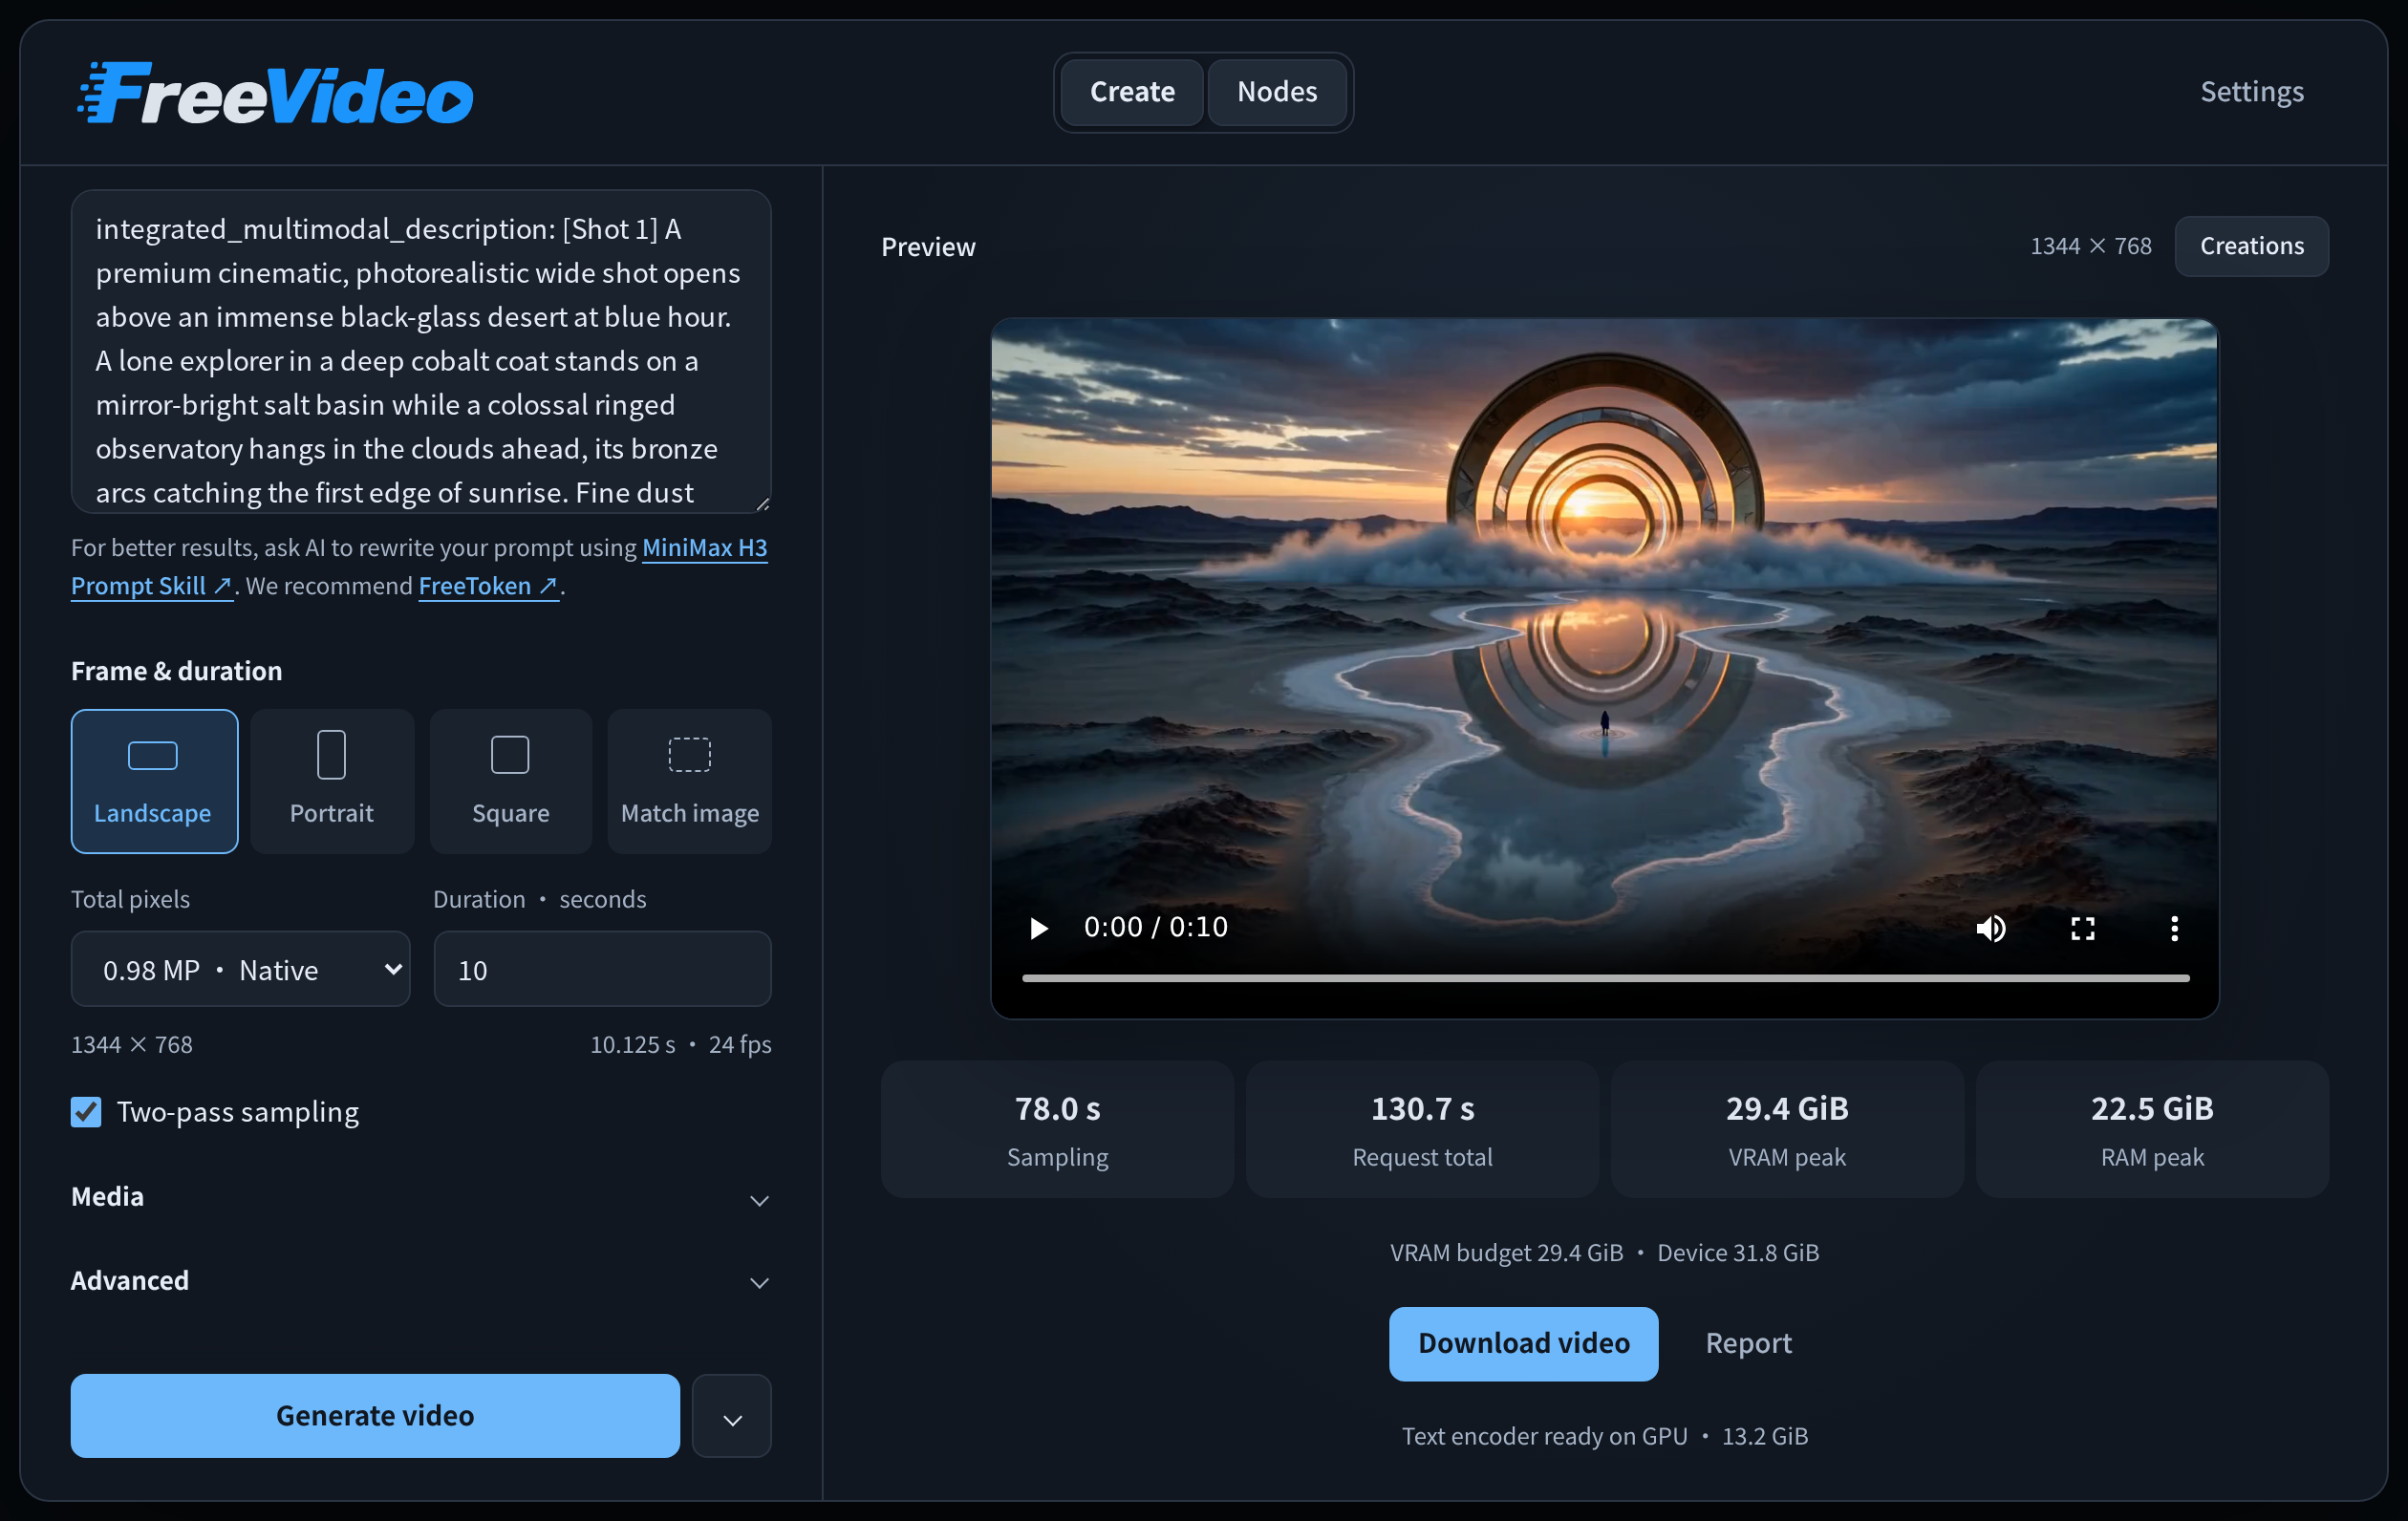 텍스트→비디오
FlashML의 FreeVideo는 최소 8GB VRAM에서 MiniMax H3를 실행하며, 8단계 VDN-H3 모델과 FP8 실행을 기반으로 하는 ComfyUI 플러그인 및 Windows 런처로 제공됩니다.
Apache-2.0
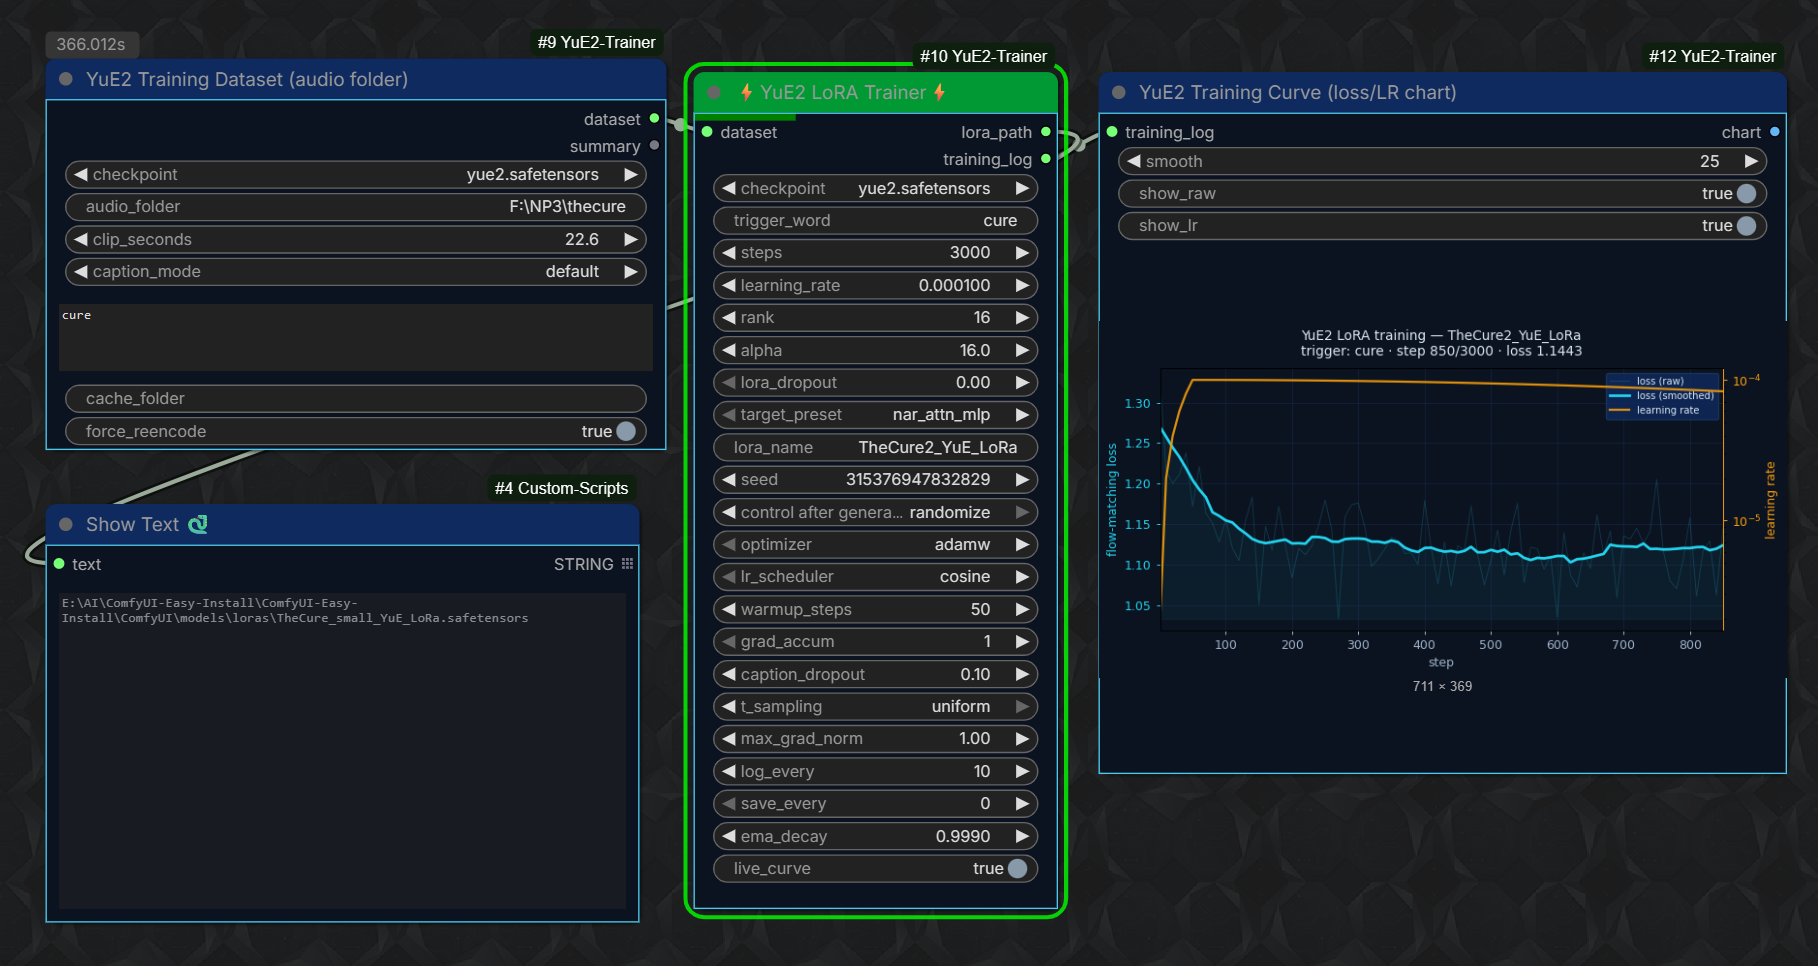 음성 합성
ComfyUI-YuE2-Trainer는 YuE2-3B 음악 모델의 LoRA 학습을 ComfyUI 노드로 가져옵니다. mp3 또는 wav 파일을 넣고 트리거 단어를 지정하면 기본 로더에서 바로 쓸 수 있는 LoRA가 나옵니다.
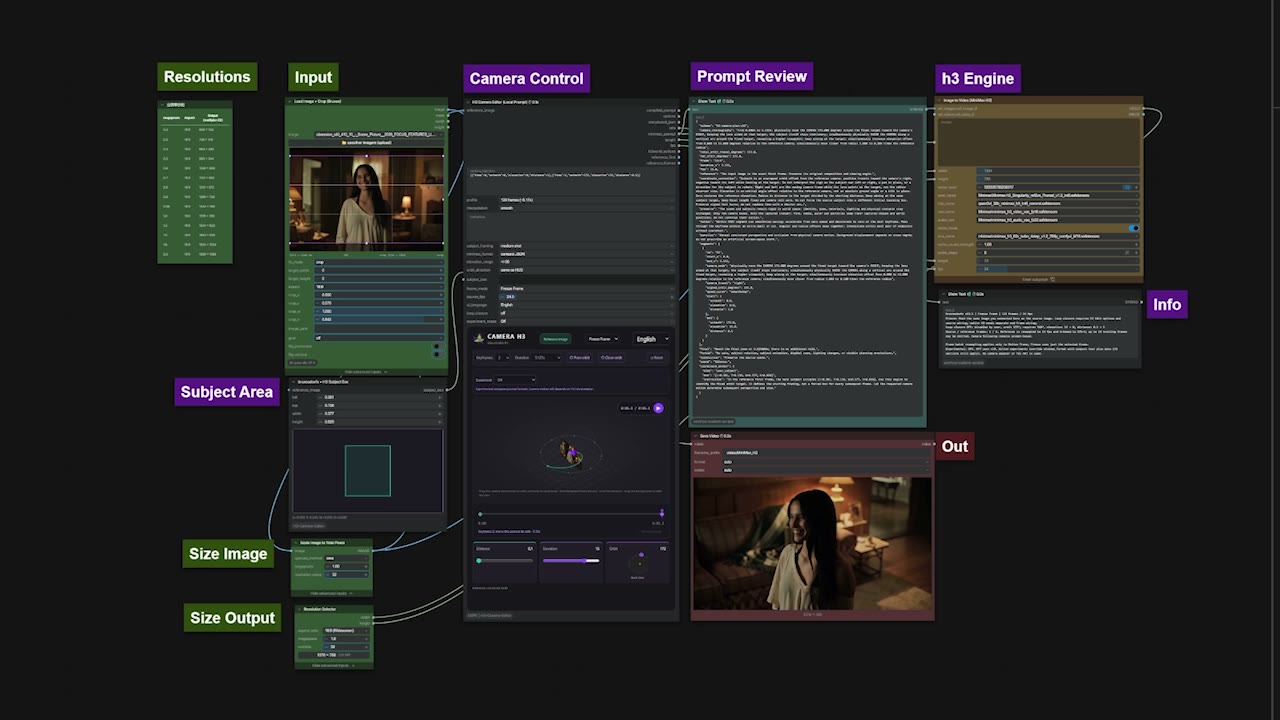 텍스트→비디오
카메라 무브를 MiniMax H3 프롬프트로 바꿔주는 ComfyUI 커스텀 노드입니다. 3D 카메라를 드래그하고 키프레임과 궤도 프리셋을 설정하면 컴파일된 궤적 프롬프트를 얻을 수 있습니다.
 비디오 편집
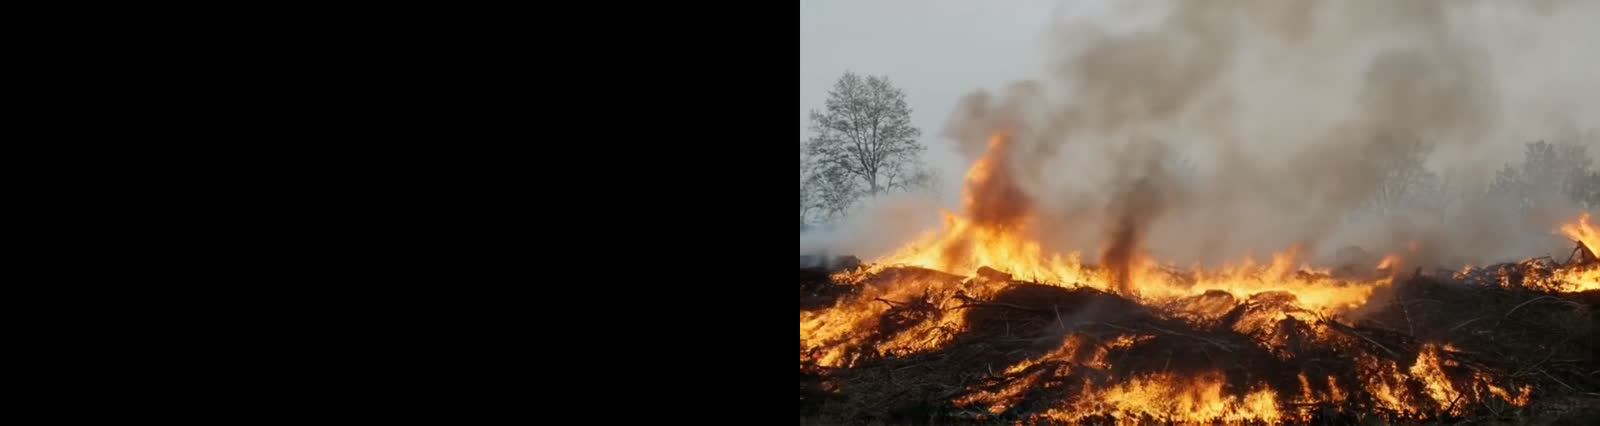
AInVFX의 Adrien Toupet이 키프레임에 칠한 평면 덩어리를 ComfyUI 안에서 아트 디렉팅 가능한 연기, 증기, 불 영상으로 바꿔주는 LTX 2.5용 무료 IC-LoRA를 공개했습니다.
LTX-2.x Community License
 음성 합성
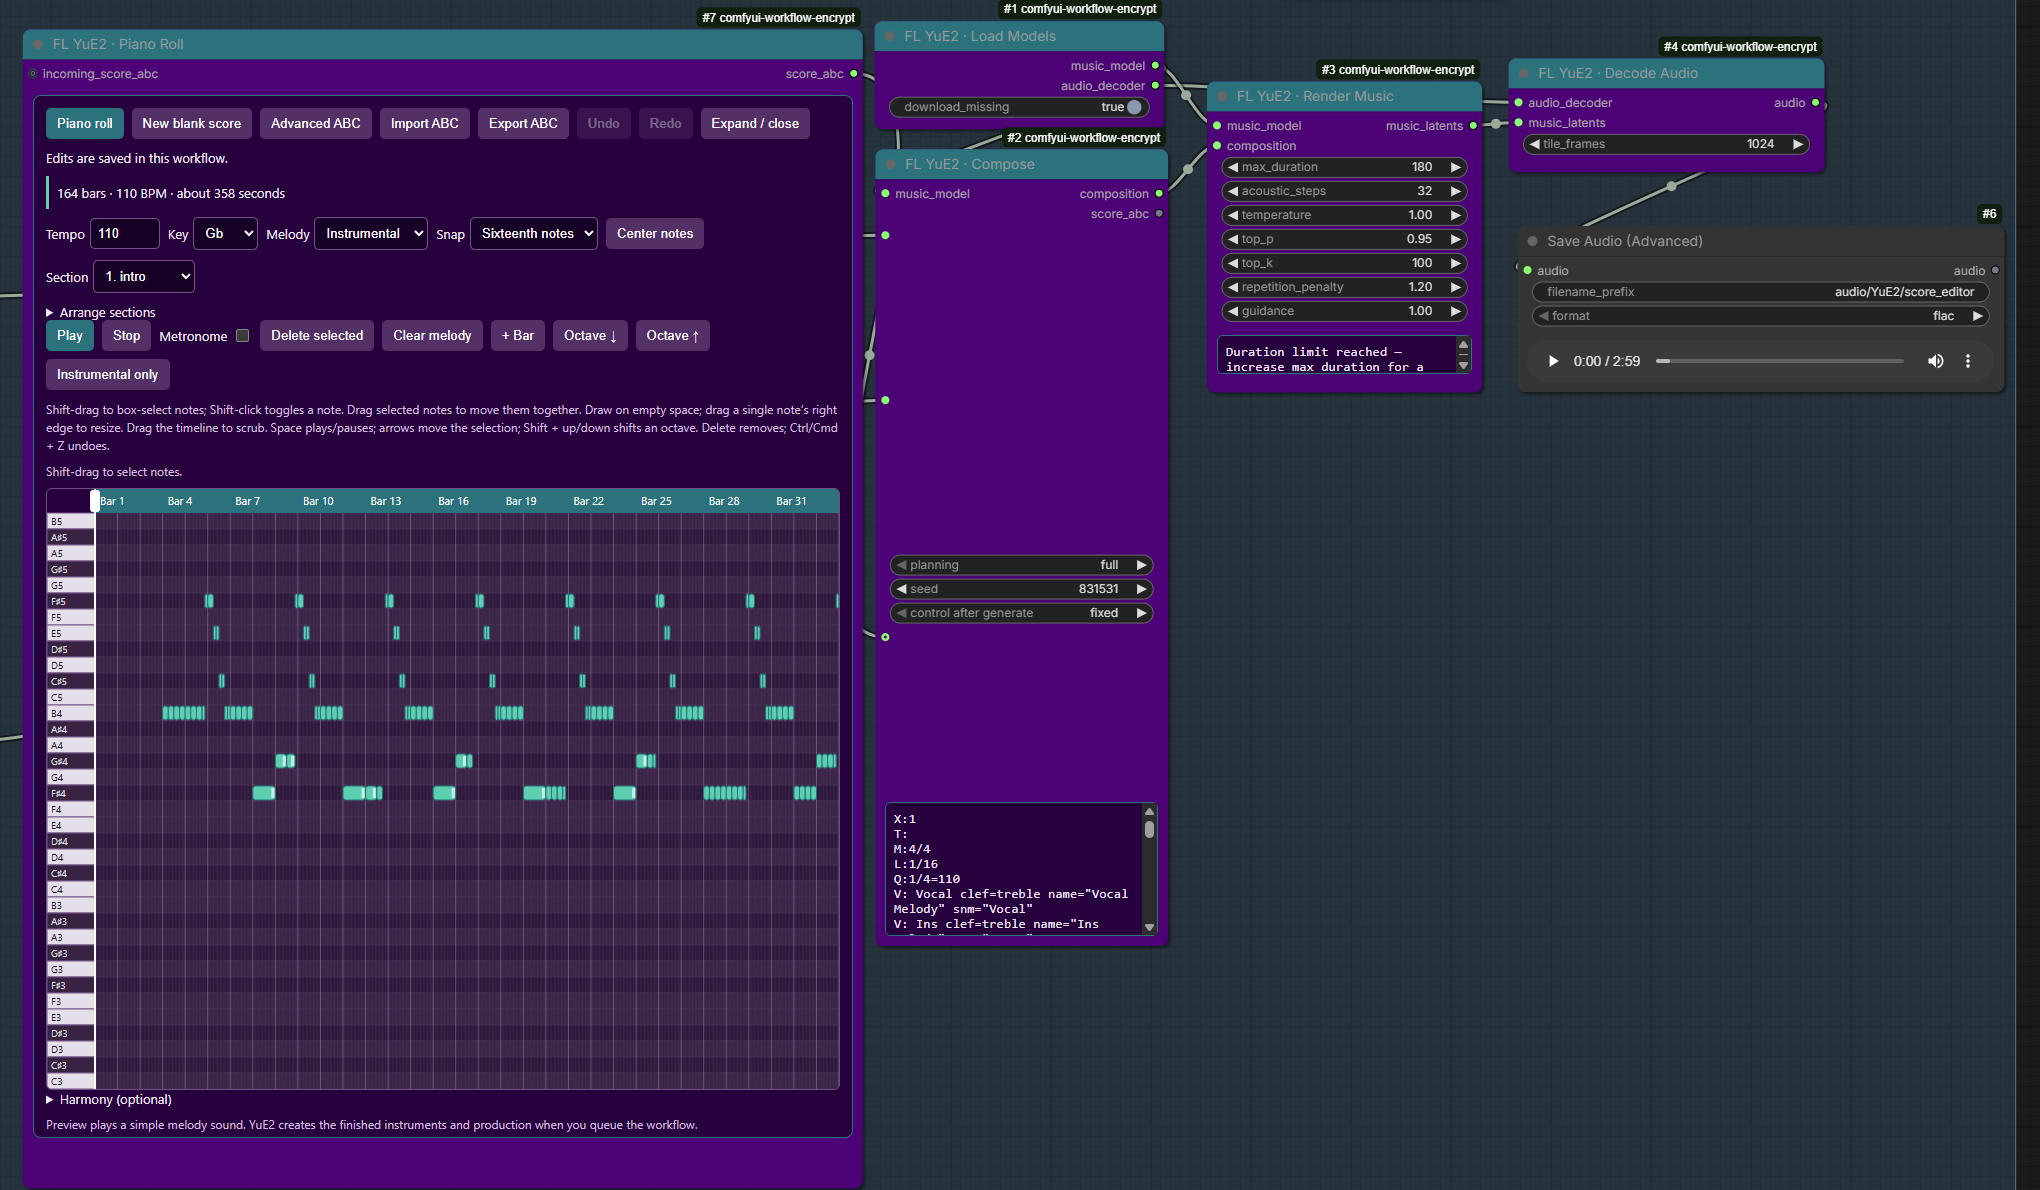
Fill Nodes가 편집 가능한 피아노 롤 악보 편집기, AR LoRA 학습, 48 kHz 스테레오 렌더링을 갖춘 YuE2 노드 팩을 추가합니다. 모두 ComfyUI의 네이티브 YuE2 pipeline 위에 구축되었습니다.
 음성 합성
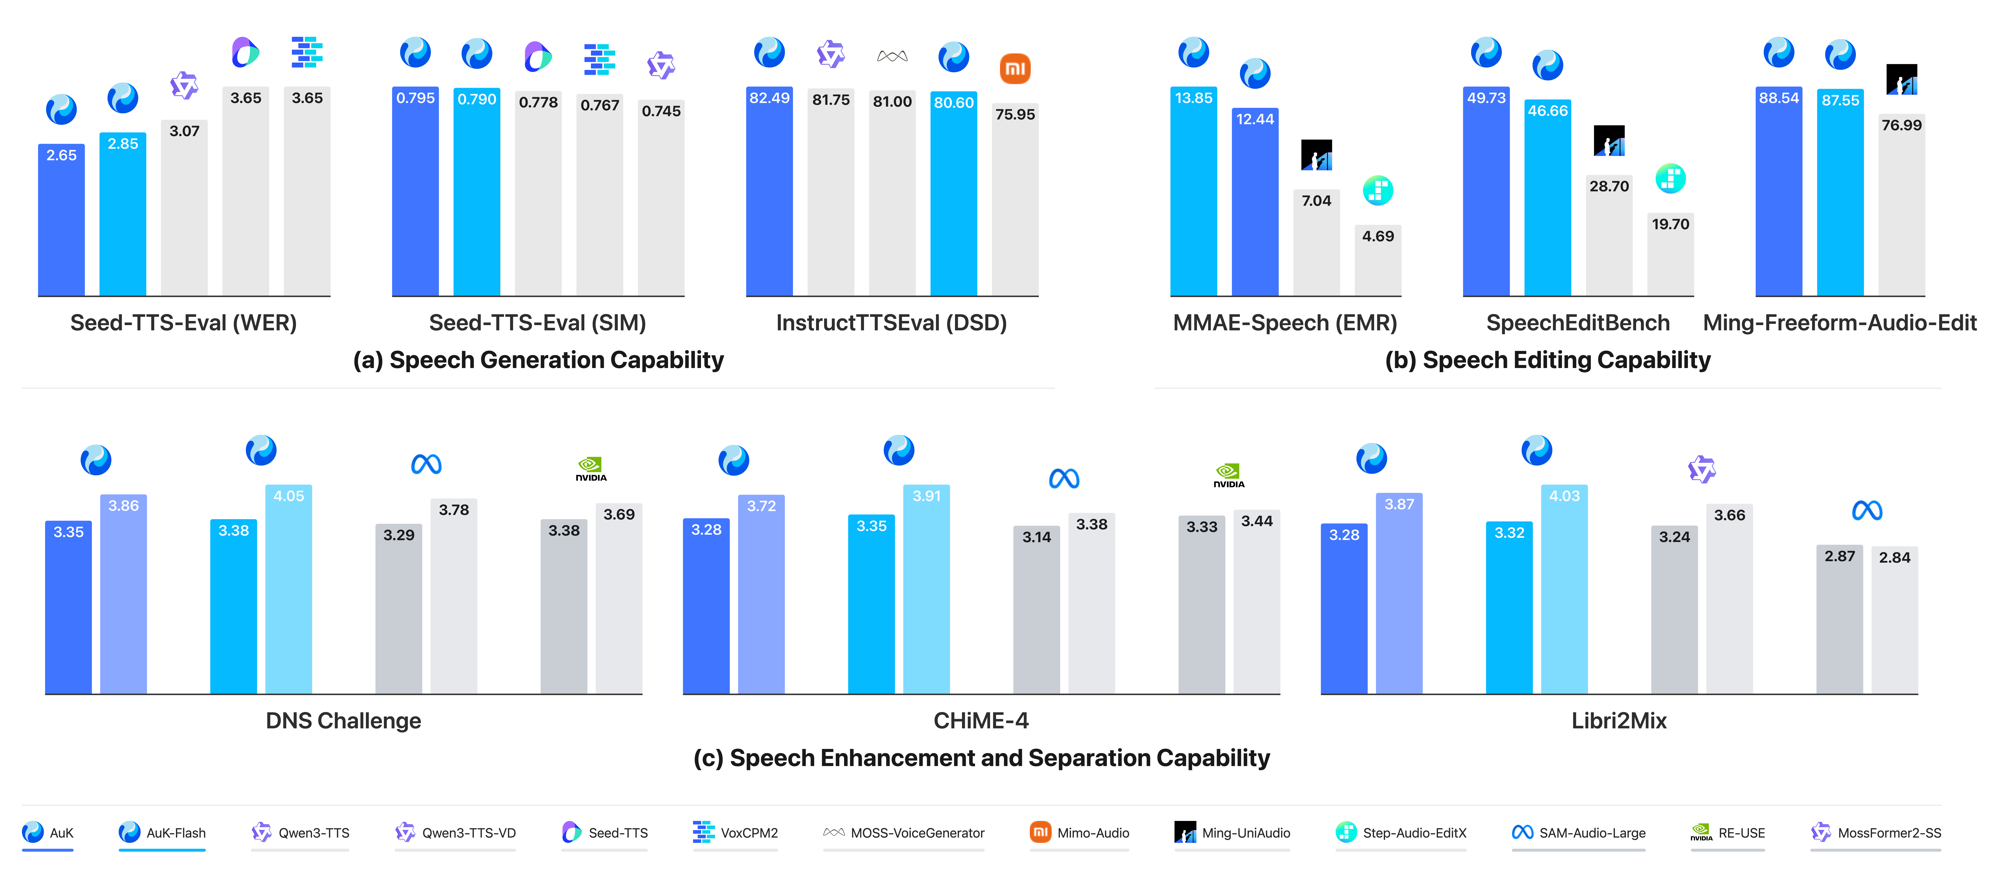
Tencent Hunyuan이 TTS, 음성 복제, 가사 편집, 음성 향상, 음원 분리를 아우르는 1.5B 음성 모델 AuK를 오픈소스로 공개했습니다. 공식 ComfyUI 노드와 워크플로가 함께 제공됩니다.
MIT