ComfyUI에서 직접 나만의 YuE2 LoRA 학습하기
ComfyUI-YuE2-Trainer는 YuE2-3B 음악 모델의 LoRA 학습을 ComfyUI 노드로 가져옵니다. mp3 또는 wav 파일을 넣고 트리거 단어를 지정하면 기본 로더에서 바로 쓸 수 있는 LoRA가 나옵니다.
safetensors LoRA가 만들어집니다. 캡션 파일도, 외부 학습 스크립트도 필요 없고 ComfyUI를 벗어날 일도 없습니다.
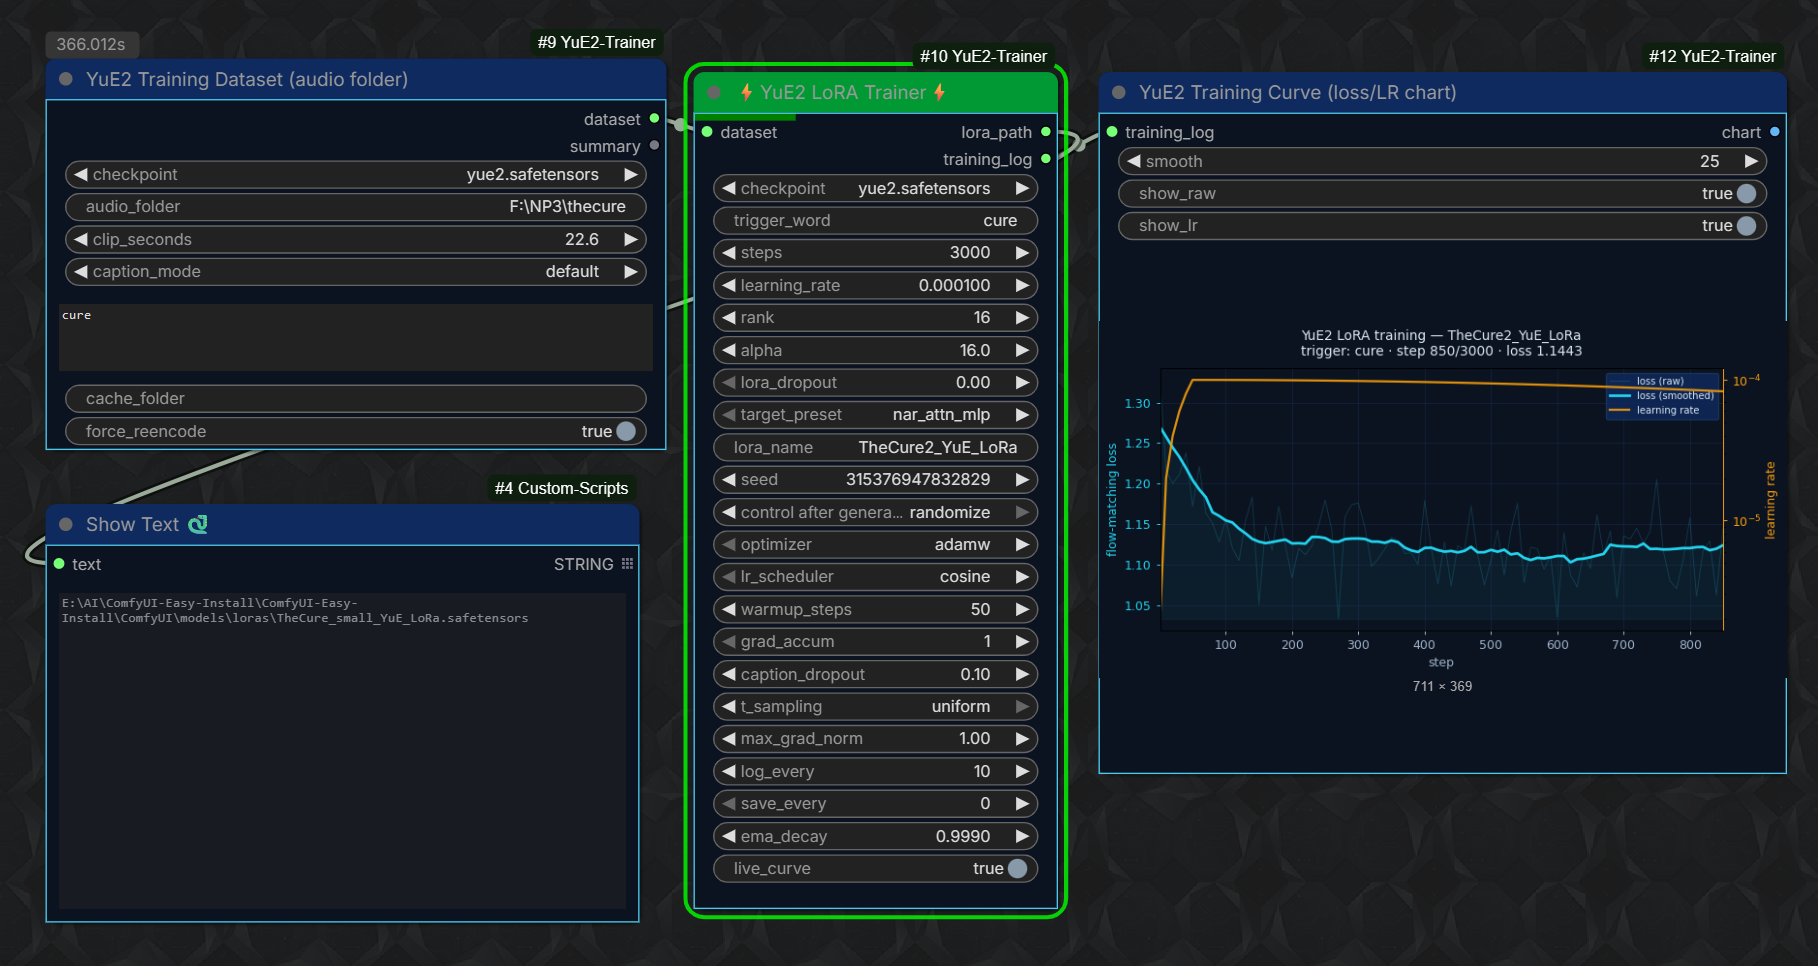
무엇을 어떻게 학습하는가
YuE2-3B는 스타일 프롬프트와 가사로 완성된 곡을 생성하며, 내부적으로 세 부분으로 구성됩니다. 곡을 설계하고 의미 토큰을 작성하는 2.2B AR 언어 모델, 64채널 VAE latent를 사운드로 렌더링하는 1.5B NAR flow-matching 분기, 그리고 48 kHz 스테레오 VAE입니다. 트레이너는 AR "작곡" 분기를 고정하고(m-a-p는 audio-to-token 인코더나 그 학습 코드를 공개하지 않았습니다) 공개된 flow-matching 목적 함수를 사용해 NAR 분기에만 LoRA 어댑터를 학습합니다.
따라서 결과물은 음성 복제가 아니라 스타일, 악기 구성, 보컬 음색 LoRA입니다. 학습은 캡션 없이 진행됩니다. 오디오 파일은 한 번 VAE latent로 인코딩되어 디스크에 캐시되고, 트리거 단어는 YuE2의 checkpoint 네이티브 텍스트 접두사([Tags] your_trigger_word, caption ...)를 통해 주입됩니다. 더 세밀한 제어를 원한다면 파일마다 같은 이름의 .txt 캡션을 선택적으로 지원합니다.
저장된 LoRA는 네이티브 ComfyUI 형식의 표준 *.safetensors이며, models/loras/에 넣고 네이티브 YuE2 checkpoint에서 기본 LoraLoaderModelOnly 노드로 로드하면 됩니다. 변환 단계는 없습니다.
요구 사항
- 단일 파일 네이티브 YuE2 checkpoint: Comfy-Org/YuE2의
yue2_3b_bf16.safetensors(~7.8 GB)이며, 네이티브 생성 노드가 사용하는 것과 같은 파일입니다. bf16 파일을 사용하세요. INT8로 재패키징된 버전은 학습할 수 없습니다. - 24 GB VRAM 권장 (RTX 5090 Laptop 24 GB에서 테스트).
- 이 노드 팩은 독립 실행형입니다. 공식 YuE2 모델 코드(m-a-p의
yue2_infer, Apache-2.0, 수정 없음)가 함께 포함되어 있어 다른 커스텀 노드가 필요하지 않습니다.
작성자 설정과 초기 피드백
작성자가 권장하는 레시피는 weight 2.0으로 5000 스텝이며, LoRA는 convrot 변형보다 FP16 모델에서 더 잘 작동합니다. 초기 커뮤니티 피드백은 엇갈립니다. 첫 번째 이슈에서는 학습된 LoRA가 귀에 들리는 효과가 없다고 보고하고, 음성 복제는 작동하지 않는 것으로 명시되어 있으므로, 아직 공개적으로 개선 중인 실험적 도구로 취급하세요. 이 프로젝트에는 이미 더 넓은 학습 범위를 탐색하는 포크가 있으며, 그중 하나는 음향 모델과 플래너 CLIP을 함께 학습합니다.
사용 가능 여부
트레이너는 GitHub의 Starnodes2024/ComfyUI-YuE2-Trainer에서 무료로 제공됩니다(작성 시점 기준 스타 51개). ComfyUI-Manager로 설치하거나 custom_nodes에 git clone 하세요.
댓글
GitHub로 로그인하고 토론에 참여하세요.