Fizgig v6 RefMods: ComfyUI MiniMax H3용 무학습 캐릭터 참조
Fizgig v6.0은 MiniMax H3용 RefMod를 만듭니다. 참조 사진을 작은 파일 하나로 묶고, 모델 자체에 맞춰 튜닝하며, ComfyUI를 열기 전에 RefMod Studio에서 미리 확인할 수 있습니다.
Fizgig v6.0이 어제 LoRA 및 파인튜닝 트레이너 위에 새로운 기능을 얹어 출시되었습니다: MiniMax H3용 RefMod. RefMod는 참조 사진 또는 클립 폴더를 작은 파일 하나로 묶어, ComfyUI-MiniMaxH3Mod 노드가 LoRA처럼 불러와 H3의 참조 경로로 공급합니다. 학습 실행이 필요 없고 몇 분이면 파일이 만들어지며, 기본 종류는 캡션도 필요 없습니다.
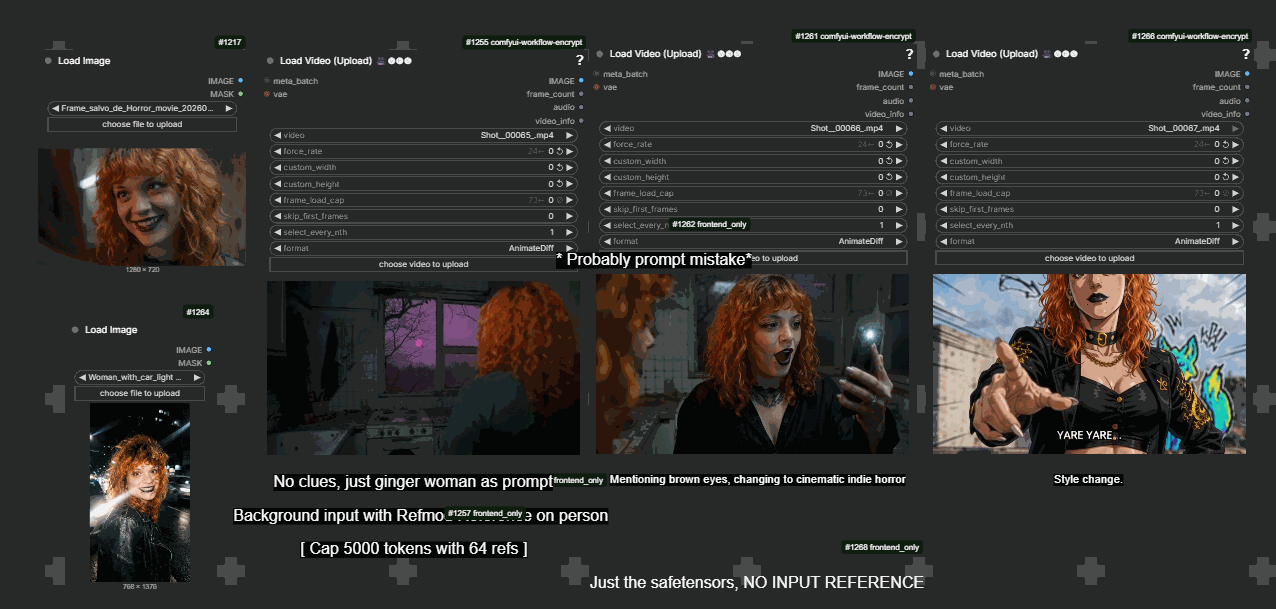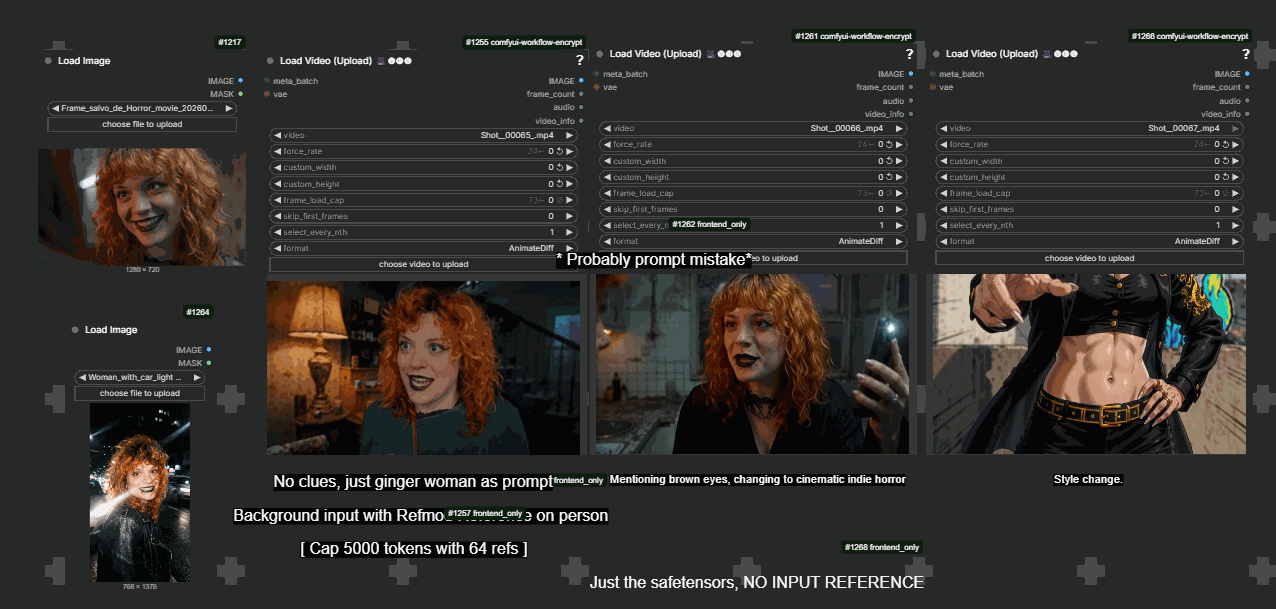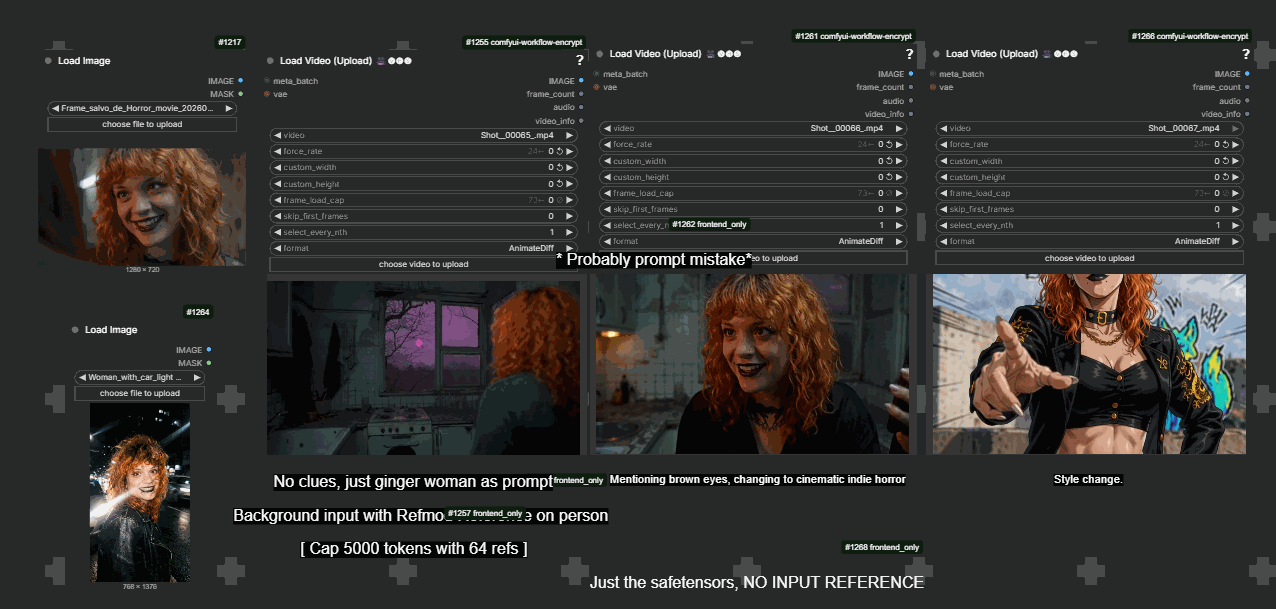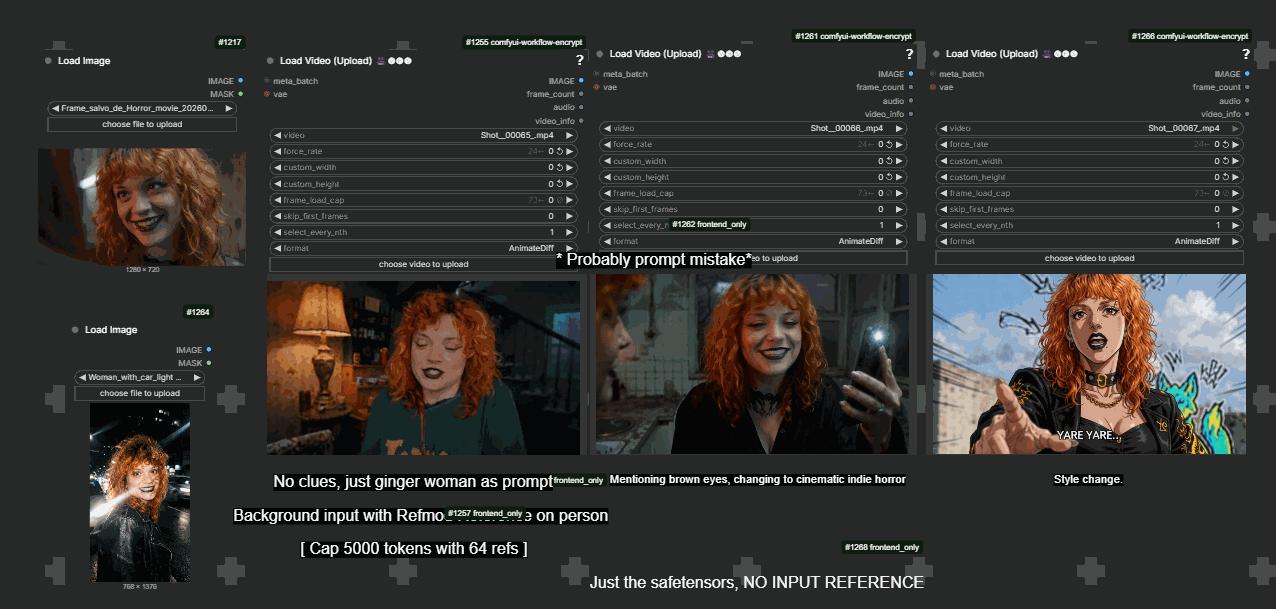
프로젝트의 예시 갤러리에서 MiniMaxH3Mod 노드를 통해 ComfyUI에서 생성된 아이덴티티 RefMod.
RefMod란 무엇인가
RefMod 포맷 자체는 커뮤니티 노드 팩 ComfyUI-MiniMaxH3Mod by @Luisacaotica(스타 199개)에서 비롯되었으며, @malcolmrey의 모드 라이브러리와 가이드가 함께 제공됩니다. 이 포맷은 참조 이미지와 비디오를 H3의 참조 경로를 따라 흐르는 아주 작은 잠재 데이터 토큰으로 압축합니다. 따라서 매 생성마다 같은 사진을 이미지 슬롯에 밀어 넣는 대신 파일 하나만 불러오면 됩니다. Fizgig v6는 다른 어떤 제작자도 갖지 못한 한 가지를 추가했습니다: 사진을 단순히 인코딩하는 데 그치지 않고 H3 자체에 맞춰 RefMod를 튜닝할 수 있습니다.
Fizgig v6가 추가한 것
- 사람과 스타일을 위한 다섯 가지 프리셋: 커뮤니티 레시피(1 MP에서 사진 8장을 단순 인코딩한 것으로, 노드 팩 자체 추출기가 만드는 결과와 동일), Fizgig recipe lite(0.5 MP에서 사진 16장, 모델에 맞춰 튜닝), Fizgig recipe(더 선명한 결과를 위한 1 MP의 동일 구성), 그리고 사람이 아닌 외형을 위한 스타일 프리셋.
- 모델 인 더 루프 튜닝: 튜닝된 프리셋은 생성 과정에서 H3 베이스 모델에 대해 파일을 실행하며, 작성자는 이를 통해 사진에 담기지 않았던 샷에서 더 나은 일반화와 더 깔끔하고 선명한 출력을 얻는다고 말합니다.
- RefMod Studio 탭: ComfyUI를 열기 전에 Fizgig 안에서 모드와 베이스 모델을 A/B 비교할 수 있습니다.
- 모션 및 오디오 모드로 쓰는 클립: 팩의 Gizmo 도구로 준비한 비디오 클립은 모션 참조가 될 수 있고, 오디오 모드는 비주얼과 함께 폴더의 사운드를 담을 수 있습니다.
- 드롭인 호환성: 출력 폴더를 ComfyUI의
models/refmods로 한 번만 지정하면 모든 모드가 기존 MiniMaxH3Mod 노드를 통해 로드됩니다. ref2va와 fl2va 워크플로 모두에서 작동합니다.
RefMod와 LoRA 비교
릴리스 스레드에서 작성자 본인이 밝힌 설명: RefMod는 빠르고 작지만, LoRA만큼 어떤 콘셉트를 많이 알 수 없고 일반화도 잘 되지 않습니다. 트레이드오프는 속도입니다. LoRA는 학습 실행이 필요하지만 RefMod는 몇 분이면 완성되며, 참조와 유사한 샷에서의 캐릭터 일관성이라면 품질 차이도 작습니다. 최대한의 유사성과 일반화를 위해서는 여전히 LoRA가 최고이며, Fizgig v6는 완전한 H3 및 Krea 2 LoRA 트레이너를 그대로 유지합니다.
받는 방법
Fizgig v6.0.1은 GitHub에 있습니다. ComfyUI에서는 파일을 로드하기 위해 MiniMaxH3Mod 노드 팩이 필요하며, 작성자의 RefMods - how do I...? 가이드가 사진에서 로드된 모드까지의 전체 흐름을 안내합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.