FreeVideo: 8GB VRAM에서 MiniMax H3 실행하기
FlashML의 FreeVideo는 최소 8GB VRAM에서 MiniMax H3를 실행하며, 8단계 VDN-H3 모델과 FP8 실행을 기반으로 하는 ComfyUI 플러그인 및 Windows 런처로 제공됩니다.
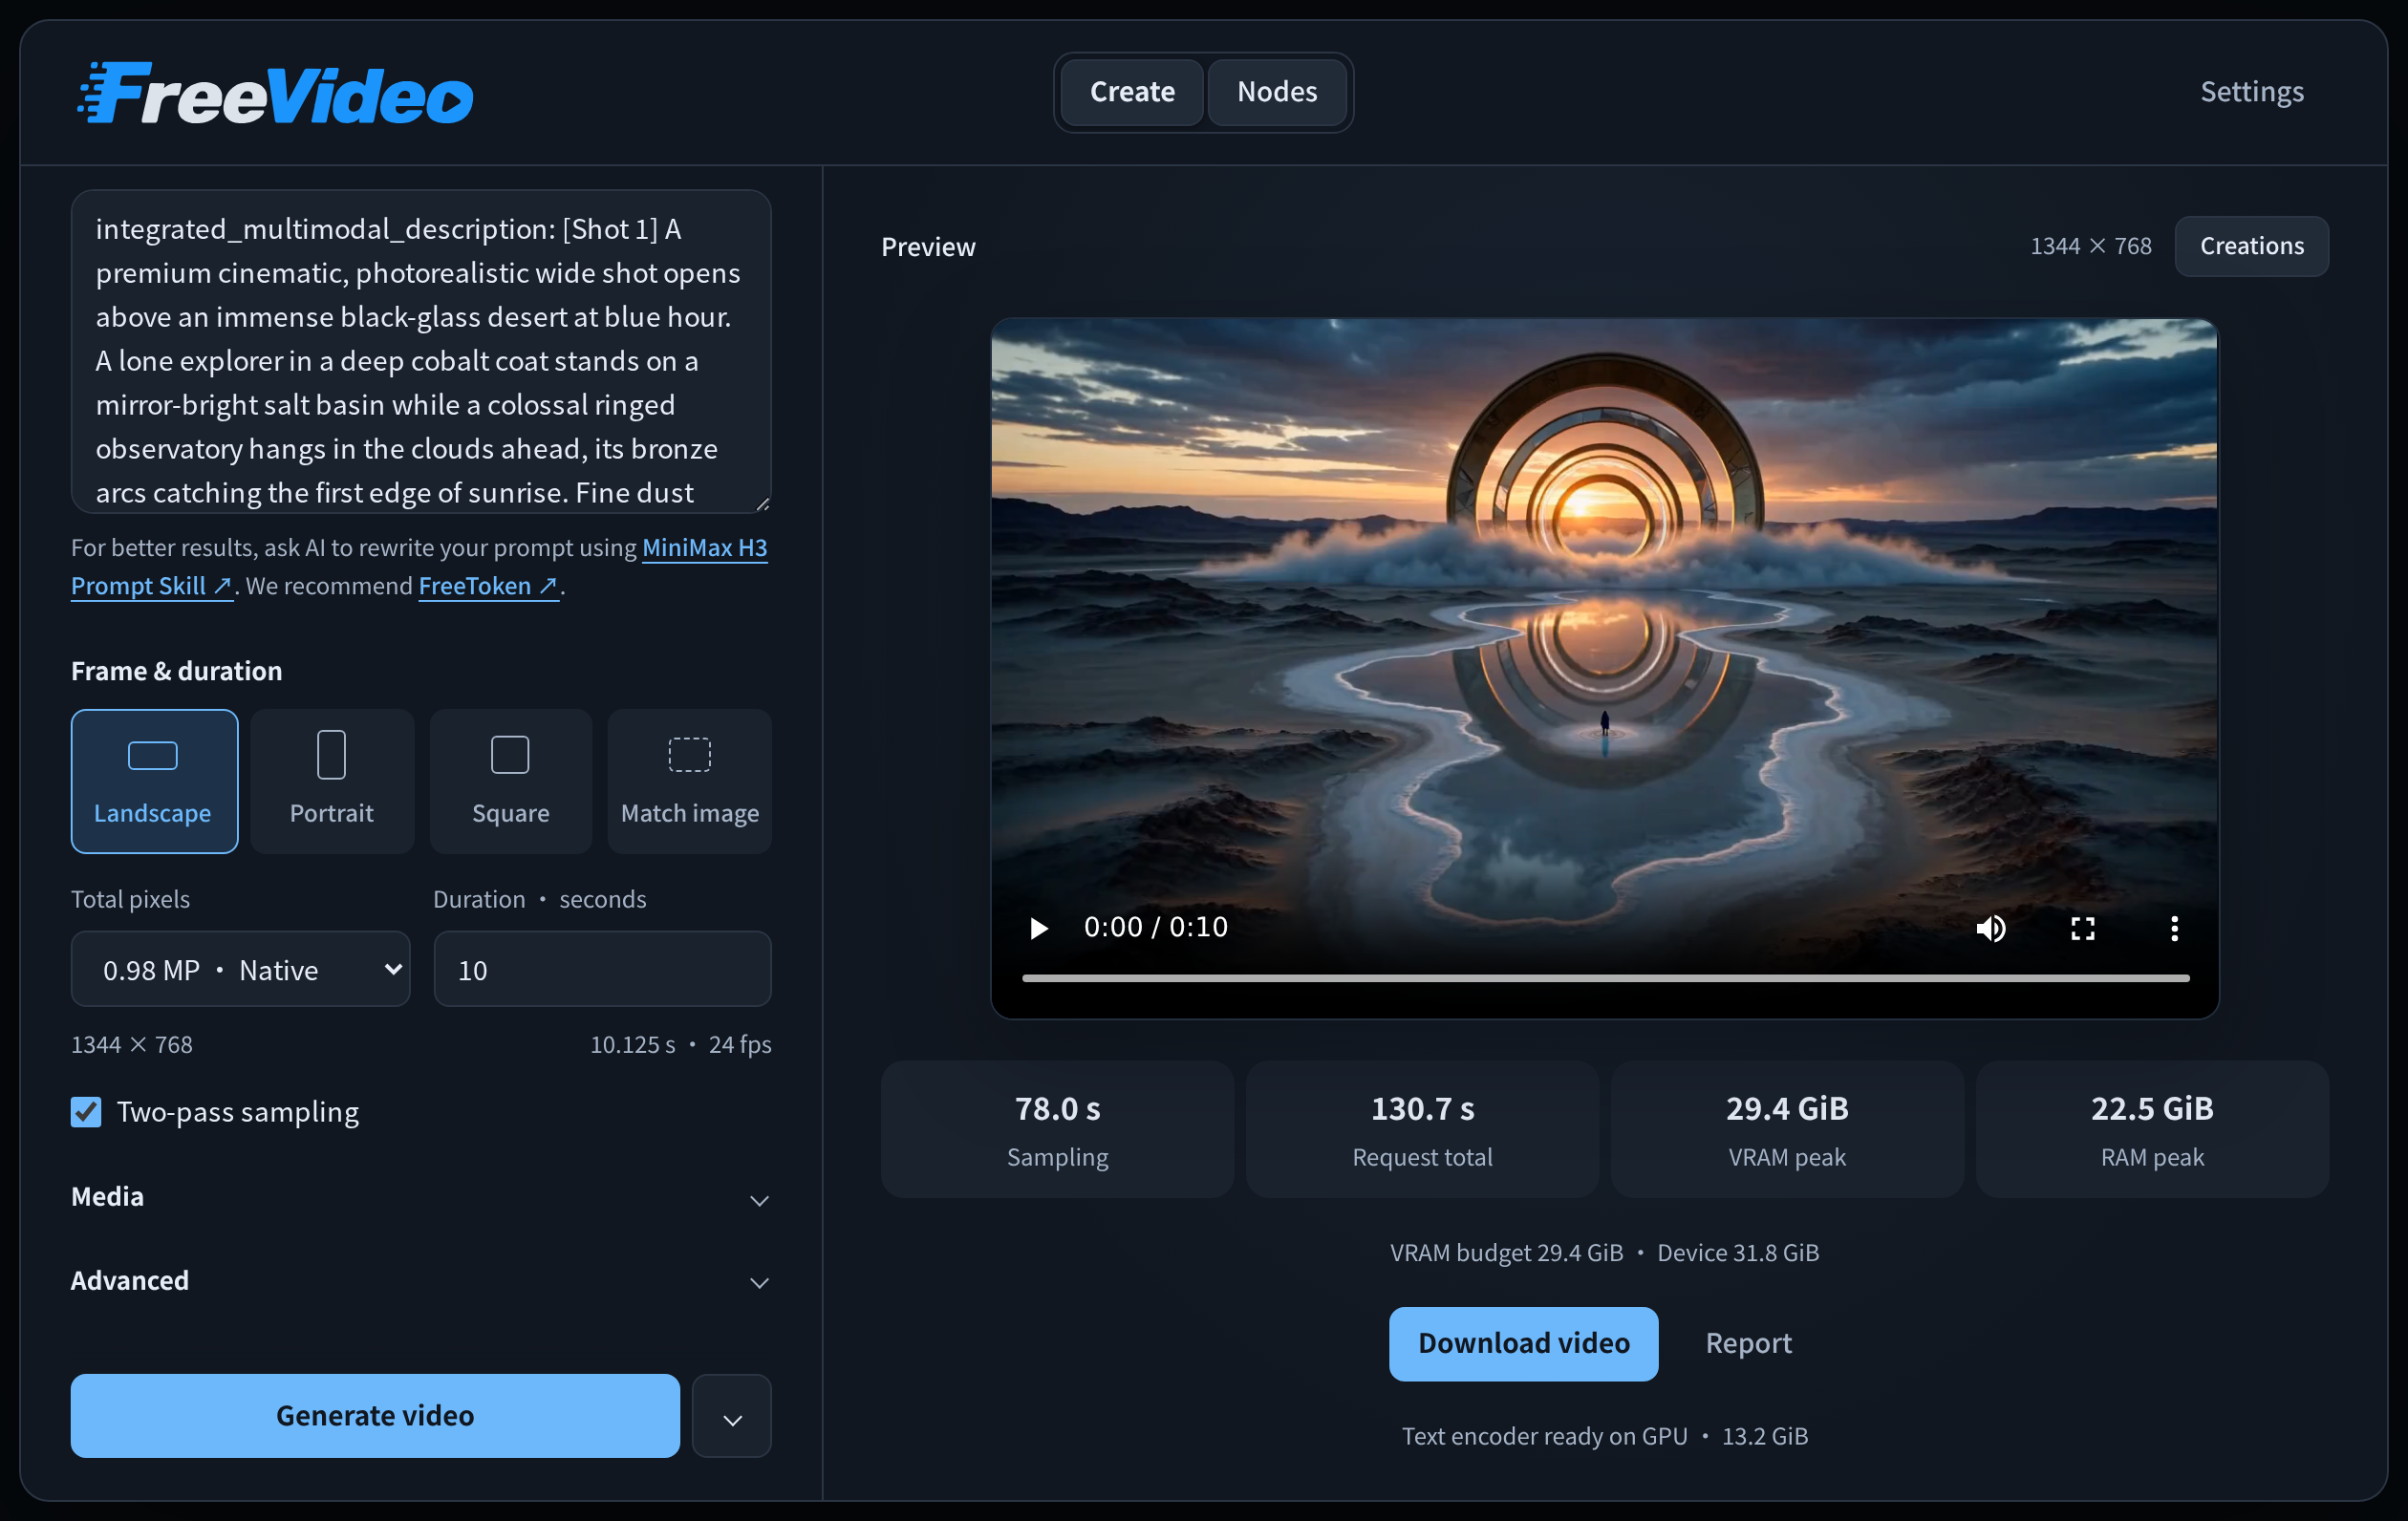
ComfyUI 내부의 FreeVideo 워크스페이스. LoRA와 워크플로 편집을 위한 노드 뷰도 사용할 수 있습니다.
VDN-H3 기반
FreeVideo는 dense H3 트랜스포머를 실행하지 않습니다. 대신 OpenVDN의 8단계 VDN-H3 체크포인트를 실행합니다. 이는 H3의 2차 장거리 어텐션을 선형 분기로 대체한 Video DeltaNet 하이브리드 어텐션 재설계입니다(VDN-H3 관련 글 참고). FreeVideo는 이 모델을 준비된 FP8 vdn-minimax-h3-edge 릴리스(포맷당 약 22.9GB)로 패키징하고, 그 위에 H3의 트랜스포머 블록 50개 각각이 런타임에 어디에 위치할지 결정하는 플래너를 얹습니다.
하드웨어 적응형 실행
각 요청마다 Adaptive Execution Planner는 사용 가능한 VRAM, 호스트 메모리, 어텐션 커널의 프로브 결과를 측정한 뒤 다음 항목을 확정합니다.
- 블록 상주: 트랜스포머 블록 50개 중 몇 개가 VRAM에 남고, 몇 개가 고정된 호스트 메모리(최대 22GB)에 있으며, 몇 개가 매 단계마다 디스크에서 읽히는지.
- FP8 GEMM 경로: Blackwell(SM120)에서는 텐서별 스케일, Ada와 Hopper에서는 채널별 스케일, Ampere에서는 FP8 가중치와 BF16 연산.
- 어텐션 백엔드: SageAttention 2, PyTorch flash attention, cuDNN, FlashAttention 2, FlashAttention 4 중 온디바이스 프로브를 통과한 첫 번째 항목.
- VAE 디코더 배치: 예산이 20GB 미만이면 디코더의 36개 블록 중 일부는 상주하고 나머지는 스트리밍되며, 클립은 순차적으로 디코딩됩니다.
예산은 매 요청 전에 다시 측정되며, 완료된 실행은 소요 시간과 메모리 최대치를 resource-history.sqlite3에 저장합니다. 엔진은 이 기록을 이용해 최소 2% 더 빠를 것으로 예측되는 배치가 있으면 더 빠른 배치로 교체합니다.
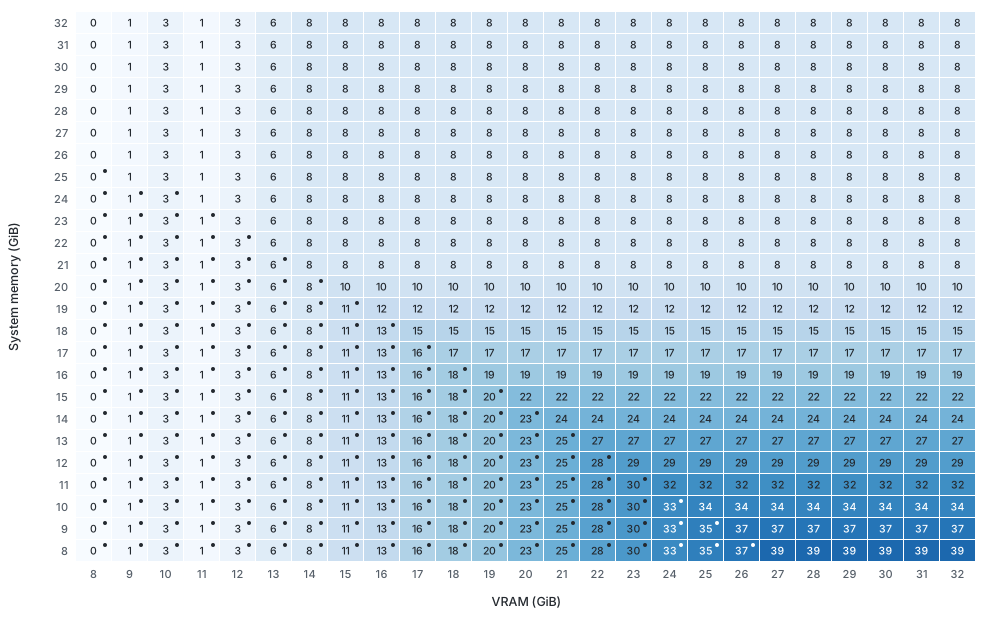 | 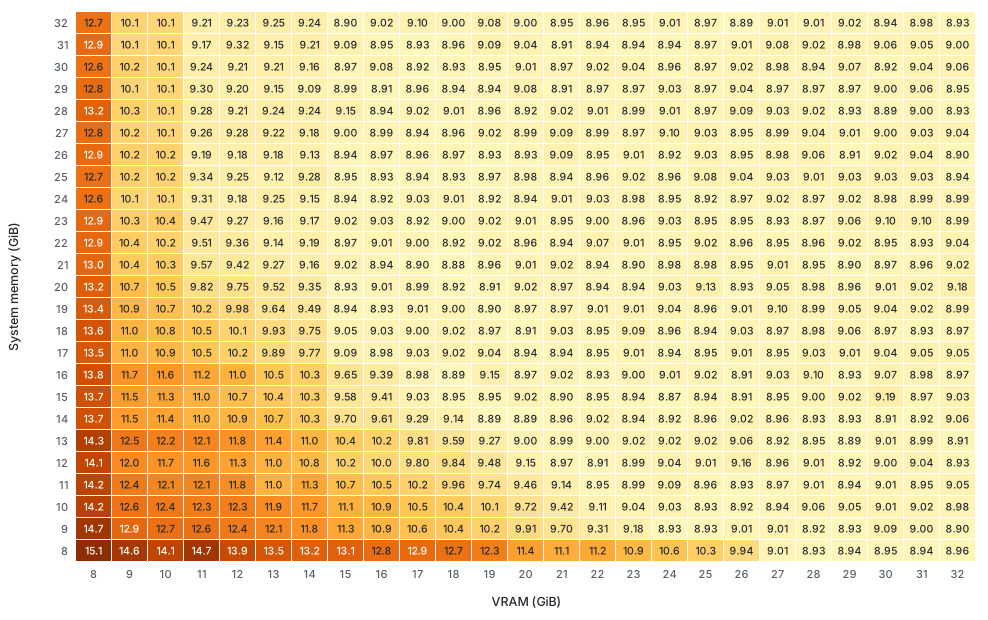 |
|---|---|
| VRAM 예산별로 트랜스포머 블록 50개가 위치하는 곳 | VRAM 예산별로 플래너가 예상하는 처리량 |
지원하는 기능
- 오디오가 포함된 텍스트 프롬프트 기반 비디오 생성
- 첫 프레임 및 마지막 프레임 조건화
- 이미지, 비디오, 오디오 참조
- 같은 워크플로에서 커뮤니티 MiniMax H3 LoRA 사용
- ComfyUI 워크스페이스에서의 2패스 샘플링과 배치 생성, 그리고 이전 작업 기록
시작하기
Windows에서는 windows-preview 릴리스에서 FreeVideo.exe를 다운로드해 실행하세요. 런처는 ComfyUI, 런타임, 그리고 GPU에 맞는 모델 팩을 설치하고, 기존 모델 폴더를 재사용하며, 다운로드한 패키지로 오프라인 설치도 지원합니다.
기존 ComfyUI 설치에 FreeVideo를 추가하려면:
cd ComfyUI/custom_nodes
git clone https://github.com/FlashML-org/FreeVideo.git
ComfyUI를 재시작하고 워크플로 -> 템플릿 탐색 -> FreeVideo -> FreeVideo-All-in-One을 연 다음, FreeVideo 설정에서 설정을 완료하세요. Linux에서는 저장소가 CLI도 제공합니다:
git clone https://github.com/FlashML-org/FreeVideo.git && cd FreeVideo
./setup.sh
./freevideo generate --prompt-file prompt.txt --out video.mp4
함께 제공되는 예제 워크플로는 템플릿 브라우저에 표시되는 것과 동일합니다:
제공
FreeVideo는 github.com/FlashML-org/FreeVideo에 있으며, 준비된 FP8 가중치는 OpenVDN/vdn-minimax-h3-edge에서 제공됩니다. 런처는 감지된 아키텍처에 맞춰 이 가중치를 자동으로 다운로드합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.