Anima-Light-Lavender: 긴 자연어 프롬프트를 위한 Anima 포스트 트레인
Anima-Light-Lavender는 512 토큰 자연어 캡션을 읽는 Anima-Base v1.0의 포스트 트레인으로, BF16과 MXFP8 가중치를 제공하며 ComfyUI에 그대로 적용됩니다.
Anima-Base v1.0은 Danbooru 스타일 태그를 기본 입력으로 사용합니다. Anima-Light-Lavender는 반대 방향으로 나아갑니다. 긴 자연어 image_description 필드를 포함한 구조화된 캡션으로 학습되었으며, 이번 릴리스는 512 토큰 규모의 설명 이해에 초점을 맞춥니다. 학습 데이터셋은 약 170만 장의 Danbooru 이미지로, 주석, 필터링, 선호도 판단 모델을 모두 기성품 대신 작성자가 직접 학습한 데이터 파이프라인으로 주석 처리하고 필터링했습니다.
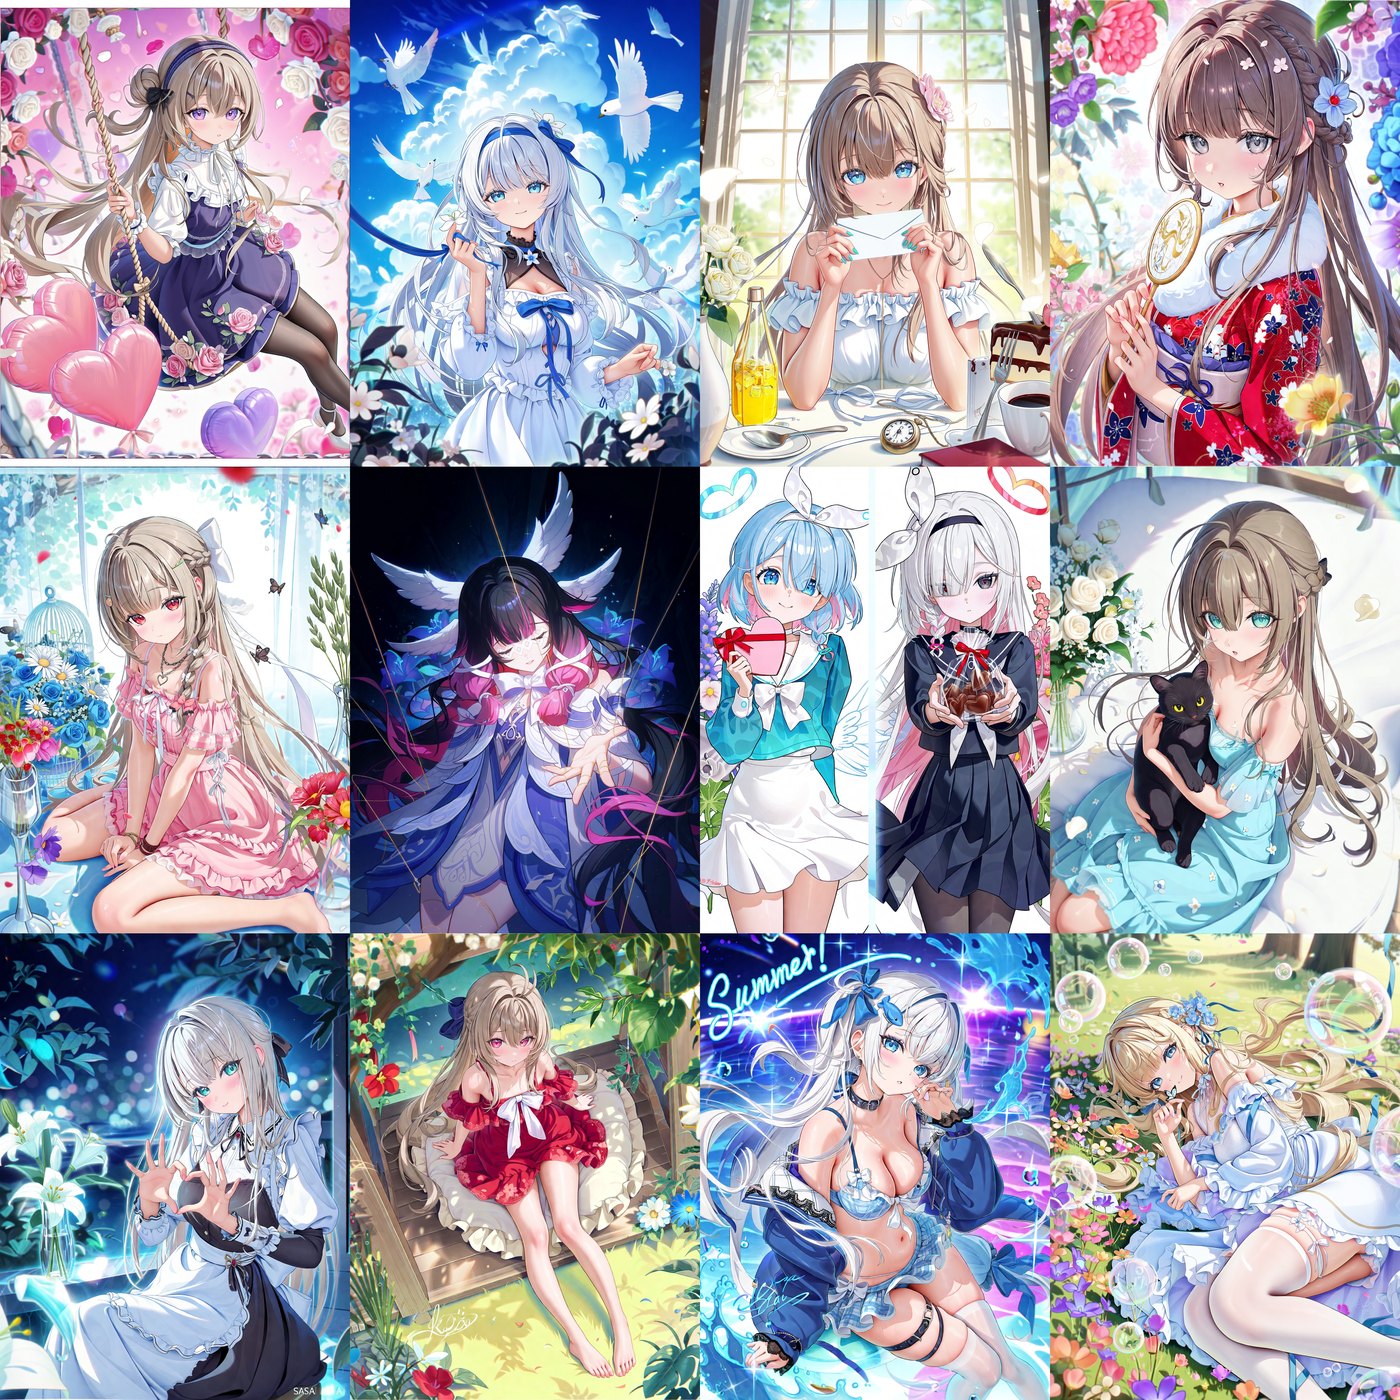
이 모델은 애니메 일러스트, 캐릭터, 스타일화된 아트를 대상으로 하며, 태그 나열보다는 서술형 문장으로 구동됩니다.
달라진 점과 달라지지 않은 점
| Anima-Light-Lavender | |
|---|---|
| 베이스 모델 | Anima-Base v1.0 (anima-base-v1.0.safetensors) |
| 아키텍처 | 변경 없음: 약 2B 파라미터, 28레이어 DiT, 추가된 레이어와 증류 없음 |
| 텍스트 인코더 | Qwen3-0.6B (qwen_3_06b_base.safetensors) |
| VAE | Qwen-Image VAE (qwen_image_vae.safetensors) |
| 가중치 | anima-light-lavender.safetensors(BF16) 및 anima-light-lavender_mxfp8.safetensors(MXFP8, 더 빠른 추론) |
| 학습 초점 | 512 토큰 규모의 자연어 설명, 그리고 더 높은 품질의 데이터 |
레이어 수, 파라미터 수, 파일 구성이 베이스 모델과 일치하므로 기존 Anima 워크플로는 체크포인트만 교체하면 됩니다.
ComfyUI에 설치하기
- 가중치 파일 하나를
ComfyUI/models/diffusion_models/에 넣습니다. BF16 또는 MXFP8 버전 중 하나만 선택하고 둘 다 넣지 마세요. - 현재 Anima 환경의 텍스트 인코더와 VAE를 그대로 재사용합니다.
qwen_3_06b_base.safetensors는ComfyUI/models/text_encoders/에,qwen_image_vae.safetensors는ComfyUI/models/vae/에 둡니다. ComfyUI/custom_nodes/안에서git clone https://github.com/aa0525/comfyui-zako-pe.git으로 동반 노드를 설치한 뒤 ComfyUI를 재시작합니다.
comfyui-zako-pe 팩은 두 개의 노드를 추가합니다. 구조화된 캡션을 조립하는 Danbooru Caption JSON, 그리고 OpenAI 호환 서버를 호출해 태그 스타일의 image_description을 자연어로 확장하는 Danbooru Prompt Extend (OpenAI)입니다. 동반 모델 zako-pe(ZAKO-V0.1)는 이 확장을 로컬에서 처리하도록 설계되었습니다.
이 릴리스에는 두 가지 워크플로가 포함되어 있으며, 둘 다 JSON 파일을 ComfyUI 캔버스로 드래그하면 불러올 수 있습니다.
두 워크플로 모두 기본값이 MXFP8 가중치입니다. 대신 BF16 파일을 설치했다면 확산 모델 로드 노드에서 체크포인트를 전환하세요.
구조화된 캡션으로 프롬프트 작성하기
이 모델은 고정된 필드로 구성된 캡션으로 학습되었으며, 설명은 산문처럼 작성합니다.
{
  "year": 2025,
  "preference_level": "best",
  "artist": [...],
  "copyright": [...],
  "character": [...],
  "image_description": "...",
  "extra_tags": [...]
}| 필드 | 용도 |
|---|---|
year | 연도 기준값, 기본 2025 |
preference_level | normal, high, very_high 또는 best(기본 best) |
artist | 작가 및 스타일 태그 |
copyright | 시리즈 또는 프랜차이즈 태그 |
character | 캐릭터 태그 |
image_description | 이미지 콘텐츠를 상세한 자연어 문장으로 작성 |
extra_tags | 보조 콘텐츠 태그 |
긴 문장을 쓰는 것이 원하는 방식이 아니라면, 기본 워크플로는 태그를 받아들이고 프롬프트 확장 노드가 이를 다시 작성하도록 합니다. 작성자가 제안하는 또 다른 방법은 이미지를 묘사하고 나머지는 모델에 맡기는 것입니다. 릴리스 노트에 따르면 품질 단어나 네거티브 프롬프트 없이도 결과가 깔끔하게 유지됩니다.
권장 설정
| 파라미터 | 값 |
|---|---|
| 샘플러 | euler |
| 스케줄러 | simple |
| 스텝 | 25 |
| CFG | 4.0 |
| 해상도 | 약 1280×1280 |
| 네거티브 프롬프트 | 비워 두기 |
학습 세부 정보
학습은 BF16으로 진행되었으며 MLP와 어텐션 행렬 곱셈에는 MXFP8 GEMM을 사용했고, 배치 크기는 1024, 최대 학습률은 4e-5였습니다. MLP와 어텐션의 2D 파라미터는 Muon(모멘텀 0.95, match_rms_adamw)으로 업데이트되었고, 나머지 파라미터는 AdamW(β 0.9 / 0.95, ε 1e-8)로 유지되었습니다. 캡션의 preference_level 등급은 약 300만 개 샘플로 학습된 선호도 모델에서 나왔으며, 학습 데이터는 2025년 11월 말까지 포함합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.