 텍스트→이미지
LoRA
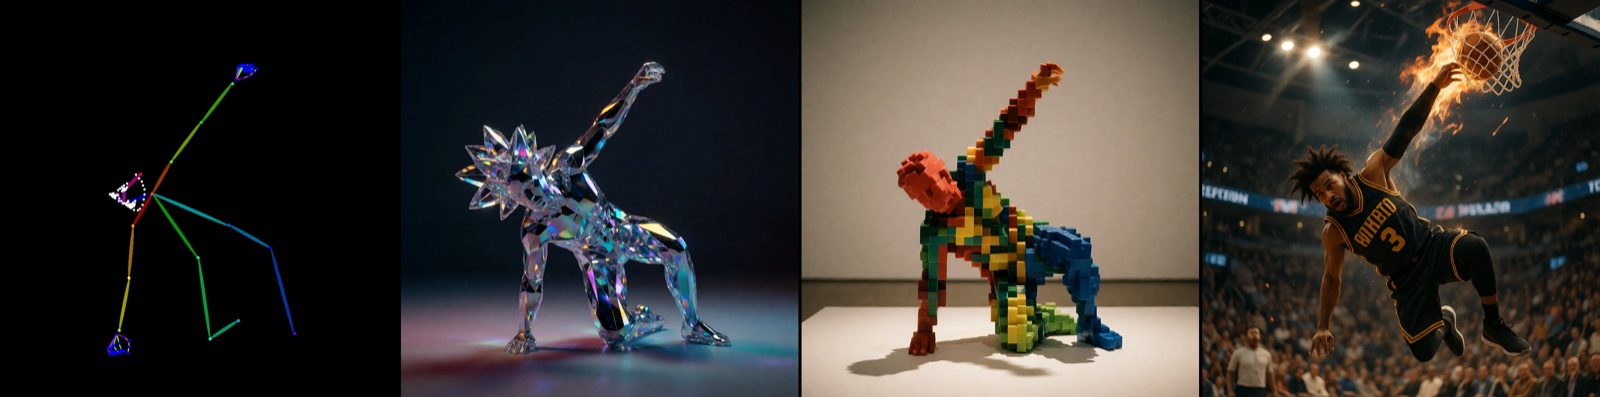
Krea 2 OpenPose 컨트롤넷 LoRA: ComfyUI 워크플로 가이드Krea 2 Turbo용 클래식 OpenPose 컨트롤넷 LoRA: DWPose 스켈레톤 맵을 입력하면 모델이 포즈를 따르고, 프롬프트가 외형을 정의합니다.
Apache-2.0
ComfyUI 생태계 소식 — 오픈소스 모델 릴리스, 커스텀 노드, 워크플로, 이미지·비디오·오디오 생성 도구 업데이트.
텍스트→이미지Krea 2 Turbo용 클래식 OpenPose 컨트롤넷 LoRA: DWPose 스켈레톤 맵을 입력하면 모델이 포즈를 따르고, 프롬프트가 외형을 정의합니다.
Apache-2.0
 비디오 편집
JD 오픈소스가 라이브 비디오 스트림을 720p 30 FPS로 실시간 편집하는 16B 오토리그레시브 diffusion 모델, JoyAI-Video-Edit를 공개했습니다.
Apache-2.0
 텍스트→비디오
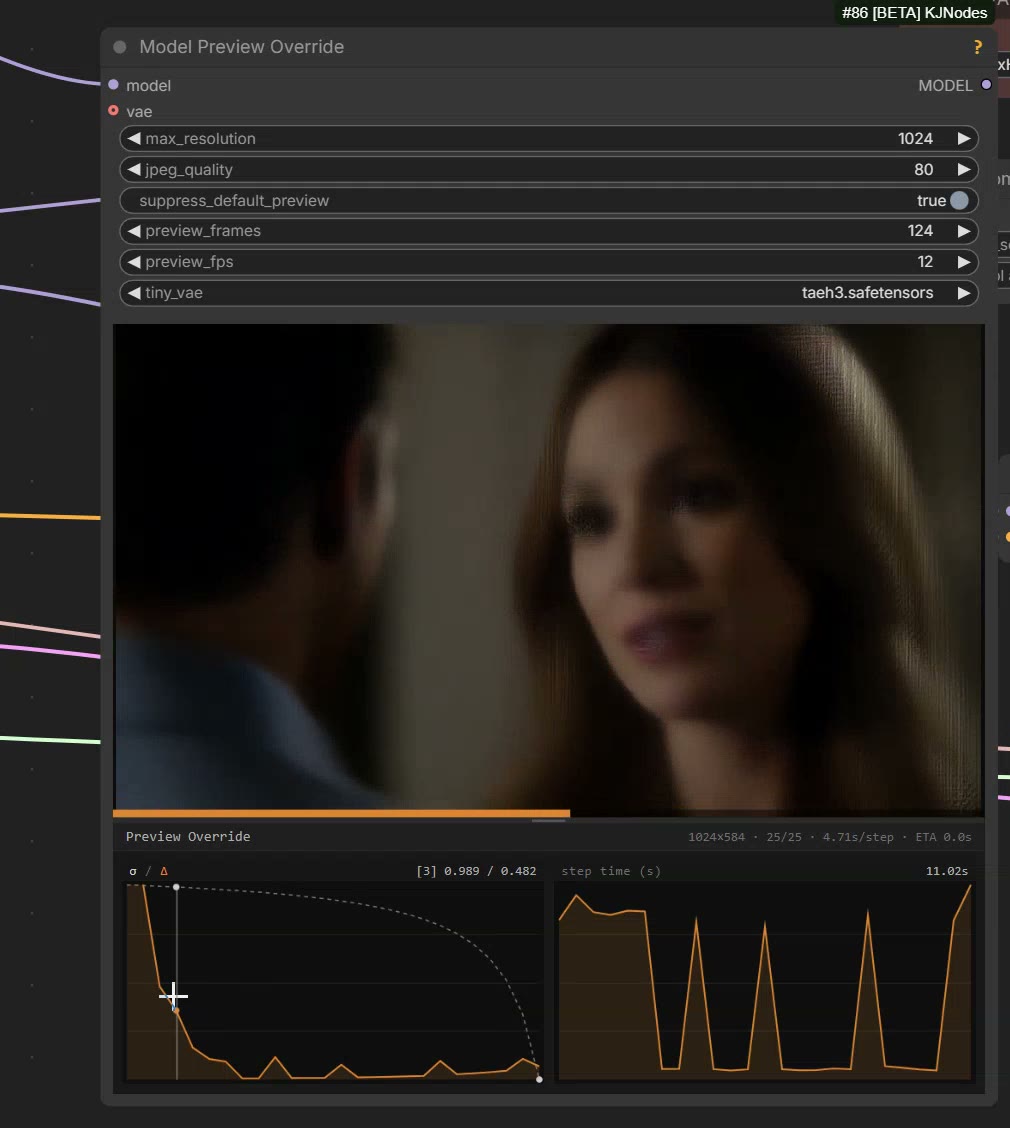
taeh3.safetensors(MiniMax H3 TAE)를 다운로드하여 ComfyUI에서 비디오를 빠르게 미리보세요. ComfyUI-KJNodes의 ModelPreviewOverride 노드에서 사용하는 소형 2D 오토인코더입니다.
 텍스트→비디오
Spectrum Apply MiniMax H3는 xmarre의 ComfyUI-Spectrum-MiniMax-H3 노드입니다. H3 transformer 평가를 건너뛰어 MiniMax H3 영상 생성을 약 30% 빠르게 하며, H3 Sigma Shift 뒤에 배치합니다.
 텍스트→비디오
ComfyUI용 MiniMax H3 커뮤니티 양자화 모델 다운로드: GGUF Q2-Q5(MiniMax-H3-FL2VA-Q3_K_M/Q4_K_M, 텍스트 인코더 GGUF), 프루닝 INT4/INT8, NVFP4 파일과 번들 워크플로우.
minimax-h3-community-license-agreement
텍스트→비디오Ostris AI Toolkit으로 MiniMax H3 LoRA를 학습하세요. T2V 및 I2V 지원, NVFP4 양자화, VAE 그래디언트 체크포인트로 소비자용 GPU에서도 실행할 수 있습니다.
Open-Weights
텍스트→비디오ComfyUI용 MiniMax H3 오픈 가중치를 다운로드하세요: FL2VA 및 Ref2VA 체크포인트, bf16, INT8, pruned, NVFP4 파일, T2V·I2V·R2V 공식 워크플로우 템플릿 6개 포함.
Open-Weights
 텍스트→이미지
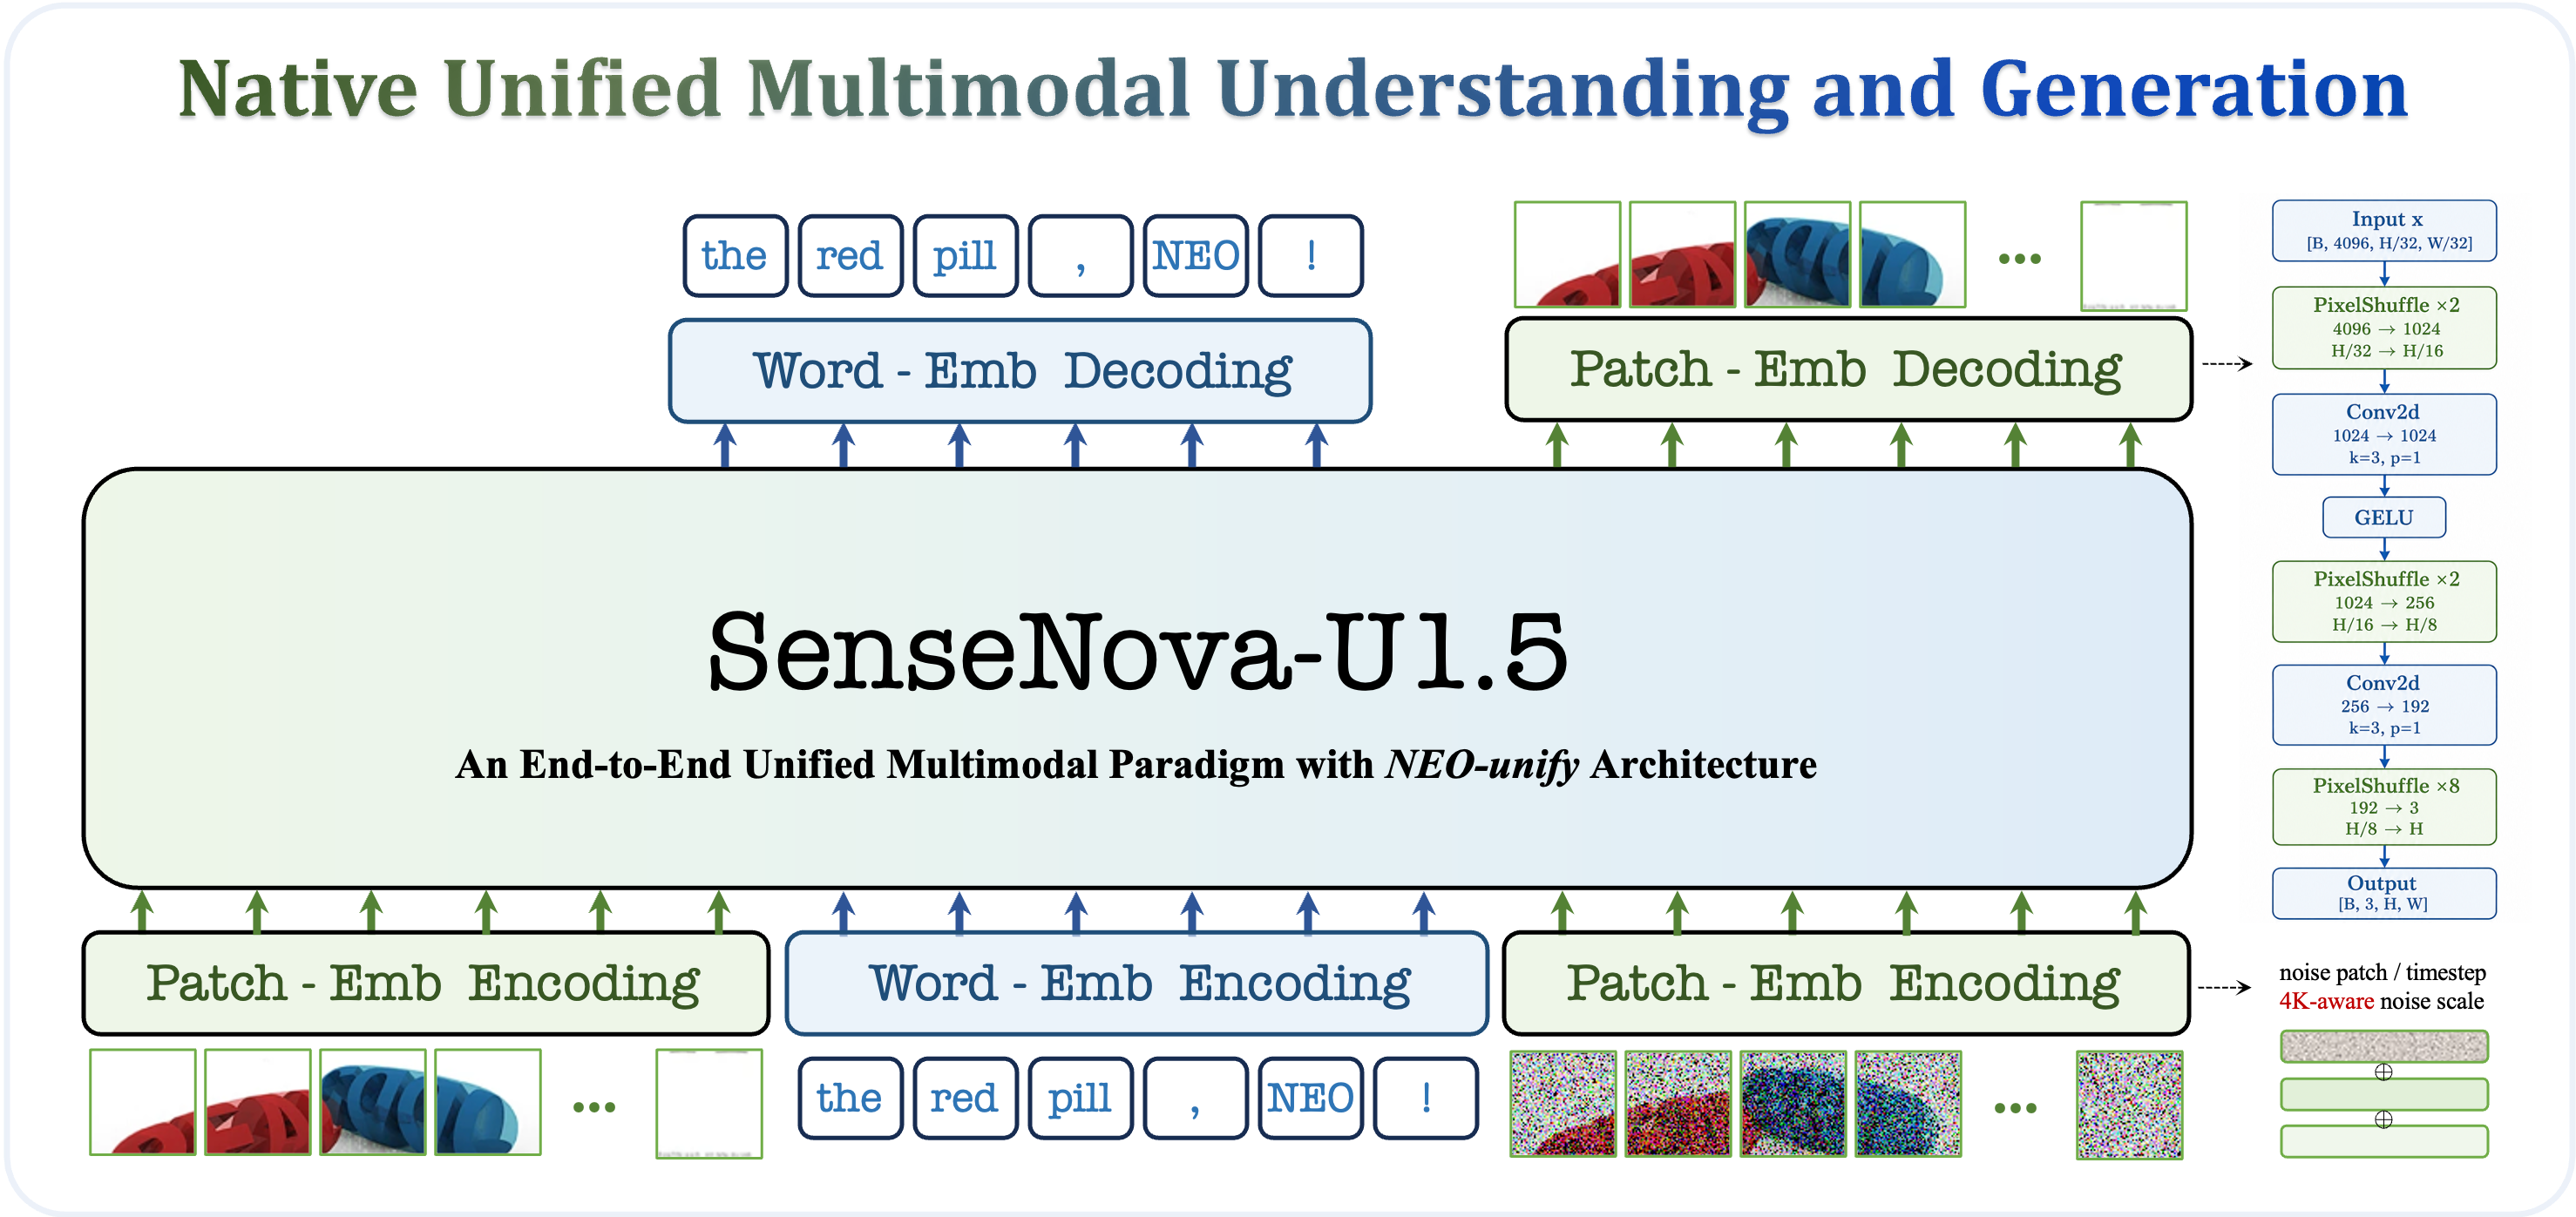
SenseTime의 SenseNova-U1.5-8B-MoT-Preview는 하나의 통합 모델에서 4K 텍스트 기반 이미지 생성과 더 강력한 이미지 편집을 제공하며, SenseNova_U1 커스텀 노드 팩을 통해 ComfyUI를 지원합니다.
Apache-2.0
 이미지 편집
캐릭터 이미지를 깔끔한 TripleView 및 QuadView 레퍼런스 시트로 변환하는 이미지 편집 LoRA 모음으로, FLUX.2 Klein 9B 및 Krea 2용 ComfyUI 워크플로가 포함되어 있습니다.
Civitai-Model-License
 텍스트→이미지
Lodestones가 Krea 2용 rank-256 ComfyUI 호환 LoRA인 Kroma v0.1을 출시했습니다. 완전히 파인튜닝된 정규화(norm) 및 변조(modulation) 델타를 포함하며 Krea 2 base와 Turbo에서 작동합니다.
MIT
텍스트→비디오MiniMax가 H3를 출시했습니다. 네이티브 스테레오 오디오, 멀티모달 컨텍스트 이해, 명령 기반 편집을 지원하며 2K 15초 클립을 생성하는 옴니모달 비디오 모델입니다.
Open-Weights
 이미지→이미지
SeedVR2-7B의 1.4B 파라미터, 6레이어 증류 버전이 저VRAM 기기에서 원스텝 4x/8x 업스케일링을 제공하며, 바로 사용 가능한 ComfyUI 커스텀 노드와 기성 워크플로를 포함합니다.
Apache-2.0
 텍스트→비디오
PrunaVAED는 LTX-2.3용 드롭인 교체 VAE 디코더로, 거의 원본 수준의 시각적 품질을 유지하면서 1.7배 더 빠른 디코딩과 약 50% 낮은 피크 VRAM을 제공합니다.
ltx-2
 비디오 편집
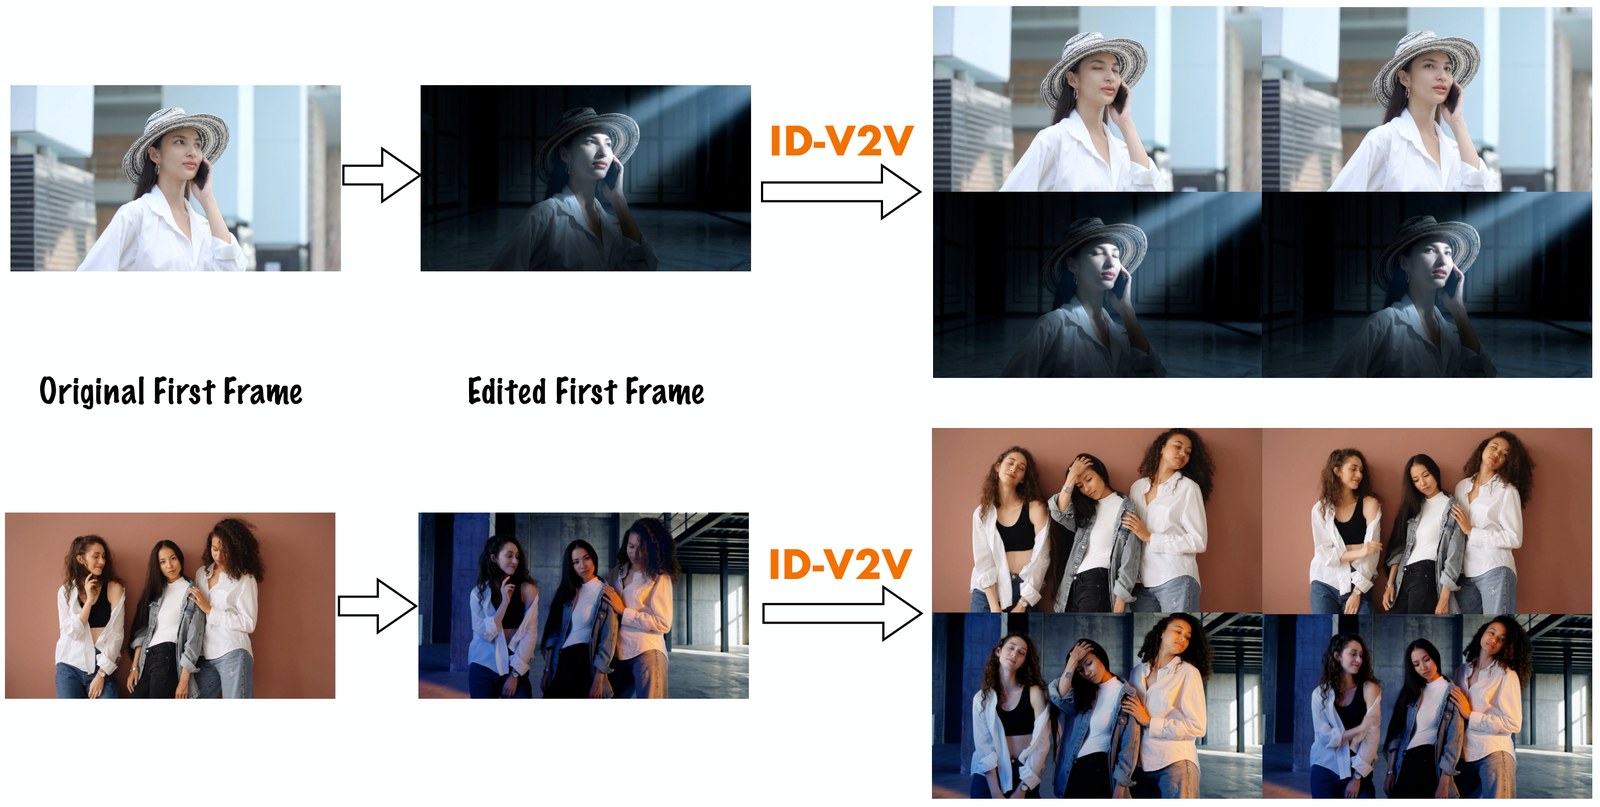
Eyeline-Labs의 ID-V2V, SIGGRAPH Asia 2026 아이덴티티 보존 비디오 기반 비디오 생성 모델이 이제 Kijai의 int8 convrot 가중치와 핵심 PR을 통해 ComfyUI를 지원합니다.
 텍스트→이미지
NVIDIA가 Qwen-Image-Flash를 공개했습니다. Qwen-Image의 4단계 DMD2 증류 버전으로 기본 아키텍처를 유지하면서 빠른 텍스트-이미지 생성을 지원합니다.
nvidia-open-model-license
 텍스트→비디오
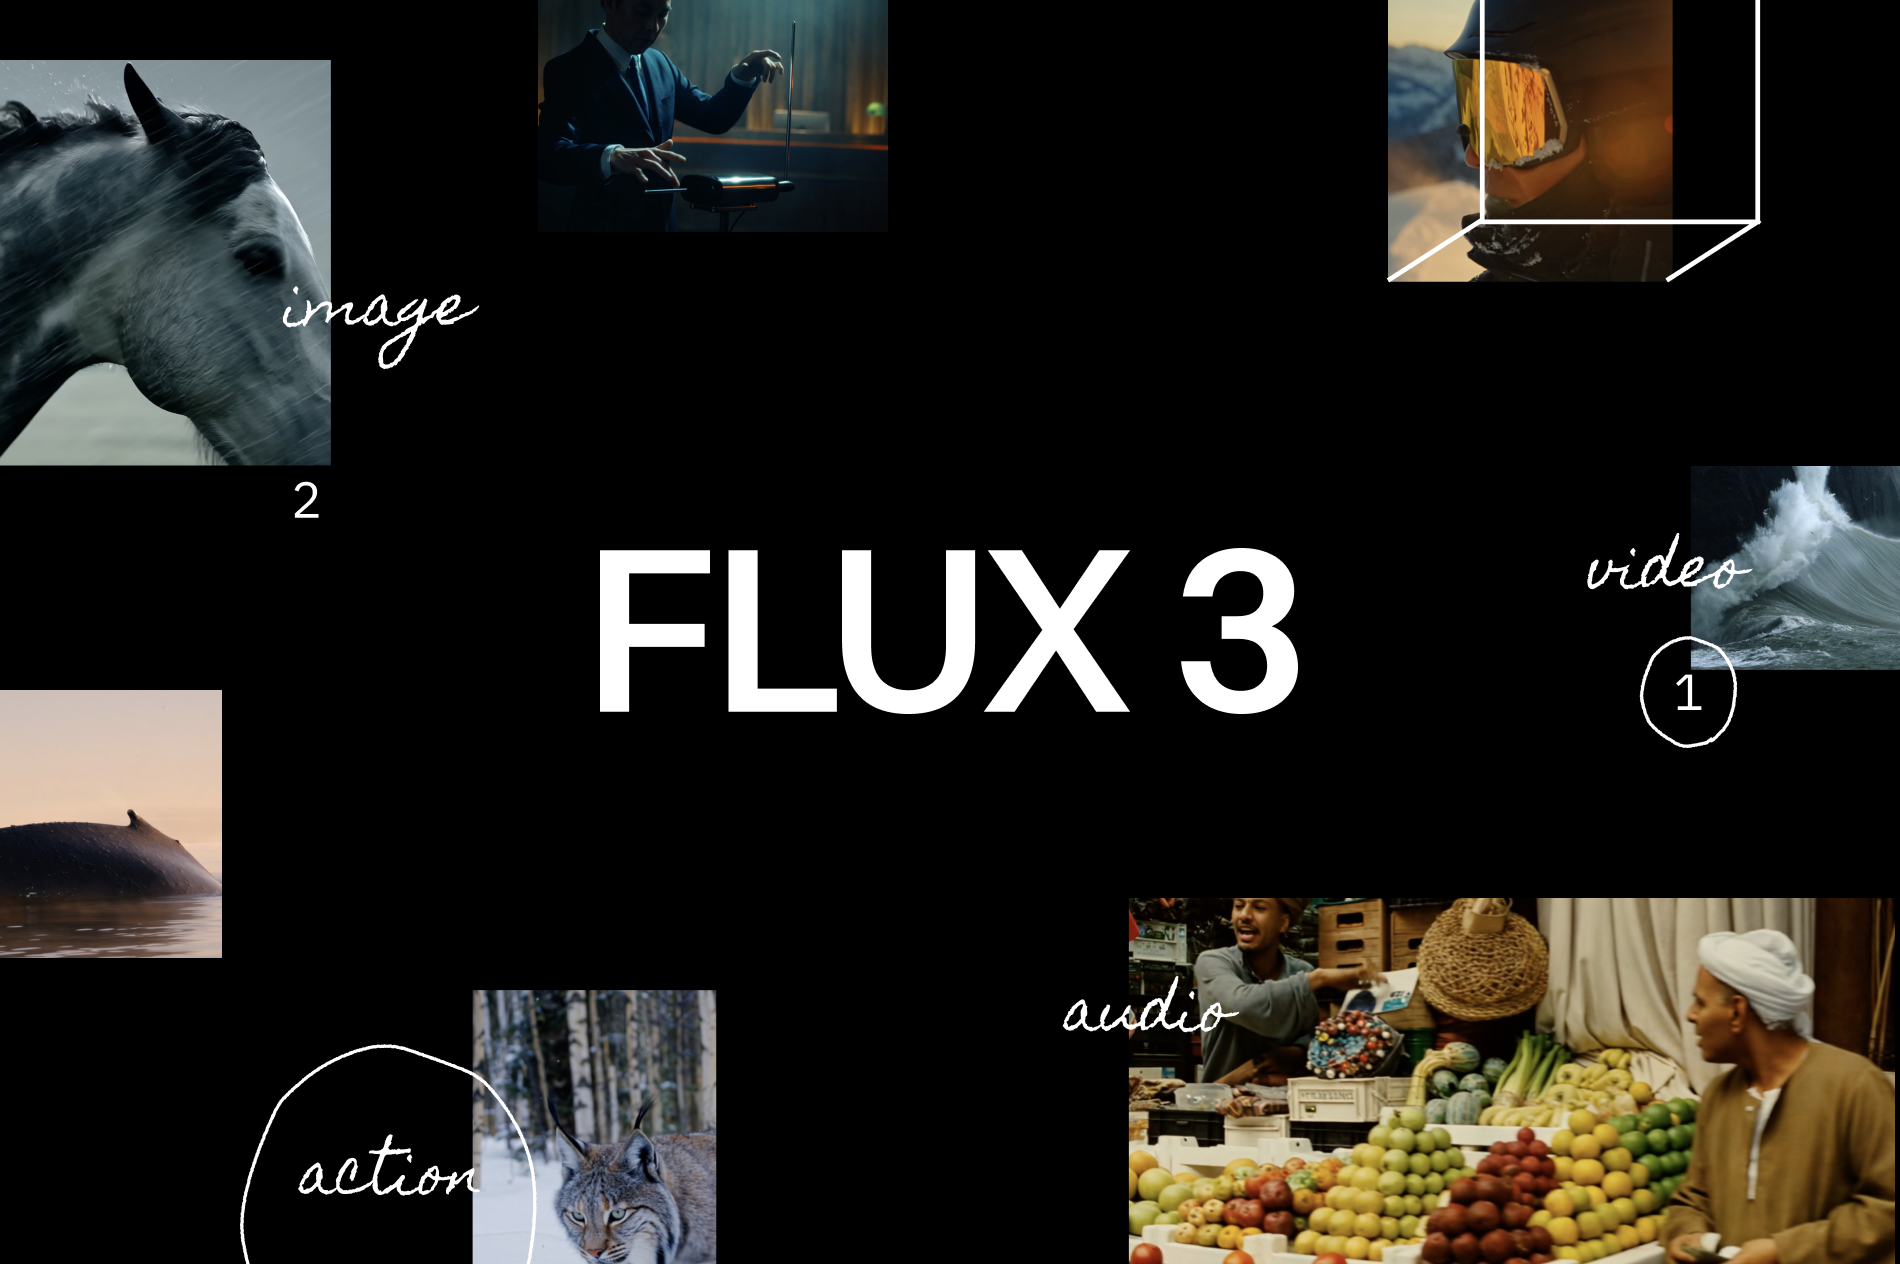
Black Forest Labs가 FLUX 3를 공개했습니다. 통합 멀티모달 기반 모델로, 네이티브 오디오가 포함된 20초 비디오, 이미지 생성, 그리고 로봇 공학을 위한 동작 예측을 수행합니다.
API-Only
 텍스트→이미지
Microsoft Asia releases Mage-Flow -- compact 4B generative stack for text-to-image and image editing, native resolution 512-2048, RL and 4-step Turbo variants, MIT license.
MIT
 텍스트→비디오
NVIDIA가 텍스트, 이미지, 작업 궤적에서 비디오, 이미지, 오디오를 생성하는 4B Mixture-of-Transformers 월드 모델인 Cosmos3-Edge를 출시했습니다. ComfyUI 커뮤니티 노드에서 사용할 수 있습니다.
OpenMDW-1.1
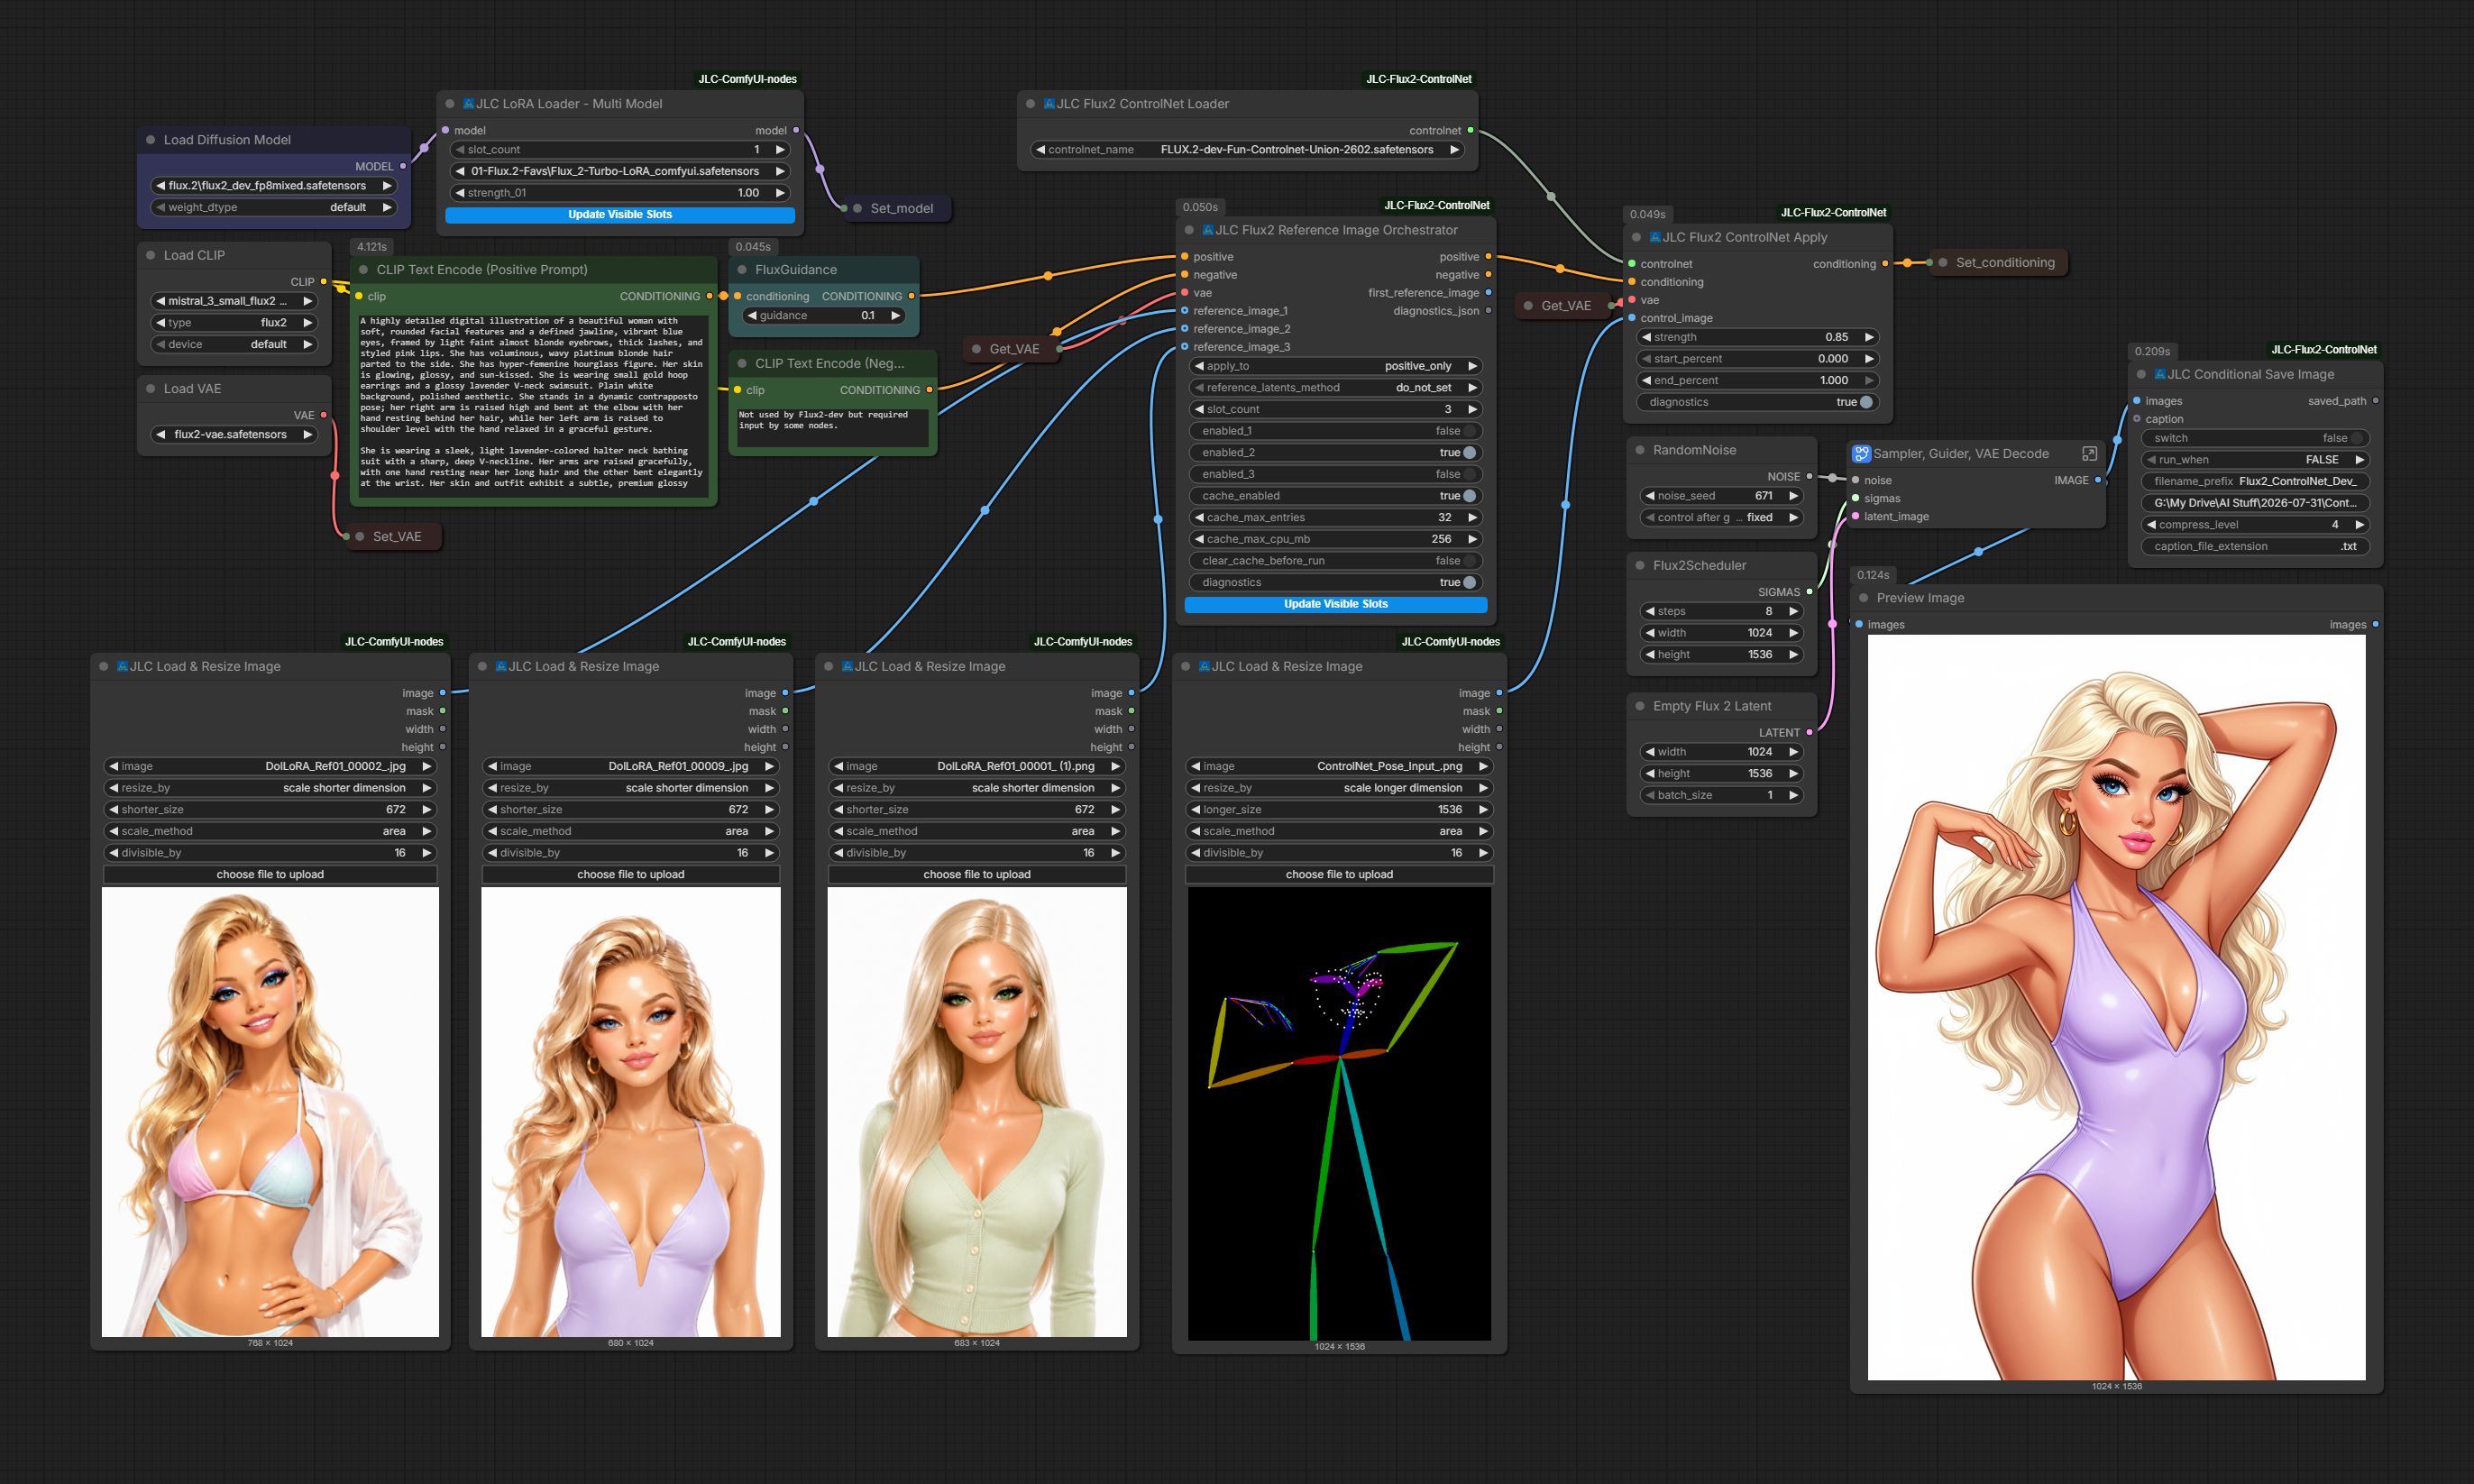 이미지→이미지
Damkohler가 JLC Flux2 ControlNet v1.0.0을 출시했습니다. FLUX.2-dev Fun ControlNet Union을 ComfyUI에 연동하는 커스텀 노드로, 멀티 브랜치 제어, 참조 조건, 인페인트/아웃페인트를 지원합니다.
 텍스트→비디오
Oasis Suite v1.5는 Image Oasis를 3개의 노드 팩으로 확장하여 노드 미리보기용 Video Oasis Viewer와 올인원 LTX 2.3 비디오 생성을 위한 LTX2.3 Oasis를 추가합니다.