MiniMax H3 Image:开放的 16 MP 图像生成与编辑模型
ComfyUI Wiki
在 ComfyUI 中运行 MiniMax-H3-Image:单个 33B checkpoint 即可完成 16 MP 文生图与编辑,支持最多 16 张引用图像,6 步采样、CFG 1。
M
MiniMax H3 Image
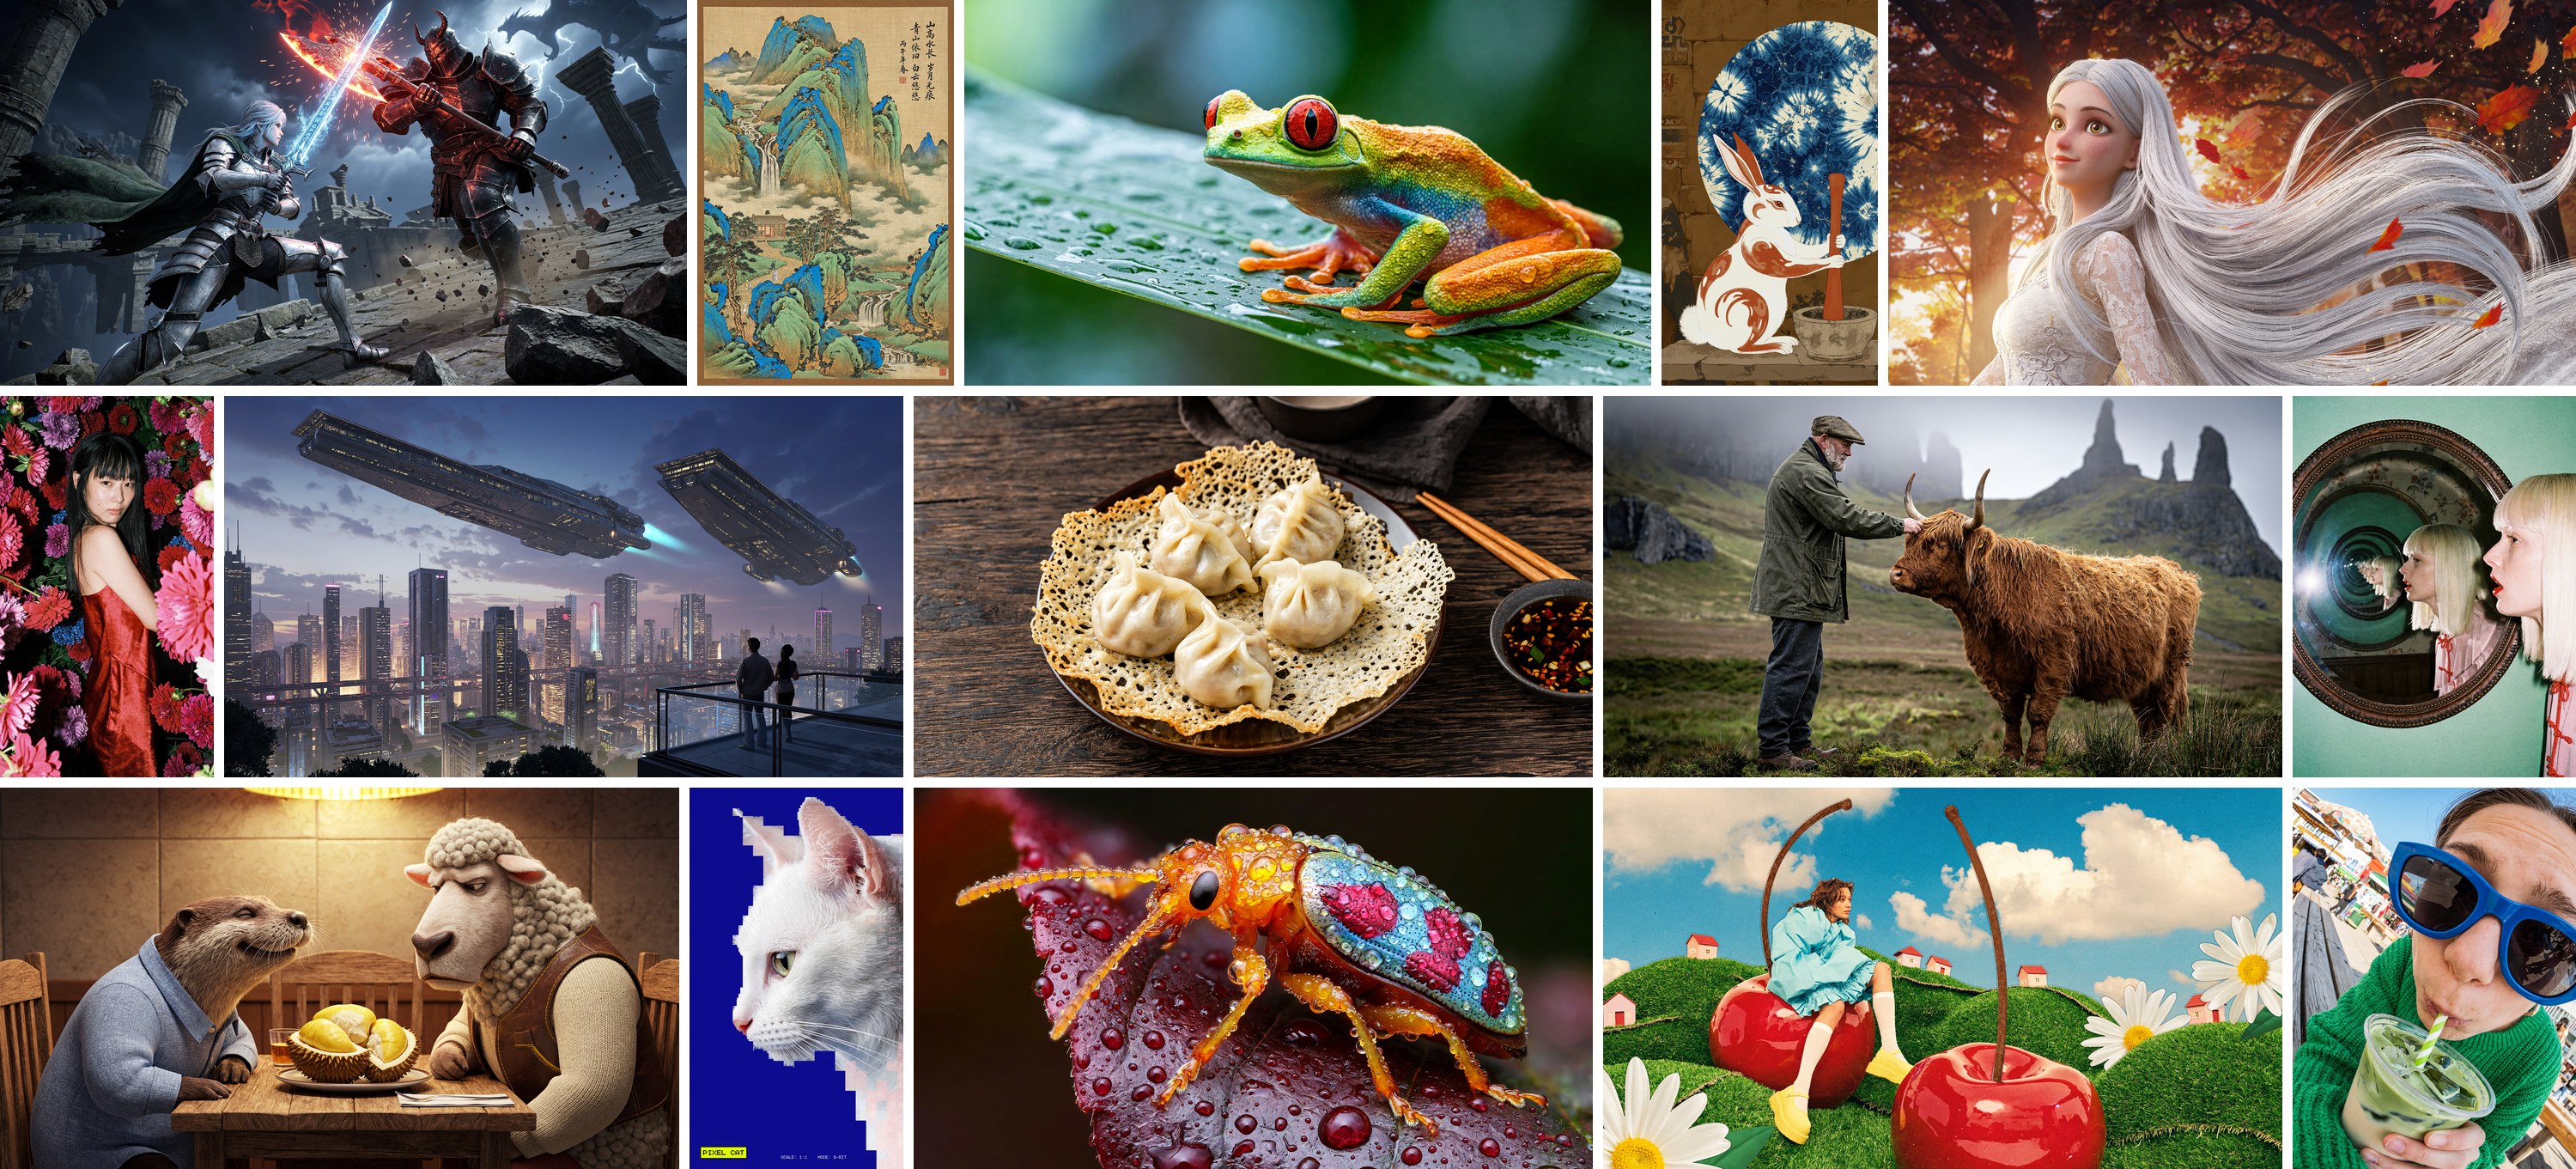
文生图图像编辑多引用16 MP6 步MiniMax-H3-Image 是 MiniMax 的开放权重图像模型。单个 33.1B checkpoint 即可在约 1600 万像素下完成文生图与多引用编辑,并蒸馏至 6 步采样、无需无分类器引导。它沿用 MiniMax H3 的 H3 扩散 Transformer,但不含音频分支,文本编码器同为 Qwen3-VL-32B。
| 开发者 | MiniMax |
| 发布日期 | 2026-11-10 |
| 架构 | 33.1B 稠密单流 DiT(H3 去掉音频图层) |
| 文本编码器 | Qwen3-VL-32B(第 50 层隐藏状态) |
| 图像 VAE | CNN 编码器搭配 2D ViT 解码器,16 倍下采样,24 个 Latent 通道 |
| 采样 | 6 步,CFG 1,无需负面提示词 |
| 许可证 | MiniMax H3 Image Community License |
MiniMax-H3-Image 在任意宽高比下都能生成约 1600 万像素(16 MP)的图像,从 4096x4096 到 6272x2688,并用同一个 checkpoint 编辑一张或多张引用图像。原生 ComfyUI 支持已于 2026-11-10 合并(Comfy-Org/ComfyUI #17655),并已包含在 v0.45.0 中。
模式
| 模式 | 输入 | 说明 |
|---|---|---|
| 文生图 | 一段详细的英文描述 | 有效范围 4 MP 至 20 MP,16 MP 附近效果最佳 |
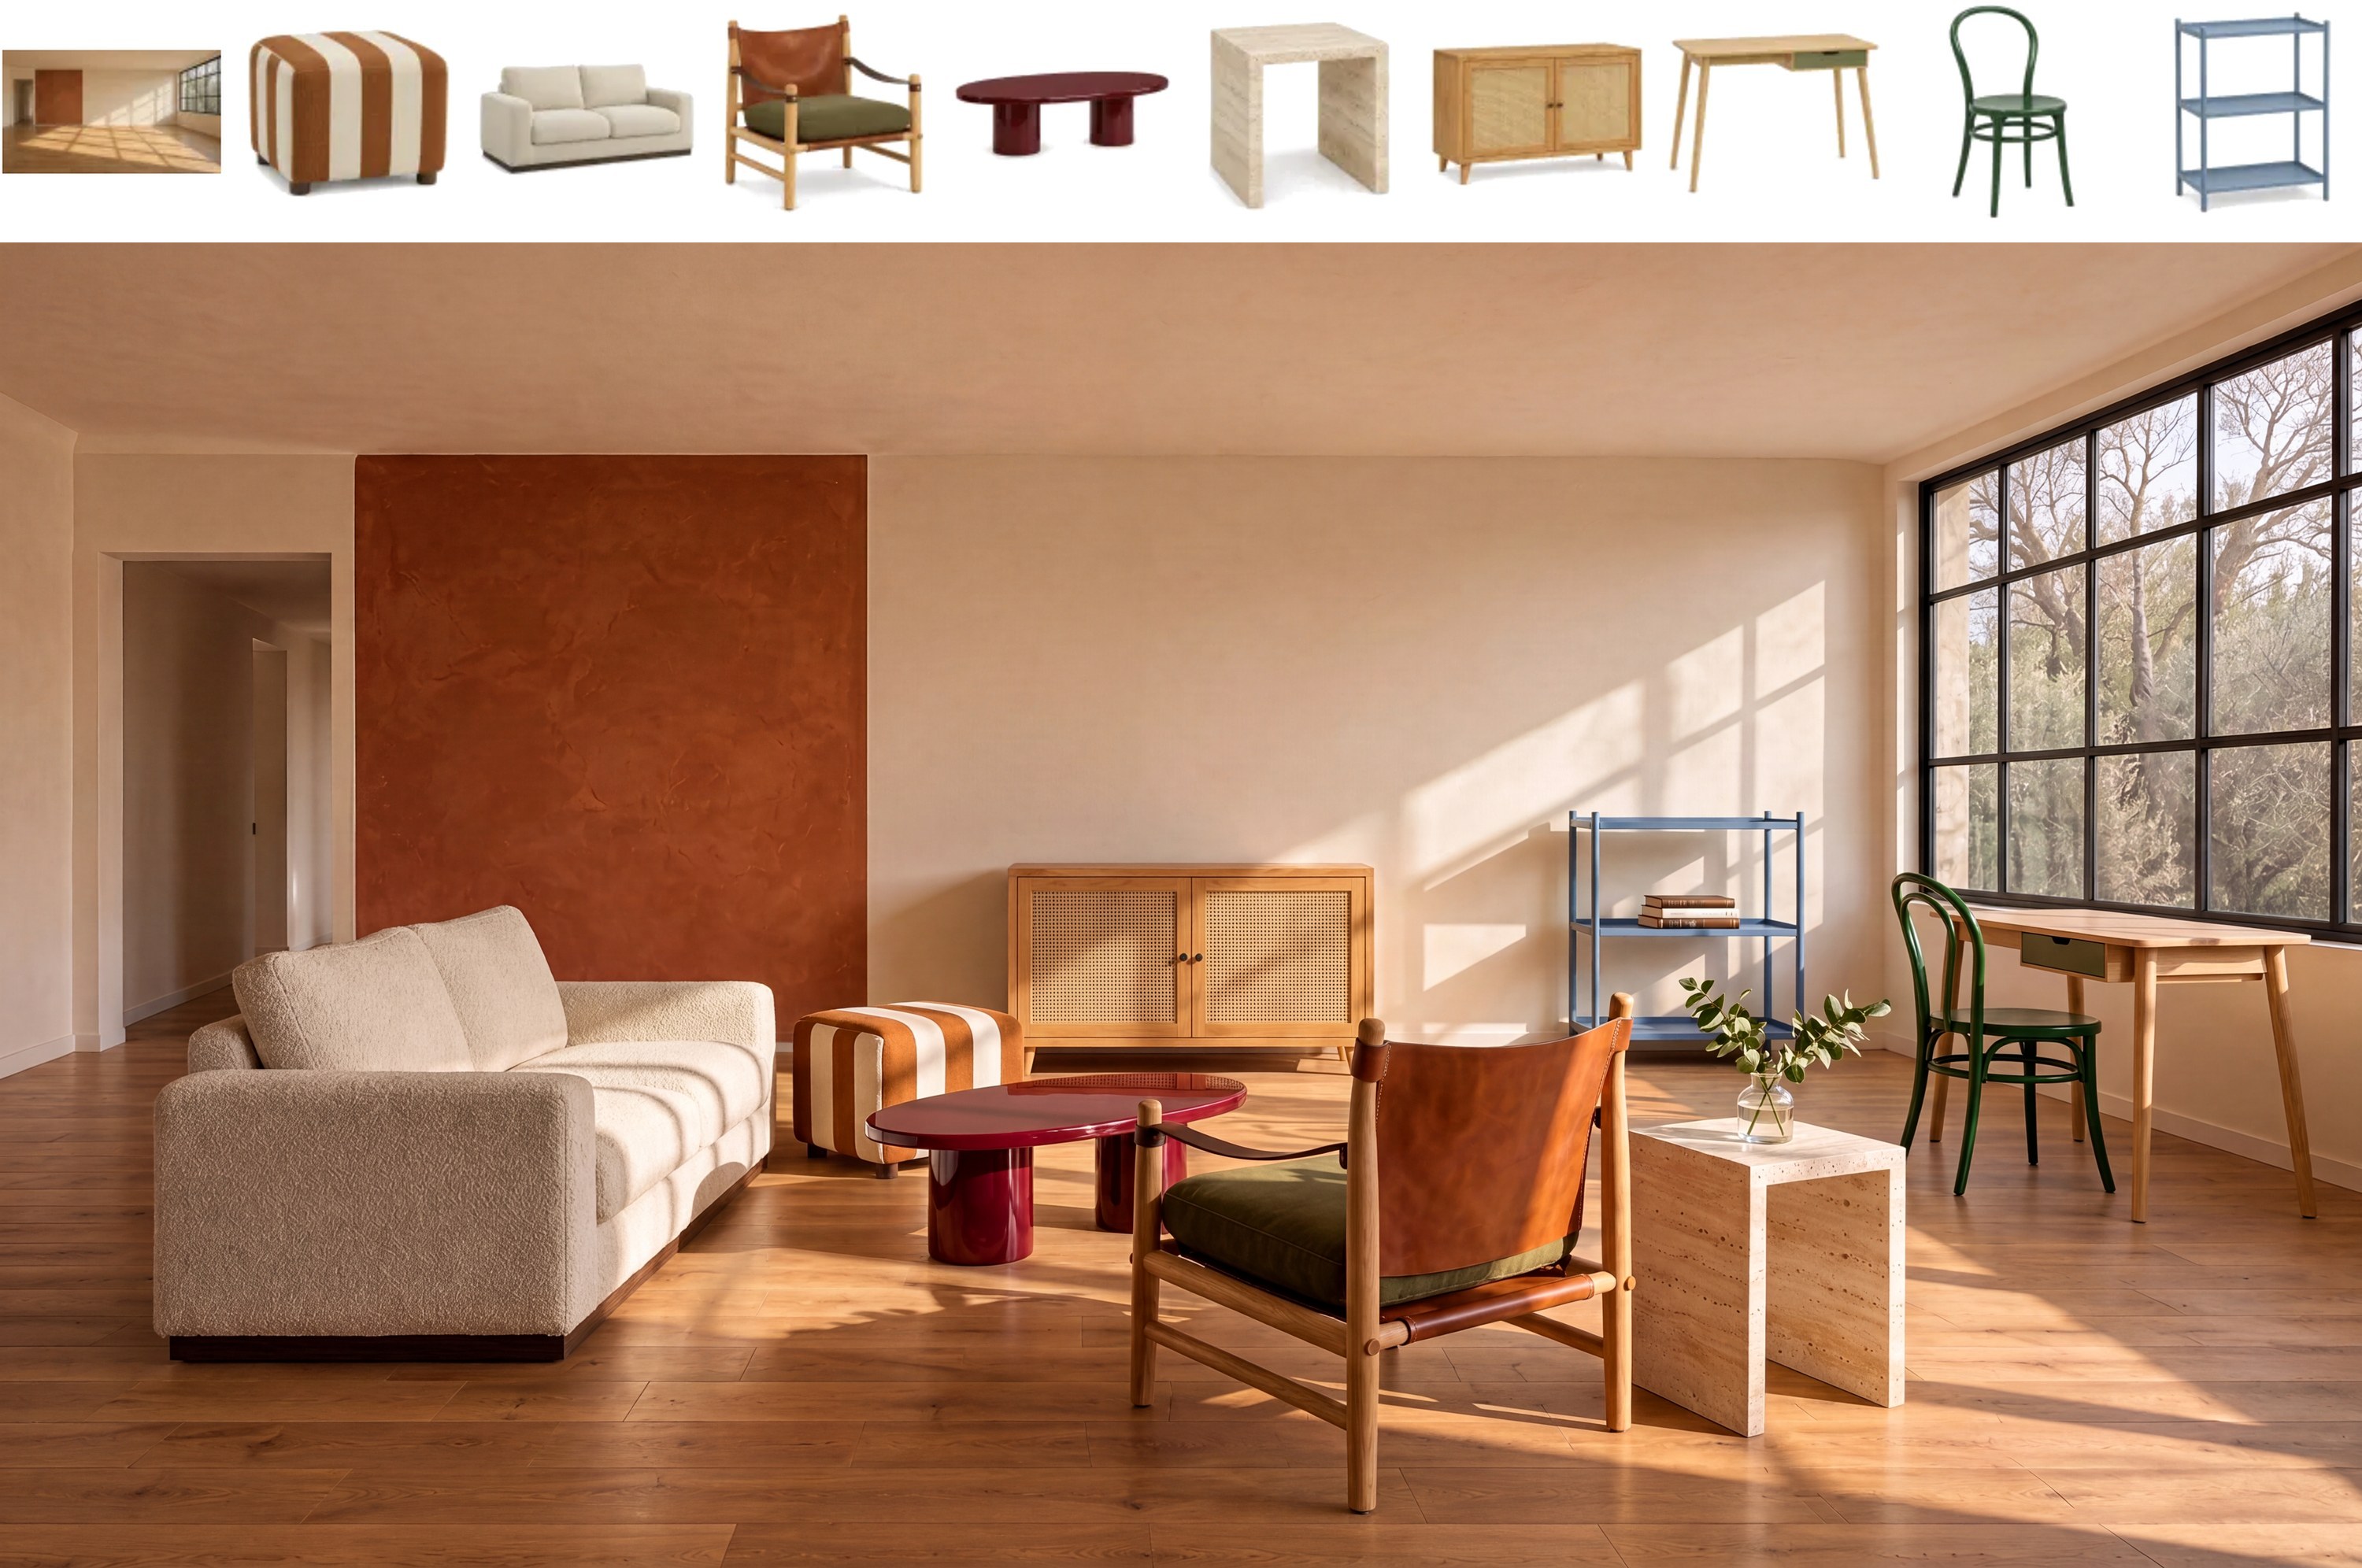
| 图像编辑 | 1 至 16 张引用图像,以 Picture 1、Picture 2… 指代 | 使用相同权重,无需单独的编辑 checkpoint |
模型需要详细的英文描述文本。MiniMax 托管的 H3-Image-Context-IR 可以把简短提示词转写成这样的描述;可选的 MiniMax-H3-Image-PE 提示词扩展器(17.9 GB NVFP4)可在本地完成同样工作,而官方 ComfyUI 模板则通过 Generate Text 使用一个 9B Qwen3.5 扩展器。
ComfyUI
- 节点:
MiniMax H3 Image Conditioning(image/conditioning),可选的vae输入会同时把这些图片锚定为引用 Latent。 - 模板:模板浏览器中的
image_minimax_h3_image_t2i和image_minimax_h3_image_edit。 - 两个模板的采样器设置:6 步,CFG 1。默认画布为 4 MP;显卡允许时可以提高。
资源
- ComfyUI 教程(官方文档)
- MiniMax H3 Image 开放权重新闻
- MiniMax H3 模型页面(视频同系列模型,使用相同的文本编码器)
Guides and workflows related to this model series.
No articles found.
评论
使用 GitHub 登录后即可参与讨论。