MiniMax:开放视频与音乐生成模型
ComfyUI Wiki
MiniMax 在 ComfyUI 中提供的开放生成模型:带原生 32 kHz 立体声音频的全模态 H3 视频模型,以及可生成长达五分钟完整歌曲的 Music 3。
M
MiniMax H3
视频生成原生音频全模态文生视频图生视频MiniMax H3 是一个开放的通用全模态生成系统,能够理解由文本、图像、视频和音频构成的多模态上下文,并在单次生成中输出最长 15 秒、带原生 32 kHz 立体声音频的视频。它是 MiniMax Hailuo 视频系列的最新模型,由 33.1B 稠密单流全模态 Transformer 驱动,并配备 Qwen3-VL-32B 文本编码器。
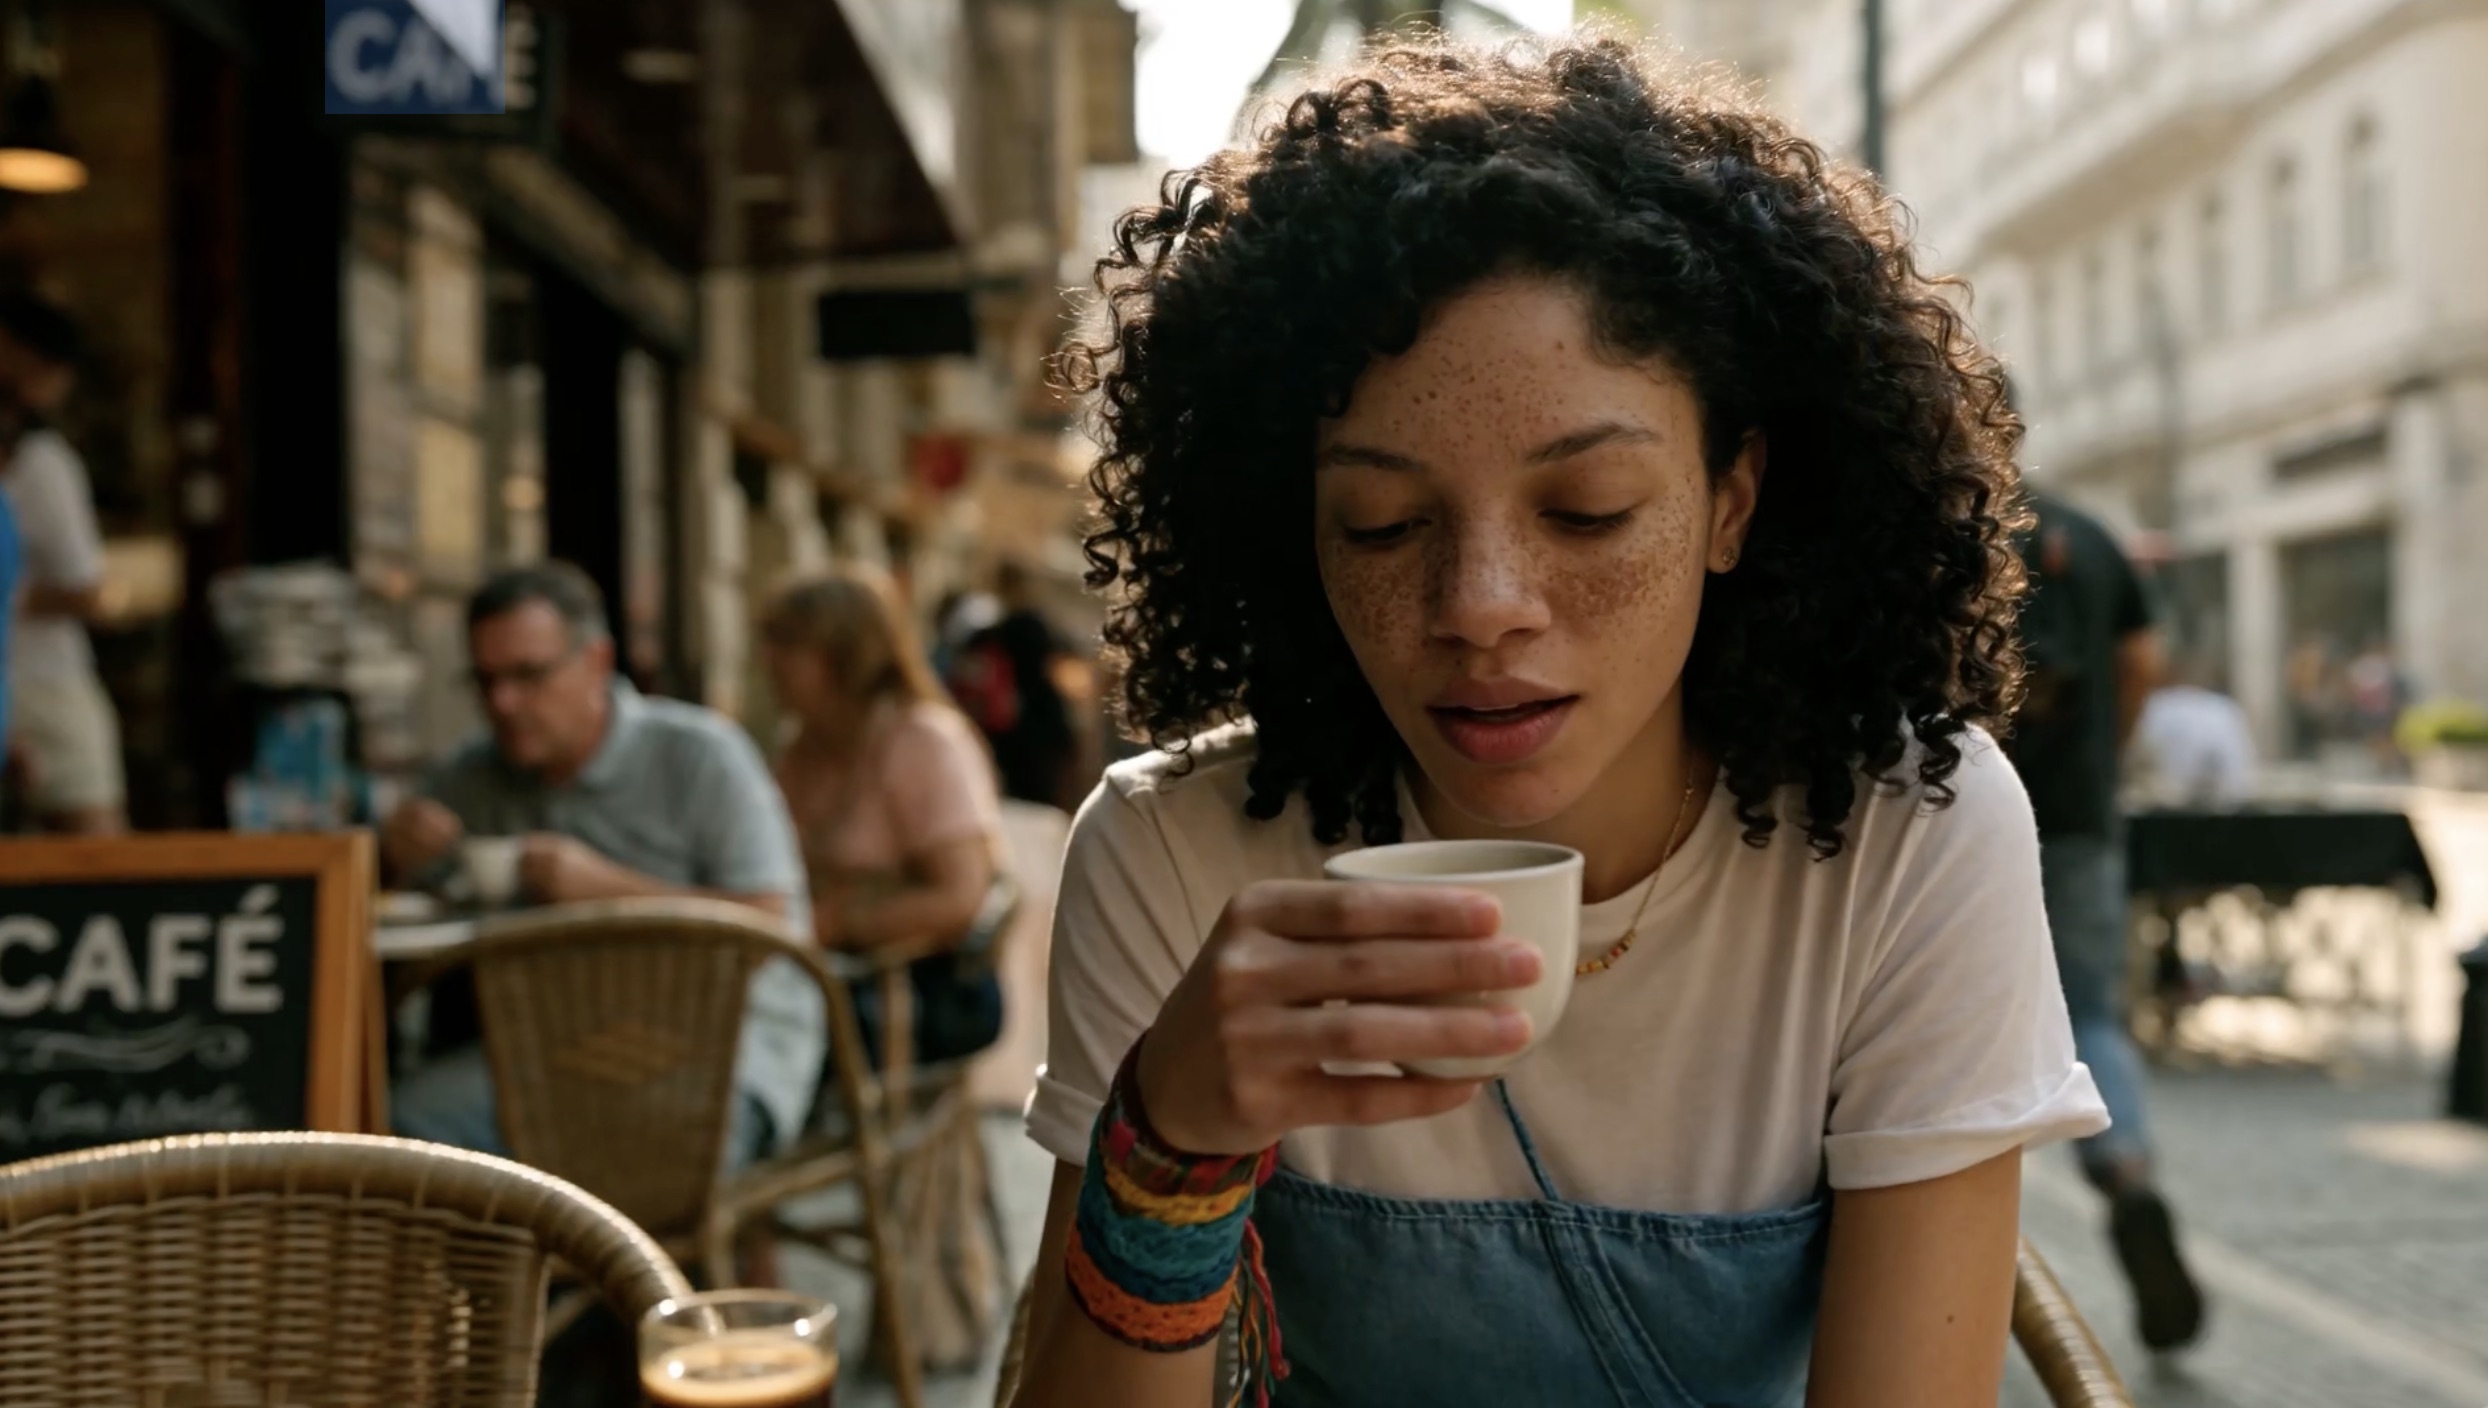
来自 MiniMax 官方 H3 多模态上下文演示的示例输入图像
MiniMax H3 于 2026 年 8 月 3 日根据 MiniMax H3 社区许可协议正式开源。本次开源涵盖 H3-Base 的两个任务专用 checkpoint:FL2VA(文生视频与首/尾帧条件生成)和 Ref2VA(基于参考的生成)。H3-Context-IR 预处理系统与 H3-Regenerate-2K 放大模块仍以托管 API 形式提供。
模型
| 模型 | 类型 | 描述 | 许可证 | 发布时间 |
|---|---|---|---|---|
| MiniMax H3 | 视频 | 带原生 32 kHz 立体声音频的全模态视频生成 | MiniMax H3 社区许可证 | 2026-08 |
| MiniMax Music 3 | 音乐 | 根据歌词和音乐描述生成长达五分钟的完整歌曲 | MiniMax Music 3 社区许可证 | 2026-09 |
在上方选择模型,即可获取精选权重下载、教程及相关信息。
版本
| 版本 | 说明 |
|---|---|
| H3-Base FL2VA | 文生视频、首帧、尾帧、首尾帧模式 |
| H3-Base Ref2VA | 基于最多 9 张图像、3 段视频和 3 段音频片段的参考生成 |
主要能力
- 原生立体声音频:与画面在同一次生成中输出 32 kHz 立体声,无需单独的音频模型
- 多模态上下文:可将文本、图像、视频和音频的任意组合作为输入
- 2K 上下文内再生成:H3-Regenerate-2K 复用原始上下文,将 768p 输出重新生成为 2K
- 11 种语言:ar、zh、en、fr、de、it、ja、ko、pt、ru、es
- 部署方式:SGLang、vLLM、diffusers 和 ComfyUI
安装
MiniMax H3 在 ComfyUI 中为原生支持。将文件放入对应目录:
| 文件 | 目标目录 |
|---|---|
minimax_h3_*_bf16.safetensors 或 *_int8_convrot.safetensors | ComfyUI/models/diffusion_models/ |
qwen3vl_32b_minimax_h3_*.safetensors | ComfyUI/models/text_encoders/ |
minimax_h3_video_vae_fp16.safetensors | ComfyUI/models/vae/ |
minimax_h3_audio_vae_fp32.safetensors | ComfyUI/models/vae/ |
官方 ComfyUI 重打包仓库(Comfy-Org/MiniMax-H3)提供 bf16、INT8 convrot 和 pruned INT8 扩散模型变体,以及 bf16、INT8 和 NVFP4 AWQ 文本编码器选项。得益于预计算的 adaLN 曲线表,pruned INT8 checkpoint 的体积约小 40%,而 NVFP4 AWQ 文本编码器可在任意 GPU 上运行。
评论
使用 GitHub 登录后即可参与讨论。