JoyAI Image Edit от JD Open Source теперь работает нативно в ComfyUI. Редактирование одного и нескольких изображений по текстовой инструкции с пространственным контролем, форматы BF16 и INT8.
Apache-2.0
Новости экосистемы ComfyUI: релизы открытых моделей, пользовательские ноды, рабочие процессы и инструменты для генерации изображений, видео и аудио.
JoyAI Image Edit от JD Open Source теперь работает нативно в ComfyUI. Редактирование одного и нескольких изображений по текстовой инструкции с пространственным контролем, форматы BF16 и INT8.
Apache-2.0
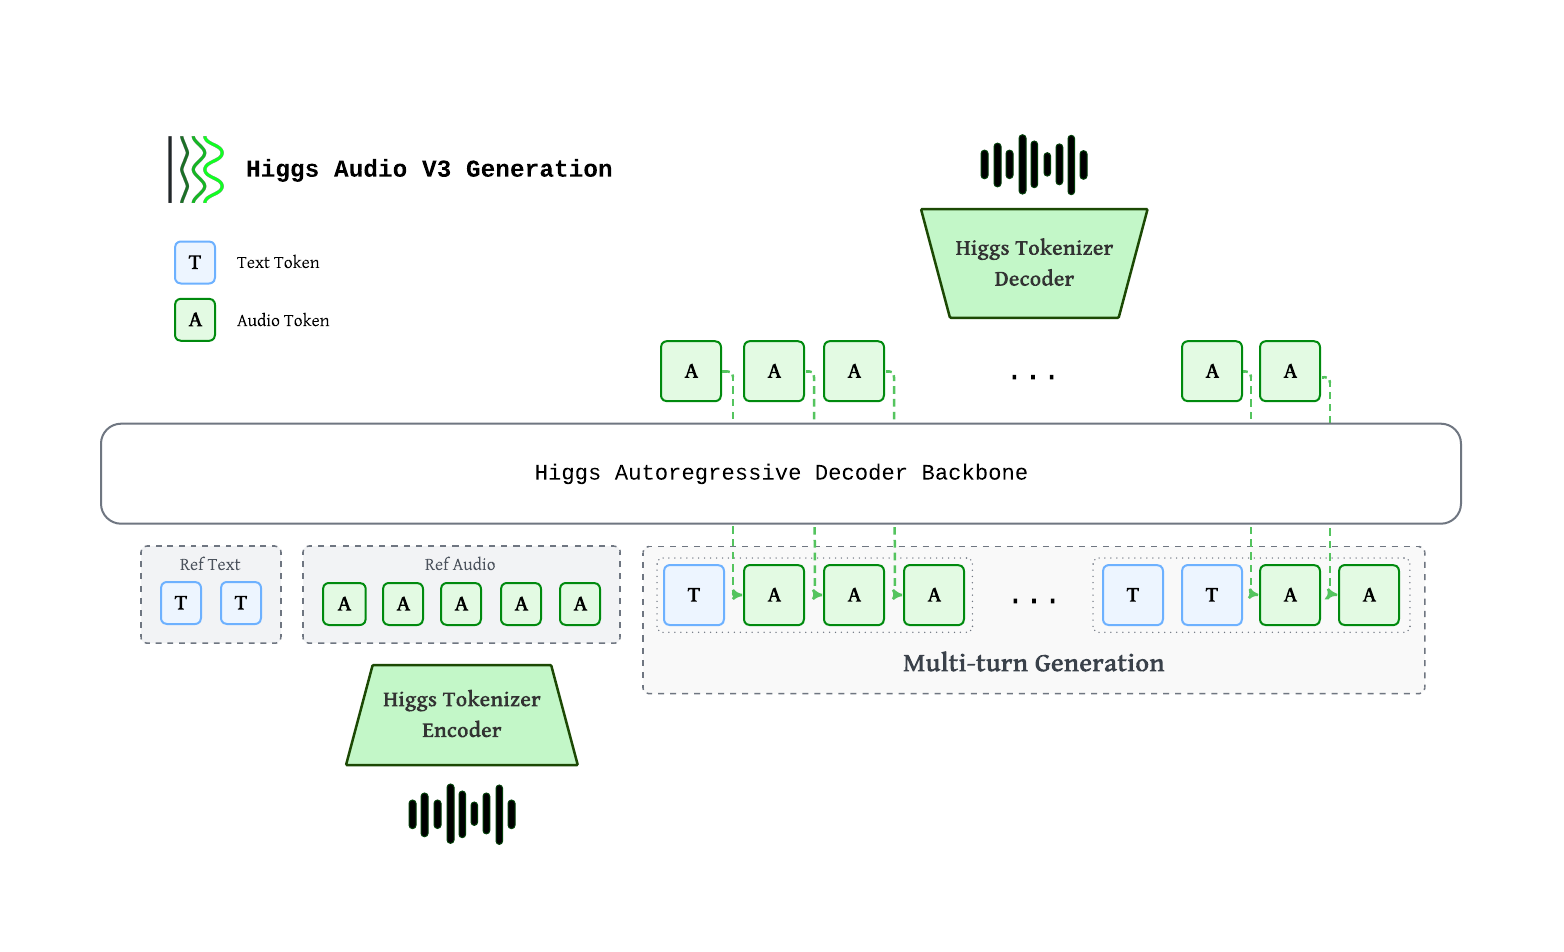
Синтез речиHiggs TTS 3: это модель преобразования текста в речь с 4 млрд параметров, поддерживающая более 100 языков, с клонированием голоса без обучения, выразительным контролем эмоций и встроенными эффектами просодии и звуков для голосовых агентов.
Open-Weights
Meituan обновляет LongCat-Video-Avatar до 1.5: липсинк на базе Whisper-Large, дистилляция DMD2 до 8 шагов и поддержка нескольких аудиодорожек, плюс кастомные ноды ComfyUI.
MIT
Текст → видеоSulphur 2 — это созданная сообществом доработка LTX 2.3, предлагающая генерацию видео из текста и изображения со встроенным улучшателем промптов и дистиллированной LoRA, обученная на 125K+ отобранных клипов.
Open-Weights
Команда OpenMOSS выпускает MOVA (MOSS Video and Audio) - фундаментальную модель сквозной синхронизированной генерации видео и аудио, которая генерирует видео и аудио за один проход вывода, обеспечивая точную синхронизацию губ и осознанные окружением звуковые эффекты, полностью открывая веса модели, код обучения и вывода
Open-Weights
Alibaba Tongyi Lab выпускает Z-Image-Base, недистиллированную базовую модель серии Z-Image, сохраняющую полный генеративный потенциал и предоставляющую идеальную основу для тонкой настройки сообществом и индивидуальной разработки
Open-Weights
DeepSeek публикует в открытом доступе DeepSeek-OCR-2, представляя новый визуальный кодировщик DeepEncoder V2, который имитирует логику человеческого чтения через механизм визуального причинного потока, достигая точности 91.09% на OmniDocBench v1.5
Open-Weights
Moonshot AI официально выпускает Kimi K2.5, нативную мультимодальную агентную модель с 1T параметрами, предварительно обученную на примерно 15 триллионах смешанных визуальных и текстовых токенов, поддерживающую понимание изображений и видео с механизмом автономной совместной работы Agent Swarm
Open-Weights
ACE Studio и StepFun выпускают ACE-Step 1.5 — открытую модель для генерации музыки, создающую полноценные песни за секунды, с официальной поддержкой ComfyUI.
Apache-2.0
Alibaba Qwen публикует в открытом доступе серию моделей генерации голоса Qwen3-TTS, достигая сверхнизкой задержки 97мс через моделирование Dual-Track, поддерживая клонирование голоса за 3 секунды и дизайн голоса на естественном языке, охватывая 10 основных языков
Open-Weights
Microsoft публикует в открытом доступе VibeVoice-ASR, унифицированную модель распознавания речи с 9B параметрами, способную обрабатывать до 60 минут аудио за один проход, совместно завершая распознавание, диаризацию говорящих и генерацию временных меток в одном процессе вывода
Open-Weights
NVIDIA публикует в открытом доступе PersonaPlex-7B-v1, модель полнодуплексного голосового диалога с 7 миллиардами параметров на основе архитектуры Moshi, поддерживающую одновременное прослушивание и речь, естественные прерывания и настройку ролей с задержкой ответа на прерывания всего 240 миллисекунд
Open-Weights
Текст → видеоСоздавайте видео бесконечной длины в ComfyUI с SVI 2.0 Pro и Wan 2.2. Включает модели LoRA HIGH и LOW для длинного AI-видео. Скачайте workflow.
Редактирование изображенийQwen-Image-Layered может разлагать изображения на несколько RGBA слоев, каждый слой можно редактировать независимо, не затрагивая другой контент, поддерживая операции перекрашивания, замены, удаления, изменения размера и перемещения
Open-Weights
Изображение → 3DMicrosoft представляет TRELLIS.2, большую генеративную 3D модель с 4 миллиардами параметров, которая преобразует изображения в высококачественные 3D-ресурсы за секунды, с полными PBR материалами и поддержкой сложных топологий
Open-Weights
Команда Университета Цинхуа выпускает в открытый доступ TurboDiffusion, фреймворк ускорения генерации видео, который достигает 100-205x ускорения сквозной генерации диффузии на одной RTX 5090 при сохранении качества видео
Команда Alibaba Cloud PAI выпускает Z-Image-Turbo-Fun-Controlnet-Union, модель ControlNet с поддержкой нескольких условий управления, включая Canny, HED, Depth, Pose и MLSD, обученная на разрешении 1328
Open-Weights
Текст → изображениеКоманда AIDC-AI от Alibaba выпустила Ovis-Image — модель преобразования текста в изображение с 7B параметрами, специализирующуюся на высококачественном рендеринге текста и показывающую отличные результаты на нескольких бенчмарках
Open-Weights
Alibaba Tongyi Lab выпустила Z-Image-Turbo — эффективную модель генерации изображений с 6B параметрами, которая создаёт качественные изображения всего за 8 шагов сэмплирования и работает на потребительских GPU с 16 ГБ видеопамяти
Open-Weights
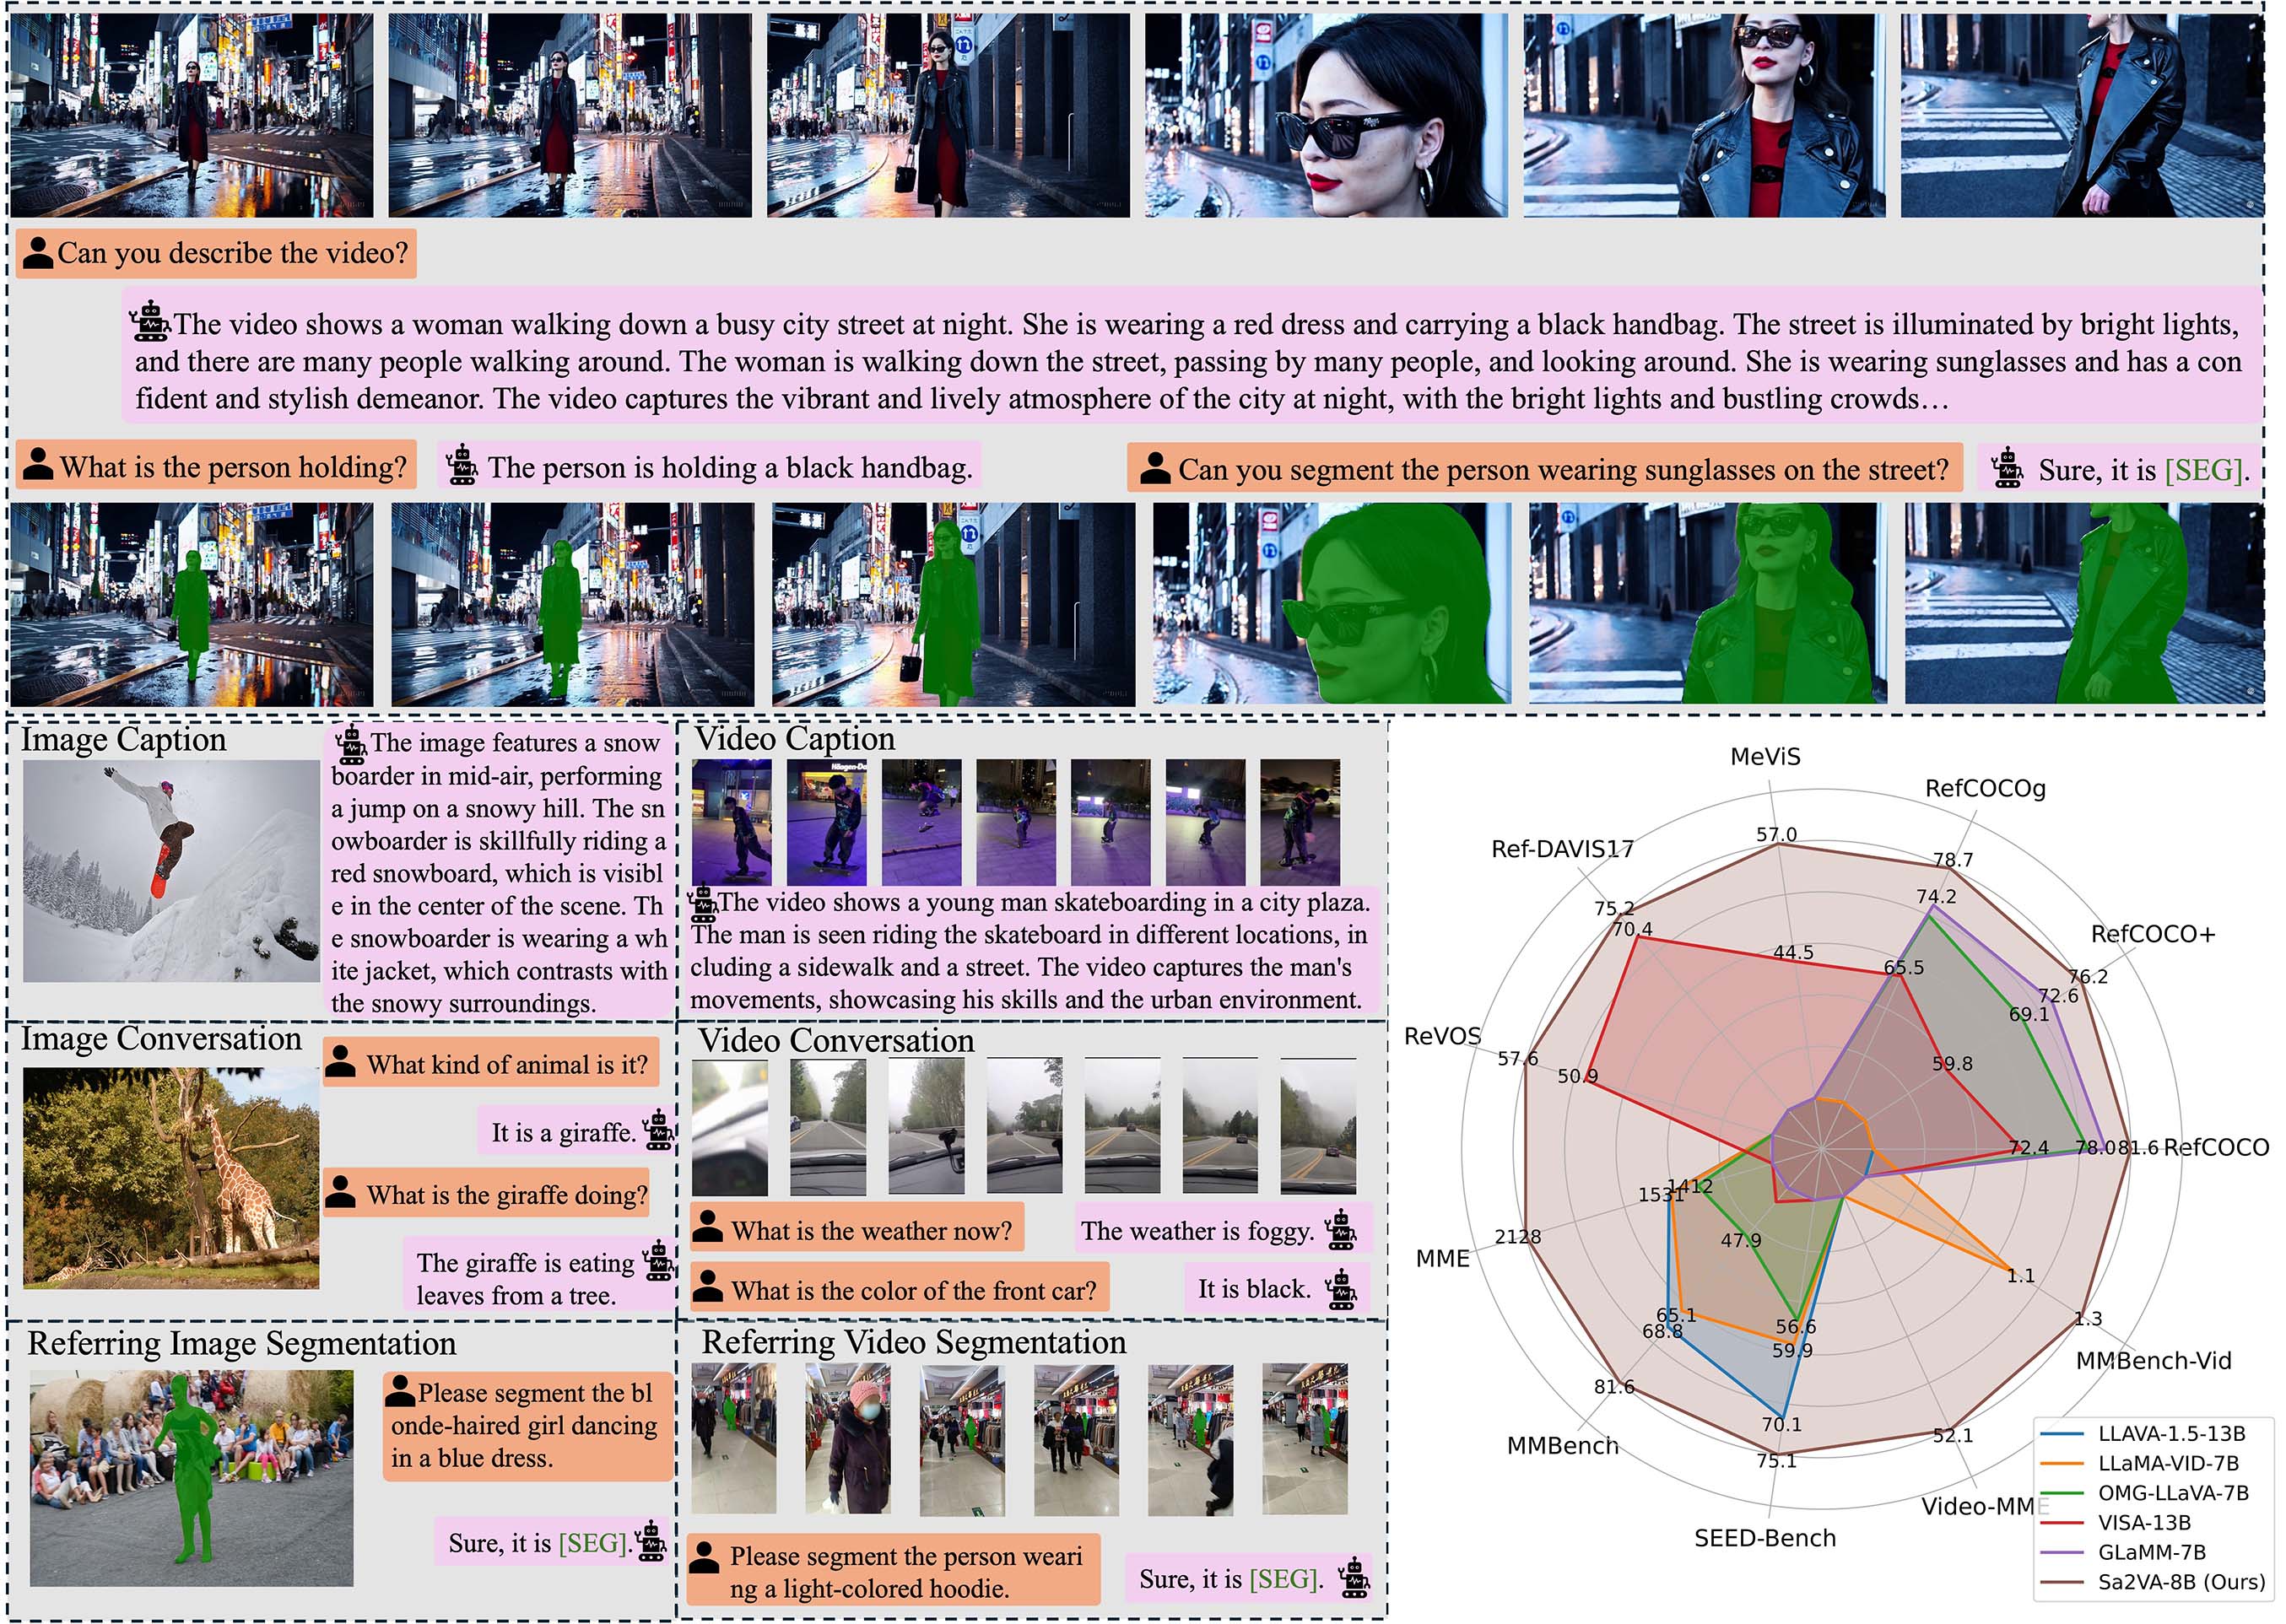
МультимодальныеByteDance представляет мультимодельную модель Sa2VA, объединяющую технологии SAM2 и LLaVA для достижения плотной сегментации и визуального ответа на вопросы как для изображений, так и для видео, достигая наилучших результатов в нескольких основных тестах
Open-Weights