MiniMax H3 Image: オープンな16MP画像生成・編集モデル
ComfyUIでMiniMax-H3-Imageを実行: 33Bの単一checkpointで16MPのテキストから画像生成と最大16枚の参照画像を使った編集を、CFG 1の6ステップで行えます。
MiniMax H3 Image
Text-to-ImageImage EditingMulti-Reference16 MP6 StepsMiniMax-H3-ImageはMiniMaxのオープンウェイト画像モデルです。単一の33.1B checkpointで、約16メガピクセルのテキストから画像生成と複数参照画像による編集を処理し、classifier-free guidanceなしの6サンプリングステップに蒸留されています。MiniMax H3のH3 diffusion transformerから音声分岐を除いた構成で、Qwen3-VL-32Bテキストエンコーダーを共有します。
| Developer | MiniMax |
| Release Date | 2026-11-10 |
| Architecture | 33.1Bのdense single-stream DiT(音声レイヤーを除いたH3) |
| Text Encoder | Qwen3-VL-32B(レイヤー50の隠れ状態) |
| Image VAE | 2D ViTデコーダー付きCNNエンコーダー、16倍ダウンサンプリング、24潜在チャンネル |
| Sampling | 6ステップ、CFG 1、ネガティブプロンプトなし |
| License | MiniMax H3 Image Community License |
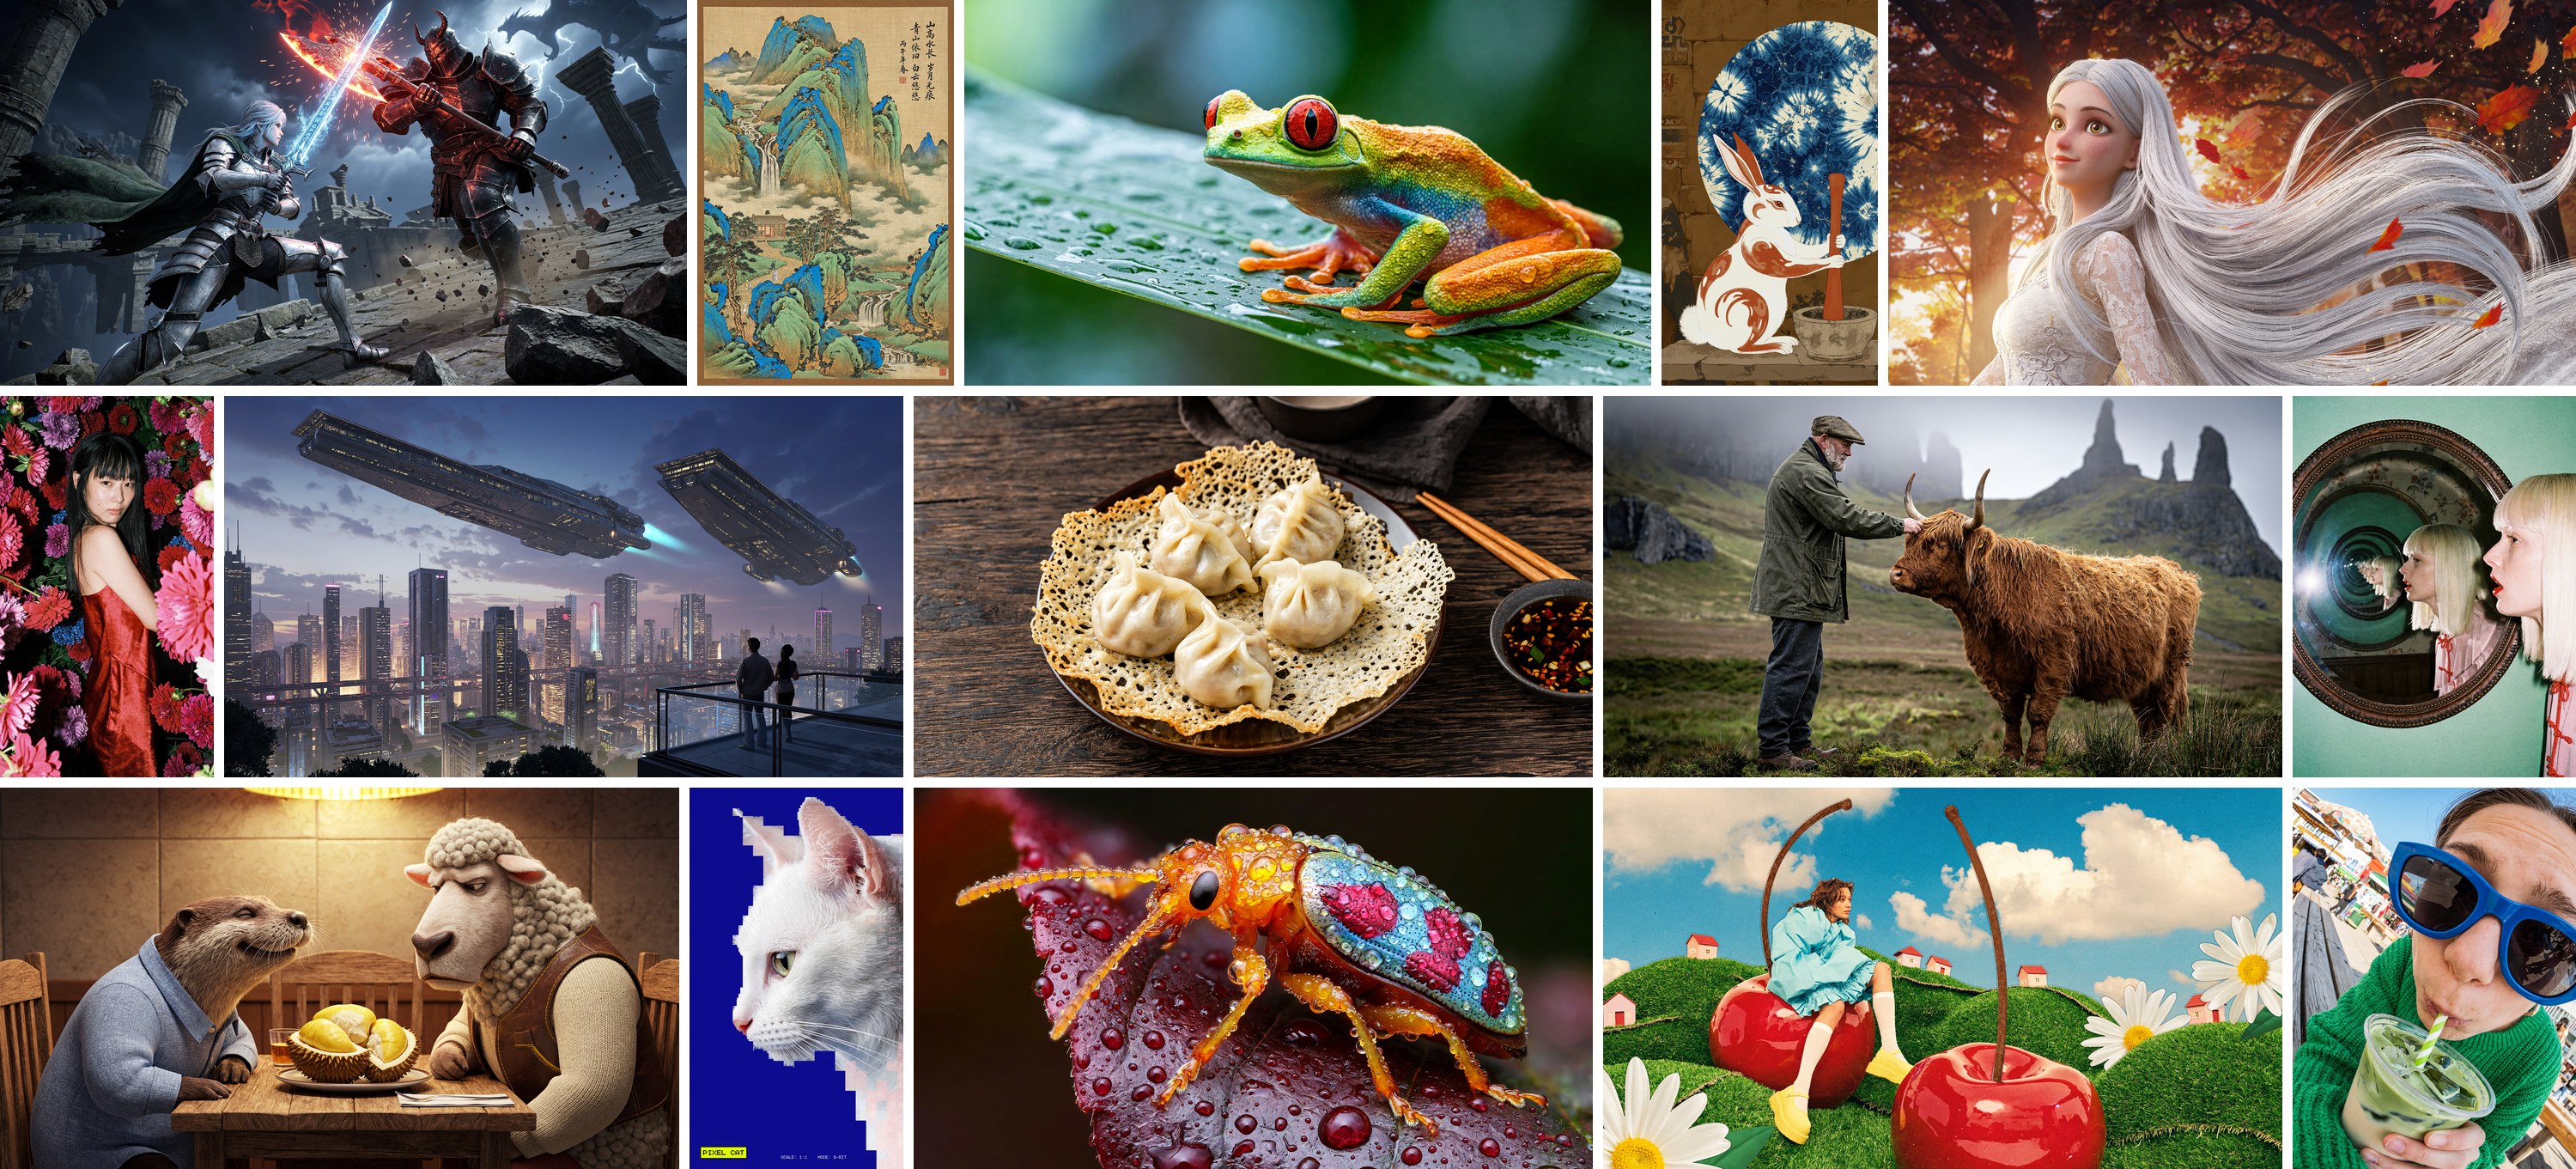
MiniMax-H3-Imageは、4096x4096から6272x2688まで、あらゆるアスペクト比で約16メガピクセルの画像を生成し、同じcheckpointで1枚以上の参照画像を編集できます。ネイティブのComfyUIサポートは2026-11-10にマージされ(Comfy-Org/ComfyUI #17655)、v0.45.0に含まれています。
モード
| モード | 入力 | 備考 |
|---|---|---|
| テキストから画像へ | 長い英語の説明 | 4MPから20MPの実用範囲、16MP前後が最適 |
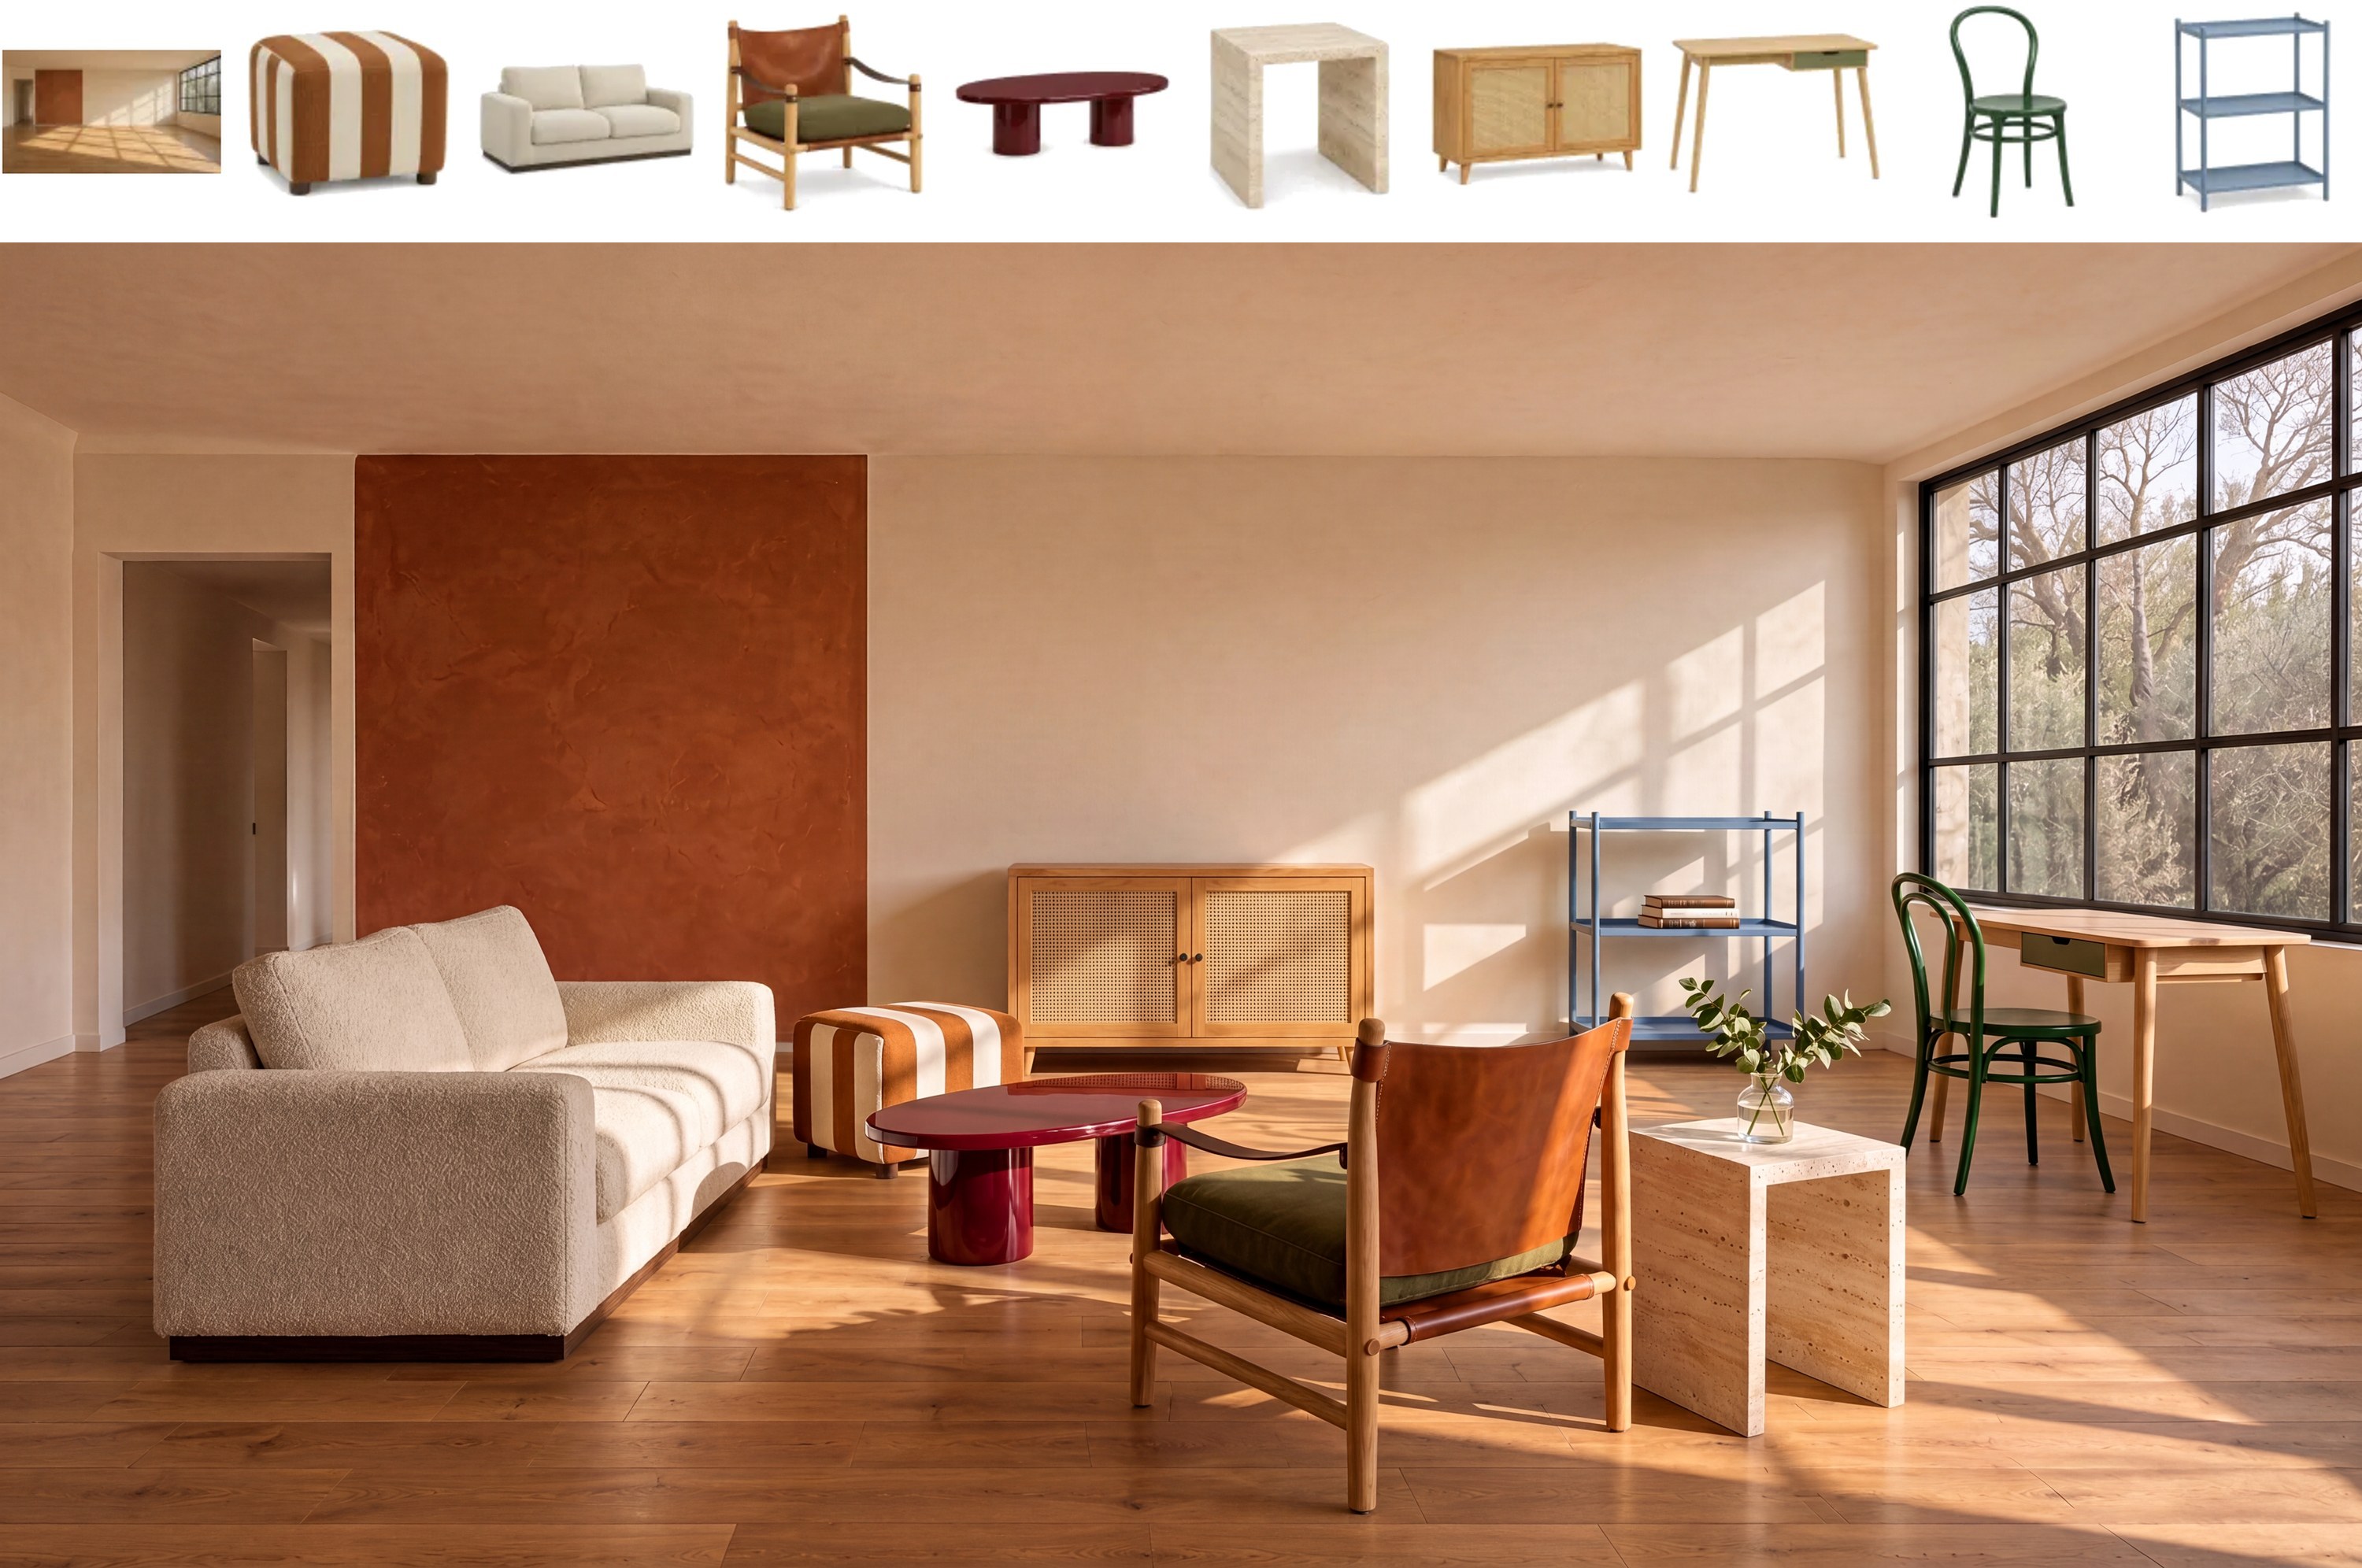
| 画像編集 | 1枚から16枚の参照画像、Picture 1、Picture 2、…として指定 | 同じ重みを使用し、編集専用のcheckpointは不要 |
モデルは詳細な英語のキャプションを想定しています。MiniMaxのホステッドH3-Image-Context-IRは短いプロンプトをそのようなキャプションに変換します。オプションのMiniMax-H3-Image-PEプロンプトエクスパンダー(17.9 GB NVFP4)はローカルで同じ処理を行い、公式ComfyUIテンプレートではGenerate Textを通じて9BのQwen3.5エクスパンダーを使用します。
ComfyUI
- ノード:
MiniMax H3 Image Conditioning(image/conditioning)、オプションのvae入力は画像を参照latentとしてアンカーします。 - テンプレート: テンプレートブラウザーの
image_minimax_h3_image_t2iとimage_minimax_h3_image_edit。 - 両テンプレートのサンプラー設定: 6ステップ、CFG 1。デフォルトのキャンバスは4MPで、カードが許す場合は引き上げてください。
リソース
- ComfyUIチュートリアル(公式ドキュメント)
- MiniMax H3 Imageオープンウェイトのニュース
- MiniMax H3モデルページ(動画版の兄弟モデル、同じテキストエンコーダー)
Guides and workflows related to this model series.
コメント
GitHubでサインインしてディスカッションに参加しましょう。