Modelos y descargas para ComfyUI
Descubre y descarga modelos compatibles con los nodos nativos y personalizados de ComfyUI, o encuentra los modelos que necesitan tus flujos de trabajo.
Explora familias de modelos. Abre una tarjeta para versiones, descargas y docs.

MOSS-Image: modelo de imagen abierto 5B con control de diseño
MOSS-Image es la familia abierta de texto a imagen de 5B de OpenMOSS con control de diseño JSON, renderizado preciso de texto en inglés y chino, y soporte de ComfyUI en el núcleo.
Qwen-Video-Edit: Edición de Vídeo por Instrucciones en Latentes Wan
Qwen-Video-Edit reutiliza el DiT de Qwen-Image-Edit para editar latentes de vídeo de Wan 2.1 con instrucciones de texto, checkpoints de 360P a 720P y nodos oficiales de ComfyUI.
SANA-Video: el transformer de difusión lineal de NVIDIA para vídeo
SANA-Video es la línea de vídeo de NVIDIA centrada en la eficiencia: el checkpoint 5B 720p renderiza clips de 736x1280 desde texto o un primer fotograma, más un DMD de 4 pasos.
Kandinsky: modelos abiertos de generación de vídeo y audio
Kandinsky 6.0 es la familia abierta de modelos de difusión de Kandinsky Lab que genera vídeo de 5 segundos con audio sincronizado de 44 kHz, en versiones Pro y Lite.
DreamX-Creator: generación conjunta de audio y vídeo en 2K
DreamX-Creator 1.0 es el modelo abierto de AMap que genera vídeo y audio sincronizados, con un refinador de 2K en 1 paso y nodos nativos de ComfyUI.
AuK: familia de voz abierta de Tencent Hunyuan
AuK es la familia de voz abierta 1.5B de Tencent Hunyuan: TTS, clonación de voz, edición de contenido y acústica, mejora y separación, con nodos oficiales de ComfyUI.
LLaDA-Image: modelo 6B de imágenes de InclusionAI
LLaDA-Image es el modelo abierto 6B de InclusionAI para texto a imagen y edición nativa por instrucciones, con una variante Turbo y un paquete de nodos ComfyUI de la comunidad.
Bernini: framework de vídeo con planificación semántica de ByteDance
Bernini es el framework abierto de generación y edición de vídeo de ByteDance: un planificador semántico y un renderizador basado en Wan2.2, publicado bajo licencia Apache-2.0.
YuE2: modelo abierto de música de letra a canción para ComfyUI
YuE2 es la familia abierta de modelos de letra a canción de m-a-p, con soporte nativo en ComfyUI. Pesos YuE2-3B para canciones con melodía y acordes editables. CC-BY-NC-4.0.
Ming-Image: modelos abiertos de diseño y capas
Ming-Image es la familia abierta de 6B de inclusionAI para diseño visual y descomposición en capas editables, con salida RGBA y soporte ComfyUI en progreso.
MiniMax: modelos abiertos de generación de video y música
Modelos de generación abiertos de MiniMax en ComfyUI: el video omni-modal H3 con audio estéreo nativo de 32 kHz, y Music 3 para canciones de hasta cinco minutos.
Mage-Flow: Familia de modelos de imagen de resolución nativa 4B de Microsoft
Mage-Flow es un stack de generación compacto de 4B parámetros de Microsoft Asia para generación de texto a imagen y edición de imágenes por instrucciones, con resolución nativa de hasta 2048, variantes RL y Turbo, licencia MIT.
JoyAI Image: Modelo Unificado Multimodal de Edición de Imágenes de JD Open Source
JoyAI Image es un modelo fundacional multimodal unificado de JD Open Source para edición de imágenes guiada por instrucciones. Combina 8B MLLM + 16B MMDiT con soporte nativo de ComfyUI.
Ovi: Generación de audio y video con doble backbone por Character.AI
Ovi de Character.AI es un modelo de audio y video con doble backbone basado en Wan2.2 que genera audio y video sincronizados en ambos sentidos.
SkyReels-V2: vídeo de longitud infinita por Skywork
SkyReels-V2 es el primer modelo abierto de vídeo de longitud infinita con Diffusion Forcing. Basado en Wan2.1, soporta T2V, I2V y generación autorregresiva.
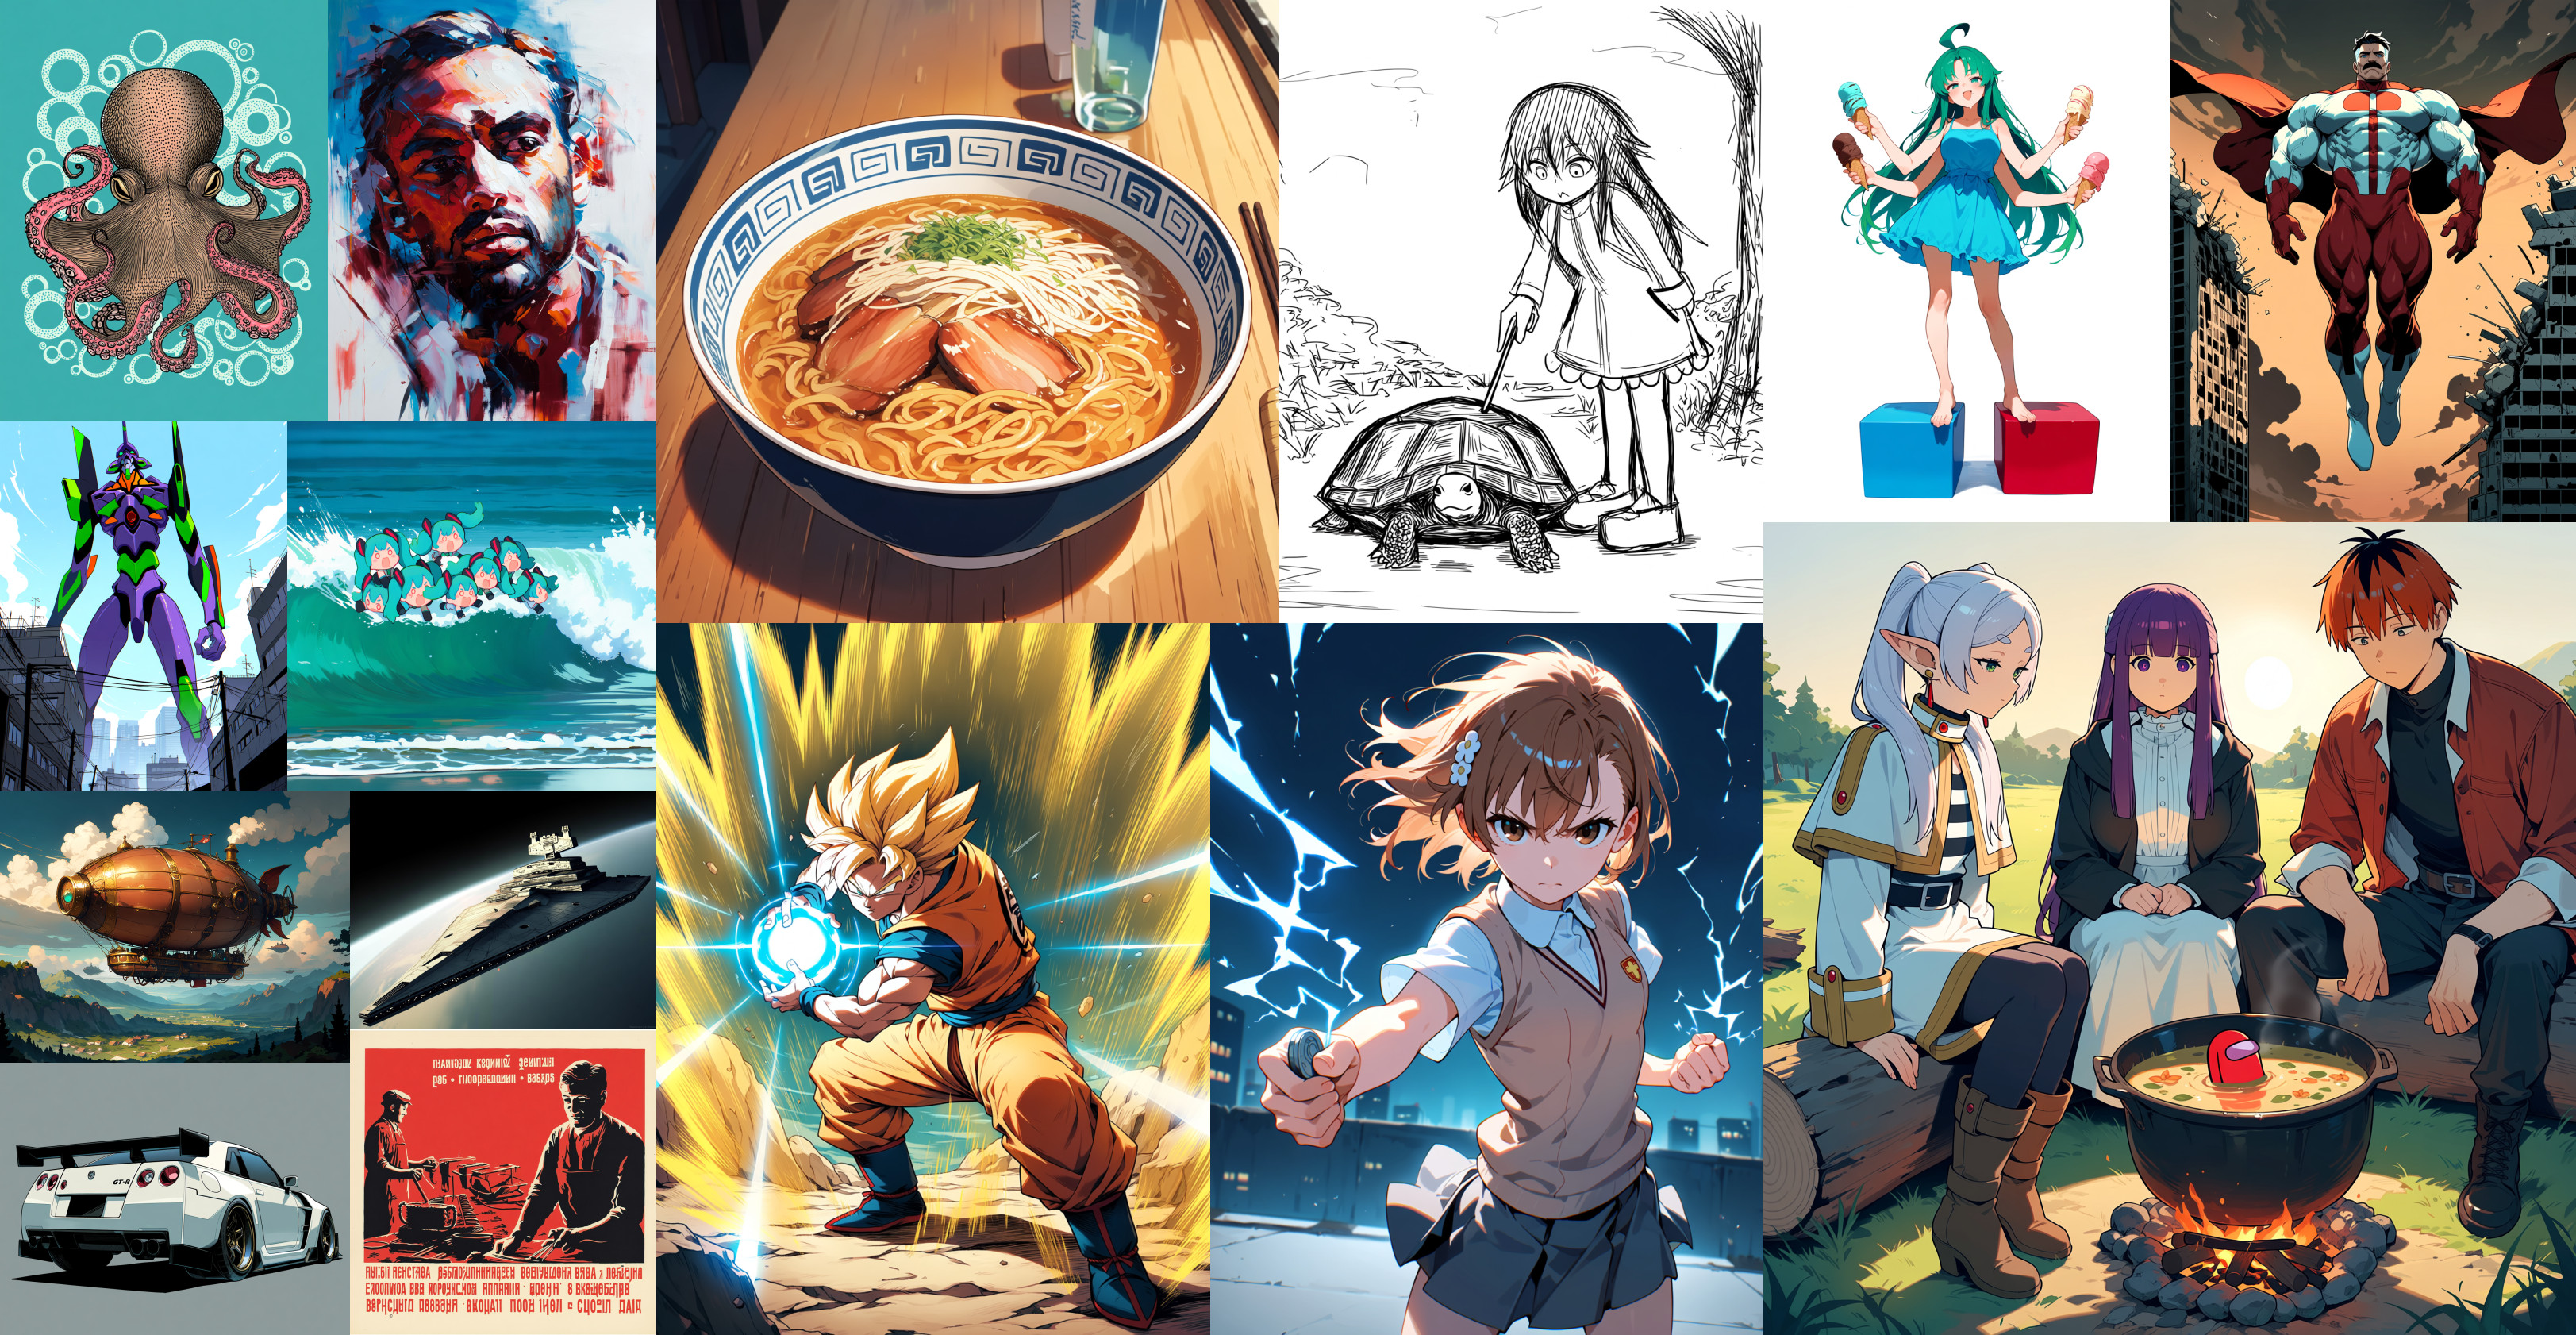
Anima: Modelo de texto a imagen anime de 2 mil millones de parámetros de Circlestone Labs
Anima es un modelo de texto a imagen de 2 mil millones de parámetros creado por Circlestone Labs y Comfy Org, centrado en conceptos anime y estilos artísticos. Disponible en variantes Base, Aesthetic y Turbo para ComfyUI.
Familia Qwen: Modelos de Codificador de Texto de Código Abierto
Modelos de codificador de texto Qwen de Alibaba para usar con ComfyUI: Qwen3-VL (visión-lenguaje) y Qwen3.5 (solo texto).
Familia Z-Image: Modelos S3-DiT de 6B de Tongyi-MAI (Alibaba)
Z-Image es una familia de modelos eficientes de generación de imágenes de Tongyi-MAI (Alibaba). Cuenta con una arquitectura DiT de flujo único de 6 mil millones de parámetros con variantes para calidad (Z-Image) y velocidad (Z-Image-Turbo).
Familia VOID: Eliminación de objetos e interacciones en video por Netflix — Apache-2.0
VOID de Netflix es un modelo de eliminación de objetos e interacciones en vídeo que elimina objetos de los vídeos junto con todas las interacciones físicas inducidas.
Stable Audio: Modelos de texto a audio de código abierto
Stable Audio es la familia de modelos de texto a audio de Stability AI para generación de música, efectos de sonido y foley, incluyendo Stable Audio Open 1.0 y Stable Audio 3.
Familia Qwen-Image: generación de imágenes open source de Alibaba
Qwen-Image es el modelo de generación de imágenes de código abierto de Alibaba en la serie Qwen, destacando en texto complejo y edición precisa.
Familia PixelDiT: DiT de espacio de píxeles sin VAE + Superresolución PiD de NVIDIA
PixelDiT de NVIDIA es un transformador de difusión de píxeles sin VAE para generación de texto a imagen. Incluye modelos PiD (Pixel Diffusion Decoder) para superresolución hasta 4K.
Familia Ovis: Modelos de generación de imágenes visión-lenguaje para ComfyUI
Ovis es la serie de modelos de generación de imágenes visión-lenguaje de AIDC-AI para usar con ComfyUI, que incluye modelos de difusión y codificadores de texto.
OmniGen: Modelo unificado de generación multimodal para ComfyUI
OmniGen es una serie de modelos unificados de generación multimodal de VectorSpace Lab que admite T2I, edición de imágenes y generación en contexto.
NewBie-image: generación de texto a imagen anime para ComfyUI
NewBie-image Exp0.1 es un modelo Next-DiT de 3.5B del NewBie AI Lab especializado en generación de imágenes de estilo anime.
Familia Lumina: Generación de imágenes basada en flujo para ComfyUI
Lumina-Image 2.0 de Alpha-VLLM es un transformer de difusión basado en flujo de 2 mil millones de parámetros para generación de texto a imagen.
Familia LongCat: generación de imágenes bilingüe para ComfyUI
LongCat de Meituan es un modelo fundacional bilingüe (chino-inglés) de código abierto pionero para generación de imágenes con renderizado de texto chino superior y fotorrealismo.
Familia Krea: Modelo de Transformer de Difusión de código abierto con variantes Raw + Turbo
Krea 2 es un modelo de generación de imágenes AI de código abierto de Krea. Ofrece variantes Raw (calidad completa) y Turbo (destilado) con LoRAs de estilo para efectos artísticos diversos.
Familia Ideogram: Transformer de Difusión con tipografía superior de Ideogram AI
Ideogram 4 es un modelo de IA de texto a imagen de última generación de Ideogram AI. Cuenta con capacidades avanzadas de tipografía y generación fotorrealista.
Familia Gemma: Modelos de codificador de texto abiertos de Google para ComfyUI
Gemma es la familia de modelos abiertos de Google DeepMind para usar como codificadores de texto en ComfyUI, incluyendo Gemma 4 con variantes ajustadas por instrucciones E2B y E4B.
ERNIE-Image: Generación de Imágenes Open Source de Baidu de 8B — Apache-2.0
ERNIE-Image es la serie de modelos open source de generación de texto a imagen de 8B parámetros de Baidu, con un Prompt Enhancer ligero, destacando en renderizado de texto y generación estructurada.
Chroma: modelos de código abierto de texto a imagen y escalado para ComfyUI
Chroma es una serie de modelos de lodestones que incluye Chroma1-HD (8.9B T2I) y Chroma1-Radiance (escalado de alta resolución en desarrollo), ambos bajo licencia Apache 2.0.
Boogu-Image: Generación de Imágenes de Código Abierto para ComfyUI
Boogu-Image es una serie versátil de modelos de generación de imágenes con variantes base, turbo y edición para ComfyUI.
Wan Video Family: Generación de video AI open-source
La serie de modelos de generación de video open-source de Alibaba Cloud. Desde Wan2.1 hasta Wan2.2, ofreciendo generación de texto a video e imagen a video de alta calidad con arquitectura MoE.
Familia de modelos Stable Diffusion: SD 1.5, SDXL, SD 3.5 para ComfyUI
Linaje de Stable Diffusion de Stability AI: SD 1.5 (Runway), SD 2.x, SDXL y SD 3.5. Checkpoints abiertos de texto a imagen muy utilizados en ComfyUI.
LTX Video: Modelo de Generación de Video en Tiempo Real
LTX-Video es el primer modelo de generación de video basado en DiT de Lightricks con 2B parámetros, compatible con generación de texto a video y de imagen a video.
DeepSeek Janus: Modelo de IA multimodal para ComfyUI
DeepSeek Janus Pro es un modelo de IA multimodal capaz de comprender y generar imágenes, publicado como código abierto por DeepSeek en enero de 2025.
IC-Light: modelos de reiluminación de imágenes para ComfyUI
IC-Light es la serie de reiluminación de imágenes de lllyasviel: checkpoints V1 abiertos más una V2 basada en FLUX que hoy solo se ejecuta en la demo online oficial.
Hunyuan3D: generación de modelos 3D de código abierto
Hunyuan3D es la serie de modelos de generación 3D de código abierto de Tencent. La versión 2.0 admite la generación de modelos 3D de alta fidelidad con mapas de textura de alta resolución a partir de entradas de texto, imagen o boceto.
Familia Hunyuan Video: Generación de vídeo open-source de Tencent
Serie de modelos de generación de vídeo open-source de Tencent. De v1.0 a v1.5, generación de texto a vídeo e imagen a vídeo de alta calidad.
HiDream-I1: Modelo de texto a imagen de código abierto con 17B parámetros
HiDream-I1 es un modelo de texto a imagen de 17B parámetros de HiDream-ai, que combina DiT con arquitectura MoE. Con licencia MIT, disponible en variantes Full/Dev/Fast.
Familia Flux: Modelos Open Source de Generación de Imágenes para ComfyUI
Flux es una serie de modelos de generación de imágenes open source de Black Forest Labs. Tres generaciones: FLUX.1 (3.8B DiT), FLUX.2 (32B dense transformer) y FLUX 3 (modelo de flujo multimodal para video, imagen, audio y predicción de acciones).
ACE-Step: Guía del modelo de generación de música
ACE-Step es un modelo base de generación de música de código abierto desarrollado conjuntamente por StepFun y ACE Studio, compatible con generación musical, edición y síntesis de audio.