MiniMax: modelos abiertos de generación de video y música
Modelos de generación abiertos de MiniMax en ComfyUI: el video omni-modal H3 con audio estéreo nativo de 32 kHz, y Music 3 para canciones de hasta cinco minutos.
MiniMax H3
Generación de VideoAudio NativoOmni-ModalTexto a VideoImagen a VideoMiniMax H3 es un sistema abierto de generación omni-modal de propósito general que entiende el contexto multimodal compuesto por texto, imágenes, video y audio, y genera hasta 15 segundos de video con audio estéreo nativo de 32 kHz en una sola pasada. Es el último modelo de la línea de video Hailuo de MiniMax, impulsado por un transformador omni de flujo único denso de 33.1B con un codificador de texto Qwen3-VL-32B.
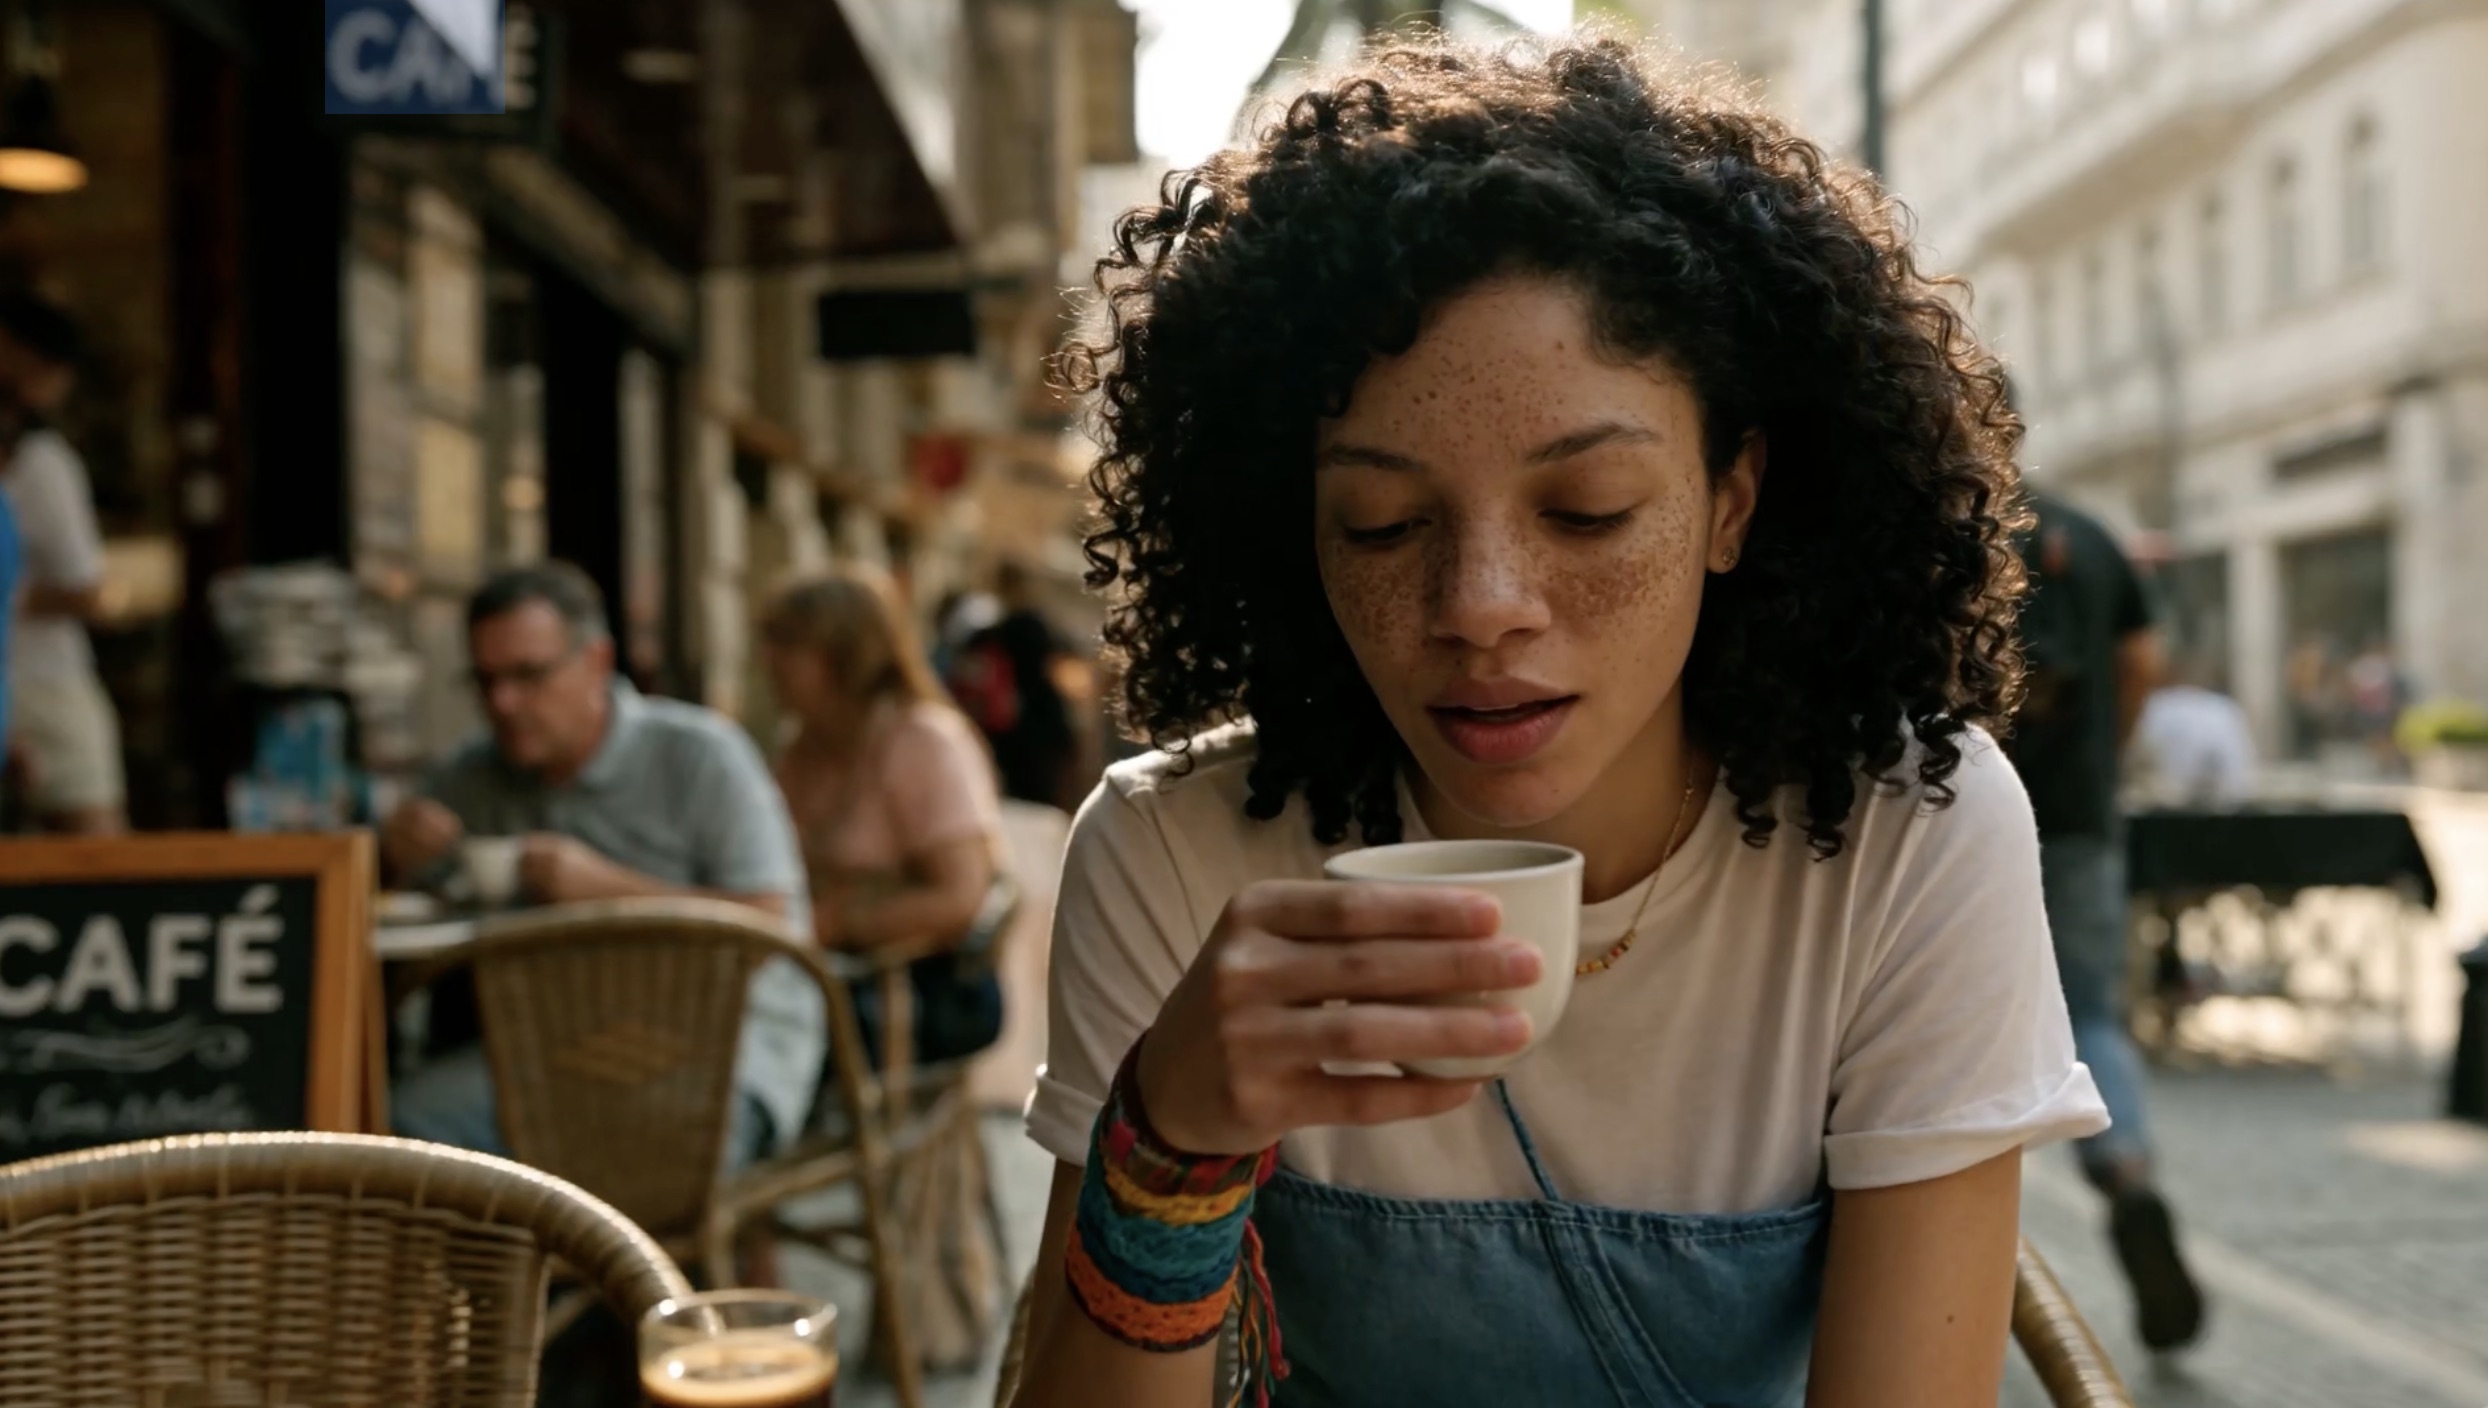
Imagen de entrada de ejemplo usada en la demo oficial de contexto multimodal de H3 de MiniMax
MiniMax H3 se publicó oficialmente como código abierto el 3 de agosto de 2026 bajo el Acuerdo de Licencia Comunitaria MiniMax H3. La publicación abierta cubre H3-Base como dos checkpoints específicos de tarea: FL2VA (texto a video y condicionamiento por primer/último fotograma) y Ref2VA (generación basada en referencias). El sistema de preprocesamiento H3-Context-IR y el módulo de ampliación H3-Regenerate-2K siguen disponibles como APIs alojadas.
Modelos
| Modelo | Tipo | Descripción | Licencia | Lanzamiento |
|---|---|---|---|---|
| MiniMax H3 | Video | Generación de video omni-modal con audio estéreo nativo de 32 kHz | Licencia Comunitaria MiniMax H3 | 2026-08 |
| MiniMax Music 3 | Música | Canciones completas de hasta cinco minutos a partir de letras y una descripción musical | Licencia Comunitaria MiniMax Music 3 | 2026-09 |
Selecciona un modelo arriba para ver descargas de pesos seleccionadas, tutoriales e información relacionada.
Versiones
| Versión | Descripción |
|---|---|
| H3-Base FL2VA | Modos texto a video, primer fotograma, último fotograma y primer+último |
| H3-Base Ref2VA | Generación basada en referencias de hasta 9 imágenes, 3 videos y 3 clips de audio |
Capacidades principales
- Audio estéreo nativo: 32 kHz estéreo generado en la misma pasada que la imagen, sin modelo de audio separado
- Contexto multimodal: cualquier combinación de texto, imágenes, video y audio como entrada
- Regeneración 2K in-context: H3-Regenerate-2K vuelve a generar la salida 768p a 2K reutilizando el contexto original
- 11 idiomas: ar, zh, en, fr, de, it, ja, ko, pt, ru, es
- Implementación: SGLang, vLLM, diffusers y ComfyUI
Instalación
MiniMax H3 tiene soporte nativo en ComfyUI. Coloca los archivos en sus carpetas respectivas:
| Archivo | Destino |
|---|---|
minimax_h3_*_bf16.safetensors o *_int8_convrot.safetensors | ComfyUI/models/diffusion_models/ |
qwen3vl_32b_minimax_h3_*.safetensors | ComfyUI/models/text_encoders/ |
minimax_h3_video_vae_fp16.safetensors | ComfyUI/models/vae/ |
minimax_h3_audio_vae_fp32.safetensors | ComfyUI/models/vae/ |
El repositorio oficial reempaquetado para ComfyUI (Comfy-Org/MiniMax-H3) ofrece variantes del modelo de difusión bf16, INT8 convrot y pruned INT8, además de opciones de codificador de texto bf16, INT8 y NVFP4 AWQ. Los checkpoints INT8 pruned son aproximadamente un 40% más pequeños gracias a las tablas de curvas adaLN precalculadas, y el codificador de texto NVFP4 AWQ funciona en cualquier GPU.
Comentarios
Inicia sesión con GitHub para unirte a la conversación.