Imagen a 3DMicrosoft presenta TRELLIS.2, un gran modelo generativo 3D de 4 mil millones de parámetros que convierte imágenes en activos 3D de alta calidad en segundos, con materiales PBR completos y soporte para topologías complejas
Open-Weights
Novedades del ecosistema ComfyUI: lanzamientos de modelos de código abierto, nodos personalizados, flujos de trabajo y herramientas de generación de imagen, video y audio.
Imagen a 3DMicrosoft presenta TRELLIS.2, un gran modelo generativo 3D de 4 mil millones de parámetros que convierte imágenes en activos 3D de alta calidad en segundos, con materiales PBR completos y soporte para topologías complejas
Open-Weights
El equipo de la Universidad Tsinghua publica como código abierto TurboDiffusion, un marco de aceleración para generación de video que logra 100-205x de aceleración en la generación de difusión de extremo a extremo en una sola RTX 5090 mientras mantiene la calidad del video
El equipo de Alibaba Cloud PAI lanza Z-Image-Turbo-Fun-Controlnet-Union, un modelo ControlNet que soporta múltiples condiciones de control incluyendo Canny, HED, Depth, Pose y MLSD, entrenado en resolución 1328
Open-Weights
Texto a imagenEl equipo AIDC-AI de Alibaba lanza Ovis-Image, un modelo de texto a imagen de 7B parámetros enfocado en el renderizado de texto de alta calidad, logrando excelentes resultados en múltiples benchmarks
Open-Weights
Alibaba Tongyi Lab lanza Z-Image-Turbo, un modelo eficiente de generación de imágenes con 6B parámetros que produce imágenes de alta calidad en solo 8 pasos de muestreo y funciona fluidamente en GPUs de consumo con 16GB de VRAM
Open-Weights
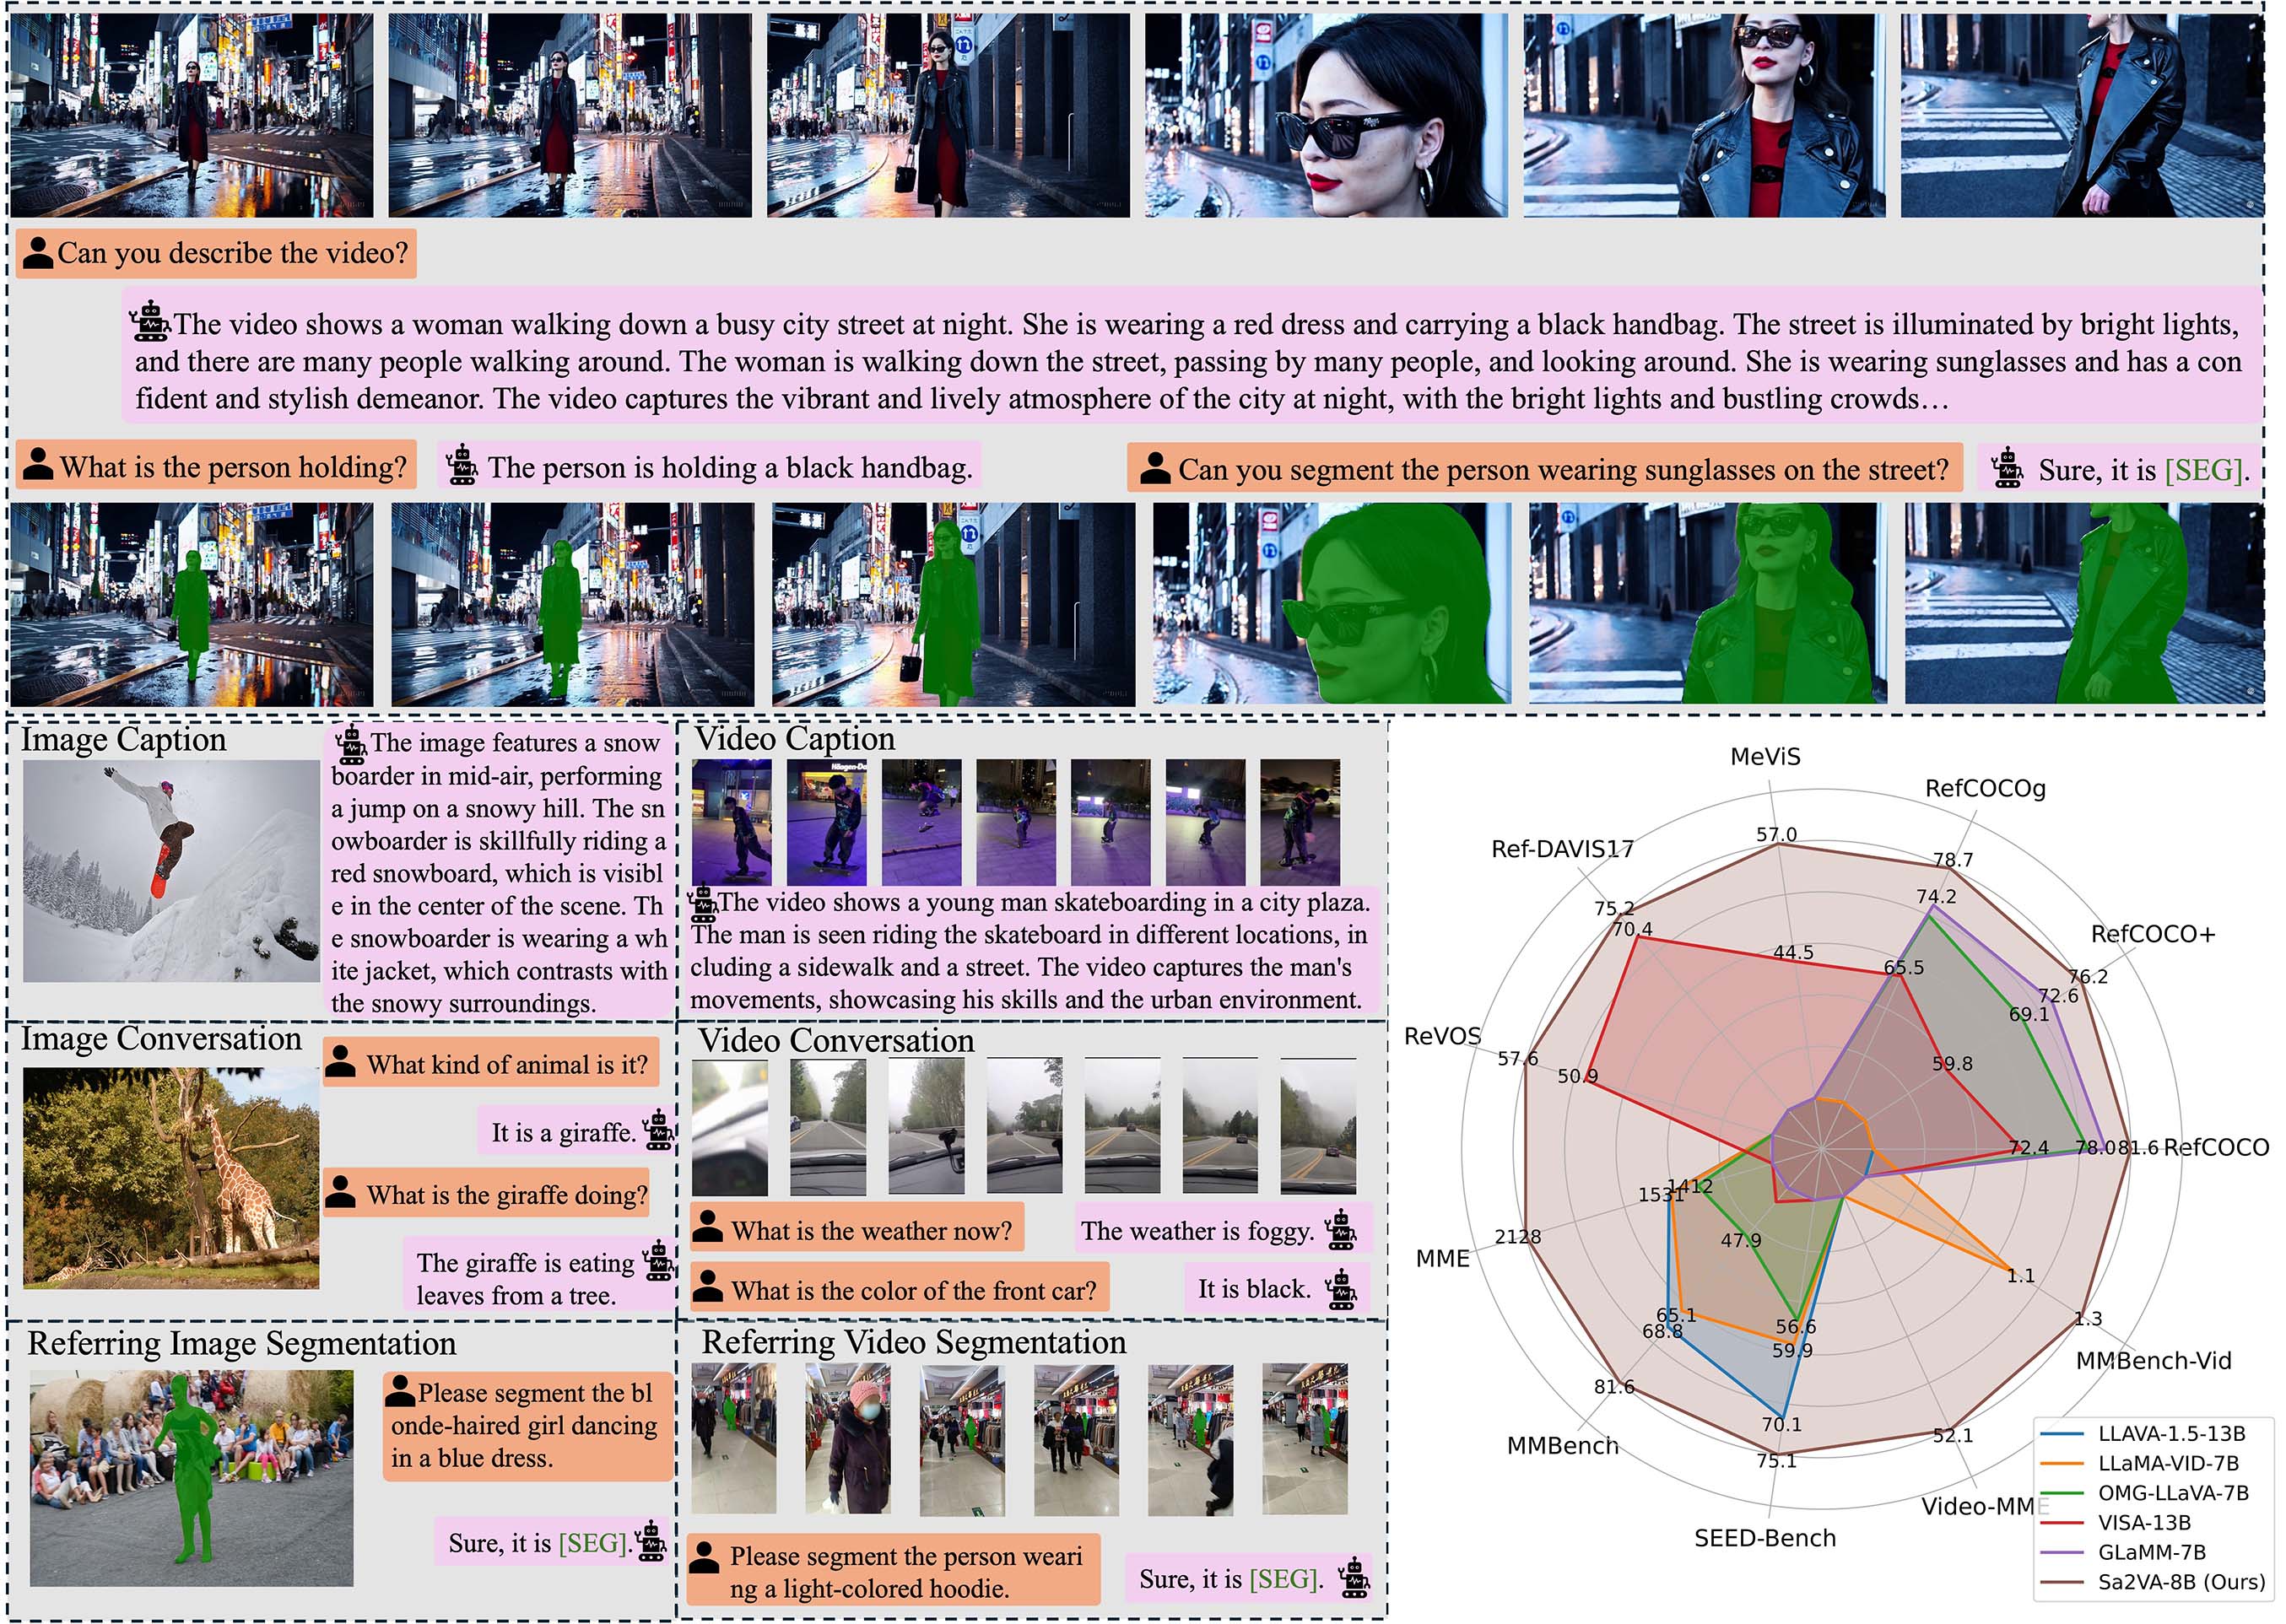
MultimodalByteDance presenta el modelo multimodal Sa2VA, combinando las tecnologías SAM2 y LLaVA para lograr segmentación densa y respuesta a preguntas visuales tanto para imágenes como para videos, alcanzando un rendimiento líder en múltiples puntos de referencia
Open-Weights
Tencent lanza Hunyuan Image 3.0, el primer modelo nativo de generación de imágenes multimodal comercial de código abierto con un total de 80 mil millones de parámetros, que cuenta con capacidades de razonamiento basadas en conocimientos del mundo y admite comprensión semántica compleja de miles de caracteres
Open-Weights
El equipo de Nunchaku lanza la versión optimizada del modelo Qwen-Image-Edit-2509 Lightning de 4-Bit, compatible con inferencia rápida de 4/8 pasos, ejecutándose sin problemas en entornos con 8 GB de VRAM
El Laboratorio Tongyi de Alibaba presenta Wan-Animate, un marco unificado de animación de personajes basado en Wan2.2, que admite la generación de animación de personajes y el reemplazo de personajes en videos, con pesos de modelo e inferencia de código de código abierto
Open-Weights
Comfy Cloud ejecuta ComfyUI en el navegador con modelos y nodos personalizados ya instalados. Pago por créditos y 5 ejecuciones de GPU gratis para empezar.
Imagen a 3DEl equipo de Tencent Hunyuan lanza la tecnología Voyager, capaz de generar videos de secuencias de nubes de puntos 3D coherentes con el mundo a partir de una sola imagen y trayectorias de cámara definidas por el usuario, admitiendo exploración infinita del mundo y reconstrucción 3D directa
Open-Weights
Texto a imagenByteDance presenta el modelo USO, capaz de combinar libremente cualquier sujeto con cualquier estilo manteniendo la consistencia del sujeto y logrando efectos de transferencia de estilo de alta calidad
Open-Weights
Wan2.2-S2V es un modelo de generación de video con IA que puede convertir imágenes estáticas y audio en videos, apoyando necesidades de creación de contenido como diálogo, canto y actuación.
Open-Weights
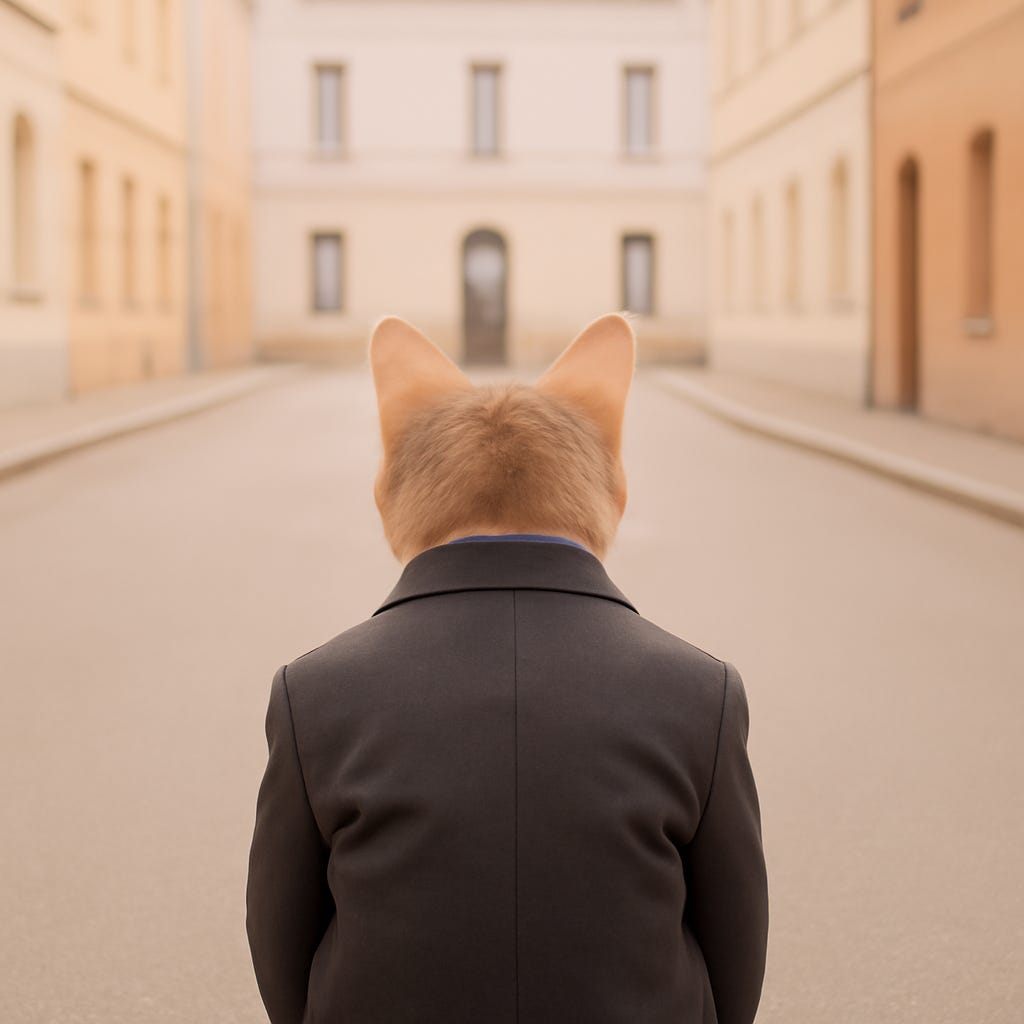
Ecosistema¡Participa en el primer Desafío Semanal de ComfyUI y gana $100! Crea un video que gire al personaje del hombre gato usando el mapa de profundidad proporcionado.
El equipo de MeiGen-AI ha publicado como código abierto el modelo InfiniteTalk, que permite la sincronización precisa de labios y la generación de videos de longitud ilimitada. Soporta conversión de imagen a video y de video a video, marcando un avance en la tecnología de humanos digitales.
MIT
ComfyUI lanza oficialmente la función Subgraph, permitiendo a los usuarios empaquetar combinaciones complejas de nodos en nodos de subgrafo reutilizables individuales, mejorando enormemente la modularidad y gestión del flujo de trabajo.
Qwen-Image es un modelo MMDiT de 20B centrado en el renderizado de texto complejo y la edición precisa; ya puede usarse de forma nativa en ComfyUI. Este artículo resume sus capacidades clave, licencia y recursos.
Open-Weights
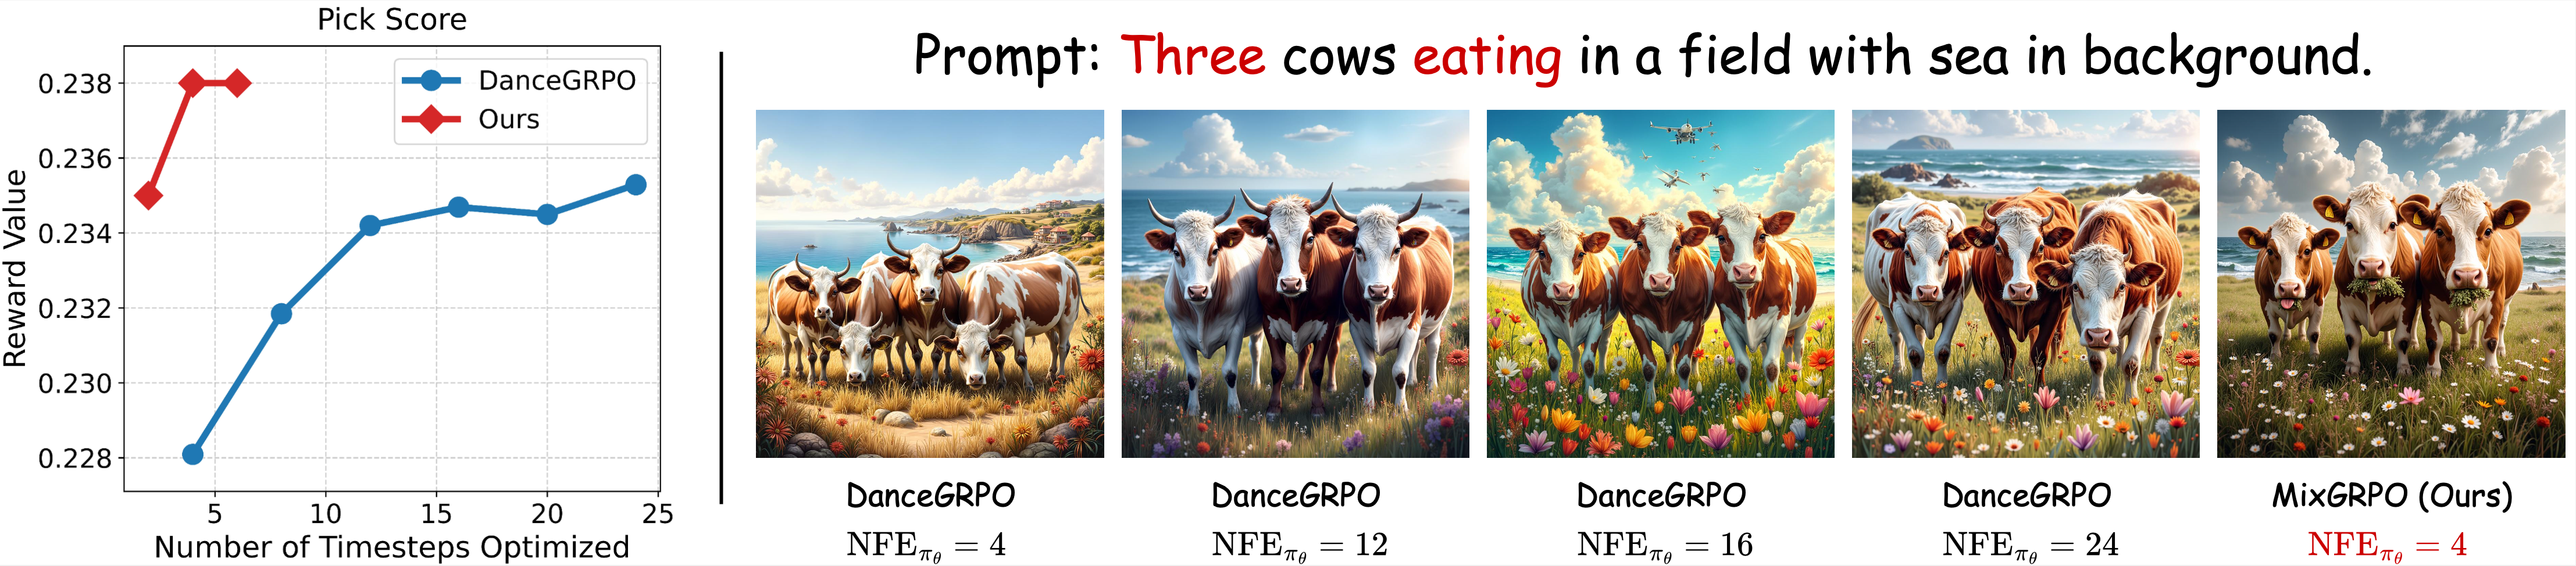
Texto a imagenEl equipo Hunyuan de Tencent lanza el framework de código abierto MixGRPO, el primero en integrar muestreo mixto ODE-SDE con ventana deslizante para GRPO, logrando hasta un 71% de aceleración en el entrenamiento para alineación de preferencias humanas en modelos de difusión y flujo.
Open-Weights
La colaboración entre Black Forest Labs y Krea lanza oficialmente el modelo FLUX.1 Krea [dev], el mejor modelo FLUX de código abierto para generación de texto a imagen. ComfyUI ha implementado soporte nativo, permitiendo a los usuarios experimentar la última tecnología de generación de texto a imagen.
FLUX-1-dev-non-commercial
El equipo de WAN lanza oficialmente la versión open source de Wan2.2, que incorpora una arquitectura MoE innovadora y mejora notablemente la calidad en la generación de video. ComfyUI ya ofrece soporte nativo, permitiendo a los usuarios experimentar directamente la nueva tecnología de generación de video.
Open-Weights