 多模态
工具
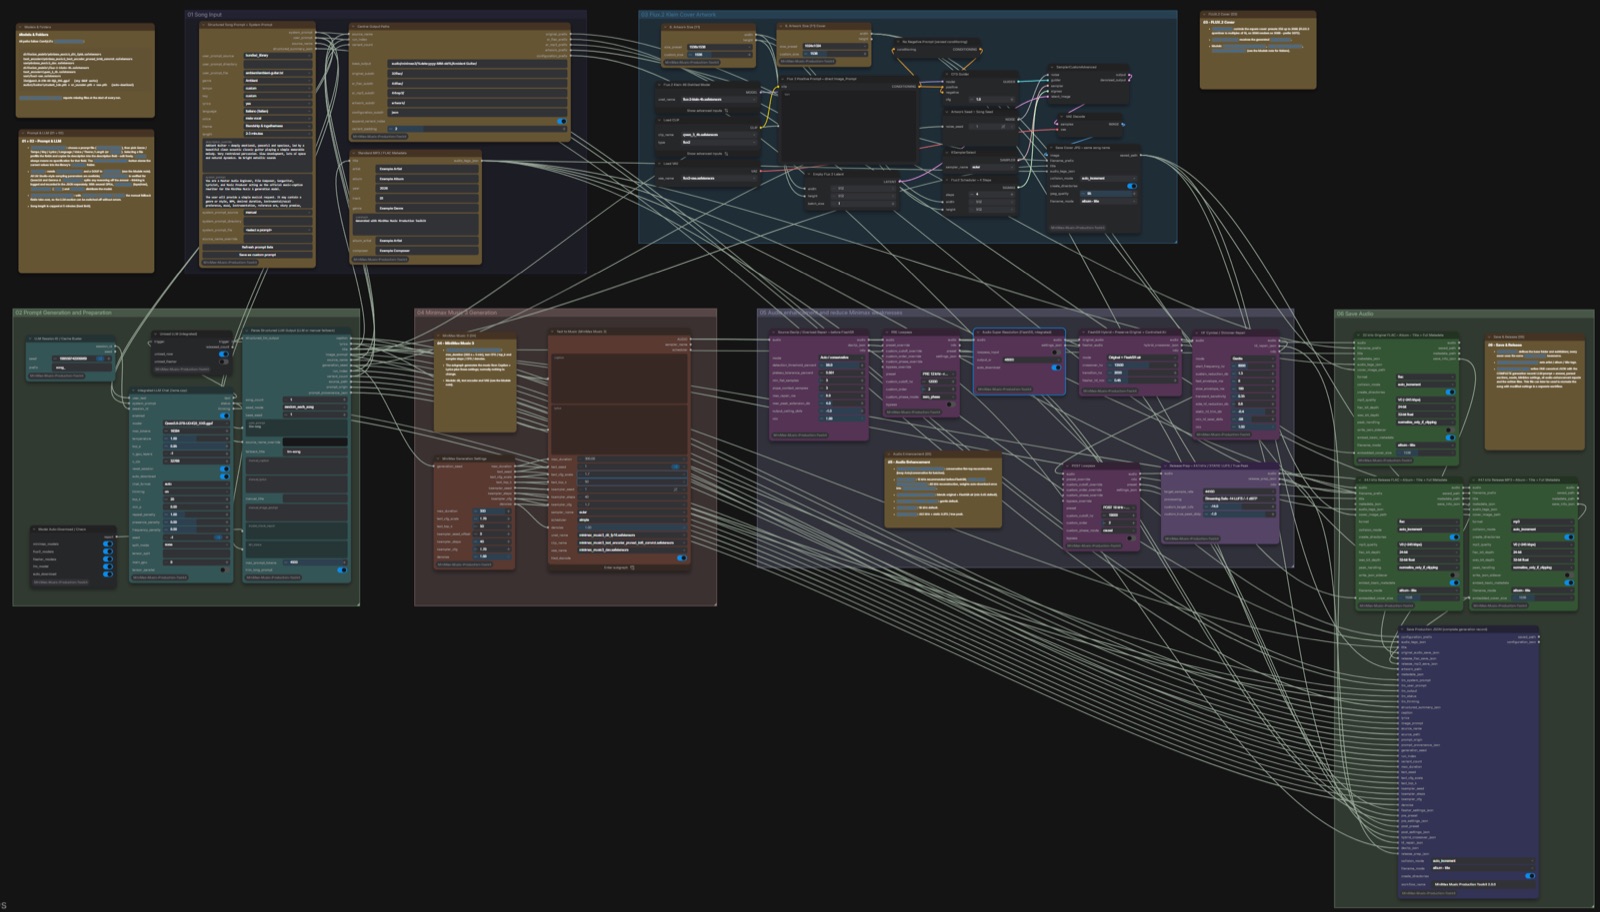
MiniMax 音乐制作工具包:在 ComfyUI 中打造完整音乐工作室一个免费、采用 MIT 许可证的节点包,可将 ComfyUI 变成 MiniMax 音乐 3 制作工作室:由 LLM 编写歌曲提示词、内置 62 种曲风预设、通过 FlashSR upscaling 将音频提升至 48 kHz,并能自动生成 FLUX.2 封面图。
ComfyUI 生态最新动态:开源模型发布、自定义节点、工作流与工具更新。
多模态一个免费、采用 MIT 许可证的节点包,可将 ComfyUI 变成 MiniMax 音乐 3 制作工作室:由 LLM 编写歌曲提示词、内置 62 种曲风预设、通过 FlashSR upscaling 将音频提升至 48 kHz,并能自动生成 FLUX.2 封面图。
 文生视频
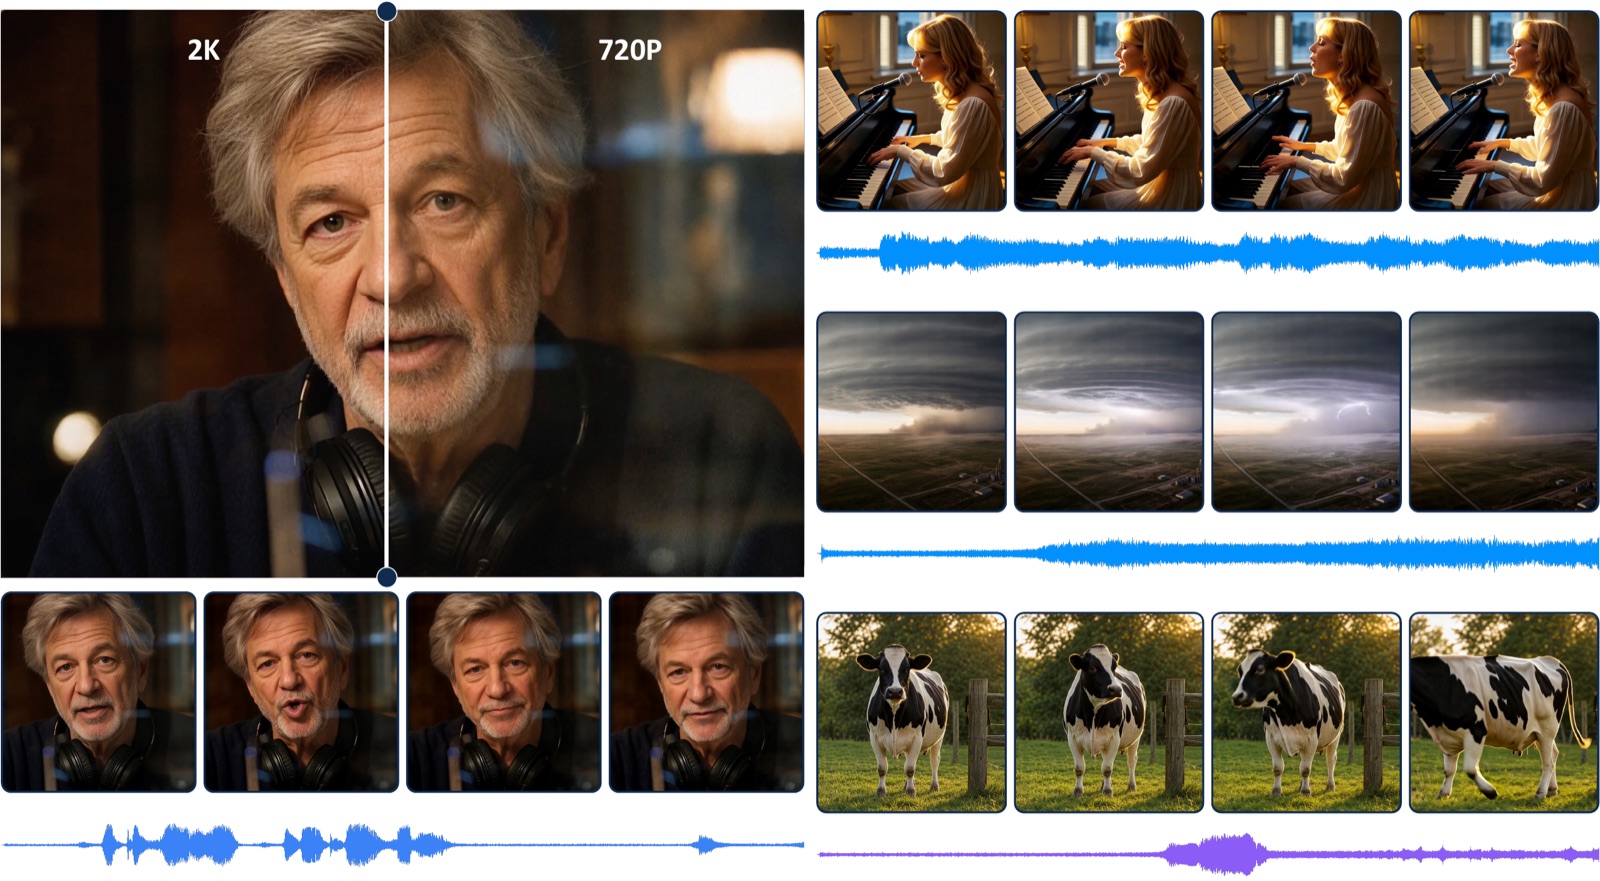
高德(AMap)开源 DreamX-Creator 1.0,一款基于 Wan2.2 构建的 7B 联合音视频生成器,具备门控跨模态注意力与 1 步 2K 精炼器,权重可以完整下载。
 文生视频
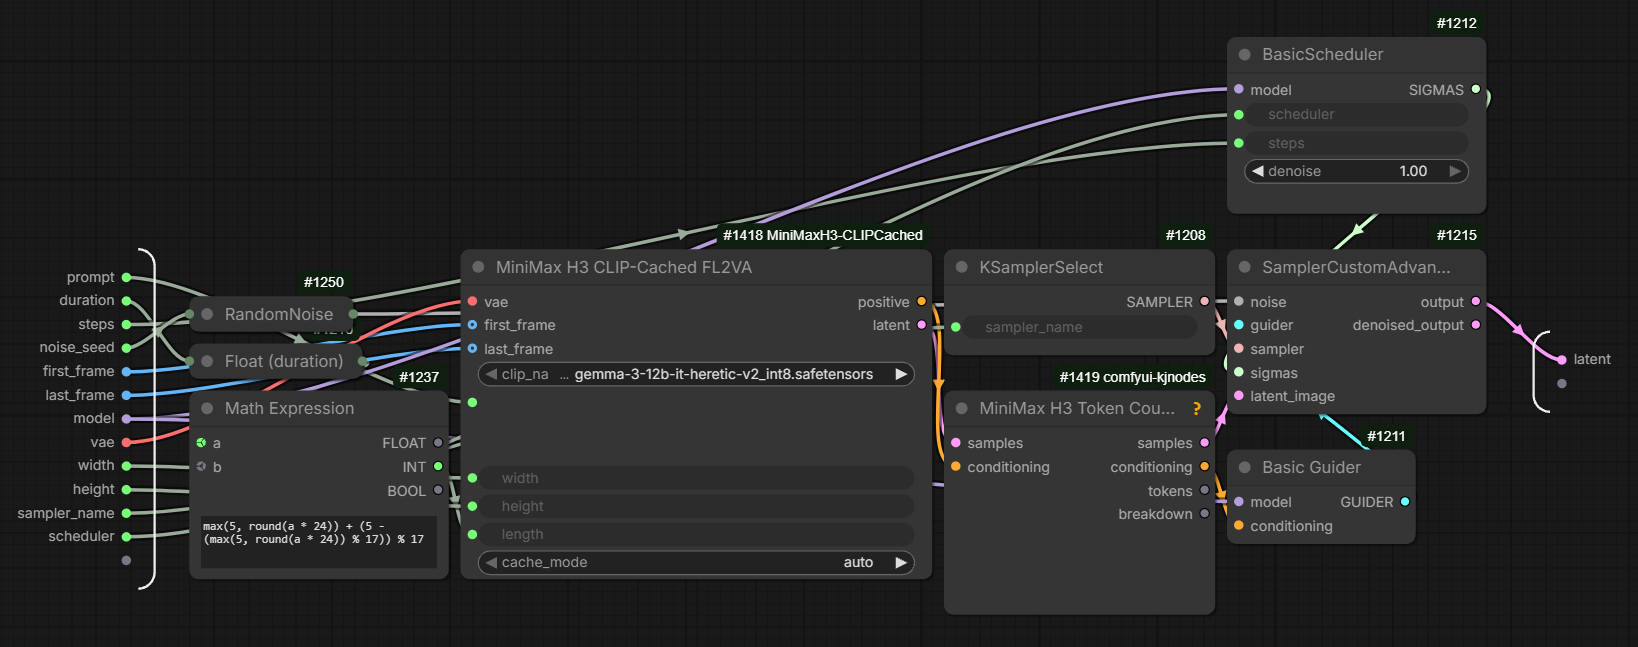
新增的 ComfyUI 节点将 MiniMax H3 Qwen3-VL 条件缓存至磁盘:使用相同提示词重复运行时跳过 14.6 GB 编码器,条件处理时间从 29.9 秒降至 1.1 秒。
 图生图
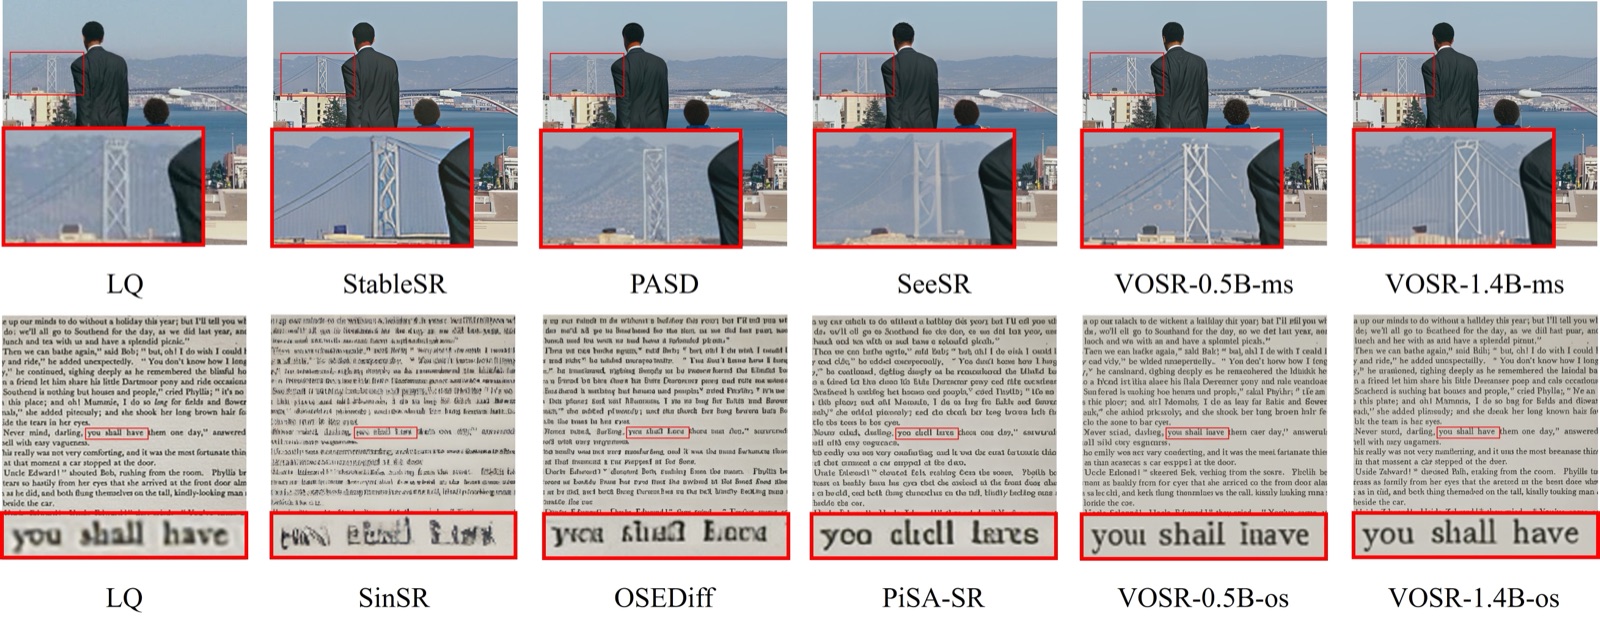
VOSR 2.0 社区节点:一步式 1.4B 超分辨率模型,搭配 Qwen-Image VAE 与 DINOv2 条件,可自动下载权重并支持分块 4 倍图像放大。
 文生视频
ComfyUI 的 MiniMax 视频节点新增 H3 Max 和 H3 Max Turbo 模型:分别是注重质量和速度的托管变体,支持文生视频、首尾帧和参考工作流。
 文生视频
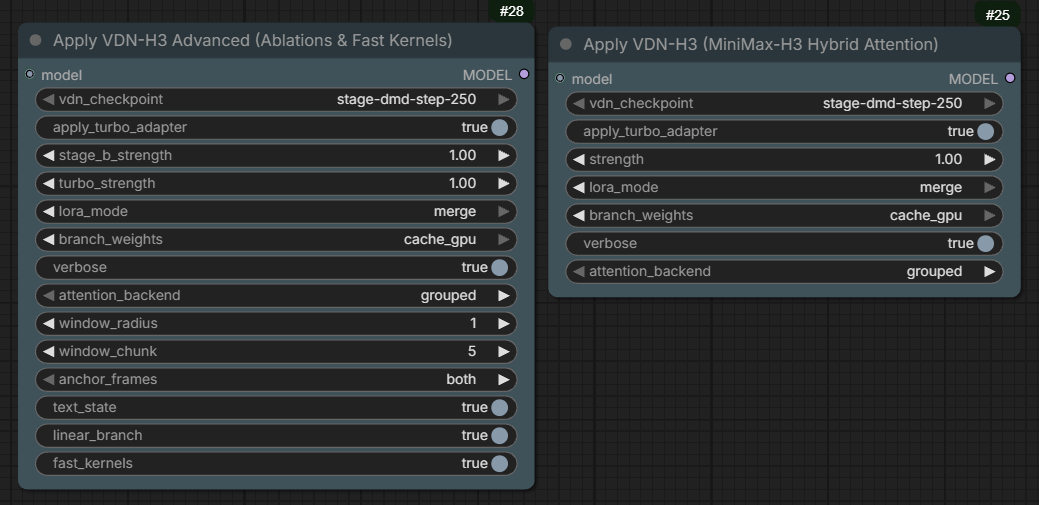
OpenVDN 为 MiniMax H3 推出的 Video DeltaNet 混合注意力模型可在 8 步内渲染 14.4 秒 768p 视频片段,社区 ComfyUI 移植版已可用。
minimax-h3-community-license-agreement
 图生视频
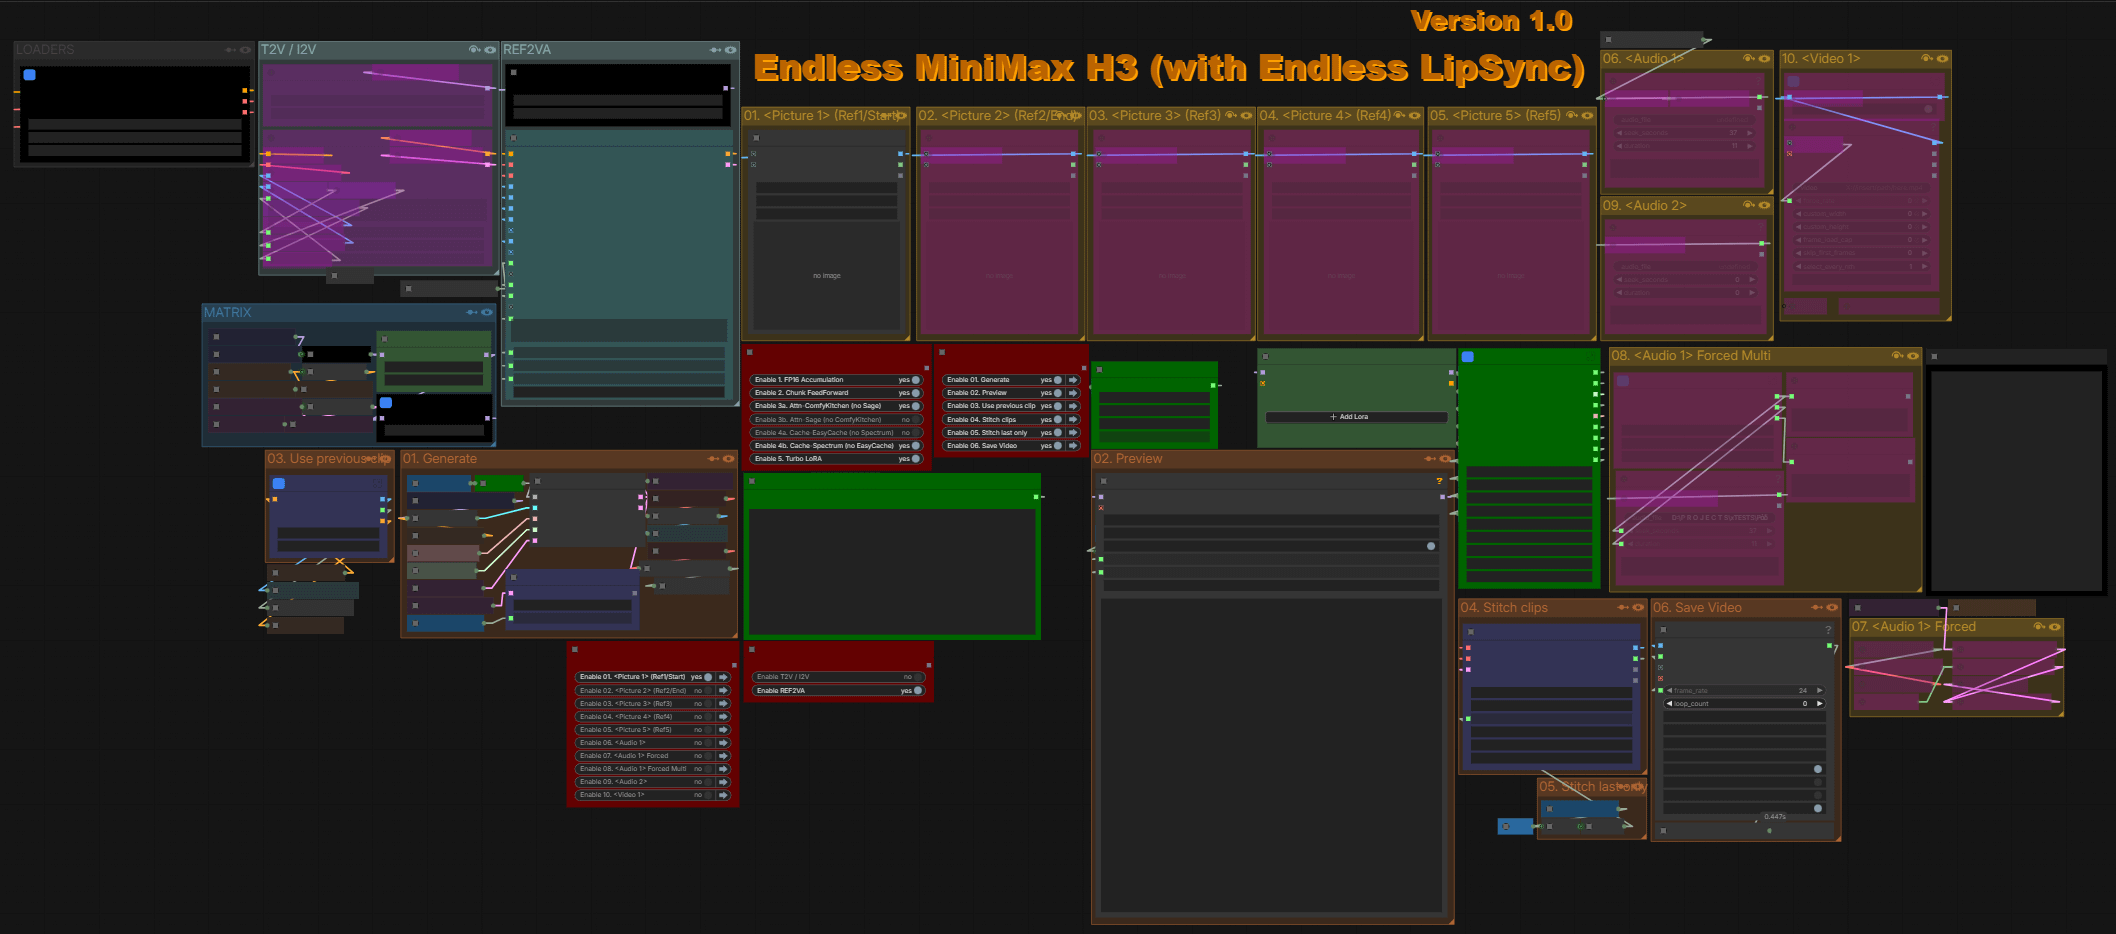
新工作流结合 H3 Motion Context 与 Latent 保存节点,将 MiniMax H3 片段链接成无限制长度视频,支持唇形同步,可在 12GB GPU 上运行。
 文生图
 图生图
VibeComfy 将 ComfyUI 工作流 JSON 转换为可编辑的 Python,供 CLI 智能体使用,现在与 Hivemind 知识库配对,提供社区来源的工作流模式。
 图生图
Provcheck v1.4.0 为 ComfyUI 带来离线 C2PA 签名节点:用于图像和音频的神经水印,以及绑定到您 Bluesky 账号的内容凭证。
 生态工具
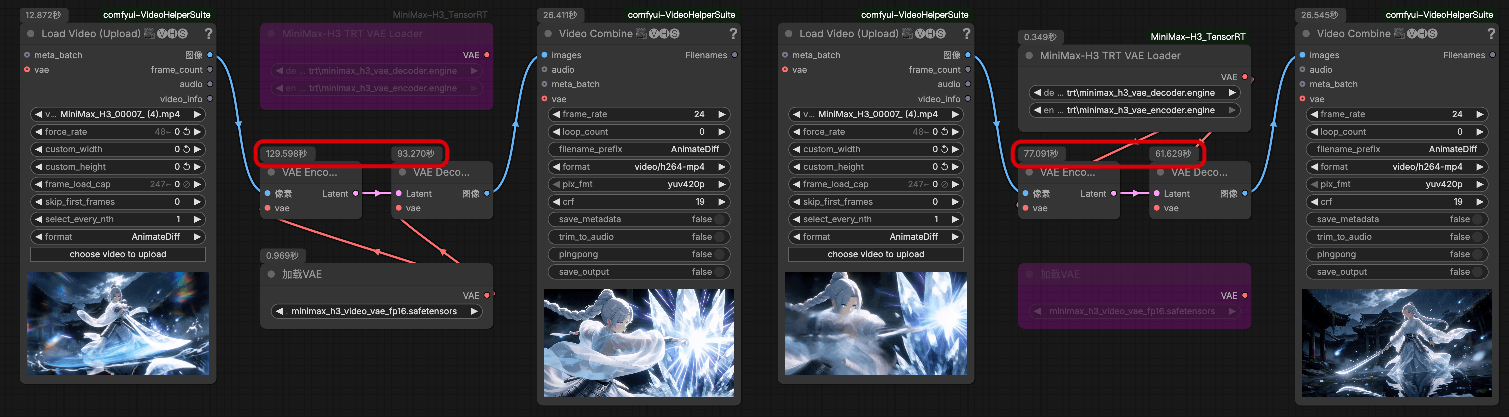
一个 ComfyUI 节点包可将 MiniMax H3 视频 VAE 编译为 TensorRT 引擎,把 VAE 编码与解码时间最多缩短 1.7 倍,并提供适用于低显存的 w4a16 解码器。
 图像编辑
 图生图
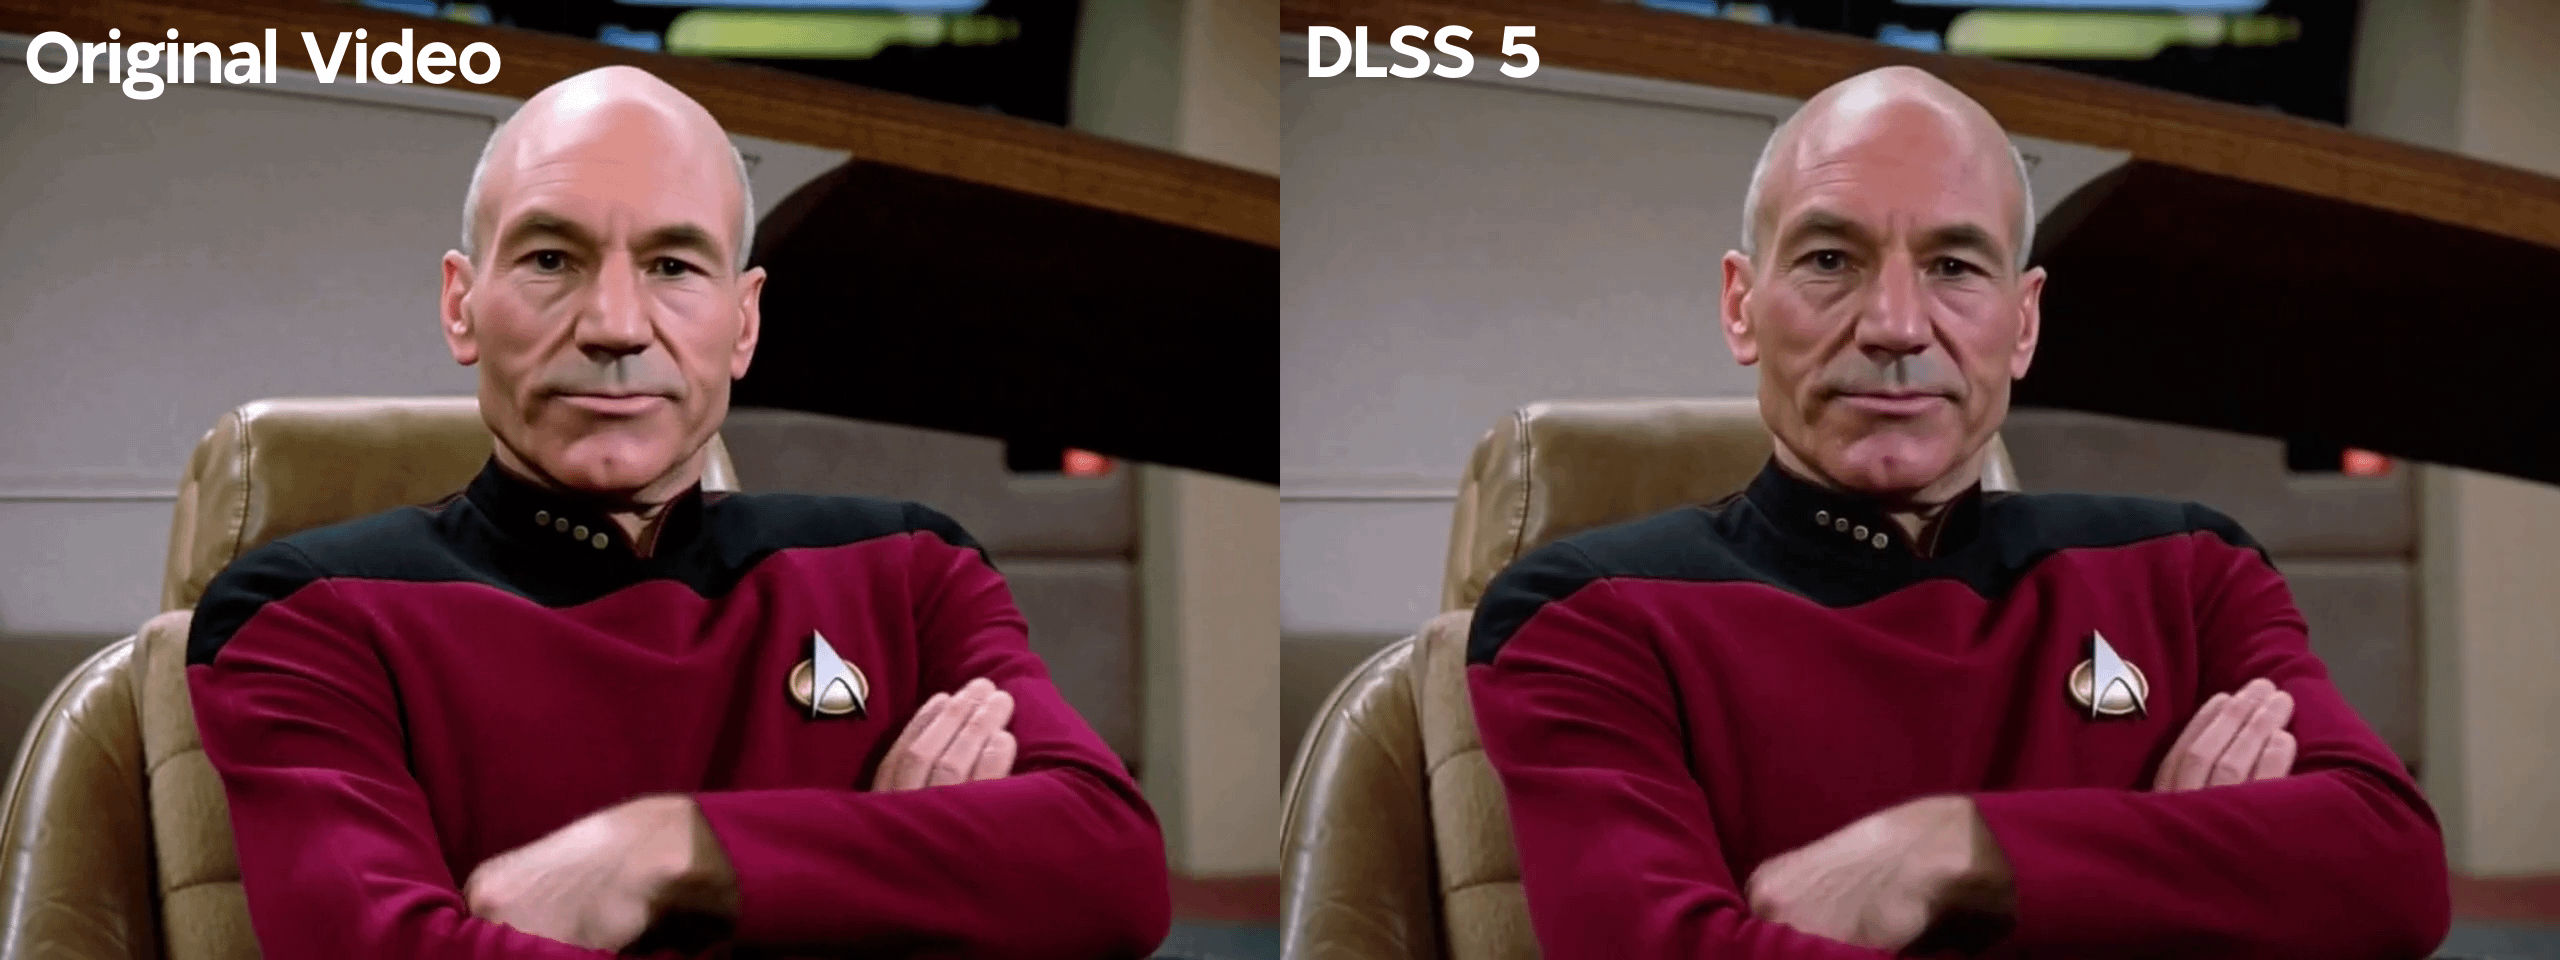
一个实验性 ComfyUI 节点通过 D3D12 桥接器在进程内运行 NVIDIA DLSS 5 神经渲染,无需离开工作流即可增强图像和视频帧。
 文生视频
一个来自 ComfyUI 社区的盲测 A/B 竞技场,对 23 个 MiniMax H3 加速变体进行排名:FastH3、H3 Turbo 蒸馏、SLA、PDD 及合并模型,基于 4000 个预生成片段的投票。
 图生视频
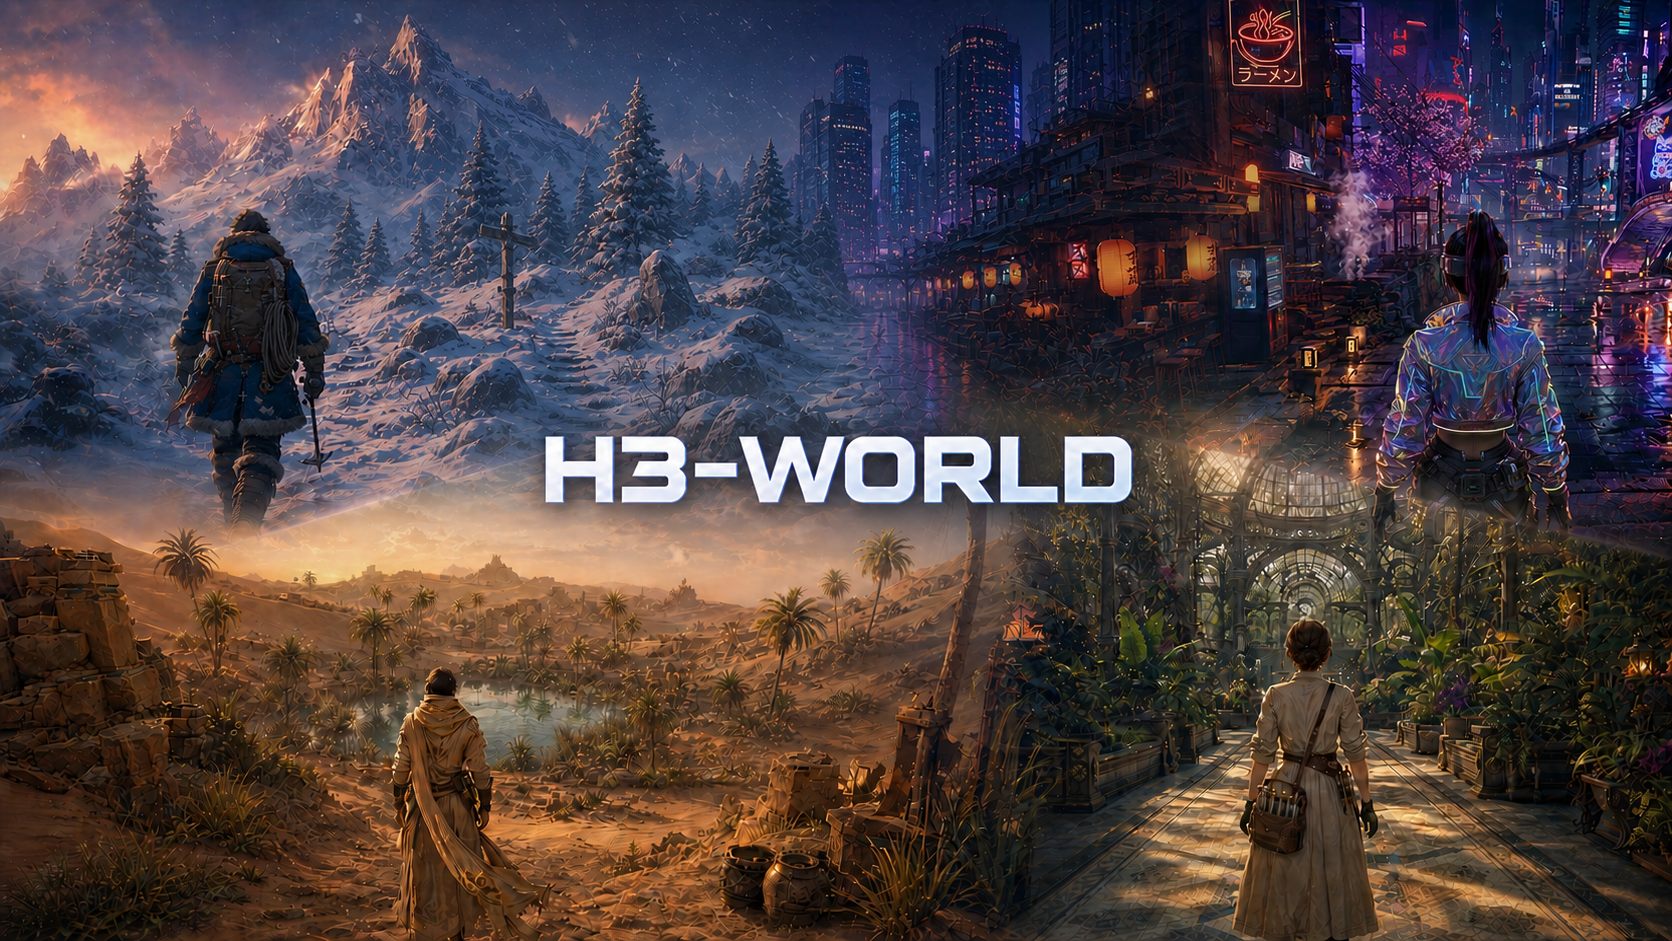
H3-World 将 MiniMax H3 转变为交互式世界模型:65.6M LoRA 加上注意力补丁将 WASD 和相机键映射为从单帧生成的动作控制视频。
apache-2.0
 文生图
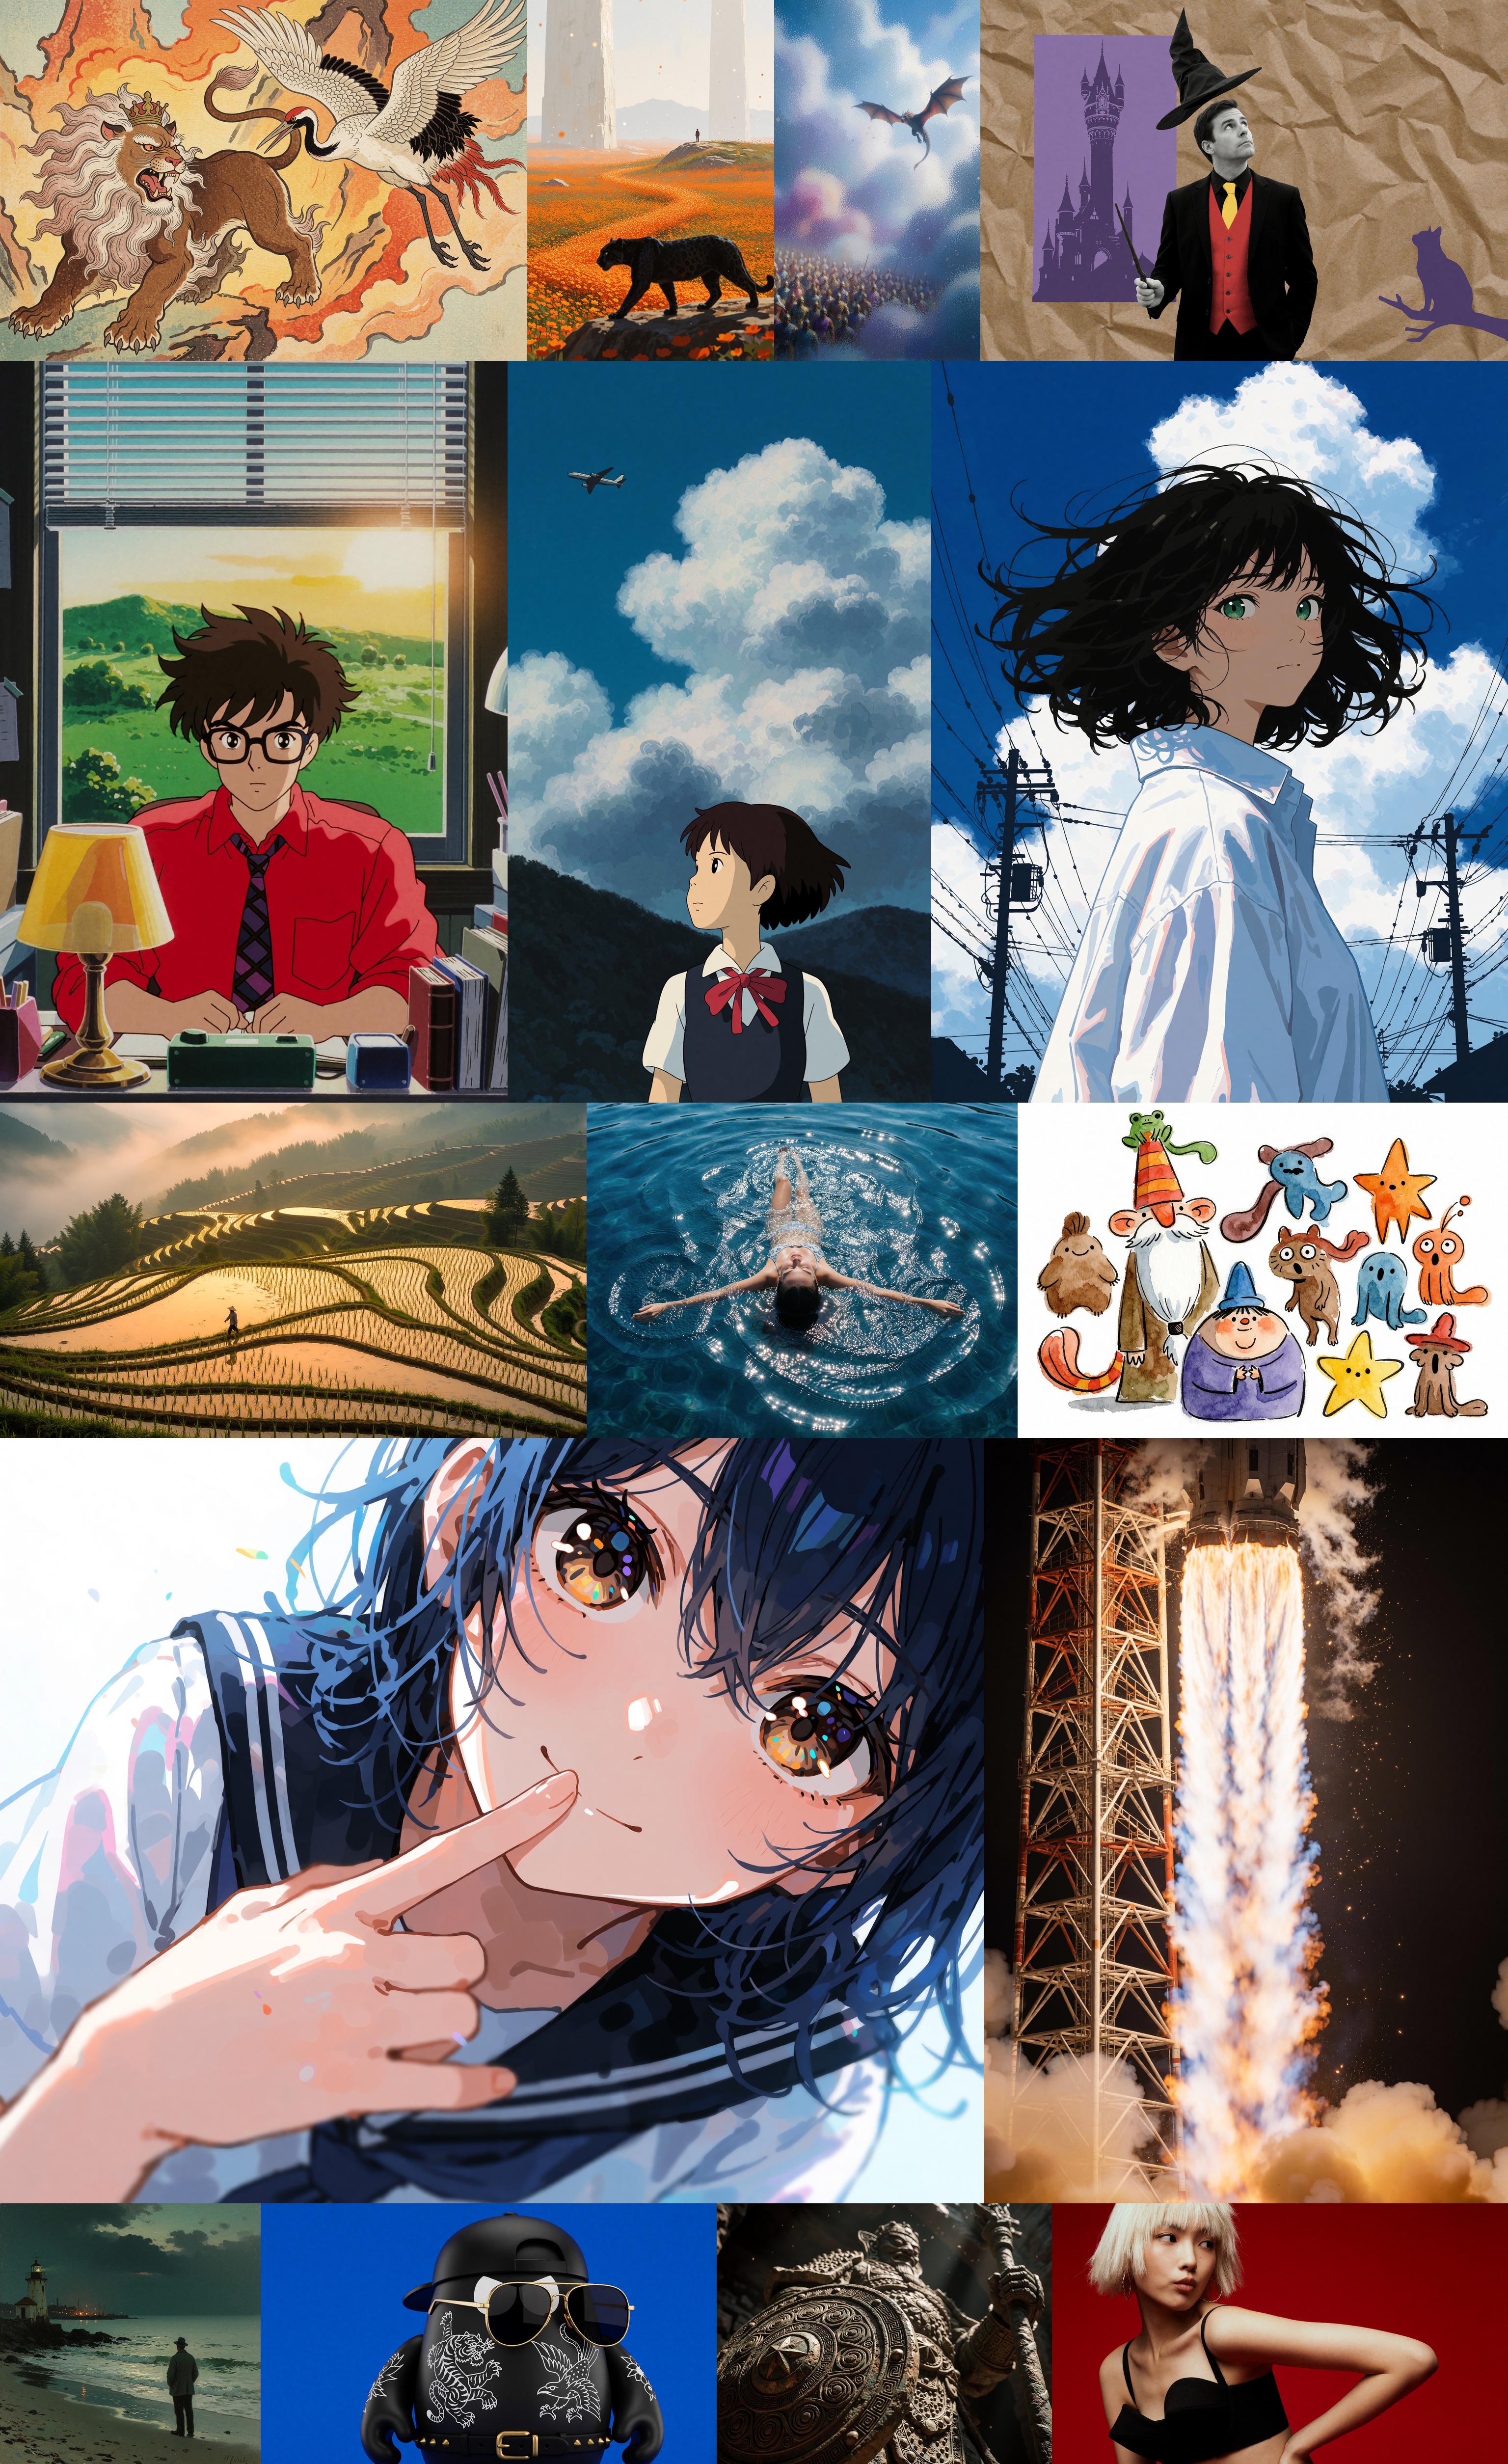
开源 C++20 编译器用于 diffusion 模型,在 RTX 3090 Ti 上将 Krea 2 Turbo 提示词转 PNG 的速度比 ComfyUI 快 2 倍以上,MiniMax H3 进行中。
 图生 3D
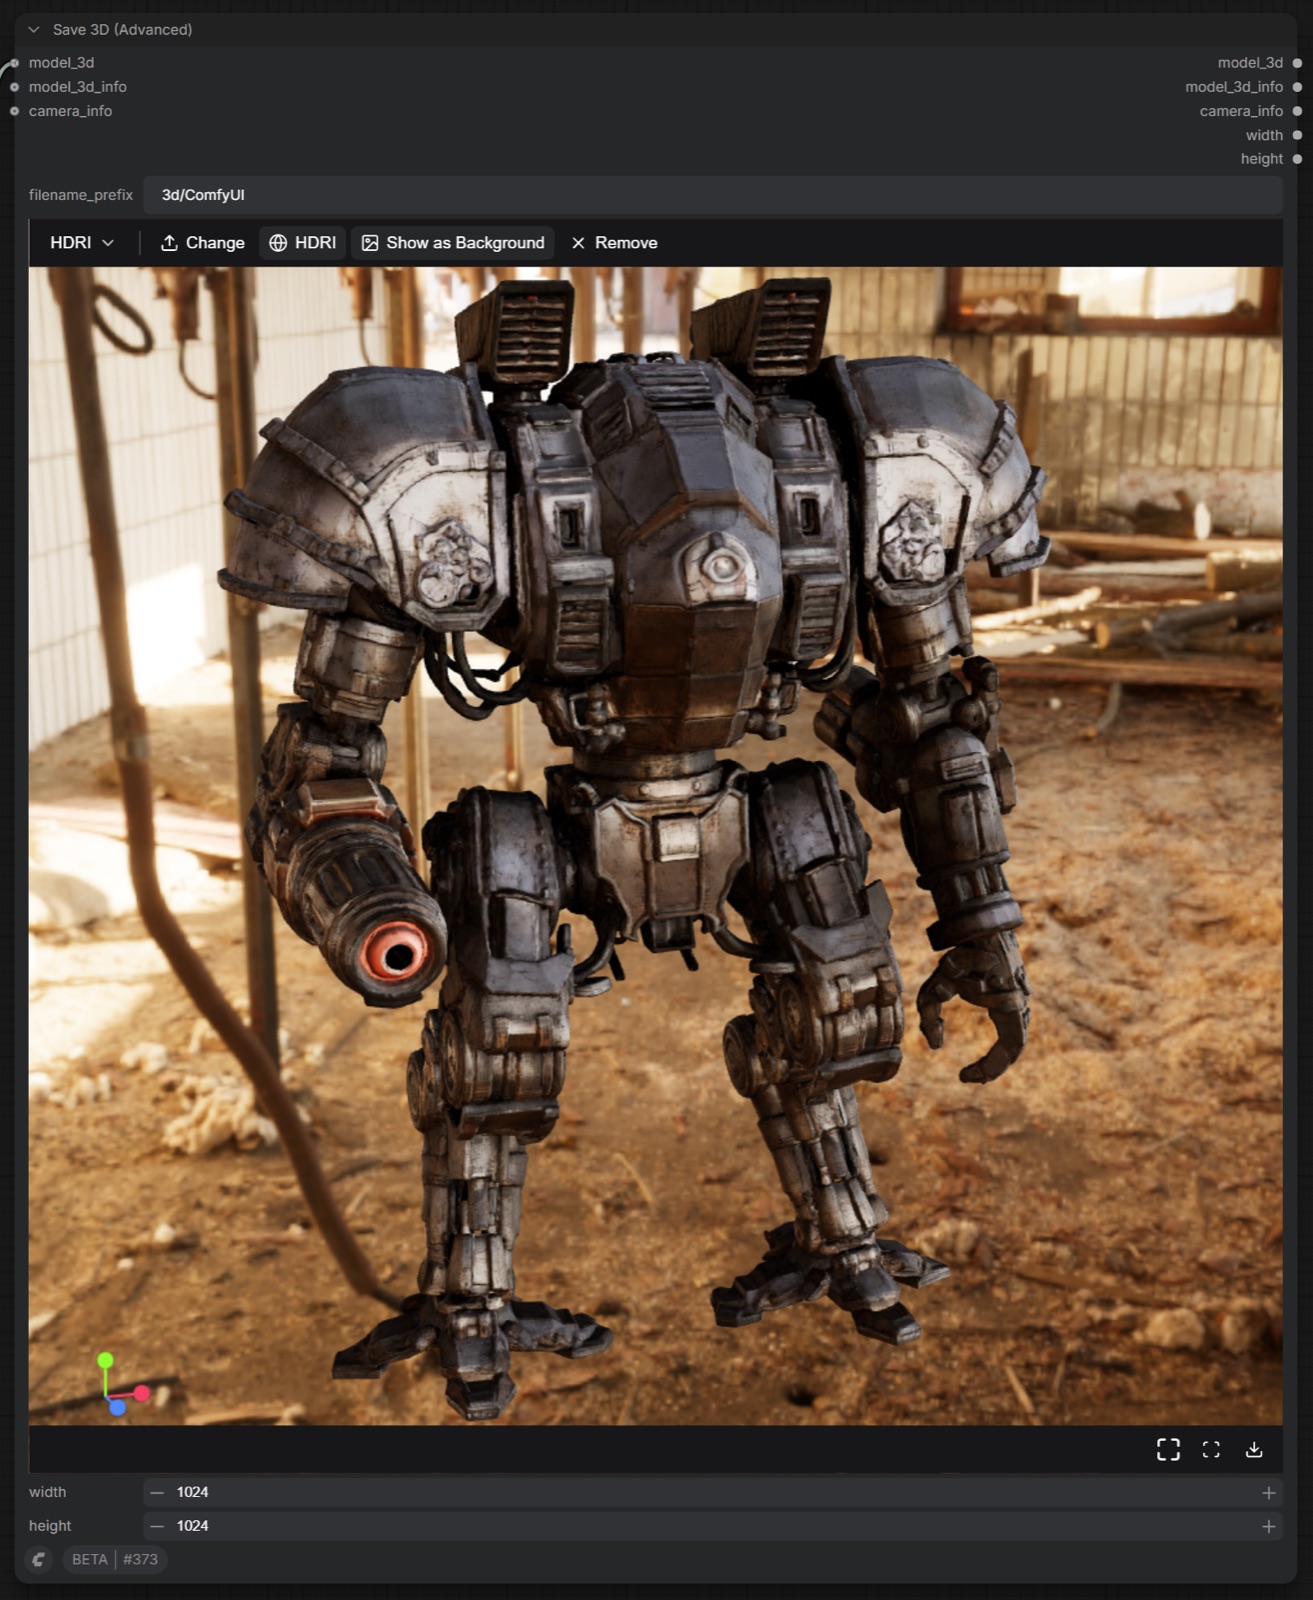
ComfyUI 核心新增原生 Pixal3D 多视角支持,附带官方 bf16 和 INT8 权重,将四个轨道视角或 MV-diffusion 输出转化为更清晰的网格。
MIT
 视频编辑
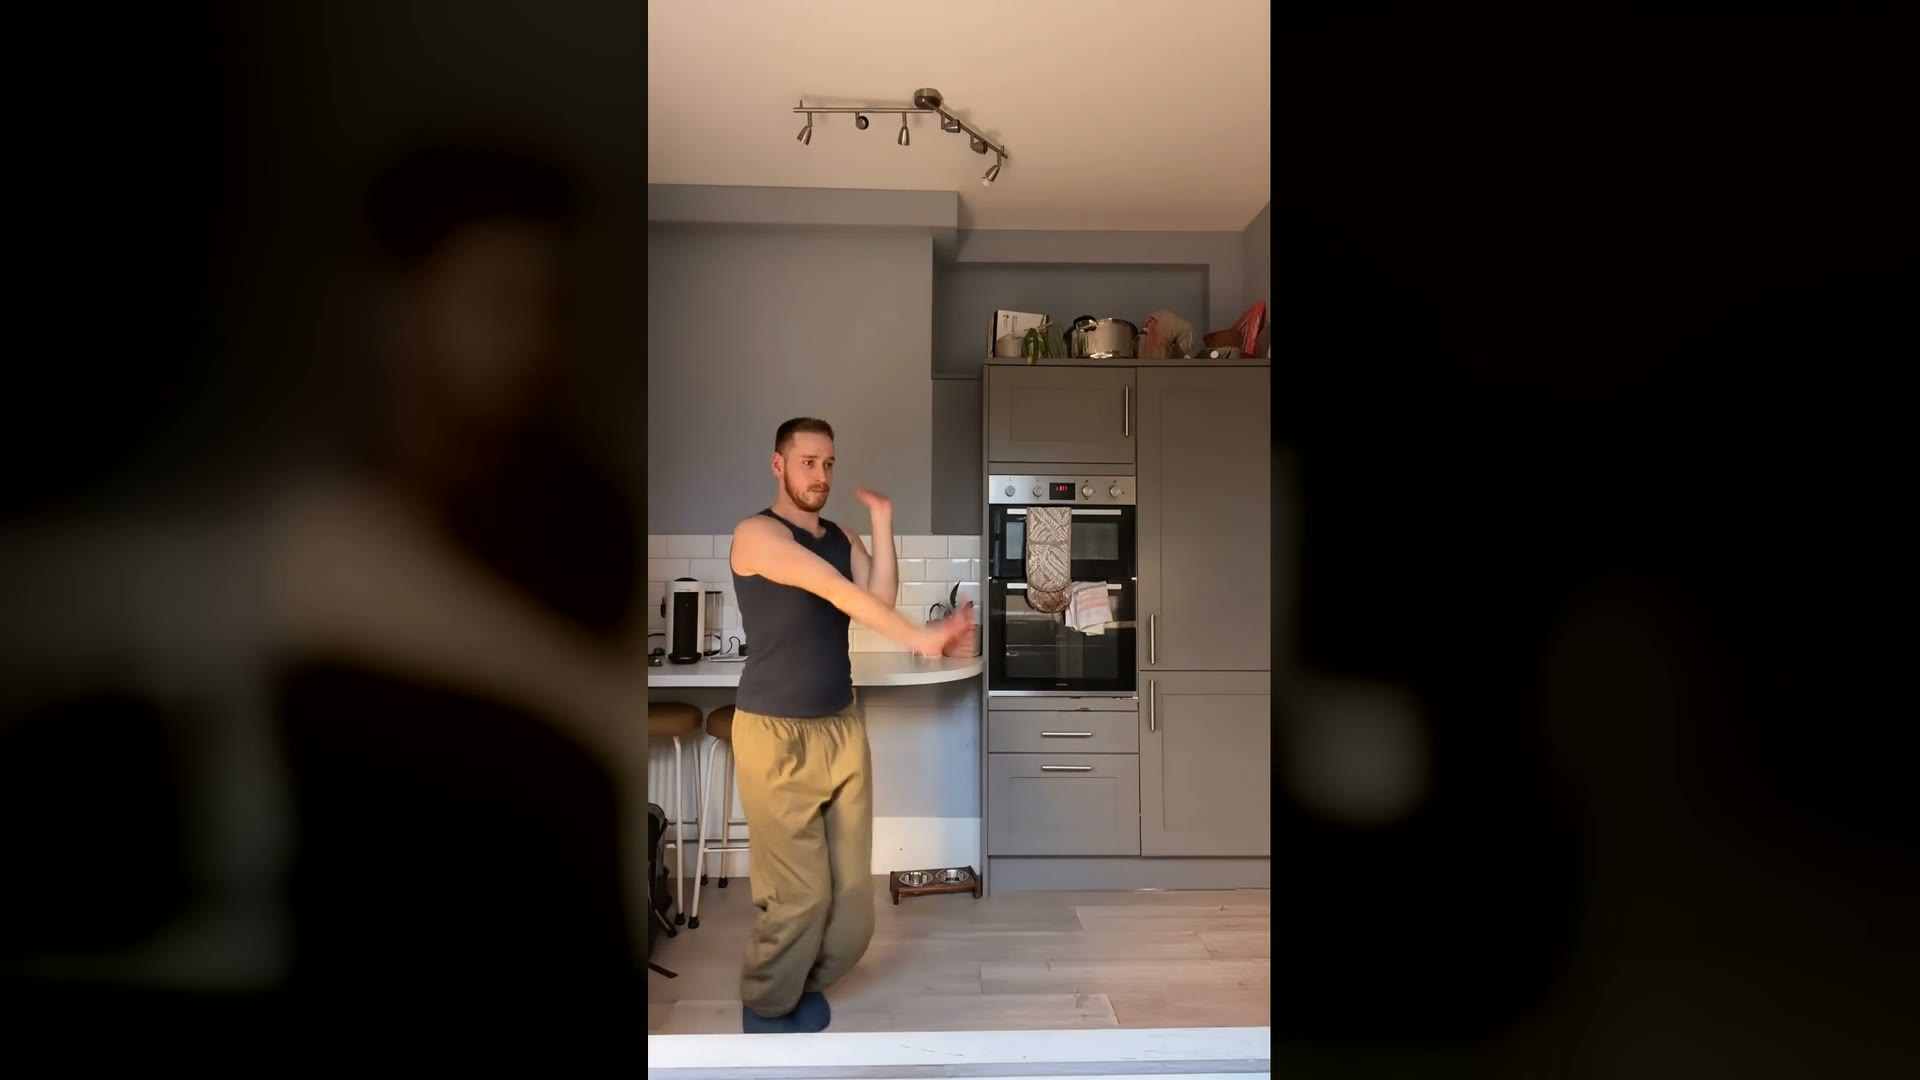
Viggle-Animate 是 MiniMax H3 ref2va 的 331 亿参数微调版本,采用 DMD 蒸馏技术,通过单个重绘帧交换视频角色,仅需 3 次前向传播,每片段耗时 26 秒。
minimax-h3-community-license-agreement
 文生视频
vh5tape 使 MiniMax H3 视频素材呈现出磨损的 1980 年代 VHS 录像效果,包含跟踪噪波、色度溢出及匹配的磁带嘶声。支持三种由提示词控制的损坏等级。
 文生图
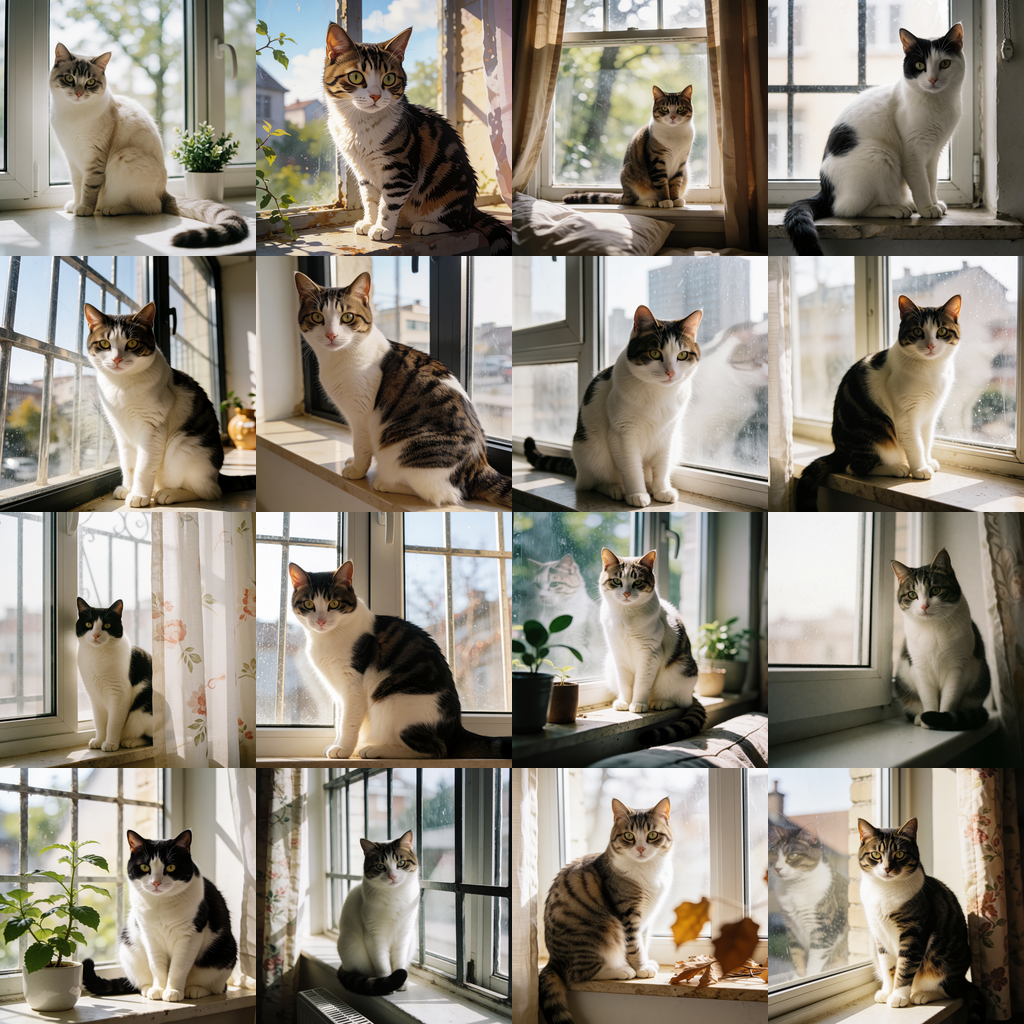
F16 发布了一款使用语义方向对齐训练的 Krea 2 Turbo LoRA:相同的提示词在不同种子下能生成不同的猫、汽车和场景,且质量无损。
krea-2-community-license