ComfyUI-VOSR2:为 ComfyUI 引入一步式 VOSR 2.0 图像放大模型
VOSR 2.0 社区节点:一步式 1.4B 超分辨率模型,搭配 Qwen-Image VAE 与 DINOv2 条件,可自动下载权重并支持分块 4 倍图像放大。
VOSR 2.0 是什么
VOSR 2.0 是一个一步式超分辨率模型,由三个固定组件构成:LightningDiT 主干、作为其 Latent 空间的 Qwen-Image 2D VAE,以及用于条件的 DINOv2-L 视觉编码器。它属于生成式方法,而不是经典的调整大小加锐化流程,因此能够重建低分辨率输入中并不真实存在的结构,例如文字字形、面部特征和建筑边缘。
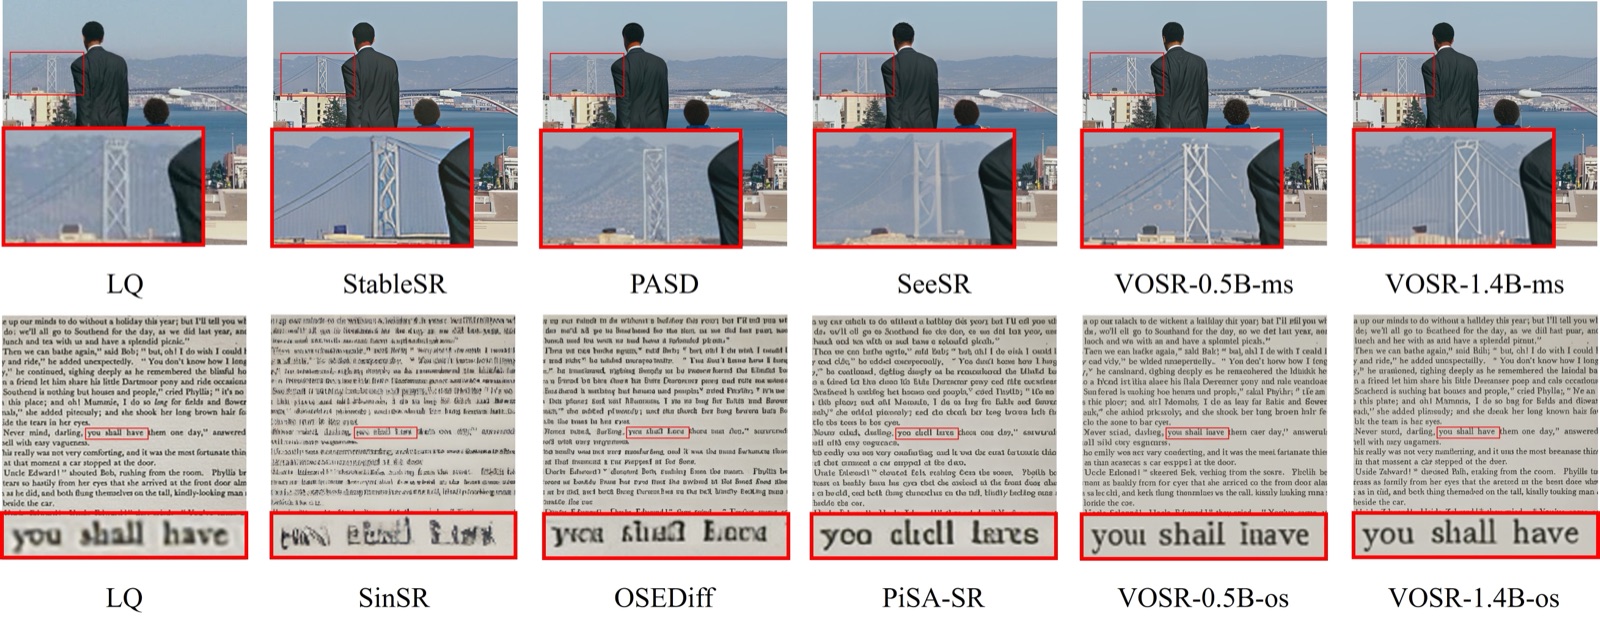
模型卡在精细结构与小号文字上的对比,论文认为 VOSR 2.0 在这类场景中最强。
由于这些组件属于同一套训练产物,节点包将它们作为一个捆绑包处理:DiT 只能与它训练时对应的 Qwen 2D VAE 配合使用,视觉编码器也以同样方式匹配。没有可单独替换的 VAE 或编码器输入。
两个节点
两个节点都位于 image/upscaling/VOSR2 下:
| 节点 | 类名 | 作用 |
|---|---|---|
| VOSR 2.0 Model Loader | VOSR2ModelLoader | 加载捆绑包文件夹并返回 VOSR2_MODEL,使已执行图像不会重新构建权重 |
| VOSR 2.0 Upscale | VOSR2Upscale | 对图像批处理执行一步式超分辨率 |
图像放大节点接受一个 upscale 倍数(默认 4,不设上限)、用于 Latent 噪波的 seed(其中批处理第 i 项使用 seed + i)、对双三次目标进行后处理的 color_alignment 模式(wavelet、adain 或 none),以及独立的 DiT 与 VAE 分块控制。
超过 512px 后分块不是可选项
这部分值得在你提交任务之前先读一读:VOSR 2.0 的原生训练分辨率最高为 512 px,因此只要放大后的输出超过 512x512,就需要设置 tile_size(文档给出的值为 512),否则质量会下降。对于远超 1024 px 的输出,还应设置 vae_tile_size,约为 1024,否则整图 VAE 解码很可能会内存不足。
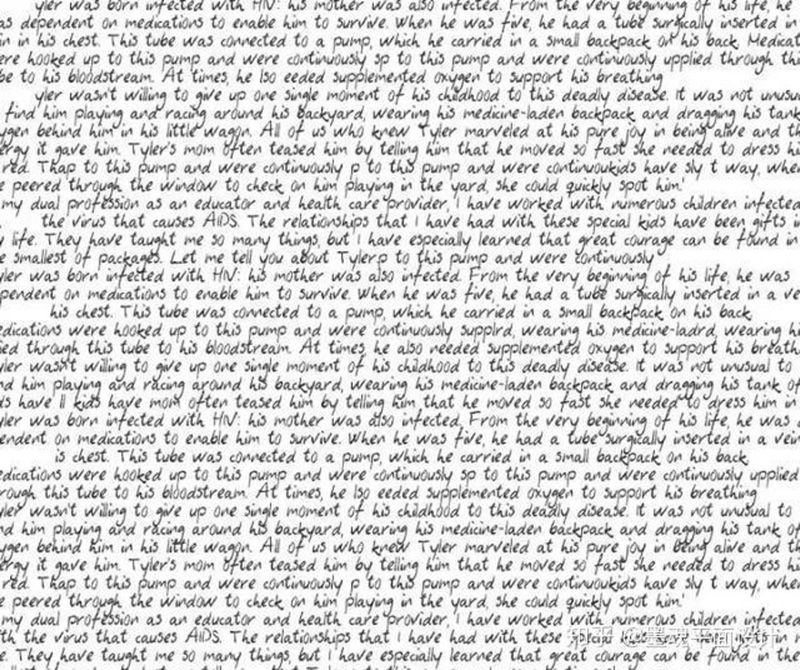 | 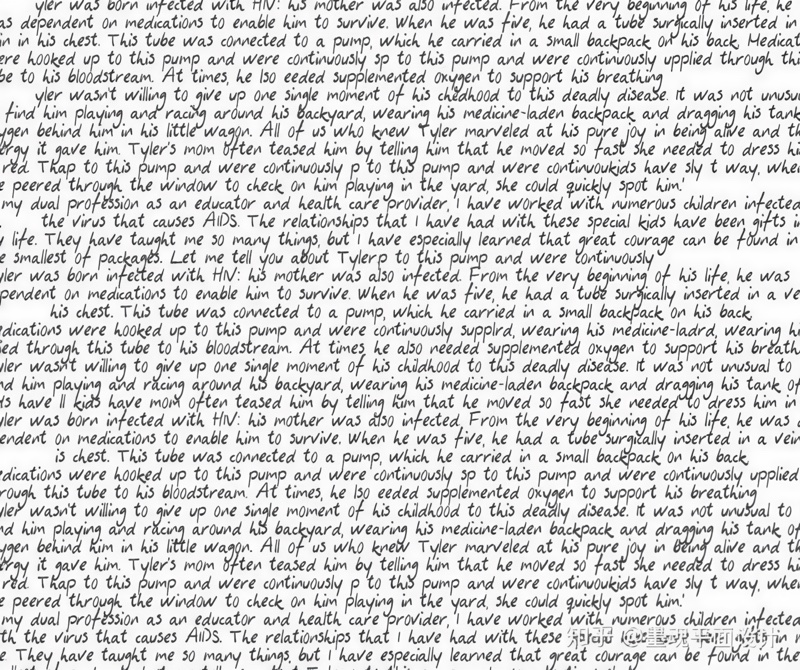 |
|---|---|
| 含小号文字的低分辨率输入 | VOSR 2.0 输出 |
加载器会在构建任何内容之前,依据固定的 VOSR 2.0 架构校验 args.json,因此不兼容的 checkpoint 会以清晰的提示信息报错,而不是部分加载。任何带有 args.json 的捆绑包文件夹只要放在 models/vosr2/ 下,就会出现在模型下拉列表中,但只有 VOSR2 会自动下载。
工作流
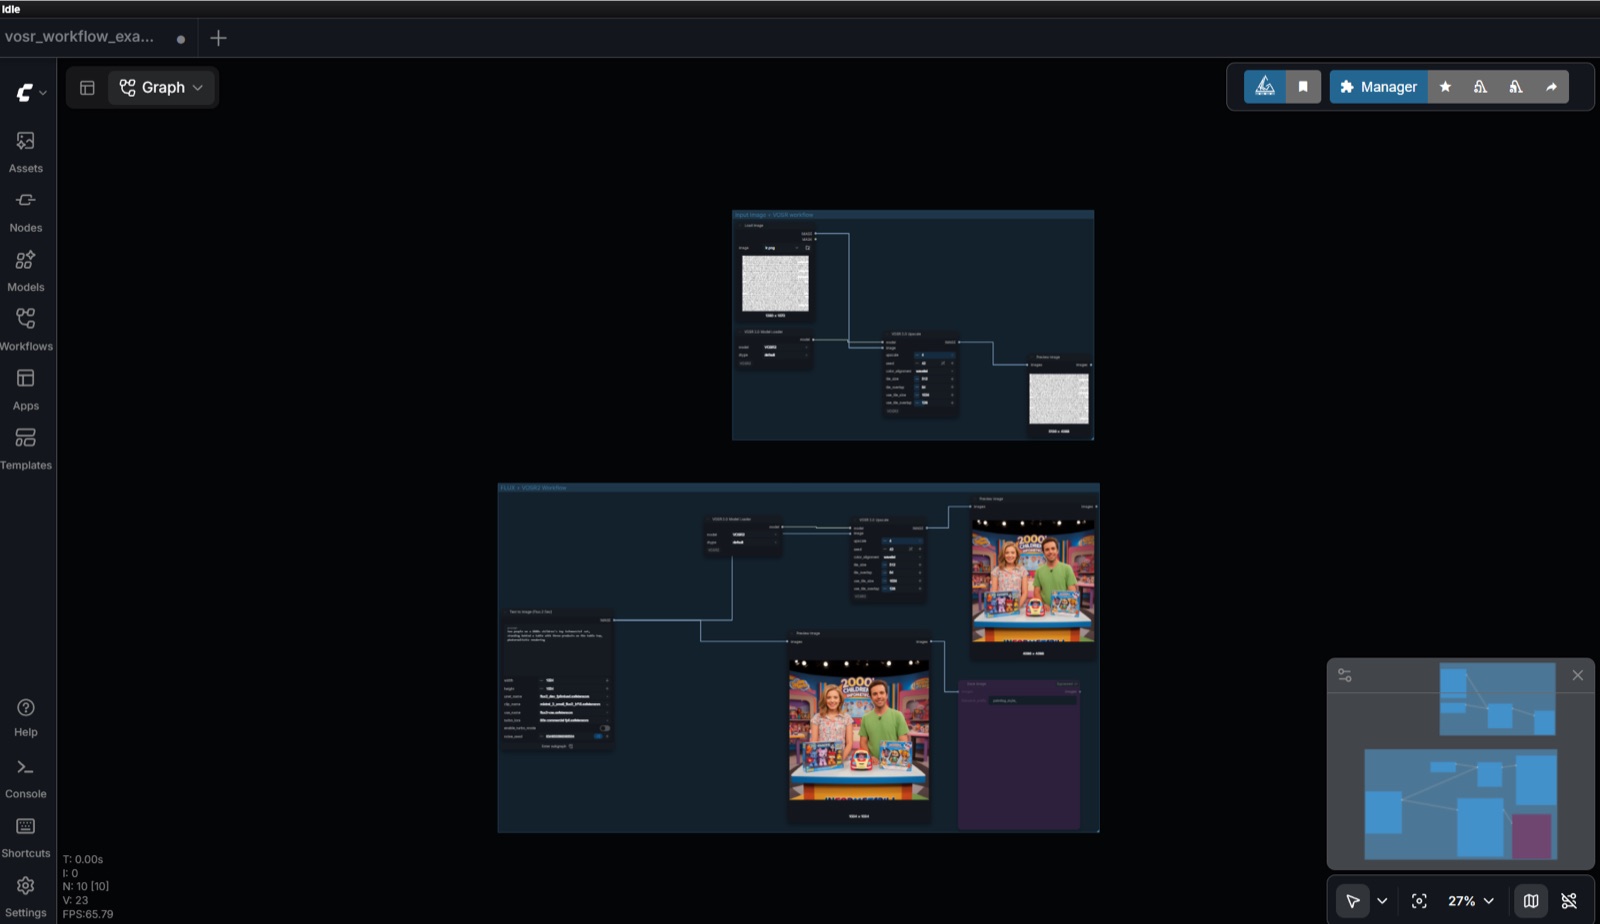
示例工作流:两组加载器与放大节点配对,让已加载的捆绑包不进入逐图像处理路径。
可用性
将 ylchen333/ComfyUI-VOSR2 克隆到 ComfyUI/custom_nodes 并重新启动。它需要搭配较新 PyTorch 的 ComfyUI,且该包会预先进行检查,因此旧环境只会记录一条清晰的错误,而不会从节点列表中消失。
首次运行时,加载器会把所有缺失的组件从固定的 CSWRY/VOSR 仓库下载到 models/vosr2/VOSR2/ 捆绑包中,之后便会跳过下载。该仓库中的 DINOv2-L 文件是原始 PyTorch pickle;加载器会自动将其转换为 safetensors,README 也记录了离线安装时的手动转换方法。
评论
使用 GitHub 登录后即可参与讨论。