MiniMax H3 TRT VAE:在 ComfyUI 中让 H3 解码提速 1.7 倍
ComfyUI Wikinews
一个 ComfyUI 节点包可将 MiniMax H3 视频 VAE 编译为 TensorRT 引擎,把 VAE 编码与解码时间最多缩短 1.7 倍,并提供适用于低显存的 w4a16 解码器。
ComfyUI-H3VAE_TRT 通过 TensorRT 运行 MiniMax H3 视频 VAE。只需编译一次 VAE,之后便可复用该引擎:此节点在 ComfyUI 中报告的 VAE 编码与解码速度最高提升 1.7 倍。
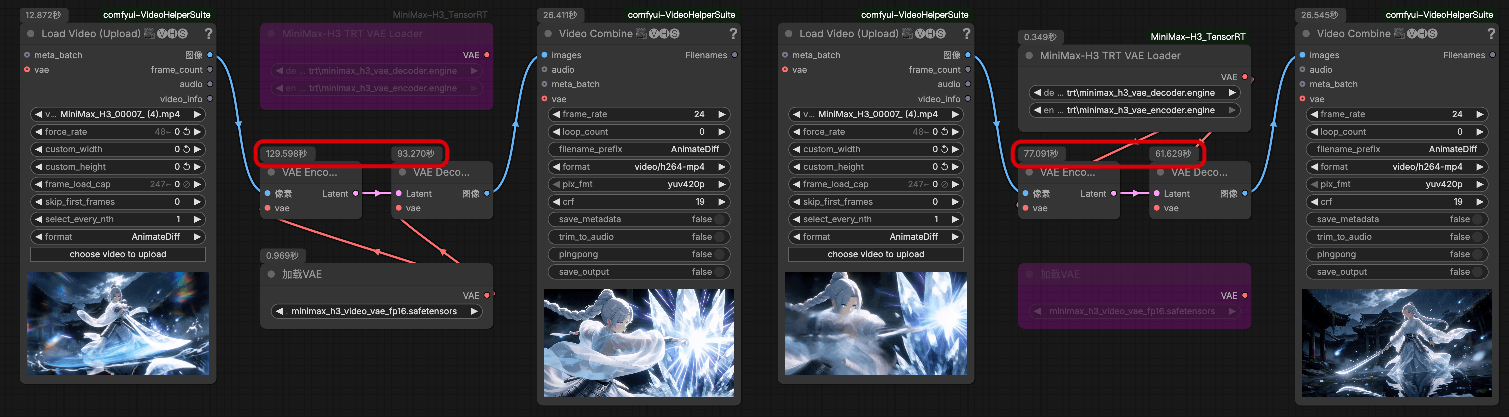
项目 README 预览:位于 ComfyUI 节点图中的 TRT VAE 编译与加载节点。
VAE 解码在每次 H3 运行时都是一项固定开销。ComfyUI 内置的 kernels 已在 PyTorch 侧降低了这项开销;此节点则走另一条路线,把 VAE 交给编译好的 TensorRT 引擎。
此节点做什么
该节点包提供两个节点,以及一条通往引擎的 ONNX 路径:
- MiniMax-H3 TRT VAE Compiler:接收 ONNX 编码器和解码器并构建 TensorRT 引擎。这是一次性步骤,编译好的引擎之后可重复使用。
- MiniMax-H3 TRT VAE Loader:加载已编译的引擎,使其可以替代常规 VAE 使用。
权重以 ONNX 文件形式发布在 Hugging Face 上,放入 ComfyUI/models/vae。该节点包还包含独立的 compile.py,可在 ComfyUI 之外构建引擎,当编译步骤不应阻塞 UI 时很有用。
安装设置
| 步骤 | 操作 |
|---|---|
| 1 | 将 git clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT 克隆到 ComfyUI/custom_nodes,并安装 requirements.txt 中的依赖项 |
| 2 | 下载 ONNX 编码器和解码器到 ComfyUI/models/vae |
| 3 | 运行一次 MiniMax-H3 TRT VAE Compiler 来构建引擎 |
| 4 | 将工作流的 VAE 切换为 MiniMax-H3 TRT VAE Loader |
ONNX 仓库还提供 w4a16_awq 解码器变体,README 建议在 GPU 显存不足 12GB 时使用该变体。
来自问题追踪的说明
在编译之前值得先阅读该仓库的问题,因为 TensorRT 构建对已安装的软件栈非常敏感:
- 引擎编译很慢。有一份反馈实测,单次构建耗时超过五小时,因此首次编译最好提前进行,而不是在会话中途执行。
- TensorRT 与 CUDA 版本必须对应。目前存在 TensorRT 11.2 搭配 CUDA 13.0 的未解决问题反馈,另有其他环境中出现的
IBuilder::buildSerializedNetworkAPI 使用错误。 - 编译后的编码器曾在首帧、末帧和引用帧上留下网格图案,该问题已被反馈并于 9 月初修复,因此从当前
main构建即可避免。
获取方式
节点包与 ONNX 权重均已公开:
节点包: lihaoyun6/ComfyUI-H3VAE_TRT
ONNX 权重: lihaoyun6/MiniMax-H3-VAE-ONNX
基础模型: MiniMaxAI/MiniMax-H3
该节点包未附带示例工作流:编译器与加载器可直接替代标准 VAE 节点,接入现有的 H3 节点图。
评论
使用 GitHub 登录后即可参与讨论。